


ErrImagePull ist der Fehler, den Kubernetes anzeigt, wenn das kubelet ein Container-Image für einen Pod nicht pullen kann. Aus dem Image wird der Container gestartet – kann das kubelet es nicht herunterladen, startet der Container nie. In der Regel sehen Sie dann einen Pod, der in ErrImagePull oder ImagePullBackOff feststeckt, ohne Anwendungslogs, die den Fehler erklären könnten, denn die Anwendung ist noch gar nicht gelaufen.
In diesem Leitfaden erfahren Sie, was ErrImagePull bedeutet, wie es sich von ImagePullBackOff unterscheidet, wie Kubernetes Images pullt, welche Ursachen am häufigsten sind, wie Sie den Fehler diagnostizieren und wie Sie ihn beheben. Außerdem sehen Sie, wie festhängende Pods Node-Kapazität verschwenden können.
Was bedeutet der ErrImagePull-Fehler in Kubernetes?
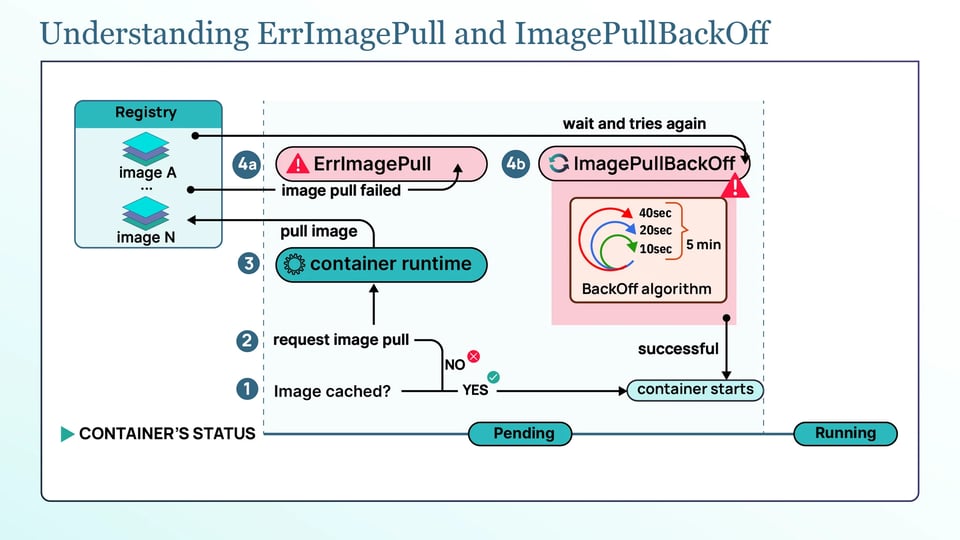
ErrImagePull bedeutet, dass ein einzelner Image-Pull-Versuch fehlgeschlagen ist. Wenn Sie einen Pod erstellen, weist das kubelet auf dem Node des Pods die Container-Runtime an, das im Pod-Spec angegebene Image zu pullen. Schlägt dieser Pull aus irgendeinem Grund fehl, wechselt der Zustand des Containers auf ErrImagePull, und der Container wartet, statt zu starten.
Entscheidend ist: Bei ErrImagePull geht es um das Beschaffen des Images, nicht um dessen Ausführung. Die Anwendung ist nicht gestartet, daher hat kubectl logs nichts anzuzeigen. Der Grund für den Fehler steht in den Events des Pods.
ErrImagePull vs. ImagePullBackOff
ErrImagePull bedeutet, dass das kubelet versucht hat, das Container-Image zu pullen, und der Versuch fehlgeschlagen ist. Es gibt dabei nicht auf: Nach dem Fehlschlag wartet das kubelet, bevor es den Pull erneut versucht.
ImagePullBackOff bedeutet, dass das kubelet vor dem nächsten Pull-Versuch wartet. Die Wartezeit zwischen den Versuchen wächst mit wiederholten Fehlschlägen.
Der Backoff beginnt bei etwa 10 Sekunden und steigt exponentiell: rund 10 Sekunden, 20 Sekunden, 40 Sekunden und so weiter. Er ist bei 5 Minuten (300 Sekunden) gedeckelt. Sobald die maximale Wartezeit erreicht ist, versucht das kubelet den Pull etwa alle 5 Minuten erneut.
Der Pod verschwindet nicht automatisch. Er bleibt in diesem Zyklus, bis das Image gepullt werden kann, das zugrunde liegende Problem behoben ist oder der Pod gelöscht wird.
Wie pullt Kubernetes Container-Images?
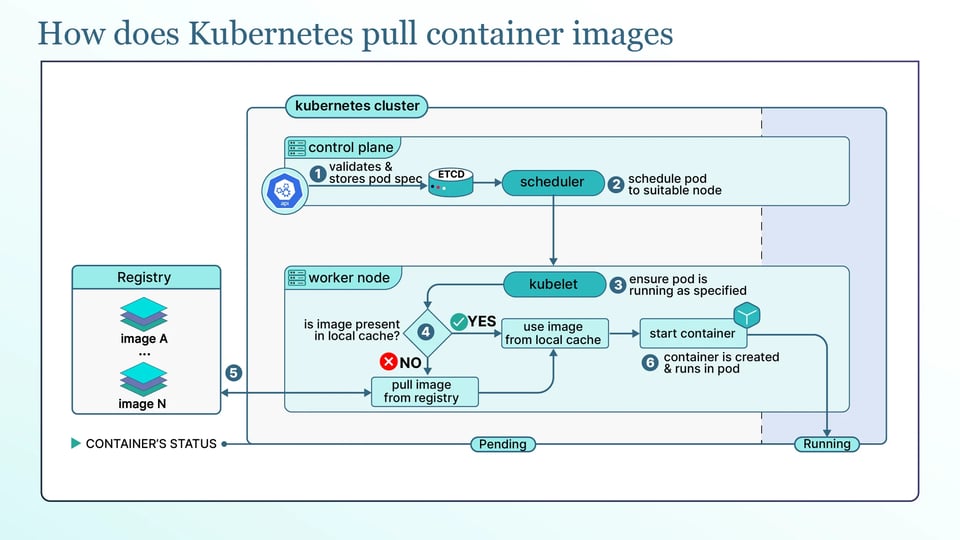
Die meisten ErrImagePull-Fehler sind leichter zu verstehen, wenn man weiß, wie Kubernetes ein Image pullt. Wird ein Pod auf einen Node geplant, weist das kubelet auf diesem Node die Container-Runtime (etwa containerd oder CRI-O) an, sicherzustellen, dass das Image vorhanden ist. Die Runtime prüft zunächst die Image-Pull-Policy und ob das Image bereits auf dem Node liegt. Muss sie pullen, kontaktiert sie die Registry, authentifiziert sich (falls die Registry privat ist), lädt die Image-Layer herunter und entpackt sie. Erst wenn das Image bereit ist, startet der Container. Ein Fehler in einem dieser Schritte – etwa ein falscher Name, fehlende Zugangsdaten oder ein Netzwerkproblem – zeigt sich als ErrImagePull.
Die Image-Pull-Policy steuert, wann Kubernetes ein Image pullt. Es gibt drei Optionen:
a. Always pullt das Image bei jedem Start des Pods. Das ist der Standard, wenn das Image den Tag :latest verwendet oder gar keinen Tag hat.
b. IfNotPresent pullt das Image nur, wenn es noch nicht auf dem Node liegt. Das ist der Standard für Images mit jedem anderen Tag.
c. Never weist die Runtime an, ausschließlich ein bereits auf dem Node vorhandenes Image zu verwenden. Sie pullt das Image nie. Ist das Image lokal nicht verfügbar, erhalten Sie den Fehler ErrImageNeverPull.
Die Image-Referenz bestimmt, welches Image genau gepullt wird. Sie besteht aus einem Repository und entweder einem Tag oder einem Digest, geschrieben als repository:tag oder repository@sha256:<digest>. Ein Tag wie :1.4 ist veränderlich, das heißt, das Image, auf das er zeigt, kann sich mit der Zeit ändern. Ein Digest ist eine eindeutige ID für ein Image und zeigt daher immer auf dasselbe Image.
Häufige Ursachen für ErrImagePull
ErrImagePull geht in der Regel auf die folgenden typischen Probleme zurück:
a. Falscher Image-Name, falsches Repository oder falscher Tag: Ein Tippfehler im Image-Namen, ein falscher Registry-Pfad oder ein nicht existierender Tag lassen den Pull scheitern. Die Meldung lautet meist etwa manifest unknown oder repository does not exist or may require authorization. Das sollten Sie als Erstes prüfen.
b. Fehlende, falsche oder abgelaufene Registry-Zugangsdaten: Eine private Registry benötigt Zugangsdaten – fehlen sie oder sind sie falsch, schlägt der Pull mit unauthorized: authentication required fehl. Typische Varianten sind ein Pull-Secret, das nie an den Pod angehängt wurde, ein Secret im falschen Namespace oder ein abgelaufenes Token. Amazon-ECR-Tokens etwa sind kurzlebig, sodass ein Setup, das gestern noch problemlos gepullt hat, heute scheitern kann, wenn die Token-Aktualisierung nicht konfiguriert ist.
c. Registry-Rate-Limits und Pull-Drosselung: Öffentliche Registries begrenzen, wie oft Sie pullen dürfen. Docker Hub liefert toomanyrequests (eine 429-Antwort), sobald Sie das Limit überschreiten. Aktuell sind anonyme Pulls auf 100 pro 6 Stunden pro IP-Adresse begrenzt, authentifizierte kostenlose Konten erhalten 200 pro 6 Stunden, bezahlte Konten sind unbegrenzt. Die vielzitierte Angabe von "10 Pulls pro Stunde" wurde zwar angekündigt, aber nie durchgesetzt – das aktuelle Limit liegt bei 100 pro 6 Stunden. In einem stark ausgelasteten Cluster hinter einer einzigen öffentlichen IP ist das schneller erreicht, als man denkt.
d. Node-Netzwerk, DNS oder Proxy blockieren die Registry: Erreicht der Node die Registry nicht, schlägt der Pull mit Fehlern wie dial tcp: lookup ... no such host oder i/o timeout fehl. Das passiert bei defektem DNS, einem Unternehmens-Proxy, den die Runtime nicht kennt, einer Firewall-Regel oder einem abgeschotteten Cluster ohne Route zu einer öffentlichen Registry.
e. TLS-Zertifikatsfehler bei privaten Registries: Eine private Registry mit einem selbstsignierten oder anderweitig nicht vertrauenswürdigen Zertifikat lässt den Pull mit x509: certificate signed by unknown authority scheitern. Die Container-Runtime des Nodes vertraut dem Zertifikat der Registry nicht und verweigert die Verbindung.
f. Image-Architektur passt nicht zur CPU des Nodes: Ein nur für amd64 gebautes Image läuft nicht auf einem arm64-Node, und der Pull schlägt mit no matching manifest for linux/arm64 fehl. Das kommt in Clustern mit gemischten CPUs und auf Arm-basierten Nodes häufig vor.
g. Disk Pressure auf dem Node und zu wenig Platz für Image-Layer: Image-Layer brauchen Platz auf dem Node. Ist der Speicherplatz knapp, schlägt der Pull mit no space left on device fehl, und der Node kann zusätzlich eine Disk-Pressure-Condition aufweisen, die verhindert, dass neue Pods dort landen.
So diagnostizieren Sie einen ErrImagePull-Fehler
Die Ursache finden Sie meist, indem Sie die richtigen Ausgaben in dieser Reihenfolge lesen:
a. Pod-Status mit kubectl get pods prüfen: Damit bestätigen Sie das Symptom. Der STATUS des Pods zeigt ErrImagePull oder ImagePullBackOff, und ein steigender RESTARTS-Zähler bzw. das Alter verrät, dass er schon eine Weile feststeckt.
kubectl get pods
b. Den eigentlichen Fehler in kubectl describe pod finden: Das ist der entscheidende Schritt. Der Abschnitt Events: in der Ausgabe von kubectl describe pod zeigt den tatsächlichen Image-Pull-Fehler, der in der Regel verrät, mit welcher Ursache Sie es zu tun haben.
kubectl describe pod <pod-name>Suchen Sie nach einem Failed-Event mit einer Meldung wie Failed to pull image ...: unauthorized oder ... no such host. Diese Meldung liefert meistens schon die Antwort.
c. kubelet- und containerd-Logs auf dem Node prüfen: Reicht die Event-Meldung nicht aus, liefern die Logs auf dem betroffenen Node mehr Details. Lesen Sie auf dem Node das kubelet-Log mit journalctl -u kubelet und auf demselben Weg das containerd-Log für die Sicht der Runtime auf den Pull.
d. Den Pull mit crictl pull vom Node aus reproduzieren: Um zu prüfen, ob das Problem auf dem Node selbst liegt, pullen Sie das Image direkt mit crictl, dem CRI-Debugging-Tool, auf dem Node:
crictl pull <image>Schlägt das mit demselben Fehler fehl, liegt das Problem auf Node-Ebene – etwa Netzwerk, Zugangsdaten oder TLS-Vertrauen – und nicht am Pod-Spec.
So beheben Sie ErrImagePull
Kennen Sie die Ursache, ist die Lösung meist unkompliziert. Hier die Lösungen für die genannten Ursachen:
a. Image-Referenz korrigieren und auf einen Digest pinnen: Beheben Sie zunächst Tippfehler in Repository, Tag oder Registry-Pfad. Für Produktions-Workloads gehen Sie einen Schritt weiter und pinnen das Image auf einen Digest (repository@sha256:<digest>) statt auf einen veränderlichen Tag – so pullt der Pod immer exakt das Image, das Sie getestet haben.
b. Ein imagePullSecret erstellen und anhängen: Für eine private Registry erstellen Sie ein Pull-Secret und geben es dem Pod mit. Secret erstellen:
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>Referenzieren Sie es anschließend im Pod-Spec unter imagePullSecrets oder hängen Sie es an den ServiceAccount des Pods, damit jeder Pod mit diesem Account es automatisch erhält. Das Secret muss im selben Namespace liegen wie der Pod.
c. Node-Netzwerk, Proxy-Einstellungen und CA-Vertrauen korrigieren: Bei Netzwerkursachen stellen Sie sicher, dass der Node die Registry auflösen und erreichen kann. Nutzt der Node einen Proxy, konfigurieren Sie die Container-Runtime entsprechend. Bei einem TLS-Fehler fügen Sie das CA-Zertifikat der Registry dem Trust Store des Nodes oder der Runtime-Konfiguration hinzu, damit sie der Registry vertraut.
d. Registry-Mirror oder Pull-Through-Cache einrichten: Um Rate-Limits zu vermeiden, sollten Sie dieselben öffentlichen Images nicht immer wieder aus dem Internet pullen. Ein Pull-Through-Cache oder Registry-Mirror (zum Beispiel ein ECR-Pull-Through-Cache) hält Images näher an Ihrem Cluster vor, und authentifizierte Pulls erhöhen zusätzlich Ihr Limit.
e. Speicherplatz freigeben und Image Garbage Collection anpassen: Bei Disk Pressure geben Sie Platz auf dem Node frei und lassen das kubelet ungenutzte Images aufräumen. Die Image Garbage Collection des kubelet wird über imageGCHighThresholdPercent (Standard 85) und imageGCLowThresholdPercent (Standard 80) gesteuert: Überschreitet die Speichernutzung den oberen Schwellenwert, entfernt das kubelet ungenutzte Images, bis der untere erreicht ist. Ein niedrigerer Schwellenwert lässt die Bereinigung früher starten und verhindert, dass Nodes volllaufen.
ErrImagePull in Managed- und lokalen Clustern
Manche Umgebungen behandeln Image-Zugangsdaten unterschiedlich – hier die häufigsten Fälle im Überblick:
a. Amazon EKS pullt aus ECR: Der Node oder Pod benötigt AWS-Berechtigungen für den Pull aus ECR statt eines Docker-Pull-Secrets. Die IAM-Rolle des Nodes kann die Policy AmazonEC2ContainerRegistryReadOnly verwenden. Für stärker eingeschränkten Zugriff nutzen Sie IRSA oder EKS Pod Identity, um bestimmten Workloads Zugriff zu geben. ECR-Tokens sind kurzlebig, das kubelet erneuert sie jedoch automatisch.
b. GKE pullt aus Artifact Registry: Der Service Account des Nodes benötigt die Rolle Artifact Registry Reader. Für Zugriff auf Workload-Ebene verbinden Sie über Workload Identity einen Kubernetes-Service-Account mit einem Google-Service-Account, der die Reader-Rolle besitzt.
c. Lokale Cluster wie minikube und kind: Ein auf Ihrem Laptop gebautes Image ist auf den Nodes des Clusters unter Umständen nicht verfügbar. Laden Sie das Image direkt in den Cluster, statt es in eine Registry zu pushen. Mit minikube nutzen Sie minikube image load <image>, mit kind kind load docker-image <image>. Setzen Sie anschließend imagePullPolicy auf IfNotPresent oder Never, damit Kubernetes das lokale Image verwendet.
Wie Pods im ImagePullBackOff Node-Kapazität und Budget verschwenden
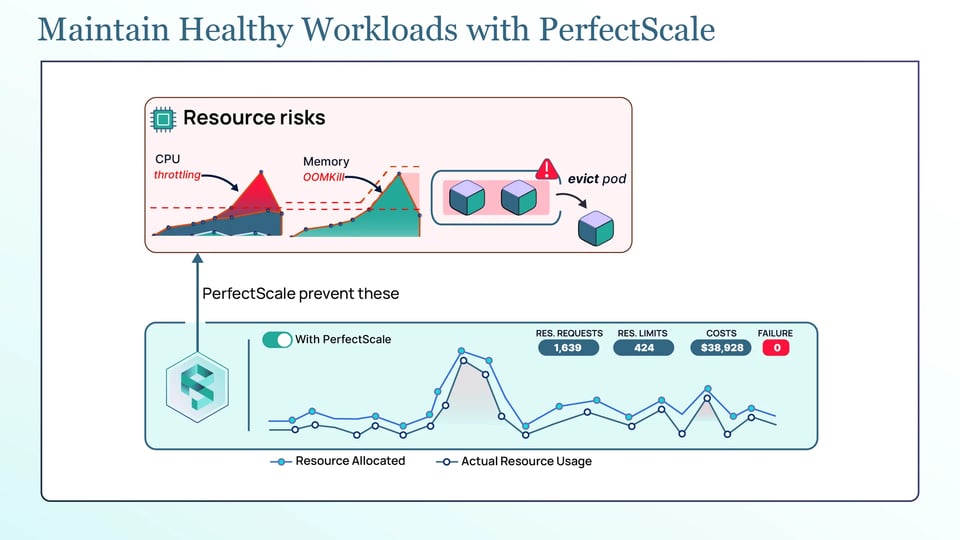
Erreicht ein Pod den Zustand ImagePullBackOff, wurde er bereits auf einen Node geplant. Seine CPU- und Speicher-Requests zählen zur reservierten Kapazität des Nodes, und diese Reservierung bleibt bestehen, solange der Pod auf das Image wartet. Der Node hält also Kapazität für einen Pod vor, der keinerlei Arbeit leistet.
Ein einzelner festhängender Pod fällt kaum ins Gewicht. Ein Rollout mit vielen festhängenden Replikas oder Pods mit überdimensionierten Resource-Requests kann jedoch erhebliche Kapazität blockieren. In einem Cluster mit Autoscaling kann das sogar dazu führen, dass der Cluster Autoscaler zusätzliche Nodes bereitstellt, um Platz für andere Workloads zu schaffen. Am Ende zahlen Sie für Kapazität, während die festhängenden Pods nichts tun.
Weil das kubelet den Image-Pull immer wieder versucht, kann diese verschwendete Kapazität bestehen bleiben, bis das Image-Problem behoben oder der Pod entfernt ist.
Genau hier hilft PerfectScale auf der Kostenseite. Die Kubernetes-Governance-Plattform von PerfectScale macht sichtbar, wie Ihre Workloads CPU und Speicher tatsächlich nutzen, und leitet daraus umsetzbare, automatisierte Right-Sizing-Empfehlungen ab, die Sie manuell oder autonom anwenden können. Passgenaue Requests bedeuten, dass ein festhängender Pod nur das reserviert, was er wirklich braucht – statt einer überdimensionierten Menge. Teams wie Paramount Pictures und Creditas setzen auf PerfectScale, um ihre Cluster effizient zu halten. Sie können sich registrieren oder eine technische Session buchen.
Best Practices zur Vermeidung von ErrImagePull-Fehlern
Die wichtigsten Maßnahmen, um ErrImagePull-Fehlern vorzubeugen:
a. Produktions-Workloads auf Image-Digests statt auf veränderliche Tags pinnen: Ein Digest (@sha256:...) zeigt immer auf exakt das getestete Image – Änderungen an einem Tag können das Image, das Ihre Pods pullen, nicht mehr verändern.
b. Multi-Architektur-Images für Node-Pools mit gemischten CPUs veröffentlichen: Enthalten Ihre Nodes sowohl amd64 als auch arm64, nutzen Sie Multi-Architektur-Images, damit jeder Node die passende Version pullen kann.
c. Image-Referenzen in der CI validieren und Admission-Policies nutzen: Prüfen Sie Image-Namen und Tags vor dem Deployment. Admission-Policies können außerdem Image-Digests erzwingen oder nur Images aus freigegebenen Registries zulassen.
d. Kritische Images vor einem Rollout vorab pullen: Ziehen Sie wichtige Images im Voraus auf die Nodes, etwa per DaemonSet, damit das Rollout nicht davon abhängt, das Image beim Start zu pullen.
e. Alerts für Image-Pull-Fehler, Disk Pressure auf Nodes und Image Garbage Collection einrichten: Frühzeitige Alerts bei fehlgeschlagenen Pulls, knappem Speicherplatz und Image Garbage Collection helfen, Probleme zu erkennen, bevor sie weitere Pods oder Nodes betreffen.