


ErrImagePull é o erro que o Kubernetes exibe quando o kubelet não consegue fazer o pull da imagem de contêiner de um pod. O contêiner roda a partir da imagem, então, se o kubelet não conseguir baixá-la, o contêiner nunca inicia. Normalmente você vê isso como um pod travado em ErrImagePull ou ImagePullBackOff, sem nenhum log da aplicação para explicar o problema — afinal, a aplicação ainda nem rodou.
Neste guia, você vai aprender o que significa ErrImagePull, qual a diferença para o ImagePullBackOff, como o Kubernetes faz o pull de imagens, as causas mais comuns, como diagnosticar a falha e como corrigi-la. Você também vai ver como pods travados podem desperdiçar capacidade dos nós.
O que é o erro ErrImagePull no Kubernetes?
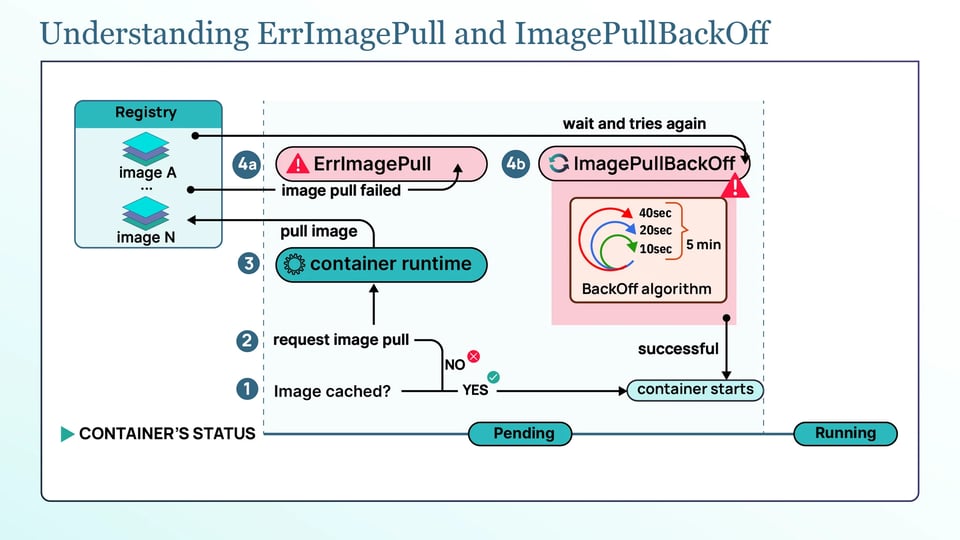
ErrImagePull significa que uma única tentativa de pull da imagem falhou. Quando você cria um pod, o kubelet no nó do pod pede ao runtime de contêiner que faça o pull da imagem indicada na spec do pod. Se esse pull falhar por qualquer motivo, o estado do contêiner passa a ser ErrImagePull, e o contêiner fica aguardando em vez de iniciar.
O ponto importante é que o ErrImagePull diz respeito a obter a imagem, não a executá-la. A aplicação não chegou a iniciar, então o kubectl logs não tem nada a mostrar. O motivo da falha está nos eventos do pod.
ErrImagePull vs. ImagePullBackOff
ErrImagePull significa que o kubelet tentou fazer o pull da imagem do contêiner e a tentativa falhou. Ele não desiste: após a falha, o kubelet aguarda antes de tentar o pull novamente.
ImagePullBackOff significa que o kubelet está aguardando antes de uma nova tentativa de pull. O intervalo entre as tentativas aumenta após falhas repetidas.
O backoff começa em cerca de 10 segundos e cresce exponencialmente: aproximadamente 10 segundos, 20 segundos, 40 segundos e assim por diante. Ele é limitado a 5 minutos (300 segundos). Uma vez atingido o intervalo máximo, o kubelet continua tentando novamente a cada 5 minutos, aproximadamente.
O pod não desaparece sozinho. Ele permanece nesse ciclo até que o pull da imagem se torne possível, o problema subjacente seja corrigido ou o pod seja excluído.
Como o Kubernetes faz o pull de imagens de contêiner?
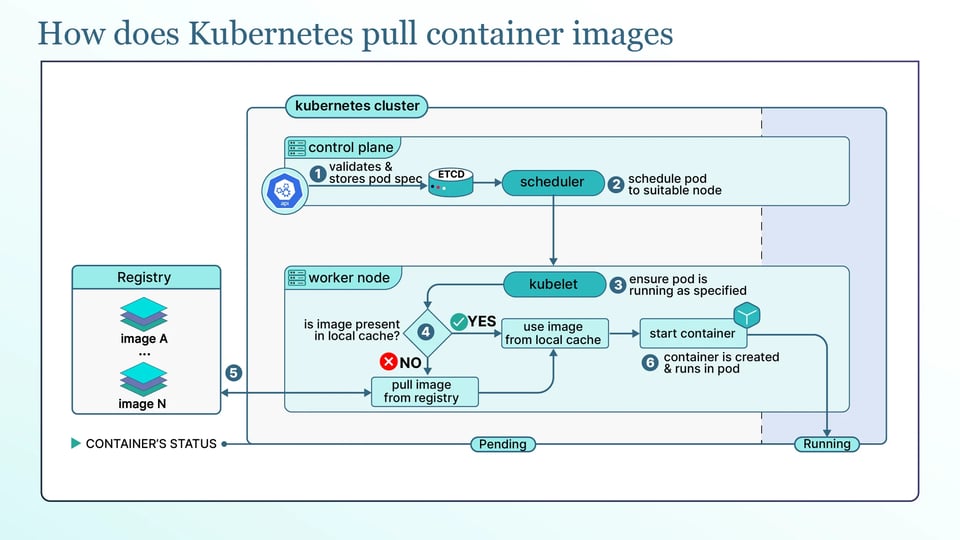
A maioria dos erros ErrImagePull fica mais fácil de entender quando você sabe como o Kubernetes faz o pull de uma imagem. Quando um pod é agendado em um nó, o kubelet desse nó pede ao runtime de contêiner (como containerd ou CRI-O) que garanta a presença da imagem. O runtime primeiro verifica a política de pull da imagem e se a imagem já está no nó. Se precisar fazer o pull, ele contata o registry, autentica-se caso o registry seja privado, baixa as camadas da imagem e as descompacta. Só depois que a imagem está pronta é que o contêiner inicia. Uma falha em qualquer uma dessas etapas — como um nome incorreto, uma credencial ausente ou um problema de rede — aparece como ErrImagePull.
A política de pull da imagem controla quando o Kubernetes faz o pull. Existem três opções:
a. Always faz o pull da imagem toda vez que o pod inicia. É o padrão quando a imagem usa a tag :latest ou não tem tag.
b. IfNotPresent faz o pull da imagem apenas quando ela ainda não está no nó. É o padrão para imagens com qualquer outra tag.
c. Never instrui o runtime a usar somente uma imagem que já esteja no nó. Ele nunca faz o pull. Se a imagem não estiver disponível localmente, você recebe o erro ErrImageNeverPull.
A referência da imagem controla exatamente qual imagem será baixada. Ela inclui um repositório e uma tag ou um digest, escrito como repository:tag ou repository@sha256:<digest>. Uma tag como :1.4 é mutável, ou seja, a imagem para a qual ela aponta pode mudar ao longo do tempo. Um digest é um ID único de uma imagem, então ele sempre aponta para a mesma imagem.
Causas comuns do ErrImagePull
O ErrImagePull geralmente vem dos seguintes problemas comuns:
a. Nome de imagem, repositório ou tag incorretos: um erro de digitação no nome da imagem, o caminho errado do registry ou uma tag que não existe fazem o pull falhar. A mensagem costuma ser algo como manifest unknown ou repository does not exist or may require authorization. Essa é a primeira coisa a verificar.
b. Credenciais de registry ausentes, incorretas ou expiradas: um registry privado exige credenciais e, se elas estiverem ausentes ou incorretas, o pull falha com unauthorized: authentication required. As variações mais comuns são um pull secret que nunca foi vinculado ao pod, um secret no namespace errado ou um token expirado. Os tokens do Amazon ECR, por exemplo, têm vida curta, então uma configuração que fazia pull sem problemas ontem pode falhar hoje se a renovação do token não estiver configurada.
c. Rate limits do registry e throttling de pull: registries públicos limitam a frequência dos pulls. O Docker Hub retorna toomanyrequests (uma resposta 429) quando você ultrapassa o limite. Atualmente, pulls anônimos estão limitados a 100 a cada 6 horas por endereço IP, contas gratuitas autenticadas têm 200 a cada 6 horas e contas pagas são ilimitadas. O número amplamente divulgado de "10 pulls por hora" chegou a ser anunciado, mas nunca entrou em vigor, então o limite atual é de 100 a cada 6 horas. Em um cluster movimentado atrás de um único IP público, é mais fácil atingir esse limite do que parece.
d. Rede do nó, DNS ou proxy bloqueando o registry: se o nó não consegue alcançar o registry, o pull falha com erros como dial tcp: lookup ... no such host ou i/o timeout. Isso acontece com DNS quebrado, um proxy corporativo que o runtime desconhece, uma regra de firewall ou um cluster isolado (air-gapped) sem rota para um registry público.
e. Erros de certificado TLS com registries privados: um registry privado que usa certificado autoassinado ou não confiável faz o pull falhar com x509: certificate signed by unknown authority. O runtime de contêiner do nó não confia no certificado do registry e, por isso, recusa a conexão.
f. Arquitetura da imagem incompatível com a CPU do nó: uma imagem compilada apenas para amd64 não roda em um nó arm64, e o pull falha com no matching manifest for linux/arm64. Isso é comum em clusters com CPUs mistas e em nós baseados em Arm.
g. Pressão de disco no nó e espaço insuficiente para as camadas da imagem: as camadas da imagem precisam de espaço no nó. Se o nó estiver com pouco disco, o pull falha com no space left on device, e o nó também pode entrar em condição de disk pressure, o que impede que novos pods sejam agendados nele.
Como diagnosticar um erro ErrImagePull?
Encontrar a causa é, em grande parte, uma questão de ler a saída certa na seguinte ordem:
a. Leia o status do pod com kubectl get pods: isso confirma o sintoma. O STATUS do pod mostra ErrImagePull ou ImagePullBackOff, e um contador de RESTARTS crescente ou a idade do pod indicam que ele está travado há algum tempo.
kubectl get pods
b. Encontre o erro real no kubectl describe pod: este é o passo-chave. A seção Events: na saída do kubectl describe pod mostra o erro real do pull da imagem, o que geralmente revela com qual causa você está lidando.
kubectl describe pod <pod-name>Procure um evento Failed com uma mensagem como Failed to pull image ...: unauthorized ou ... no such host. Na maioria das vezes, essa mensagem é a resposta.
c. Verifique os logs do kubelet e do containerd no nó: se a mensagem do evento não for suficiente, os logs no nó agendado têm mais detalhes. No nó, leia o log do kubelet com journalctl -u kubelet e o log do containerd da mesma forma, para ter a visão do runtime sobre o pull.
d. Reproduza o pull a partir do nó com crictl pull: para confirmar se o problema está no próprio nó, faça o pull da imagem diretamente com o crictl, a ferramenta de depuração da CRI, no nó:
crictl pull <image>Se isso falhar com o mesmo erro, o problema está no nível do nó — como rede, credenciais ou confiança TLS — e não em algo na spec do pod.
Como corrigir o ErrImagePull?
Depois que você conhece a causa, a correção costuma ser simples. Aqui estão as correções para as causas acima:
a. Corrija a referência da imagem e fixe-a em um digest: primeiro, corrija qualquer erro de digitação no repositório, na tag ou no caminho do registry. Para workloads de produção, vá além e fixe a imagem em um digest (repository@sha256:<digest>) em vez de uma tag mutável, para que o pod sempre faça o pull da imagem exata que você testou.
b. Crie um imagePullSecret e vincule-o: para um registry privado, crie um pull secret e forneça-o ao pod. Crie o secret:
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>Em seguida, referencie-o na spec do pod em imagePullSecrets ou vincule-o à ServiceAccount do pod para que todo pod que use essa conta o receba automaticamente. O secret precisa estar no mesmo namespace que o pod.
c. Corrija a rede do nó, as configurações de proxy e a confiança na CA: para causas de rede, garanta que o nó consiga resolver e alcançar o registry. Se o nó usa um proxy, configure o runtime de contêiner para usá-lo. Para um erro de TLS, adicione o certificado da CA do registry ao trust store do nó ou à configuração do runtime, para que ele passe a confiar no registry.
d. Configure um mirror de registry ou um pull-through cache: para evitar rate limits, pare de fazer o pull das mesmas imagens públicas repetidamente da internet. Um pull-through cache ou mirror de registry (por exemplo, um pull-through cache do ECR) armazena as imagens mais perto do seu cluster, e autenticar seus pulls também aumenta seu limite.
e. Libere espaço em disco e ajuste o garbage collection de imagens: para pressão de disco, libere espaço no nó e deixe o kubelet limpar imagens não utilizadas. O garbage collection de imagens do kubelet é controlado por imageGCHighThresholdPercent (padrão 85) e imageGCLowThresholdPercent (padrão 80): quando o uso de disco ultrapassa o limite superior, o kubelet remove imagens não utilizadas até atingir o limite inferior. Um limite mais baixo faz a limpeza começar mais cedo, ajudando a evitar que os nós fiquem cheios.
ErrImagePull em clusters gerenciados e locais
Alguns ambientes tratam as credenciais de imagem de forma diferente, então vale conhecer os casos mais comuns:
a. Amazon EKS fazendo pull do ECR: o nó ou o pod precisa de permissões da AWS para fazer pull do ECR, em vez de um pull secret do Docker. A role IAM do nó pode usar a política AmazonEC2ContainerRegistryReadOnly. Para acesso mais restrito, use IRSA ou EKS Pod Identity para conceder acesso a workloads específicos. Os tokens do ECR têm vida curta, mas o kubelet os renova automaticamente.
b. GKE fazendo pull do Artifact Registry: a service account do nó precisa da role Artifact Registry Reader. Para acesso no nível do workload, use o Workload Identity para conectar uma service account do Kubernetes a uma service account do Google com a role Reader.
c. Clusters locais como minikube e kind: uma imagem construída no seu notebook pode não estar disponível nos nós do cluster. Carregue a imagem diretamente no cluster em vez de enviá-la a um registry. Com o minikube, use minikube image load <image>. Com o kind, use kind load docker-image <image>. Depois, defina imagePullPolicy como IfNotPresent ou Never para que o Kubernetes use a imagem local.
Como pods travados em ImagePullBackOff desperdiçam capacidade dos nós e orçamento?
Quando um pod chega ao estado ImagePullBackOff, ele já foi agendado em um nó. Seus requests de CPU e memória contam para a capacidade reservada do nó, e essa reserva permanece enquanto o pod aguarda a imagem. Ou seja, o nó está segurando capacidade para um pod que não faz trabalho nenhum.
Um único pod travado pode não fazer muita diferença. Mas um rollout com muitas réplicas travadas, ou pods com requests de recursos superdimensionados, pode reservar uma quantidade significativa de capacidade. Em um cluster com autoscaling, isso pode até fazer o Cluster Autoscaler adicionar nós para abrir espaço para outros workloads. No fim, você paga por capacidade enquanto os pods travados não fazem nada.
Como o kubelet continua tentando o pull da imagem, essa capacidade desperdiçada pode permanecer até que o problema da imagem seja corrigido ou o pod seja removido.
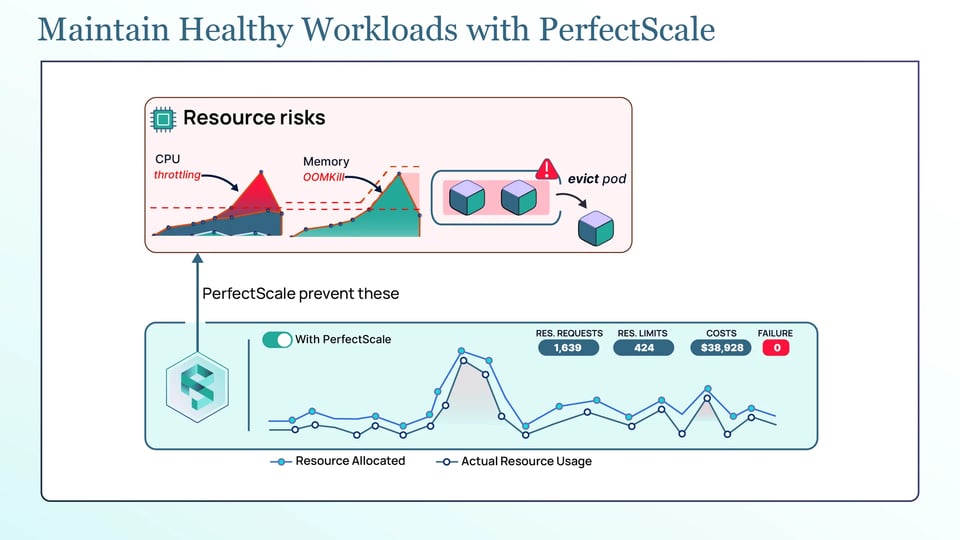
É aqui que a PerfectScale ajuda no lado dos custos. A plataforma de governança de Kubernetes da PerfectScale oferece visibilidade de como seus workloads realmente usam CPU e memória e transforma isso em recomendações de right-sizing acionáveis e automatizadas, que você pode aplicar manualmente ou de forma autônoma. Requests bem dimensionados fazem com que um pod travado reserve apenas o que realmente precisa, e não um volume superdimensionado. Equipes como Paramount Pictures e Creditas usam a PerfectScale para manter seus clusters eficientes. Você pode criar sua conta ou agendar uma sessão técnica.
Boas práticas para prevenir erros ErrImagePull
Estas são as principais práticas para prevenir erros ErrImagePull:
a. Fixe workloads de produção em digests de imagem em vez de tags mutáveis: um digest (@sha256:...) sempre aponta para a imagem exata que você testou, então mudanças em uma tag não podem alterar a imagem que seus pods baixam.
b. Publique imagens multiarquitetura para pools de nós com CPUs mistas: se seus nós incluem tanto amd64 quanto arm64, use imagens multiarquitetura para que cada nó possa fazer o pull da versão correta.
c. Valide referências de imagem na CI e use políticas de admissão: verifique nomes e tags de imagens antes do deploy. Políticas de admissão também podem exigir digests de imagem ou permitir imagens apenas de registries aprovados.
d. Faça o pré-pull de imagens críticas antes de um rollout: baixe as imagens importantes nos nós com antecedência, por exemplo, com um DaemonSet, para que o rollout não dependa do pull da imagem na inicialização.
e. Configure alertas para falhas de pull de imagem, pressão de disco nos nós e garbage collection de imagens: alertas antecipados para pulls com falha, pouco espaço em disco e garbage collection de imagens ajudam a identificar problemas antes que eles afetem mais pods ou nós.