


ErrImagePull est l'erreur que Kubernetes affiche lorsque le kubelet ne parvient pas à récupérer l'image de conteneur d'un pod. C'est à partir de cette image que le conteneur s'exécute : si le kubelet ne peut pas la télécharger, le conteneur ne démarre jamais. Vous verrez généralement un pod bloqué en ErrImagePull ou ImagePullBackOff, sans aucun log applicatif pour l'expliquer, puisque l'application ne s'est pas encore exécutée.
Dans ce guide, vous découvrirez ce que signifie ErrImagePull, en quoi il diffère d'ImagePullBackOff, comment Kubernetes récupère les images, les causes courantes, comment diagnostiquer l'échec et comment le corriger. Vous verrez aussi comment des pods bloqués peuvent gaspiller la capacité des nœuds.
Que signifie l'erreur ErrImagePull dans Kubernetes ?
ErrImagePull signifie qu'une tentative de pull d'image a échoué. Lorsque vous créez un pod, le kubelet du nœud concerné demande au runtime de conteneurs de récupérer l'image indiquée dans la spécification du pod. Si ce pull échoue, quelle qu'en soit la raison, l'état du conteneur passe à ErrImagePull et le conteneur attend au lieu de démarrer.
Le point important : ErrImagePull concerne la récupération de l'image, pas son exécution. L'application n'a pas démarré, donc kubectl logs n'affiche rien. La raison de l'échec se trouve dans les événements du pod.
ErrImagePull et ImagePullBackOff : quelle différence ?
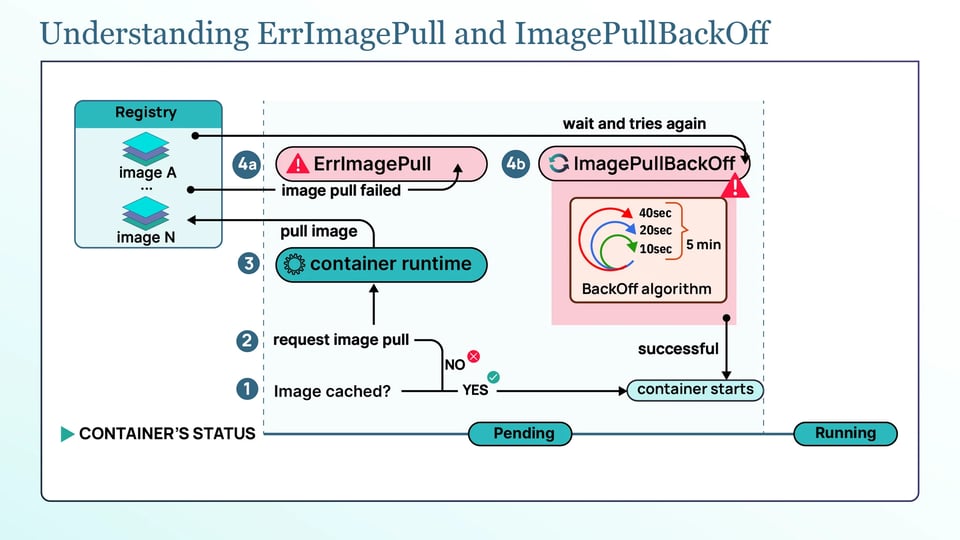
ErrImagePull signifie que le kubelet a tenté de récupérer l'image du conteneur et que la tentative a échoué. Il n'abandonne pas pour autant : après l'échec, il patiente avant de tenter à nouveau le pull.
ImagePullBackOff signifie que le kubelet attend avant une nouvelle tentative de pull. Le délai entre les tentatives augmente au fil des échecs répétés.
Le backoff démarre à environ 10 secondes et augmente de façon exponentielle : environ 10 secondes, 20 secondes, 40 secondes, etc. Il est plafonné à 5 minutes (300 secondes). Une fois le délai maximal atteint, le kubelet continue de réessayer environ toutes les 5 minutes.
Le pod ne disparaît pas automatiquement. Il reste dans ce cycle jusqu'à ce que l'image devienne récupérable, que le problème sous-jacent soit corrigé ou que le pod soit supprimé.
Comment Kubernetes récupère-t-il les images de conteneurs ?
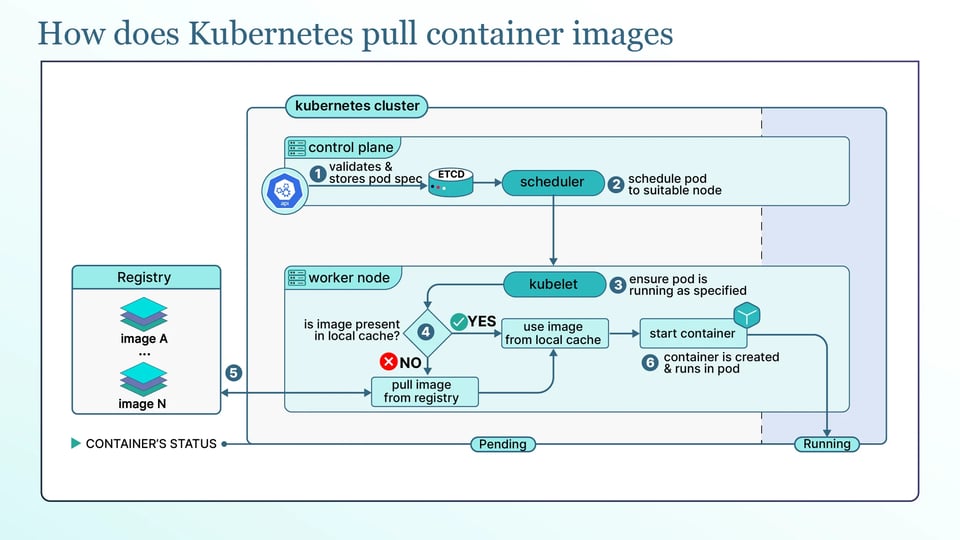
La plupart des erreurs ErrImagePull sont plus faciles à comprendre une fois que l'on sait comment Kubernetes récupère une image. Lorsqu'un pod est planifié sur un nœud, le kubelet de ce nœud demande au runtime de conteneurs (comme containerd ou CRI-O) de s'assurer que l'image est présente. Le runtime vérifie d'abord la politique de pull d'image et si l'image se trouve déjà sur le nœud. S'il doit la récupérer, il contacte le registre, s'authentifie si le registre est privé, télécharge les couches de l'image et les décompresse. Le conteneur ne démarre qu'une fois l'image prête. Un échec à n'importe laquelle de ces étapes — nom incorrect, identifiant manquant, problème réseau — se traduit par ErrImagePull.
La politique de pull d'image détermine quand Kubernetes récupère une image. Trois options existent :
a. Always récupère l'image à chaque démarrage du pod. C'est la valeur par défaut lorsque l'image utilise le tag :latest ou n'a pas de tag.
b. IfNotPresent récupère l'image uniquement si elle n'est pas déjà présente sur le nœud. C'est la valeur par défaut pour les images avec tout autre tag.
c. Never indique au runtime d'utiliser uniquement une image déjà présente sur le nœud. Il ne récupère jamais l'image. Si l'image n'est pas disponible localement, vous obtenez l'erreur ErrImageNeverPull.
La référence d'image détermine exactement quelle image est récupérée. Elle comprend un dépôt et soit un tag, soit un digest, sous la forme repository:tag ou repository@sha256:<digest>. Un tag comme :1.4 est mutable : l'image vers laquelle il pointe peut changer au fil du temps. Un digest est un identifiant unique d'une image, il pointe donc toujours vers la même image.
Causes courantes d'ErrImagePull
ErrImagePull provient généralement des problèmes courants suivants :
a. Nom d'image, dépôt ou tag incorrect : une faute de frappe dans le nom de l'image, un mauvais chemin de registre ou un tag inexistant font échouer le pull. Le message ressemble généralement à manifest unknown ou repository does not exist or may require authorization. C'est la première chose à vérifier.
b. Identifiants de registre manquants, incorrects ou expirés : un registre privé exige des identifiants ; s'ils sont manquants ou incorrects, le pull échoue avec unauthorized: authentication required. Les cas les plus fréquents : un pull secret jamais rattaché au pod, un secret dans le mauvais namespace ou un token expiré. Les tokens Amazon ECR, par exemple, ont une durée de vie courte : une configuration qui fonctionnait parfaitement hier peut échouer aujourd'hui si le renouvellement du token n'est pas configuré.
c. Limites de débit et throttling des registres : les registres publics limitent la fréquence des pulls. Docker Hub renvoie toomanyrequests (une réponse 429) une fois sa limite dépassée. À ce jour, les pulls anonymes sont limités à 100 par tranche de 6 heures et par adresse IP, les comptes gratuits authentifiés bénéficient de 200 par 6 heures, et les comptes payants sont illimités. Le chiffre largement relayé de 10 pulls par heure a été annoncé mais jamais appliqué : la limite actuelle est bien de 100 par 6 heures. Sur un cluster chargé derrière une seule IP publique, cette limite est plus vite atteinte qu'on ne le pense.
d. Réseau du nœud, DNS ou proxy bloquant le registre : si le nœud ne peut pas joindre le registre, le pull échoue avec des erreurs comme dial tcp: lookup ... no such host ou i/o timeout. Cela arrive avec un DNS défaillant, un proxy d'entreprise inconnu du runtime, une règle de pare-feu ou un cluster isolé (air-gapped) sans route vers un registre public.
e. Erreurs de certificat TLS avec les registres privés : un registre privé utilisant un certificat auto-signé ou non approuvé fait échouer le pull avec x509: certificate signed by unknown authority. Le runtime de conteneurs du nœud ne fait pas confiance au certificat du registre et refuse donc la connexion.
f. Architecture d'image incompatible avec le CPU du nœud : une image compilée uniquement pour amd64 ne s'exécutera pas sur un nœud arm64, et le pull échoue avec no matching manifest for linux/arm64. C'est fréquent dans les clusters à CPU mixtes et sur les nœuds Arm.
g. Pression disque sur le nœud et espace insuffisant pour les couches d'image : les couches d'image ont besoin d'espace sur le nœud. Si le disque est presque plein, le pull échoue avec no space left on device, et le nœud peut aussi présenter une condition de pression disque qui empêche de nouveaux pods d'y être planifiés.
Comment diagnostiquer une erreur ErrImagePull ?
Trouver la cause consiste surtout à lire la bonne sortie, dans l'ordre suivant :
a. Lisez le statut du pod avec kubectl get pods : cela confirme le symptôme. Le STATUS du pod affiche ErrImagePull ou ImagePullBackOff, et un compteur RESTARTS qui augmente ou l'ancienneté du pod vous indique qu'il est bloqué depuis un moment.
kubectl get pods
b. Trouvez l'erreur réelle avec kubectl describe pod : c'est l'étape clé. La section Events: de la sortie de kubectl describe pod affiche l'erreur de pull d'image réelle, qui indique généralement à quelle cause vous avez affaire.
kubectl describe pod <pod-name>Recherchez un événement Failed avec un message tel que Failed to pull image ...: unauthorized ou ... no such host. Ce message contient la réponse dans la plupart des cas.
c. Consultez les logs du kubelet et de containerd sur le nœud : si le message de l'événement ne suffit pas, les logs du nœud concerné apportent plus de détails. Sur le nœud, lisez le log du kubelet avec journalctl -u kubelet, et le log de containerd de la même manière pour avoir la vue côté runtime.
d. Reproduisez le pull depuis le nœud avec crictl pull : pour confirmer si le problème vient du nœud lui-même, récupérez l'image directement avec crictl, l'outil de débogage CRI, sur le nœud :
crictl pull <image>Si cette commande échoue avec la même erreur, le problème se situe au niveau du nœud (réseau, identifiants ou confiance TLS) plutôt que dans la spécification du pod.
Comment corriger ErrImagePull ?
Une fois la cause identifiée, la correction est généralement simple. Voici les correctifs pour les causes ci-dessus :
a. Corrigez la référence d'image et figez-la sur un digest : corrigez d'abord toute faute de frappe dans le dépôt, le tag ou le chemin du registre. Pour les workloads de production, allez plus loin en figeant l'image sur un digest (repository@sha256:<digest>) plutôt qu'un tag mutable, afin que le pod récupère toujours exactement l'image que vous avez testée.
b. Créez un imagePullSecret et rattachez-le : pour un registre privé, créez un pull secret et fournissez-le au pod. Créez le secret :
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>Référencez-le ensuite dans la spécification du pod sous imagePullSecrets, ou rattachez-le au ServiceAccount du pod pour que chaque pod utilisant ce compte le reçoive automatiquement. Le secret doit se trouver dans le même namespace que le pod.
c. Corrigez le réseau du nœud, les paramètres de proxy et la confiance CA : pour les causes réseau, assurez-vous que le nœud peut résoudre et joindre le registre. Si le nœud utilise un proxy, configurez le runtime de conteneurs pour l'utiliser. Pour une erreur TLS, ajoutez le certificat CA du registre au magasin de confiance du nœud ou à la configuration du runtime afin qu'il fasse confiance au registre.
d. Mettez en place un miroir de registre ou un cache pull-through : pour éviter les limites de débit, évitez de récupérer sans cesse les mêmes images publiques depuis Internet. Un cache pull-through ou un miroir de registre (par exemple un cache pull-through ECR) stocke les images au plus près de votre cluster, et l'authentification de vos pulls relève également votre limite.
e. Libérez de l'espace disque et ajustez le garbage collection des images : en cas de pression disque, libérez de l'espace sur le nœud et laissez le kubelet nettoyer les images inutilisées. Le mécanisme de garbage collection des images du kubelet est contrôlé par imageGCHighThresholdPercent (85 par défaut) et imageGCLowThresholdPercent (80 par défaut) : lorsque l'utilisation du disque dépasse le seuil haut, le kubelet supprime les images inutilisées jusqu'à atteindre le seuil bas. Un seuil plus bas déclenche le nettoyage plus tôt et aide à éviter que les nœuds ne se remplissent.
ErrImagePull dans les clusters managés et locaux
Certains environnements gèrent les identifiants d'images différemment ; il est donc utile de connaître les cas courants :
a. Amazon EKS avec ECR : le nœud ou le pod a besoin de permissions AWS pour récupérer les images depuis ECR, plutôt que d'un pull secret Docker. Le rôle IAM du nœud peut utiliser la politique AmazonEC2ContainerRegistryReadOnly. Pour un accès plus restreint, utilisez IRSA ou EKS Pod Identity afin de donner accès à des workloads spécifiques. Les tokens ECR ont une durée de vie courte, mais le kubelet les renouvelle automatiquement.
b. GKE avec Artifact Registry : le compte de service du nœud a besoin du rôle Artifact Registry Reader. Pour un accès au niveau des workloads, utilisez Workload Identity afin de relier un compte de service Kubernetes à un compte de service Google disposant du rôle Reader.
c. Clusters locaux comme minikube et kind : une image construite sur votre machine peut ne pas être disponible sur les nœuds du cluster. Chargez l'image directement dans le cluster au lieu de la pousser vers un registre. Avec minikube, utilisez minikube image load <image>. Avec kind, utilisez kind load docker-image <image>. Définissez ensuite imagePullPolicy sur IfNotPresent ou Never pour que Kubernetes utilise l'image locale.
Comment les pods bloqués en ImagePullBackOff gaspillent la capacité des nœuds et le budget
Lorsqu'un pod atteint ImagePullBackOff, il a déjà été planifié sur un nœud. Ses requêtes CPU et mémoire comptent dans la capacité réservée du nœud, et cette réservation persiste tant que le pod attend l'image. Le nœud immobilise donc de la capacité pour un pod qui ne fait aucun travail.
Un seul pod bloqué n'a pas grande importance. Mais un déploiement avec de nombreux réplicas bloqués, ou des pods aux requêtes de ressources surdimensionnées, peut réserver une capacité considérable. Dans un cluster avec autoscaling, cela peut même amener le Cluster Autoscaler à ajouter des nœuds pour faire de la place à d'autres workloads. Vous finissez par payer de la capacité pendant que les pods bloqués ne font rien.
Comme le kubelet continue de réessayer le pull de l'image, cette capacité gaspillée peut perdurer jusqu'à ce que le problème d'image soit corrigé ou que le pod soit supprimé.
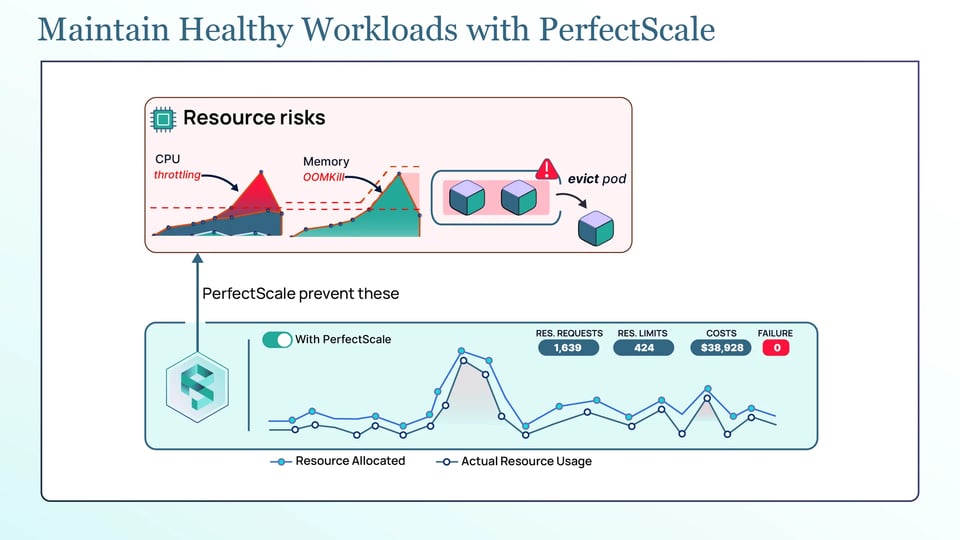
C'est là que PerfectScale vous aide sur le plan des coûts. La plateforme de gouvernance Kubernetes de PerfectScale vous donne de la visibilité sur l'utilisation réelle du CPU et de la mémoire par vos workloads, et la transforme en recommandations de right-sizing concrètes et automatisées, que vous pouvez appliquer manuellement ou de façon autonome. Avec des requêtes correctement dimensionnées, un pod bloqué ne réserve que ce dont il a réellement besoin, plutôt qu'une quantité surdimensionnée. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour maintenir l'efficacité de leurs clusters. Vous pouvez créer un compte ou réserver une session technique.
Bonnes pratiques pour prévenir les erreurs ErrImagePull
Voici les principales pratiques pour prévenir les erreurs ErrImagePull :
a. Figez les workloads de production sur des digests d'image plutôt que sur des tags mutables : un digest (@sha256:...) pointe toujours vers l'image exacte que vous avez testée ; une modification du tag ne peut donc pas changer l'image récupérée par vos pods.
b. Publiez des images multi-architectures pour les pools de nœuds à CPU mixtes : si vos nœuds incluent à la fois amd64 et arm64, utilisez des images multi-architectures afin que chaque nœud puisse récupérer la bonne version.
c. Validez les références d'images dans votre CI et utilisez des politiques d'admission : vérifiez les noms et tags d'images avant le déploiement. Les politiques d'admission peuvent aussi exiger des digests d'images ou n'autoriser que les images provenant de registres approuvés.
d. Pré-chargez les images critiques avant un déploiement : récupérez à l'avance les images importantes sur les nœuds, par exemple avec un DaemonSet, pour que le déploiement ne dépende pas du pull de l'image au démarrage.
e. Configurez des alertes sur les échecs de pull d'image, la pression disque des nœuds et le garbage collection des images : des alertes précoces sur les pulls échoués, l'espace disque faible et le garbage collection des images aident à identifier les problèmes avant qu'ils n'affectent davantage de pods ou de nœuds.