


¿Qué es el EKS Cluster Autoscaler?
El Amazon EKS Cluster Autoscaler es un controlador de Kubernetes que ajusta automáticamente la cantidad de nodos worker de tu clúster: detecta los pods pendientes que no se pueden programar por falta de recursos y termina los nodos subutilizados. La mayoría de los usuarios de Reddit r/aws coincide en que los grupos de Auto Scaling (ASG) predeterminados no bastan por sí solos para los workloads dinámicos de Kubernetes, lo que hace que el Cluster Autoscaler sea esencial para atender solicitudes de recursos en tiempo real.
Cómo funciona:
- Detección de pods no programables: Supervisa los pods que no se pueden ubicar por falta de recursos o por restricciones de programación.
- Selección del grupo de nodos de EKS a escalar: Simula la ubicación de los pods en los grupos de nodos disponibles y selecciona un grupo adecuado para agregar capacidad.
- Aumento de la capacidad del grupo de Auto Scaling de EC2: Eleva la capacidad deseada del grupo de Auto Scaling seleccionado para que nuevos nodos worker de EC2 se unan al clúster.
- Identificación de nodos subutilizados: Determina si los workloads de los nodos innecesarios pueden moverse a otro lugar según las solicitudes de recursos y los requisitos de programación.
- Reducción segura de nodos: Verifica que los pods movibles puedan reprogramarse antes de reducir la capacidad del grupo de nodos y terminar los nodos innecesarios.
Pasos clave de configuración:
- Configura los límites de escalado de los grupos de nodos de EKS: Define la capacidad mínima, máxima y deseada de cada grupo de nodos que el autoscaler pueda administrar.
- Configura los permisos de IAM para el Cluster Autoscaler: Otorga al autoscaler permiso para inspeccionar y modificar los grupos de Auto Scaling de EC2 correspondientes.
- Habilita el descubrimiento automático de grupos de nodos: Aplica las etiquetas requeridas a los grupos de Auto Scaling para que el autoscaler pueda descubrir los grupos de nodos de EKS elegibles.
- Despliega el Cluster Autoscaler: Instálalo en el clúster y configura AWS como proveedor de nube con los ajustes de descubrimiento automático adecuados.
- Alinea la versión del autoscaler con la versión de Kubernetes de EKS: Usa una versión del Cluster Autoscaler que coincida con la versión mayor y menor de Kubernetes del clúster.
- Verifica el funcionamiento del Cluster Autoscaler: Revisa el pod y los logs del autoscaler, y luego comprueba que los pods no programables activen el escalado de nodos como se espera.
Este artículo forma parte de una serie sobre la programación (scheduling) en Kubernetes
En este artículo:
- ¿Cómo funciona el EKS Cluster Autoscaler?
- Cómo configurar el Cluster Autoscaler en EKS
- EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
- EKS Cluster Autoscaler vs. EKS Auto Mode
- Buenas prácticas para el EKS Cluster Autoscaler
¿Cómo funciona el EKS Cluster Autoscaler?
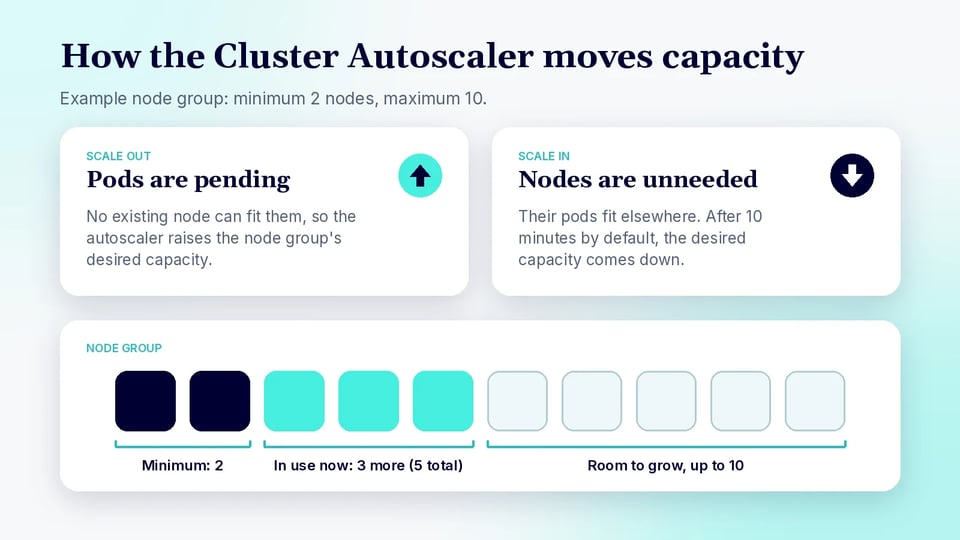
Detección de pods no programables
El Cluster Autoscaler consulta periódicamente la API de Kubernetes en busca de pods que el scheduler no puede ubicar en ningún nodo existente. Un pod puede volverse no programable cuando sus solicitudes de CPU, memoria, GPU u otros recursos no pueden satisfacerse, o cuando restricciones de programación como los node selectors, las reglas de afinidad y los taints limitan dónde puede ejecutarse.
De forma predeterminada, el Cluster Autoscaler analiza el clúster aproximadamente cada 10 segundos. Cuando encuentra pods no programables, determina si agregar capacidad a uno de los grupos de nodos configurados permitiría que esos pods se ejecuten.
Selección del grupo de nodos de EKS a escalar
Para cada pod no programable, el Cluster Autoscaler simula su programación en nodos nuevos hipotéticos de los grupos de nodos de EKS disponibles. Toma en cuenta factores como la capacidad de CPU y memoria del grupo de nodos, las etiquetas, los taints y otras propiedades de programación.
AWS recomienda que los nodos de un mismo grupo tengan características de programación idénticas. Por ejemplo, los tipos de instancia usados con una Mixed Instances Policy de EC2 deberían tener una capacidad similar de CPU, memoria y GPU, ya que el Cluster Autoscaler utiliza el primer tipo de instancia de la política al simular la programación. Una vez que identifica los grupos adecuados, la estrategia de expansión (expander) configurada determina qué grupo se debe aumentar.
Aumento de la capacidad del grupo de Auto Scaling de EC2
Después de seleccionar un grupo de nodos adecuado, el Cluster Autoscaler aumenta su capacidad deseada. Los grupos de nodos de EKS están respaldados por grupos de Auto Scaling de EC2, por lo que al aumentar el grupo de nodos se lanzan instancias de EC2 que luego se registran como nodos de Kubernetes.
Este proceso continúa hasta que haya capacidad suficiente o hasta que el grupo de nodos alcance su tamaño máximo configurado. Con los grupos de nodos administrados de EKS, cada nodo administrado pertenece a un grupo de Auto Scaling de EC2, y EKS sincroniza la información de escalado del grupo de nodos con los cambios realizados por componentes externos como el Cluster Autoscaler.
Identificación de nodos subutilizados
El Cluster Autoscaler también busca nodos que ya no son necesarios. En lugar de limitarse a monitorear la utilización real de CPU, evalúa las solicitudes de recursos de Kubernetes y determina si los workloads que se ejecutan en un nodo podrían programarse en otra parte del clúster.
Un nodo debe permanecer innecesario durante un período configurado antes de ser candidato a eliminación. El valor predeterminado de --scale-down-unneeded-time es de 10 minutos, aunque este y otros umbrales de reducción se pueden ajustar. Esta demora ayuda a evitar que los nodos se agreguen y eliminen repetidamente durante fluctuaciones breves de los workloads.
Reducción segura de nodos
Antes de eliminar un nodo, el Cluster Autoscaler realiza una simulación de programación para verificar que sus pods movibles puedan ejecutarse en otros nodos disponibles. Ciertos workloads pueden impedir la reducción, incluidos los pods protegidos por PodDisruptionBudgets restrictivos o los pods que no se pueden mover de forma segura.
Cuando un nodo puede eliminarse, el Cluster Autoscaler coordina su retiro y reduce la capacidad deseada del grupo de nodos correspondiente. Con los grupos de nodos administrados de EKS, la terminación de nodos incluye un drenado automático diseñado para desalojar los workloads de forma controlada antes de terminar la instancia de EC2 subyacente. Esto permite que el clúster reduzca la capacidad sin uso minimizando la interrupción de las aplicaciones en ejecución.
Cómo configurar el Cluster Autoscaler en EKS
Configurar el Cluster Autoscaler en Amazon EKS requiere preparar los grupos de nodos para el autoescalado, otorgar al autoscaler permiso para modificar los grupos de Auto Scaling de EC2 y desplegar una versión del Cluster Autoscaler compatible con la versión de Kubernetes del clúster.
Paso 1: Configura los límites de escalado de los grupos de nodos de EKS
Comienza por configurar la capacidad mínima, máxima y deseada de cada grupo de nodos administrado de EKS o grupo de Auto Scaling de EC2 autoadministrado que controlará el Cluster Autoscaler. El autoscaler solo puede ajustar la capacidad dentro de estos límites mínimo y máximo configurados.
Por ejemplo, un grupo de nodos podría tener un tamaño mínimo de 2 nodos y un máximo de 10. El Cluster Autoscaler puede entonces aumentar o reducir la capacidad deseada entre esos valores a medida que cambia la demanda de los workloads. AWS recomienda configurar los grupos de nodos de modo que las instancias de un mismo grupo tengan propiedades de programación equivalentes y una capacidad de recursos similar.
Paso 2: Configura los permisos de IAM para el Cluster Autoscaler
El Cluster Autoscaler requiere permisos de IAM de AWS para inspeccionar los grupos de Auto Scaling y modificar su capacidad deseada. AWS recomienda otorgar estos permisos a la cuenta de servicio de Kubernetes que usa el autoscaler, en lugar de asignar permisos amplios a cada nodo worker.
En EKS, esto puede configurarse con un rol de IAM asociado a la cuenta de servicio cluster-autoscaler en el namespace kube-system. La política debe permitir al autoscaler realizar las acciones de Auto Scaling necesarias y, a la vez, restringir las operaciones de escalado a los grupos de Auto Scaling asociados al clúster de EKS correspondiente.
Paso 3: Habilita el descubrimiento automático de grupos de nodos
AWS recomienda usar el descubrimiento automático del Cluster Autoscaler en lugar de listar manualmente cada grupo de Auto Scaling. El descubrimiento automático permite al autoscaler identificar qué grupos de nodos pertenecen al clúster de EKS examinando las etiquetas de los grupos de Auto Scaling.
Las etiquetas de descubrimiento más comunes son:
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedHerramientas como eksctl pueden configurar estas etiquetas automáticamente. Por ejemplo, crear un clúster con eksctl create cluster --asg-access agrega los permisos de autoescalado y las etiquetas de descubrimiento requeridos.
Paso 4: Despliega el Cluster Autoscaler
Despliega el Cluster Autoscaler en el clúster de EKS, normalmente en el namespace kube-system. Se puede instalar con el manifiesto oficial del Kubernetes Cluster Autoscaler o con su chart de Helm.
El despliegue debe especificar AWS como proveedor de nube y configurar el descubrimiento automático para el clúster. Por ejemplo:
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>El despliegue oficial también usa la clase de prioridad system-cluster-critical, de modo que el propio autoscaler tenga menos probabilidades de ser desalojado cuando los recursos del clúster escasean.
Paso 5: Alinea la versión del autoscaler con la versión de Kubernetes de EKS
Usa una versión del Cluster Autoscaler que coincida con la versión mayor y menor de Kubernetes que se ejecuta en EKS. Por ejemplo, un clúster con Kubernetes 1.32 debería ejecutar, por lo general, una versión 1.32.x del Cluster Autoscaler en lugar de una pensada para otra versión menor de Kubernetes.
Mantener las versiones alineadas es importante porque el Cluster Autoscaler depende de APIs de Kubernetes y de comportamientos del scheduler que pueden cambiar entre versiones. Por eso, al actualizar un clúster de EKS, conviene revisar la versión del autoscaler y actualizarla si es necesario.
Paso 6: Verifica el funcionamiento del Cluster Autoscaler
Después del despliegue, verifica que el pod del Cluster Autoscaler esté en ejecución:
kubectl get pods -n kube-systemLuego puedes revisar sus logs:
kubectl logs -n kube-system deployment/cluster-autoscalerUna prueba práctica consiste en desplegar workloads con solicitudes de recursos lo bastante grandes como para dejar pods pendientes. Si ningún nodo existente tiene capacidad suficiente, el Cluster Autoscaler debería detectar los pods no programables y aumentar la capacidad deseada de un grupo de Auto Scaling elegible. Cuando la demanda baja y los nodos quedan innecesarios, puede volver a reducir el grupo de nodos dentro de sus límites configurados.
EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
El EKS Cluster Autoscaler y el Horizontal Pod Autoscaler (HPA) operan en capas distintas de un entorno de EKS. El Cluster Autoscaler escala nodos worker, mientras que el HPA escala los pods de las aplicaciones. AWS recomienda combinar el autoescalado de workloads, como el HPA, con un autoscaler de nodos cuando tanto las aplicaciones como la capacidad del clúster necesitan responder dinámicamente a la demanda.
El Horizontal Pod Autoscaler monitorea métricas como CPU, memoria o métricas personalizadas y modifica el número de réplicas de un workload, como un Deployment. Si las réplicas adicionales no pueden programarse porque los nodos existentes carecen de capacidad, el Cluster Autoscaler puede entonces agregar nodos para dar cabida a esos pods pendientes.
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| Qué escala | Nodos worker | Pods |
| Disparador principal | Pods no programables y nodos innecesarios | Métricas de CPU, memoria, personalizadas o externas |
| Propósito principal | Ajustar la capacidad de cómputo del clúster | Ajustar la capacidad de la aplicación |
| Interacción con la infraestructura de AWS | Modifica la capacidad de los grupos de Auto Scaling de EC2 | Modifica el número de réplicas de los workloads de Kubernetes |
Por ejemplo, un HPA podría aumentar una aplicación de cinco a diez pods cuando sube la utilización de CPU. Si el clúster no tiene recursos suficientes para los pods adicionales, algunos quedan pendientes, lo que puede hacer que el Cluster Autoscaler aumente la capacidad de nodos.
Contenido relacionado: Lee nuestra guía sobre el Kubernetes Vertical Pod Autoscaler (VPA).
EKS Cluster Autoscaler vs. EKS Auto Mode
El EKS Cluster Autoscaler es un componente de autoescalado de Kubernetes administrado por el cliente, mientras que EKS Auto Mode ofrece una automatización de infraestructura administrada por AWS que incluye el autoescalado de cómputo. El Cluster Autoscaler funciona principalmente aumentando o reduciendo la capacidad deseada de grupos de Auto Scaling de EC2 predefinidos. EKS Auto Mode, en cambio, usa un sistema basado en Karpenter que puede aprovisionar nodos en respuesta a los requisitos de cada workload.
Con el Cluster Autoscaler, las organizaciones siguen siendo responsables de instalar y mantener el autoscaler y de configurar grupos de nodos adecuados, grupos de Auto Scaling, permisos de IAM y límites de escalado. EKS Auto Mode elimina buena parte de este trabajo operativo: AWS administra el aprovisionamiento de nodos, el software de los nodos, los parches, el autoescalado de cómputo y varias capacidades de infraestructura relacionadas.
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| Modelo de escalado | Escala grupos de Auto Scaling predefinidos | Aprovisionamiento dinámico de nodos basado en Karpenter |
| Grupos de nodos | Suele requerir grupos de nodos administrados o autoadministrados | Usa NodePools y NodeClasses administrados |
| Administración | El cliente instala y opera el autoscaler | AWS administra el autoescalado de cómputo |
| Selección de instancias | Limitada por la capacidad y los tipos de instancia configurados en el grupo de nodos | Puede elegir la capacidad adecuada según los requisitos del workload |
| Ciclo de vida de los nodos | Controlado principalmente mediante los ASG y el Cluster Autoscaler | AWS administra el aprovisionamiento, la consolidación, las actualizaciones y el reemplazo |
| Otra automatización de infraestructura | Enfocado en el escalado de nodos | También administra redes, balanceo de carga, almacenamiento en bloque y otros componentes |
EKS Auto Mode es, por lo tanto, una opción de infraestructura administrada más amplia y no simplemente otra versión del Cluster Autoscaler. AWS indica que Auto Mode puede crear nodos automáticamente cuando los pods no caben en la capacidad existente, consolidar workloads y eliminar los nodos que ya no se necesitan.
Buenas prácticas para el EKS Cluster Autoscaler
A continuación, algunas medidas útiles para tener en cuenta al trabajar con el Cluster Autoscaler en EKS.
1. Usa grupos de nodos administrados de EKS siempre que sea posible
AWS recomienda usar grupos de nodos administrados de EKS con el Cluster Autoscaler. Los grupos de nodos administrados se encargan de gran parte del ciclo de vida de los nodos de EC2, incluido el aprovisionamiento, las actualizaciones, el registro y la terminación controlada de nodos.
También se integran directamente con los grupos de Auto Scaling de EC2 e incluyen funciones que simplifican la operación del Cluster Autoscaler, como el descubrimiento automático de grupos de Auto Scaling y el drenado administrado durante muchas operaciones del ciclo de vida de los nodos.
2. Mantén los grupos de nodos lo más homogéneos posible
Los nodos de un mismo grupo deberían tener características de programación idénticas, incluidas las etiquetas, los taints y los recursos disponibles. El Cluster Autoscaler modela un grupo de nodos como si sus nodos fueran intercambiables, por lo que grandes diferencias entre instancias pueden producir decisiones de escalado imprecisas.
Al usar una Mixed Instances Policy, AWS recomienda elegir tipos de instancia con capacidad similar de CPU, memoria y GPU. El Cluster Autoscaler usa el primer tipo de instancia de la política al simular la programación; las instancias más pequeñas pueden dejar pods sin programar, mientras que las más grandes pueden derivar en recursos desaprovechados.
3. Minimiza el número de grupos de nodos
Prefiere una cantidad menor de grupos de nodos más grandes en lugar de crear muchos grupos pequeños para aplicaciones o equipos individuales. En cada ciclo de autoescalado, el Cluster Autoscaler evalúa los pods no programables frente a los grupos de nodos disponibles, por lo que aumentar el número de grupos incrementa el procesamiento y la sobrecarga de la API.
AWS identifica específicamente el exceso de grupos de nodos como un antipatrón de escalabilidad del autoescalado. Los grupos separados siguen siendo apropiados cuando los workloads realmente requieren características de programación distintas, como GPU, capacidad Spot o recursos específicos de una zona.
4. Define solicitudes de recursos precisas para los pods
Define solicitudes de CPU y memoria realistas para los workloads, de modo que el scheduler de Kubernetes y el Cluster Autoscaler tengan una representación precisa de los recursos que requiere cada pod. El autoscaler basa sus decisiones de escalado principalmente en las solicitudes de recursos de los pods y no en la utilización instantánea real.
Las solicitudes demasiado altas pueden provocar escalados de nodos innecesarios y un bin-packing deficiente, mientras que las demasiado bajas pueden generar contención de recursos incluso cuando Kubernetes parece tener capacidad suficiente. También se pueden configurar límites de recursos donde corresponda para controlar cuánta capacidad adicional puede consumir un contenedor.
5. Usa node selectors y taints solo cuando sea necesario
Usa node selectors, afinidad de nodos y taints cuando los workloads realmente requieran tipos específicos de nodos, y no como la forma predeterminada de organizar las aplicaciones. Cada restricción de programación adicional reduce la cantidad de nodos en los que un pod puede ejecutarse y puede obligar al Cluster Autoscaler a mantener grupos de nodos adicionales.
AWS recomienda usar mecanismos como los namespaces de Kubernetes para el aislamiento ordinario de workloads y tratar los node selectors y taints como excepciones. Los grupos de nodos dedicados siguen siendo útiles para workloads con requisitos reales de infraestructura, como GPU o instancias Spot.
6. Configura los Pod Disruption Budgets con cuidado
Los Pod Disruption Budgets (PDB) pueden proteger la disponibilidad de las aplicaciones durante interrupciones voluntarias, pero los PDB demasiado restrictivos pueden impedir que el Cluster Autoscaler elimine nodos que, de otro modo, serían innecesarios. Antes de reducir, el autoscaler debe determinar si los workloads pueden desalojarse de forma segura y programarse en otro lugar.
Configura los PDB para ofrecer el nivel de disponibilidad requerido sin que el desalojo voluntario resulte prácticamente imposible. Ten en cuenta también el comportamiento del ciclo de vida de los nodos específico de EKS: algunas operaciones de terminación de grupos de nodos administrados pueden continuar en algún momento incluso cuando un PDB impide drenar todos los pods.
7. Usa grupos de Auto Scaling multi-AZ cuando corresponda
Para los workloads sin requisitos de programación específicos de una zona de disponibilidad, AWS recomienda definir la capacidad regional como un único grupo de Auto Scaling de EC2 que abarque varias zonas de disponibilidad. Esto puede reducir el número de grupos de nodos que el Cluster Autoscaler debe evaluar y mejorar la escalabilidad.
Sin embargo, los workloads ligados a recursos zonales requieren consideraciones adicionales. Por ejemplo, las aplicaciones que usan volúmenes de EBS específicos de una zona, afinidad de nodos obligatoria por zona o afinidad de pods específica de una zona pueden necesitar grupos de nodos separados por zona de disponibilidad. Para aplicaciones con estado multi-AZ que usan EBS, AWS recomienda grupos de nodos de una sola AZ junto con --balance-similar-node-groups.
Preguntas frecuentes
¿Qué es el EKS Cluster Autoscaler? El Amazon EKS Cluster Autoscaler es un controlador de Kubernetes que ajusta la cantidad de nodos worker de un clúster. Agrega nodos cuando los pods no se pueden programar por falta de recursos y elimina los nodos que ya no se necesitan.
¿Cómo decide el Cluster Autoscaler agregar nodos? Consulta la API de Kubernetes aproximadamente cada 10 segundos en busca de pods que el scheduler no puede ubicar. Para cada uno, simula la programación en nodos nuevos hipotéticos de los grupos de nodos disponibles, elige un grupo con su estrategia de expansión (expander) y aumenta la capacidad deseada de ese grupo hasta que los pods quepan o se alcance el tamaño máximo.
¿Por qué el Cluster Autoscaler no reduce un nodo?
Un nodo debe permanecer innecesario durante un tiempo determinado antes de eliminarse, y el valor predeterminado de --scale-down-unneeded-time es de 10 minutos. La reducción también puede bloquearse por PodDisruptionBudgets restrictivos o por pods que no se pueden mover de forma segura a otros nodos.
¿Cuál es la diferencia entre el Cluster Autoscaler y el Horizontal Pod Autoscaler? El Cluster Autoscaler escala nodos worker, mientras que el Horizontal Pod Autoscaler escala los pods de las aplicaciones. Funcionan en conjunto: cuando el HPA agrega réplicas que no caben en los nodos existentes, los pods pendientes pueden hacer que el Cluster Autoscaler agregue nodos.
¿Cuál es la diferencia entre el Cluster Autoscaler y EKS Auto Mode? El Cluster Autoscaler es un componente administrado por el cliente que escala grupos de Auto Scaling de EC2 predefinidos. EKS Auto Mode es administrado por AWS y usa un sistema basado en Karpenter que aprovisiona nodos según las necesidades de cada workload. También administra otra infraestructura, como redes, balanceo de carga y almacenamiento en bloque.
¿Qué versión del Cluster Autoscaler debo ejecutar en EKS? Usa una versión que coincida con la versión mayor y menor de Kubernetes de tu clúster. Por ejemplo, un clúster con Kubernetes 1.32 debería ejecutar, por lo general, una versión 1.32.x del Cluster Autoscaler. Revisa la versión del autoscaler cada vez que actualices el clúster.
Maximiza la eficiencia del EKS Cluster Autoscaler con PerfectScale
Los autoscalers de nodos, como el Cluster Autoscaler, aumentan y reducen los nodos según la demanda, lo que mejora la disponibilidad del clúster y reduce los costos por capacidad inactiva. Pero incluso un autoscaler bien configurado solo puede actuar sobre las solicitudes de recursos que recibe. Los contenedores sobredimensionados desaprovechan capacidad y obligan al autoscaler a agregar más nodos de los necesarios; los contenedores subdimensionados provocan desalojos de pods, presión en los nodos y workloads inestables; y un bin-packing ineficiente deja recursos subutilizados mientras desencadena eventos de escalado innecesarios. PerfectScale aborda estos desafíos combinando el right-sizing autónomo de workloads con una visibilidad profunda de tus grupos de autoescalado y pools de nodos, para que tu Cluster Autoscaler tome mejores decisiones de escalado.
Capacidades clave de PerfectScale:
- Detección proactiva de errores de configuración: Analiza continuamente los workloads para identificar y corregir errores de configuración como CPU Request Not Set, Memory Request Not Set y Memory Limit Not Set, evitando desalojos impredecibles, sobrecompromiso de nodos y un autoescalado ineficiente.
- Right-sizing autónomo de workloads: Ajusta al instante los recursos de los workloads según la utilización real y mejora el bin-packing de los pods para aumentar la eficiencia del autoescalado, todo sin intervención manual.
- Visibilidad de grupos de autoescalado y pools de nodos: Ofrece información detallada sobre los costos y la utilización de tus grupos de autoescalado y pools de nodos, para ayudarte a identificar ineficiencias y lograr una distribución precisa de los recursos.
- Selección óptima del tipo de nodo: Te ayuda a alinear los tipos de nodo con los requisitos de CPU, memoria y GPU de tus workloads para mejorar la utilización, el bin-packing y la eficiencia general del clúster.
- Optimización combinada a nivel de nodo y de pod: Combina la optimización a nivel de nodo con el right-sizing a nivel de pod para lograr decisiones de escalado más rápidas, mejor rendimiento y menor gasto en la nube.
Descubre cómo PerfectScale te ayuda a autoescalar los nodos de Kubernetes sin conjeturas