


Che cos'è l'EKS Cluster Autoscaler?
L'Amazon EKS Cluster Autoscaler è un controller Kubernetes che regola automaticamente il numero di nodi worker del cluster, monitorando i pod in attesa che non possono essere schedulati per risorse insufficienti e terminando i nodi sottoutilizzati. La maggior parte degli utenti su Reddit r/aws concorda sul fatto che i soli Auto Scaling group (ASG) predefiniti non siano sufficienti per workloads Kubernetes dinamici, il che rende il Cluster Autoscaler essenziale per gestire le richieste di risorse in tempo reale.
Come funziona:
- Rilevamento dei pod non schedulabili: monitora i pod che non possono essere collocati a causa di risorse insufficienti o vincoli di scheduling.
- Selezione del gruppo di nodi EKS da scalare: simula il posizionamento dei pod sui gruppi di nodi disponibili e seleziona un gruppo adatto per la capacità aggiuntiva.
- Aumento della capacità dell'Auto Scaling Group EC2: incrementa la capacità desiderata dell'Auto Scaling group selezionato in modo che nuovi nodi worker EC2 possano unirsi al cluster.
- Identificazione dei nodi sottoutilizzati: determina se i workloads presenti su nodi non necessari possono essere spostati altrove in base alle richieste di risorse e ai requisiti di scheduling.
- Riduzione sicura dei nodi: verifica che i pod spostabili possano essere rischedulati prima di ridurre la capacità del gruppo di nodi e terminare i nodi non necessari.
Passaggi fondamentali della configurazione:
- Configurare i limiti di scalabilità dei gruppi di nodi EKS: impostare capacità minima, massima e desiderata per ogni gruppo di nodi che l'autoscaler può gestire.
- Configurare le autorizzazioni IAM per il Cluster Autoscaler: concedere all'autoscaler i permessi per ispezionare e modificare gli Auto Scaling group EC2 appropriati.
- Abilitare l'auto-discovery dei gruppi di nodi: applicare i tag richiesti agli Auto Scaling group in modo che l'autoscaler possa individuare i gruppi di nodi EKS idonei.
- Distribuire il Cluster Autoscaler: installarlo nel cluster e configurare AWS come cloud provider con le impostazioni di auto-discovery appropriate.
- Allineare la versione dell'autoscaler alla versione Kubernetes di EKS: utilizzare una release del Cluster Autoscaler corrispondente alla versione major e minor di Kubernetes del cluster.
- Verificare il funzionamento del Cluster Autoscaler: controllare il pod e i log dell'autoscaler, quindi verificare che i pod non schedulabili attivino lo scale-out dei nodi come previsto.
Questo articolo fa parte di una serie dedicata allo scheduling in Kubernetes
In questo articolo:
- Come funziona l'EKS Cluster Autoscaler?
- Come configurare il Cluster Autoscaler su EKS
- EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
- EKS Cluster Autoscaler vs. EKS Auto Mode
- Best practice per l'EKS Cluster Autoscaler
Come funziona l'EKS Cluster Autoscaler?
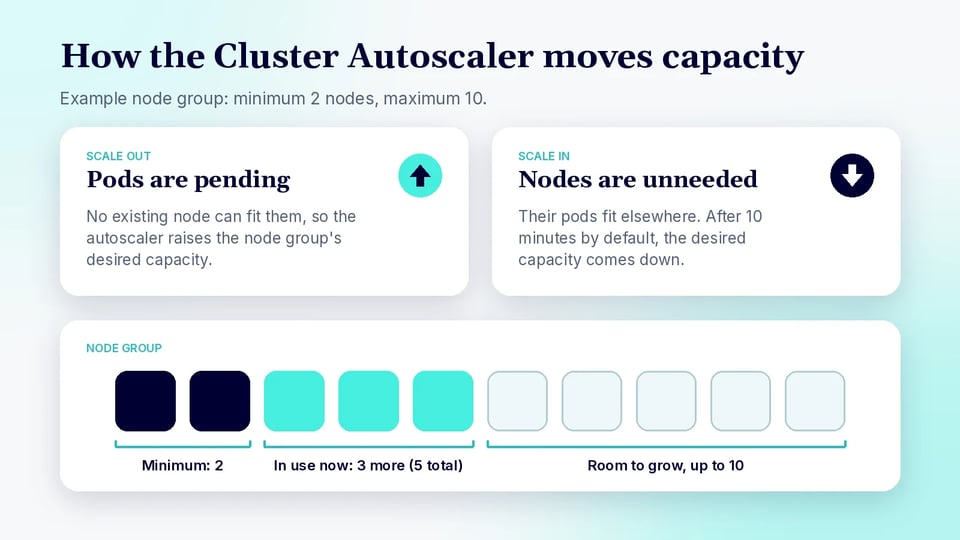
Rilevare i pod non schedulabili
Il Cluster Autoscaler interroga regolarmente l'API di Kubernetes alla ricerca di pod che lo scheduler non riesce a collocare su alcun nodo esistente. Un pod può diventare non schedulabile quando le sue richieste di CPU, memoria, GPU o altre risorse non possono essere soddisfatte, oppure quando vincoli di scheduling come node selector, regole di affinity e taint ne limitano le possibilità di esecuzione.
Per impostazione predefinita, il Cluster Autoscaler esegue una scansione del cluster circa ogni 10 secondi. Quando individua pod non schedulabili, determina se l'aggiunta di capacità a uno dei gruppi di nodi configurati consentirebbe l'esecuzione di quei pod.
Selezionare un gruppo di nodi EKS da scalare
Per ogni pod non schedulabile, il Cluster Autoscaler simula lo scheduling del pod su ipotetici nuovi nodi provenienti dai gruppi di nodi EKS disponibili. Considera fattori come la capacità di CPU e memoria del gruppo di nodi, le label, i taint e altre proprietà di scheduling.
AWS raccomanda che i nodi all'interno di un gruppo abbiano caratteristiche di scheduling identiche. Ad esempio, i tipi di istanza utilizzati con una EC2 Mixed Instances Policy dovrebbero avere capacità di CPU, memoria e GPU simili, perché il Cluster Autoscaler utilizza il primo tipo di istanza della policy nella simulazione dello scheduling. Una volta individuati i gruppi adatti, la strategia di expander configurata determina quale gruppo debba essere ampliato.
Aumentare la capacità dell'Auto Scaling Group EC2
Dopo aver selezionato un gruppo di nodi adatto, il Cluster Autoscaler ne aumenta la capacità desiderata. I gruppi di nodi EKS si basano su Auto Scaling group EC2, quindi l'ampliamento del gruppo di nodi provoca l'avvio di istanze EC2 che vengono poi registrate come nodi Kubernetes.
Questo processo continua finché non è disponibile capacità sufficiente o finché il gruppo di nodi non raggiunge la dimensione massima configurata. Con i gruppi di nodi gestiti di EKS, ogni nodo gestito appartiene a un Auto Scaling group EC2 ed EKS sincronizza le informazioni di scalabilità del gruppo di nodi con le modifiche apportate da componenti esterni come il Cluster Autoscaler.
Identificare i nodi sottoutilizzati
Il Cluster Autoscaler individua anche i nodi che non sono più necessari. Anziché limitarsi a monitorare l'utilizzo effettivo della CPU, valuta le richieste di risorse di Kubernetes e determina se i workloads in esecuzione su un nodo potrebbero essere schedulati altrove nel cluster.
Un nodo deve rimanere non necessario per un periodo configurato prima di diventare idoneo alla rimozione. Il valore predefinito di --scale-down-unneeded-time è di 10 minuti, anche se questa e altre soglie di scale-down possono essere regolate. Questo ritardo aiuta a evitare che i nodi vengano ripetutamente aggiunti e rimossi durante fluttuazioni di breve durata dei workloads.
Ridurre i nodi in modo sicuro
Prima di rimuovere un nodo, il Cluster Autoscaler esegue una simulazione di scheduling per verificare che i pod spostabili possano essere eseguiti su altri nodi disponibili. Alcuni workloads possono impedire lo scale-down, tra cui i pod protetti da PodDisruptionBudget restrittivi o i pod che non possono essere spostati in sicurezza.
Quando un nodo può essere rimosso, il Cluster Autoscaler ne coordina la rimozione e riduce la capacità desiderata del gruppo di nodi corrispondente. Con i gruppi di nodi gestiti di EKS, la terminazione dei nodi include un comportamento di draining automatico progettato per evacuare i workloads in modo graduale prima che l'istanza EC2 sottostante venga terminata. In questo modo il cluster può ridurre la capacità inutilizzata minimizzando l'impatto sulle applicazioni in esecuzione.
Come configurare il Cluster Autoscaler su EKS
Per configurare il Cluster Autoscaler su Amazon EKS occorre predisporre i gruppi di nodi per l'autoscaling, concedere all'autoscaler i permessi per modificare gli Auto Scaling group EC2 e distribuire una versione del Cluster Autoscaler compatibile con la versione Kubernetes del cluster.
Step 1: configurare i limiti di scalabilità dei gruppi di nodi EKS
Iniziare configurando capacità minima, massima e desiderata per ogni gruppo di nodi gestito di EKS o Auto Scaling group EC2 autogestito che il Cluster Autoscaler dovrà controllare. L'autoscaler può regolare la capacità solo entro i limiti minimo e massimo configurati.
Ad esempio, un gruppo di nodi potrebbe avere una dimensione minima di 2 nodi e massima di 10. Il Cluster Autoscaler può quindi aumentare o diminuire la capacità desiderata tra questi valori al variare della domanda dei workloads. AWS raccomanda di configurare i gruppi di nodi in modo che le istanze dello stesso gruppo abbiano proprietà di scheduling equivalenti e capacità di risorse simili.
Step 2: configurare le autorizzazioni IAM per il Cluster Autoscaler
Il Cluster Autoscaler richiede autorizzazioni IAM di AWS per ispezionare gli Auto Scaling group e modificarne la capacità desiderata. AWS raccomanda di assegnare questi permessi al service account Kubernetes utilizzato dall'autoscaler, anziché attribuire permessi ampi a ogni nodo worker.
Su EKS, questo può essere configurato tramite un ruolo IAM associato al service account cluster-autoscaler nel namespace kube-system. La policy dovrebbe consentire all'autoscaler di eseguire le azioni di Auto Scaling necessarie, limitando al contempo le operazioni di scalabilità agli Auto Scaling group associati al cluster EKS pertinente.
Step 3: abilitare l'auto-discovery dei gruppi di nodi
AWS raccomanda di utilizzare l'auto-discovery del Cluster Autoscaler anziché elencare manualmente i singoli Auto Scaling group. L'auto-discovery consente all'autoscaler di identificare quali gruppi di nodi appartengono al cluster EKS esaminando i tag degli Auto Scaling group.
I tag di discovery comunemente utilizzati sono:
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedStrumenti come eksctl possono configurare questi tag automaticamente. Ad esempio, la creazione di un cluster con eksctl create cluster --asg-access aggiunge i permessi di autoscaling e i tag di discovery richiesti.
Step 4: distribuire il Cluster Autoscaler
Distribuire il Cluster Autoscaler nel cluster EKS, tipicamente nel namespace kube-system. Può essere installato utilizzando il manifest ufficiale del Kubernetes Cluster Autoscaler o il relativo chart Helm.
Il deployment deve specificare AWS come cloud provider e configurare l'auto-discovery per il cluster. Ad esempio:
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>Il deployment ufficiale utilizza inoltre la priority class system-cluster-critical, in modo che l'autoscaler stesso abbia meno probabilità di subire eviction quando le risorse del cluster scarseggiano.
Step 5: allineare la versione dell'autoscaler alla versione Kubernetes di EKS
Utilizzare una release del Cluster Autoscaler che corrisponda alla versione major e minor di Kubernetes in esecuzione su EKS. Ad esempio, un cluster Kubernetes 1.32 dovrebbe generalmente eseguire una release 1.32.x del Cluster Autoscaler, anziché una release destinata a un'altra versione minor di Kubernetes.
Mantenere le versioni allineate è importante perché il Cluster Autoscaler dipende da API di Kubernetes e da comportamenti dello scheduler che possono cambiare tra una release e l'altra. Quando si aggiorna un cluster EKS, è quindi opportuno verificare la versione dell'autoscaler e aggiornarla se necessario.
Step 6: verificare il funzionamento del Cluster Autoscaler
Dopo il deployment, verificare che il pod del Cluster Autoscaler sia in esecuzione:
kubectl get pods -n kube-systemÈ quindi possibile esaminarne i log:
kubectl logs -n kube-system deployment/cluster-autoscalerUn test pratico consiste nel distribuire workloads con richieste di risorse abbastanza grandi da lasciare dei pod in stato pending. Se nessun nodo esistente dispone di capacità sufficiente, il Cluster Autoscaler dovrebbe rilevare i pod non schedulabili e aumentare la capacità desiderata di un Auto Scaling group idoneo. Quando in seguito la domanda diminuisce e i nodi restano non necessari, può ridurre il gruppo di nodi entro i limiti configurati.
EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
L'EKS Cluster Autoscaler e l'Horizontal Pod Autoscaler (HPA) operano a livelli diversi di un ambiente EKS. Il Cluster Autoscaler scala i nodi worker, mentre l'HPA scala i pod applicativi. AWS raccomanda di utilizzare l'autoscaling dei workloads, come l'HPA, insieme a un autoscaler dei nodi quando sia le applicazioni sia la capacità del cluster devono rispondere dinamicamente alla domanda.
L'Horizontal Pod Autoscaler monitora metriche come CPU, memoria o metriche personalizzate e modifica il numero di repliche di un workload come un Deployment. Se le repliche aggiuntive non possono essere schedulate perché i nodi esistenti non hanno capacità sufficiente, il Cluster Autoscaler può quindi aggiungere nodi per ospitare i pod in attesa.
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| Cosa scala | Nodi worker | Pod |
| Trigger principale | Pod non schedulabili e nodi non necessari | Metriche CPU, memoria, personalizzate o esterne |
| Scopo principale | Regolare la capacità di calcolo del cluster | Regolare la capacità applicativa |
| Interazione con l'infrastruttura AWS | Modifica la capacità degli Auto Scaling group EC2 | Modifica il numero di repliche dei workloads Kubernetes |
Ad esempio, un HPA potrebbe portare un'applicazione da cinque a dieci pod all'aumentare dell'utilizzo della CPU. Se il cluster non dispone di risorse sufficienti per i pod aggiuntivi, alcuni restano in attesa, e questo può spingere il Cluster Autoscaler ad aumentare la capacità dei nodi.
Contenuti correlati: legga la nostra guida al Kubernetes Vertical Pod Autoscaler (VPA).
EKS Cluster Autoscaler vs. EKS Auto Mode
L'EKS Cluster Autoscaler è un componente di autoscaling Kubernetes gestito dal cliente, mentre EKS Auto Mode offre un'automazione dell'infrastruttura gestita da AWS che include l'autoscaling del compute. Il Cluster Autoscaler funziona principalmente aumentando o diminuendo la capacità desiderata di Auto Scaling group EC2 predefiniti. EKS Auto Mode utilizza invece un sistema basato su Karpenter in grado di effettuare il provisioning dei nodi in risposta ai requisiti dei singoli workloads.
Con il Cluster Autoscaler, le organizzazioni restano responsabili dell'installazione e della manutenzione dell'autoscaler e della configurazione di gruppi di nodi, Auto Scaling group, autorizzazioni IAM e limiti di scalabilità adeguati. EKS Auto Mode elimina gran parte di questo lavoro operativo: AWS gestisce il provisioning dei nodi, il software dei nodi, il patching, l'autoscaling del compute e diverse funzionalità infrastrutturali correlate.
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| Modello di scalabilità | Scala Auto Scaling group predefiniti | Provisioning dinamico dei nodi basato su Karpenter |
| Gruppi di nodi | Richiede in genere gruppi di nodi gestiti o autogestiti | Utilizza NodePool e NodeClass gestiti |
| Gestione | Il cliente installa e gestisce l'autoscaler | AWS gestisce l'autoscaling del compute |
| Selezione delle istanze | Vincolata dalla capacità e dai tipi di istanza configurati nei gruppi di nodi | Può selezionare la capacità appropriata in base ai requisiti dei workloads |
| Ciclo di vita dei nodi | Controllato principalmente tramite ASG e Cluster Autoscaler | AWS gestisce provisioning, consolidamento, aggiornamenti e sostituzione |
| Altre automazioni infrastrutturali | Focalizzato sulla scalabilità dei nodi | Gestisce anche networking, load balancing, storage a blocchi e altri componenti |
EKS Auto Mode rappresenta quindi un'opzione di infrastruttura gestita più ampia, non semplicemente un'altra versione del Cluster Autoscaler. AWS dichiara che Auto Mode può creare automaticamente nodi quando i pod non trovano posto sulla capacità esistente, consolidare i workloads e rimuovere i nodi non più necessari.
Best practice per l'EKS Cluster Autoscaler
Ecco alcuni accorgimenti utili da tenere a mente quando si lavora con il Cluster Autoscaler in EKS.
1. Utilizzare gruppi di nodi gestiti di EKS ove possibile
AWS raccomanda di utilizzare i gruppi di nodi gestiti di EKS con il Cluster Autoscaler. I gruppi di nodi gestiti si occupano di gran parte del ciclo di vita dei nodi EC2, inclusi provisioning, upgrade, registrazione e terminazione graduale dei nodi.
Si integrano inoltre direttamente con gli Auto Scaling group EC2 e includono funzionalità che semplificano il funzionamento del Cluster Autoscaler, come la discovery automatica degli Auto Scaling group e il draining gestito durante molte operazioni del ciclo di vita dei nodi.
2. Mantenere i gruppi di nodi il più omogenei possibile
I nodi all'interno dello stesso gruppo dovrebbero avere caratteristiche di scheduling identiche, incluse label, taint e risorse disponibili. Il Cluster Autoscaler modella un gruppo di nodi come se i suoi nodi fossero intercambiabili, quindi differenze marcate tra le istanze possono produrre decisioni di scalabilità imprecise.
Quando si utilizza una Mixed Instances Policy, AWS raccomanda di scegliere tipi di istanza con capacità di CPU, memoria e GPU simili. Il Cluster Autoscaler utilizza il primo tipo di istanza della policy nella simulazione dello scheduling: istanze più piccole possono lasciare i pod non schedulabili, mentre istanze più grandi possono causare spreco di risorse.
3. Ridurre al minimo il numero di gruppi di nodi
Preferire un numero ridotto di gruppi di nodi più grandi anziché creare molti gruppi piccoli per singole applicazioni o team. A ogni ciclo di autoscaling, il Cluster Autoscaler valuta i pod non schedulabili rispetto ai gruppi di nodi disponibili, quindi aumentare il numero di gruppi incrementa l'elaborazione e l'overhead sulle API.
AWS identifica esplicitamente l'eccesso di gruppi di nodi come un anti-pattern per la scalabilità dell'autoscaling. Gruppi separati restano appropriati quando i workloads richiedono davvero caratteristiche di scheduling diverse, come GPU, capacità Spot o risorse specifiche di zona.
4. Impostare richieste di risorse accurate per i pod
Definire richieste realistiche di CPU e memoria per i workloads, in modo che lo scheduler di Kubernetes e il Cluster Autoscaler abbiano una rappresentazione accurata delle risorse necessarie a ciascun pod. L'autoscaler basa le decisioni di scalabilità principalmente sulle richieste di risorse dei pod, non sull'utilizzo effettivo istantaneo delle risorse.
Richieste troppo alte possono causare scale-out dei nodi non necessari e un bin packing inefficiente, mentre richieste troppo basse possono portare a contesa sulle risorse anche quando Kubernetes sembra disporre di capacità sufficiente. Dove opportuno, è possibile configurare anche limiti di risorse per controllare quanta capacità aggiuntiva può consumare un container.
5. Usare node selector e taint solo quando necessario
Utilizzare node selector, node affinity e taint quando i workloads richiedono davvero tipi di nodi specifici, non come metodo predefinito per organizzare le applicazioni. Ogni restrizione di scheduling aggiuntiva riduce il numero di nodi su cui un pod può essere eseguito e può costringere il Cluster Autoscaler a mantenere gruppi di nodi aggiuntivi.
AWS raccomanda di utilizzare meccanismi come i namespace di Kubernetes per l'isolamento ordinario dei workloads e di trattare node selector e taint come eccezioni. Gruppi di nodi dedicati restano utili per workloads con requisiti infrastrutturali reali, come GPU o istanze Spot.
6. Configurare con attenzione i Pod Disruption Budget
I Pod Disruption Budget (PDB) possono proteggere la disponibilità delle applicazioni durante le interruzioni volontarie, ma PDB eccessivamente restrittivi possono impedire al Cluster Autoscaler di rimuovere nodi altrimenti non necessari. Prima di uno scale-down, l'autoscaler deve determinare se i workloads possono essere evacuati in sicurezza e schedulati altrove.
Configurare i PDB in modo da garantire il livello di disponibilità richiesto senza rendere di fatto impossibile l'eviction volontaria. Tenere inoltre conto del comportamento specifico del ciclo di vita dei nodi di EKS: alcune operazioni di terminazione dei gruppi di nodi gestiti possono comunque procedere anche quando un PDB impedisce il draining di tutti i pod.
7. Usare Auto Scaling group multi-AZ ove opportuno
Per i workloads senza requisiti di scheduling specifici per Availability Zone, AWS raccomanda di definire la capacità regionale come un unico Auto Scaling group EC2 che copra più Availability Zone. Questo può ridurre il numero di gruppi di nodi che il Cluster Autoscaler deve valutare e migliorare la scalabilità.
Tuttavia, i workloads legati a risorse zonali richiedono considerazioni aggiuntive. Ad esempio, le applicazioni che utilizzano volumi EBS specifici di zona, node affinity obbligatorie basate sulla zona o pod affinity specifiche di zona possono richiedere gruppi di nodi separati per singole Availability Zone. Per le applicazioni stateful multi-AZ che usano EBS, AWS raccomanda gruppi di nodi a singola AZ insieme a --balance-similar-node-groups.
FAQ
Che cos'è l'EKS Cluster Autoscaler? L'Amazon EKS Cluster Autoscaler è un controller Kubernetes che regola il numero di nodi worker in un cluster. Aggiunge nodi quando i pod non possono essere schedulati per risorse insufficienti e rimuove i nodi non più necessari.
Come decide il Cluster Autoscaler di aggiungere nodi? Interroga l'API di Kubernetes circa ogni 10 secondi alla ricerca di pod che lo scheduler non riesce a collocare. Per ciascuno, simula lo scheduling su ipotetici nuovi nodi dei gruppi di nodi disponibili, sceglie un gruppo con la strategia di expander configurata e ne aumenta la capacità desiderata finché i pod non trovano posto o non viene raggiunta la dimensione massima.
Perché il Cluster Autoscaler non riduce un nodo?
Un nodo deve rimanere non necessario per un tempo prestabilito prima della rimozione, e il valore predefinito di --scale-down-unneeded-time è di 10 minuti. Lo scale-down può inoltre essere bloccato da PodDisruptionBudget restrittivi o da pod che non possono essere spostati in sicurezza su altri nodi.
Qual è la differenza tra il Cluster Autoscaler e l'Horizontal Pod Autoscaler? Il Cluster Autoscaler scala i nodi worker, mentre l'Horizontal Pod Autoscaler scala i pod applicativi. I due lavorano insieme. Quando l'HPA aggiunge repliche che non trovano posto sui nodi esistenti, i pod in attesa possono spingere il Cluster Autoscaler ad aggiungere nodi.
Qual è la differenza tra il Cluster Autoscaler ed EKS Auto Mode? Il Cluster Autoscaler è un componente gestito dal cliente che scala Auto Scaling group EC2 predefiniti. EKS Auto Mode è gestito da AWS e utilizza un sistema basato su Karpenter che effettua il provisioning dei nodi in base alle esigenze dei singoli workloads. Gestisce inoltre altra infrastruttura come networking, load balancing e storage a blocchi.
Quale versione del Cluster Autoscaler eseguire su EKS? Utilizzare una release che corrisponda alla versione major e minor di Kubernetes del cluster. Ad esempio, un cluster Kubernetes 1.32 dovrebbe generalmente eseguire una release 1.32.x del Cluster Autoscaler. Verificare la versione dell'autoscaler a ogni upgrade del cluster.
Massimizzare l'efficienza dell'EKS Cluster Autoscaler con PerfectScale
Gli autoscaler di nodi come il Cluster Autoscaler aumentano e riducono i nodi in base alla domanda, migliorando la disponibilità del cluster e riducendo i costi legati alle risorse inattive. Ma anche un autoscaler ben configurato può agire solo sulle richieste di risorse che riceve. I container sovradimensionati sprecano capacità e costringono l'autoscaler ad aggiungere più nodi del necessario, i container sottodimensionati causano eviction dei pod, pressione sui nodi e workloads instabili, e un bin-packing inefficiente lascia le risorse sottoutilizzate generando al contempo eventi di scalabilità superflui. PerfectScale affronta queste sfide combinando il right-sizing autonomo dei workloads con una visibilità approfondita sui gruppi di autoscaling e sui pool di nodi, così il Cluster Autoscaler prende decisioni di scalabilità migliori.
Funzionalità chiave di PerfectScale:
- Rilevamento proattivo degli errori di configurazione: analizza continuamente i workloads per identificare e correggere errori di configurazione come CPU Request Not Set, Memory Request Not Set e Memory Limit Not Set, prevenendo eviction imprevedibili, over-commitment dei nodi e autoscaling inefficiente.
- Right-sizing autonomo dei workloads: regola istantaneamente le risorse dei workloads in base all'utilizzo effettivo e migliora il bin-packing dei pod per aumentare l'efficienza dell'autoscaling, il tutto senza intervento manuale.
- Visibilità su gruppi di autoscaling e pool di nodi: fornisce informazioni dettagliate su costi e utilizzo dei gruppi di autoscaling e dei pool di nodi, aiutando a individuare le inefficienze e a ottenere una distribuzione precisa delle risorse.
- Selezione ottimale del tipo di nodo: aiuta ad abbinare i tipi di nodo ai requisiti di CPU, memoria e GPU dei workloads, per migliorare utilizzo, bin-packing ed efficienza complessiva del cluster.
- Ottimizzazione combinata a livello di nodo e di pod: unisce l'ottimizzazione a livello di nodo al right-sizing a livello di pod per decisioni di scalabilità più rapide, prestazioni migliori e una spesa cloud ridotta.