


Qu'est-ce que l'EKS Cluster Autoscaler ?
L'Amazon EKS Cluster Autoscaler est un contrôleur Kubernetes qui ajuste automatiquement le nombre de nœuds worker de votre cluster : il surveille les pods en attente qui ne peuvent pas être planifiés faute de ressources suffisantes et arrête les nœuds sous-utilisés. La plupart des utilisateurs du subreddit r/aws s'accordent à dire que les groupes Auto Scaling (ASG) par défaut ne suffisent pas à eux seuls pour des workloads Kubernetes dynamiques, ce qui rend le Cluster Autoscaler indispensable pour répondre aux demandes de ressources en temps réel.
Fonctionnement :
- Détection des pods non planifiables : surveille les pods qui ne peuvent pas être placés en raison de ressources insuffisantes ou de contraintes de planification.
- Sélection d'un groupe de nœuds EKS à mettre à l'échelle : simule le placement des pods sur les groupes de nœuds disponibles et sélectionne un groupe adapté pour ajouter de la capacité.
- Augmentation de la capacité du groupe EC2 Auto Scaling : augmente la capacité souhaitée du groupe Auto Scaling sélectionné afin que de nouveaux nœuds worker EC2 puissent rejoindre le cluster.
- Identification des nœuds sous-utilisés : détermine si les workloads des nœuds superflus peuvent être déplacés ailleurs en fonction des demandes de ressources et des exigences de planification.
- Réduction sécurisée du nombre de nœuds : vérifie que les pods déplaçables peuvent être replanifiés avant de réduire la capacité du groupe de nœuds et d'arrêter les nœuds superflus.
Étapes clés de la configuration :
- Configurer les limites de scaling des groupes de nœuds EKS : définissez la capacité minimale, maximale et souhaitée de chaque groupe de nœuds que l'autoscaler peut gérer.
- Configurer les permissions IAM du Cluster Autoscaler : accordez à l'autoscaler l'autorisation d'inspecter et de modifier les groupes EC2 Auto Scaling appropriés.
- Activer la découverte automatique des groupes de nœuds : appliquez les tags Auto Scaling requis afin que l'autoscaler puisse découvrir les groupes de nœuds EKS éligibles.
- Déployer le Cluster Autoscaler : installez-le dans le cluster et configurez AWS comme fournisseur cloud avec les paramètres de découverte automatique appropriés.
- Aligner la version de l'autoscaler sur la version Kubernetes d'EKS : utilisez une version du Cluster Autoscaler correspondant à la version majeure et mineure de Kubernetes du cluster.
- Vérifier le fonctionnement du Cluster Autoscaler : contrôlez le pod et les logs de l'autoscaler, puis testez que les pods non planifiables déclenchent bien l'ajout de nœuds.
Cet article fait partie d'une série consacrée à la planification dans Kubernetes
Dans cet article :
- Comment fonctionne l'EKS Cluster Autoscaler ?
- Comment configurer le Cluster Autoscaler sur EKS
- EKS Cluster Autoscaler vs Horizontal Pod Autoscaler
- EKS Cluster Autoscaler vs EKS Auto Mode
- Bonnes pratiques pour l'EKS Cluster Autoscaler
Comment fonctionne l'EKS Cluster Autoscaler ?
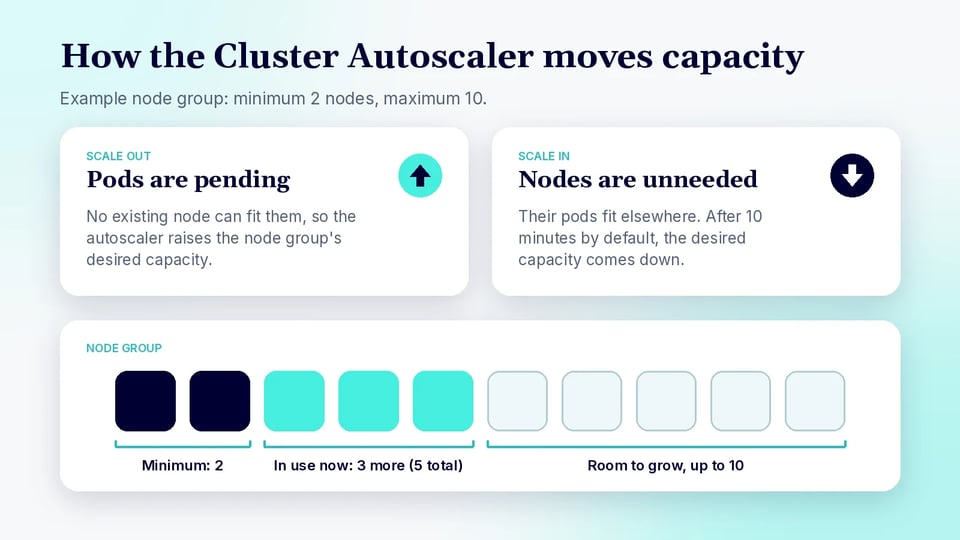
Détection des pods non planifiables
Le Cluster Autoscaler interroge régulièrement l'API Kubernetes pour repérer les pods que le scheduler ne peut placer sur aucun nœud existant. Un pod peut devenir non planifiable lorsque ses demandes de CPU, de mémoire, de GPU ou d'autres ressources ne peuvent pas être satisfaites, ou lorsque des contraintes de planification telles que les node selectors, les règles d'affinité et les taints limitent les emplacements où il peut s'exécuter.
Par défaut, le Cluster Autoscaler analyse le cluster environ toutes les 10 secondes. Lorsqu'il détecte des pods non planifiables, il détermine si l'ajout de capacité à l'un des groupes de nœuds configurés permettrait à ces pods de s'exécuter.
Sélection d'un groupe de nœuds EKS à mettre à l'échelle
Pour chaque pod non planifiable, le Cluster Autoscaler simule la planification du pod sur de nouveaux nœuds hypothétiques issus des groupes de nœuds EKS disponibles. Il prend en compte des facteurs tels que la capacité CPU et mémoire du groupe de nœuds, les labels, les taints et d'autres propriétés de planification.
AWS recommande que les nœuds d'un même groupe aient des caractéristiques de planification identiques. Par exemple, les types d'instances utilisés avec une Mixed Instances Policy EC2 doivent offrir des capacités CPU, mémoire et GPU similaires, car le Cluster Autoscaler se base sur le premier type d'instance de la politique lors de la simulation de planification. Une fois les groupes adaptés identifiés, la stratégie d'expansion (expander) configurée détermine quel groupe doit être agrandi.
Augmentation de la capacité du groupe EC2 Auto Scaling
Après avoir sélectionné un groupe de nœuds adapté, le Cluster Autoscaler augmente sa capacité souhaitée. Les groupes de nœuds EKS reposant sur des groupes EC2 Auto Scaling, l'augmentation du groupe de nœuds entraîne le lancement d'instances EC2, qui sont ensuite enregistrées comme nœuds Kubernetes.
Ce processus se poursuit jusqu'à ce qu'une capacité suffisante soit disponible ou que le groupe de nœuds atteigne sa taille maximale configurée. Avec les groupes de nœuds managés EKS, chaque nœud managé appartient à un groupe EC2 Auto Scaling, et EKS synchronise les informations de scaling du groupe de nœuds avec les modifications effectuées par des composants externes tels que le Cluster Autoscaler.
Identification des nœuds sous-utilisés
Le Cluster Autoscaler recherche également les nœuds devenus inutiles. Plutôt que de simplement surveiller l'utilisation réelle du CPU, il évalue les demandes de ressources Kubernetes et détermine si les workloads s'exécutant sur un nœud pourraient être planifiés ailleurs dans le cluster.
Un nœud doit rester inutile pendant une période configurée avant de devenir éligible à la suppression. La valeur par défaut de --scale-down-unneeded-time est de 10 minutes, mais ce seuil et les autres seuils de réduction peuvent être ajustés. Ce délai évite que des nœuds soient ajoutés puis supprimés à répétition lors de fluctuations de courte durée des workloads.
Réduction sécurisée du nombre de nœuds
Avant de supprimer un nœud, le Cluster Autoscaler effectue une simulation de planification pour vérifier que ses pods déplaçables peuvent s'exécuter sur d'autres nœuds disponibles. Certains workloads peuvent empêcher la réduction, notamment les pods protégés par des PodDisruptionBudgets restrictifs ou ceux qui ne peuvent pas être déplacés en toute sécurité.
Lorsqu'un nœud peut être supprimé, le Cluster Autoscaler coordonne sa suppression et réduit la capacité souhaitée du groupe de nœuds correspondant. Avec les groupes de nœuds managés EKS, la mise hors service des nœuds inclut un drainage automatique conçu pour évincer les workloads en douceur avant que l'instance EC2 sous-jacente ne soit arrêtée. Le cluster peut ainsi réduire la capacité inutilisée tout en minimisant les perturbations pour les applications en cours d'exécution.
Comment configurer le Cluster Autoscaler sur EKS
La mise en place du Cluster Autoscaler sur Amazon EKS nécessite de configurer les groupes de nœuds pour l'autoscaling, d'accorder à l'autoscaler l'autorisation de modifier les groupes EC2 Auto Scaling et de déployer une version du Cluster Autoscaler compatible avec la version Kubernetes du cluster.
Étape 1 : configurer les limites de scaling des groupes de nœuds EKS
Commencez par configurer la capacité minimale, maximale et souhaitée de chaque groupe de nœuds managé EKS ou groupe EC2 Auto Scaling autogéré que le Cluster Autoscaler contrôlera. L'autoscaler ne peut ajuster la capacité que dans les limites minimale et maximale ainsi configurées.
Par exemple, un groupe de nœuds peut avoir une taille minimale de 2 nœuds et une taille maximale de 10. Le Cluster Autoscaler peut alors augmenter ou diminuer la capacité souhaitée entre ces valeurs en fonction de l'évolution de la demande. AWS recommande de configurer les groupes de nœuds de sorte que les instances d'un même groupe présentent des propriétés de planification équivalentes et une capacité de ressources similaire.
Étape 2 : configurer les permissions IAM du Cluster Autoscaler
Le Cluster Autoscaler a besoin de permissions AWS IAM pour inspecter les groupes Auto Scaling et modifier leur capacité souhaitée. AWS recommande d'accorder ces permissions au compte de service Kubernetes utilisé par l'autoscaler plutôt que d'attribuer des permissions étendues à chaque nœud worker.
Sur EKS, cela peut être configuré à l'aide d'un rôle IAM associé au compte de service cluster-autoscaler dans le namespace kube-system. La politique doit autoriser l'autoscaler à effectuer les actions Auto Scaling requises tout en limitant les opérations de scaling aux groupes Auto Scaling associés au cluster EKS concerné.
Étape 3 : activer la découverte automatique des groupes de nœuds
AWS recommande d'utiliser la découverte automatique du Cluster Autoscaler plutôt que de lister manuellement les groupes Auto Scaling. La découverte automatique permet à l'autoscaler d'identifier les groupes de nœuds appartenant au cluster EKS en examinant les tags des groupes Auto Scaling.
Les tags de découverte couramment utilisés sont :
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedDes outils comme eksctl peuvent configurer ces tags automatiquement. Par exemple, la création d'un cluster avec eksctl create cluster --asg-access ajoute les permissions d'autoscaling et les tags de découverte requis.
Étape 4 : déployer le Cluster Autoscaler
Déployez le Cluster Autoscaler dans le cluster EKS, généralement dans le namespace kube-system. Il peut être installé via le manifeste officiel du Kubernetes Cluster Autoscaler ou son chart Helm.
Le déploiement doit spécifier AWS comme fournisseur cloud et configurer la découverte automatique pour le cluster. Par exemple :
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>Le déploiement officiel utilise également la classe de priorité system-cluster-critical, afin que l'autoscaler lui-même soit moins susceptible d'être évincé lorsque les ressources du cluster se raréfient.
Étape 5 : aligner la version de l'autoscaler sur la version Kubernetes d'EKS
Utilisez une version du Cluster Autoscaler correspondant à la version majeure et mineure de Kubernetes exécutée sur EKS. Par exemple, un cluster Kubernetes 1.32 doit généralement exécuter une version 1.32.x du Cluster Autoscaler plutôt qu'une version destinée à une autre version mineure de Kubernetes.
L'alignement des versions est important, car le Cluster Autoscaler dépend d'API Kubernetes et de comportements du scheduler susceptibles de changer d'une version à l'autre. Lors de la mise à niveau d'un cluster EKS, la version de l'autoscaler doit donc être vérifiée et mise à niveau si nécessaire.
Étape 6 : vérifier le fonctionnement du Cluster Autoscaler
Après le déploiement, vérifiez que le pod du Cluster Autoscaler est bien en cours d'exécution :
kubectl get pods -n kube-systemVous pouvez ensuite consulter ses logs :
kubectl logs -n kube-system deployment/cluster-autoscalerUn test concret consiste à déployer des workloads avec des demandes de ressources suffisamment élevées pour laisser des pods en attente. Si aucun nœud existant ne dispose d'une capacité suffisante, le Cluster Autoscaler doit détecter les pods non planifiables et augmenter la capacité souhaitée d'un groupe Auto Scaling éligible. Lorsque la demande diminue par la suite et que des nœuds restent inutiles, il peut réduire le groupe de nœuds dans les limites configurées.
EKS Cluster Autoscaler vs Horizontal Pod Autoscaler
L'EKS Cluster Autoscaler et le Horizontal Pod Autoscaler (HPA) opèrent à des niveaux différents d'un environnement EKS. Le Cluster Autoscaler met à l'échelle les nœuds worker, tandis que le HPA met à l'échelle les pods applicatifs. AWS recommande d'utiliser l'autoscaling des workloads, comme le HPA, conjointement avec un autoscaler de nœuds lorsque les applications et la capacité du cluster doivent toutes deux s'adapter dynamiquement à la demande.
Le Horizontal Pod Autoscaler surveille des métriques telles que le CPU, la mémoire ou des métriques personnalisées, et modifie le nombre de réplicas d'un workload tel qu'un Deployment. Si les réplicas supplémentaires ne peuvent pas être planifiés faute de capacité sur les nœuds existants, le Cluster Autoscaler peut alors ajouter des nœuds pour accueillir ces pods en attente.
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| Ce qu'il met à l'échelle | Nœuds worker | Pods |
| Déclencheur principal | Pods non planifiables et nœuds inutiles | Métriques CPU, mémoire, personnalisées ou externes |
| Objectif principal | Ajuster la capacité de calcul du cluster | Ajuster la capacité applicative |
| Interaction avec l'infrastructure AWS | Modifie la capacité des groupes EC2 Auto Scaling | Modifie le nombre de réplicas des workloads Kubernetes |
Par exemple, un HPA peut faire passer une application de cinq à dix pods lorsque l'utilisation du CPU augmente. Si le cluster ne dispose pas de ressources suffisantes pour ces pods supplémentaires, certains restent en attente, ce qui peut amener le Cluster Autoscaler à augmenter la capacité en nœuds.
Contenu associé : consultez notre guide sur le Kubernetes Vertical Pod Autoscaler (VPA).
EKS Cluster Autoscaler vs EKS Auto Mode
L'EKS Cluster Autoscaler est un composant d'autoscaling Kubernetes géré par le client, tandis qu'EKS Auto Mode offre une automatisation de l'infrastructure gérée par AWS qui inclut l'autoscaling du calcul. Le Cluster Autoscaler fonctionne principalement en augmentant ou en diminuant la capacité souhaitée de groupes EC2 Auto Scaling prédéfinis. EKS Auto Mode s'appuie quant à lui sur un système basé sur Karpenter, capable de provisionner des nœuds en fonction des besoins de chaque workload.
Avec le Cluster Autoscaler, les organisations restent responsables de l'installation et de la maintenance de l'autoscaler ainsi que de la configuration des groupes de nœuds, des groupes Auto Scaling, des permissions IAM et des limites de scaling. EKS Auto Mode supprime une grande partie de ce travail opérationnel : AWS gère le provisionnement des nœuds, leurs logiciels, les correctifs, l'autoscaling du calcul et plusieurs fonctionnalités d'infrastructure associées.
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| Modèle de scaling | Met à l'échelle des groupes Auto Scaling prédéfinis | Provisionnement dynamique des nœuds basé sur Karpenter |
| Groupes de nœuds | Nécessite généralement des groupes de nœuds managés ou autogérés | Utilise des NodePools et NodeClasses managés |
| Gestion | Le client installe et exploite l'autoscaler | AWS gère l'autoscaling du calcul |
| Sélection des instances | Limitée par la capacité et les types d'instances configurés dans les groupes de nœuds | Peut sélectionner la capacité appropriée selon les besoins des workloads |
| Cycle de vie des nœuds | Principalement contrôlé via les ASG et le Cluster Autoscaler | AWS gère le provisionnement, la consolidation, les mises à jour et le remplacement |
| Autres automatisations d'infrastructure | Axé sur le scaling des nœuds | Gère aussi le réseau, l'équilibrage de charge, le stockage bloc et d'autres composants |
EKS Auto Mode constitue donc une option d'infrastructure managée plus large, et pas simplement une autre version du Cluster Autoscaler. AWS indique qu'Auto Mode peut créer automatiquement des nœuds lorsque les pods ne tiennent pas sur la capacité existante, consolider les workloads et supprimer les nœuds devenus inutiles.
Bonnes pratiques pour l'EKS Cluster Autoscaler
Voici quelques mesures utiles à garder à l'esprit lorsque vous travaillez avec le Cluster Autoscaler dans EKS.
1. Utiliser les groupes de nœuds managés EKS lorsque c'est possible
AWS recommande d'utiliser les groupes de nœuds managés EKS avec le Cluster Autoscaler. Les groupes de nœuds managés prennent en charge une grande partie du cycle de vie des nœuds EC2, y compris le provisionnement, les mises à niveau, l'enregistrement et la mise hors service progressive des nœuds.
Ils s'intègrent également directement aux groupes EC2 Auto Scaling et offrent des fonctionnalités qui simplifient le fonctionnement du Cluster Autoscaler, comme la découverte automatique des groupes Auto Scaling et le drainage managé lors de nombreuses opérations du cycle de vie des nœuds.
2. Maintenir des groupes de nœuds aussi homogènes que possible
Les nœuds d'un même groupe doivent présenter des caractéristiques de planification identiques, y compris les labels, les taints et les ressources disponibles. Le Cluster Autoscaler modélise un groupe de nœuds comme si ses nœuds étaient interchangeables ; des différences importantes entre les instances peuvent donc conduire à des décisions de scaling erronées.
Avec une Mixed Instances Policy, AWS recommande de choisir des types d'instances offrant des capacités CPU, mémoire et GPU similaires. Le Cluster Autoscaler se base sur le premier type d'instance de la politique lors de la simulation de planification : des instances plus petites peuvent laisser des pods non planifiables, tandis que des instances plus grandes peuvent entraîner un gaspillage de ressources.
3. Limiter le nombre de groupes de nœuds
Préférez un petit nombre de grands groupes de nœuds plutôt que de créer de nombreux petits groupes pour chaque application ou équipe. À chaque cycle d'autoscaling, le Cluster Autoscaler évalue les pods non planifiables par rapport aux groupes de nœuds disponibles : multiplier les groupes augmente la charge de traitement et les appels d'API.
AWS identifie explicitement l'excès de groupes de nœuds comme un anti-pattern de scalabilité de l'autoscaling. Des groupes distincts restent pertinents lorsque les workloads nécessitent réellement des caractéristiques de planification différentes, comme des GPU, de la capacité Spot ou des ressources propres à une zone.
4. Définir des demandes de ressources précises pour les pods
Définissez des demandes de CPU et de mémoire réalistes pour vos workloads, afin que le scheduler Kubernetes et le Cluster Autoscaler disposent d'une représentation fidèle des ressources requises par chaque pod. L'autoscaler fonde ses décisions de scaling principalement sur les demandes de ressources des pods plutôt que sur l'utilisation réelle instantanée.
Des demandes trop élevées peuvent provoquer des ajouts de nœuds inutiles et un mauvais bin packing, tandis que des demandes trop faibles peuvent entraîner une contention des ressources même lorsque Kubernetes semble disposer d'une capacité suffisante. Des limites de ressources peuvent également être configurées, le cas échéant, pour contrôler la capacité supplémentaire qu'un conteneur peut consommer.
5. N'utiliser les node selectors et les taints qu'en cas de nécessité
Utilisez les node selectors, l'affinité de nœud et les taints lorsque les workloads nécessitent réellement des types de nœuds spécifiques, et non comme mode d'organisation par défaut de vos applications. Chaque restriction de planification supplémentaire réduit le nombre de nœuds sur lesquels un pod peut s'exécuter et peut contraindre le Cluster Autoscaler à maintenir des groupes de nœuds supplémentaires.
AWS recommande d'utiliser des mécanismes comme les namespaces Kubernetes pour l'isolation ordinaire des workloads et de traiter les node selectors et les taints comme des exceptions. Les groupes de nœuds dédiés restent utiles pour les workloads ayant de réelles exigences d'infrastructure, comme les GPU ou les instances Spot.
6. Configurer les Pod Disruption Budgets avec soin
Les Pod Disruption Budgets (PDB) protègent la disponibilité des applications lors des interruptions volontaires, mais des PDB trop restrictifs peuvent empêcher le Cluster Autoscaler de supprimer des nœuds pourtant inutiles. Avant de réduire la capacité, l'autoscaler doit déterminer si les workloads peuvent être évincés en toute sécurité et planifiés ailleurs.
Configurez les PDB de manière à garantir le niveau de disponibilité requis sans rendre l'éviction volontaire pratiquement impossible. Tenez également compte du comportement spécifique du cycle de vie des nœuds EKS : certaines opérations de mise hors service des groupes de nœuds managés peuvent finir par aboutir même lorsqu'un PDB empêche le drainage de tous les pods.
7. Utiliser des groupes Auto Scaling multi-AZ lorsque c'est pertinent
Pour les workloads sans exigences de planification liées à une zone de disponibilité, AWS recommande de définir la capacité régionale sous la forme d'un seul groupe EC2 Auto Scaling couvrant plusieurs zones de disponibilité. Cela peut réduire le nombre de groupes de nœuds que le Cluster Autoscaler doit évaluer et améliorer la scalabilité.
En revanche, les workloads liés à des ressources zonales demandent une attention particulière. Par exemple, les applications utilisant des volumes EBS propres à une zone, une affinité de nœud zonale obligatoire ou une affinité de pods propre à une zone peuvent nécessiter des groupes de nœuds distincts par zone de disponibilité. Pour les applications multi-AZ avec état utilisant EBS, AWS recommande des groupes de nœuds mono-AZ associés à --balance-similar-node-groups.
FAQ
Qu'est-ce que l'EKS Cluster Autoscaler ? L'Amazon EKS Cluster Autoscaler est un contrôleur Kubernetes qui ajuste le nombre de nœuds worker d'un cluster. Il ajoute des nœuds lorsque des pods ne peuvent pas être planifiés faute de ressources suffisantes et supprime les nœuds devenus inutiles.
Comment le Cluster Autoscaler décide-t-il d'ajouter des nœuds ? Il interroge l'API Kubernetes environ toutes les 10 secondes pour repérer les pods que le scheduler ne peut pas placer. Pour chacun d'eux, il simule la planification sur de nouveaux nœuds hypothétiques issus des groupes de nœuds disponibles, choisit un groupe selon sa stratégie d'expansion et augmente la capacité souhaitée de ce groupe jusqu'à ce que les pods soient placés ou que la taille maximale soit atteinte.
Pourquoi le Cluster Autoscaler ne supprime-t-il pas un nœud ?
Un nœud doit rester inutile pendant une durée définie avant d'être supprimé ; la valeur par défaut de --scale-down-unneeded-time est de 10 minutes. La réduction peut aussi être bloquée par des PodDisruptionBudgets restrictifs ou par des pods qui ne peuvent pas être déplacés en toute sécurité vers d'autres nœuds.
Quelle est la différence entre le Cluster Autoscaler et le Horizontal Pod Autoscaler ? Le Cluster Autoscaler met à l'échelle les nœuds worker, tandis que le Horizontal Pod Autoscaler met à l'échelle les pods applicatifs. Ils fonctionnent de pair : lorsque le HPA ajoute des réplicas qui ne tiennent pas sur les nœuds existants, les pods en attente peuvent déclencher l'ajout de nœuds par le Cluster Autoscaler.
Quelle est la différence entre le Cluster Autoscaler et EKS Auto Mode ? Le Cluster Autoscaler est un composant géré par le client qui met à l'échelle des groupes EC2 Auto Scaling prédéfinis. EKS Auto Mode est géré par AWS et s'appuie sur un système basé sur Karpenter qui provisionne des nœuds selon les besoins de chaque workload. Il gère également d'autres éléments d'infrastructure comme le réseau, l'équilibrage de charge et le stockage bloc.
Quelle version du Cluster Autoscaler exécuter sur EKS ? Utilisez une version correspondant à la version majeure et mineure de Kubernetes de votre cluster. Par exemple, un cluster Kubernetes 1.32 doit généralement exécuter une version 1.32.x du Cluster Autoscaler. Vérifiez la version de l'autoscaler à chaque mise à niveau du cluster.
Maximisez l'efficacité de l'EKS Cluster Autoscaler avec PerfectScale
Les autoscalers de nœuds comme le Cluster Autoscaler ajoutent et retirent des nœuds en fonction de la demande, ce qui améliore la disponibilité du cluster et réduit les coûts liés aux ressources inactives. Mais même un autoscaler bien configuré ne peut agir que sur les demandes de ressources qu'on lui fournit. Les conteneurs surprovisionnés gaspillent de la capacité et forcent l'autoscaler à ajouter plus de nœuds que nécessaire ; les conteneurs sous-provisionnés entraînent des évictions de pods, une pression sur les nœuds et des workloads instables ; et un bin packing inefficace laisse des ressources sous-utilisées tout en déclenchant des événements de scaling superflus. PerfectScale répond à ces défis en combinant le right-sizing autonome des workloads avec une visibilité approfondie sur vos groupes d'autoscaling et vos pools de nœuds, afin que votre Cluster Autoscaler prenne de meilleures décisions de scaling.
Fonctionnalités clés de PerfectScale :
- Détection proactive des erreurs de configuration : analyse en continu les workloads pour identifier et corriger les erreurs de configuration telles que CPU Request Not Set, Memory Request Not Set et Memory Limit Not Set, afin d'éviter les évictions imprévisibles, le surengagement des nœuds et un autoscaling inefficace.
- Right-sizing autonome des workloads : ajuste instantanément les ressources des workloads en fonction de l'utilisation réelle et améliore le bin packing des pods pour renforcer l'efficacité de l'autoscaling, le tout sans intervention manuelle.
- Visibilité sur les groupes d'autoscaling et les pools de nœuds : fournit une vue détaillée des coûts et de l'utilisation de vos groupes d'autoscaling et pools de nœuds, pour identifier les inefficacités et répartir les ressources avec précision.
- Sélection optimale des types de nœuds : vous aide à aligner les types de nœuds sur les besoins en CPU, mémoire et GPU de vos workloads afin d'améliorer l'utilisation, le bin packing et l'efficacité globale du cluster.
- Optimisation combinée au niveau des nœuds et des pods : associe l'optimisation au niveau des nœuds au right-sizing au niveau des pods pour des décisions de scaling plus rapides, de meilleures performances et des dépenses cloud réduites.
Découvrez comment PerfectScale vous aide à mettre à l'échelle vos nœuds Kubernetes sans tâtonnements