


O que é o EKS Cluster Autoscaler?
O Amazon EKS Cluster Autoscaler é um controlador do Kubernetes que ajusta automaticamente o número de nós de trabalho no seu cluster, monitorando pods pendentes que não podem ser agendados por falta de recursos e encerrando nós subutilizados. A maioria dos usuários do Reddit r/aws concorda que os grupos do Auto Scaling (ASGs) padrão, sozinhos, são insuficientes para workloads dinâmicos do Kubernetes, o que torna o Cluster Autoscaler essencial para lidar com solicitações de recursos em tempo real.
Como funciona:
- Detecção de pods não agendáveis: monitora pods que não podem ser alocados por falta de recursos ou por restrições de agendamento.
- Seleção de um grupo de nós do EKS para escalar: simula a alocação dos pods nos grupos de nós disponíveis e seleciona um grupo adequado para capacidade adicional.
- Aumento da capacidade do EC2 Auto Scaling Group: eleva a capacidade desejada do grupo do Auto Scaling selecionado para que novos nós de trabalho EC2 entrem no cluster.
- Identificação de nós subutilizados: determina se os workloads em nós desnecessários podem ser movidos para outro lugar com base nas solicitações de recursos e nos requisitos de agendamento.
- Redução segura de nós: verifica se os pods que podem ser movidos conseguem ser reagendados antes de reduzir a capacidade do grupo de nós e encerrar nós desnecessários.
Principais etapas de configuração:
- Configure os limites de escalonamento dos grupos de nós do EKS: defina a capacidade mínima, máxima e desejada de cada grupo de nós que o autoscaler pode gerenciar.
- Configure as permissões IAM do Cluster Autoscaler: conceda ao autoscaler permissão para inspecionar e modificar os grupos do EC2 Auto Scaling apropriados.
- Habilite a descoberta automática de grupos de nós: aplique as tags necessárias nos grupos do Auto Scaling para que o autoscaler possa descobrir os grupos de nós elegíveis do EKS.
- Implante o Cluster Autoscaler: instale-o no cluster e configure a AWS como provedor de nuvem com as configurações de descoberta automática adequadas.
- Alinhe a versão do autoscaler à versão do Kubernetes no EKS: use uma versão do Cluster Autoscaler compatível com a versão principal e secundária do Kubernetes do cluster.
- Verifique o funcionamento do Cluster Autoscaler: confira o pod e os logs do autoscaler e teste se pods não agendáveis acionam o scale-out de nós conforme esperado.
Este artigo faz parte de uma série sobre agendamento no Kubernetes
Neste artigo:
- Como funciona o EKS Cluster Autoscaler?
- Como configurar o Cluster Autoscaler no EKS
- EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
- EKS Cluster Autoscaler vs. EKS Auto Mode
- Boas práticas para o EKS Cluster Autoscaler
Como funciona o EKS Cluster Autoscaler?
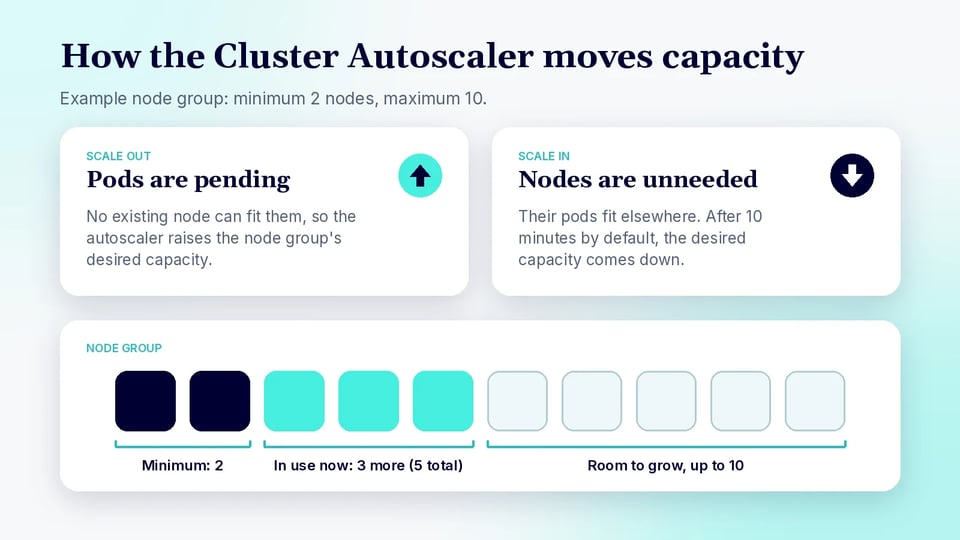
Detecção de pods não agendáveis
O Cluster Autoscaler verifica regularmente a API do Kubernetes em busca de pods que o scheduler não consegue alocar em nenhum nó existente. Um pod pode se tornar não agendável quando suas solicitações de CPU, memória, GPU ou outros recursos não podem ser atendidas, ou quando restrições de agendamento como node selectors, regras de afinidade e taints limitam onde ele pode ser executado.
Por padrão, o Cluster Autoscaler varre o cluster aproximadamente a cada 10 segundos. Ao encontrar pods não agendáveis, ele determina se adicionar capacidade a um dos grupos de nós configurados permitiria a execução desses pods.
Seleção de um grupo de nós do EKS para escalar
Para cada pod não agendável, o Cluster Autoscaler simula o agendamento do pod em novos nós hipotéticos dos grupos de nós do EKS disponíveis. Ele considera fatores como a capacidade de CPU e memória do grupo de nós, labels, taints e outras propriedades de agendamento.
A AWS recomenda que os nós dentro de um grupo tenham características de agendamento idênticas. Por exemplo, os tipos de instância usados com uma EC2 Mixed Instances Policy devem ter capacidade semelhante de CPU, memória e GPU, porque o Cluster Autoscaler usa o primeiro tipo de instância da política ao simular o agendamento. Depois de identificar os grupos adequados, a estratégia de expansão (expander) configurada determina qual grupo deve ser aumentado.
Aumento da capacidade do EC2 Auto Scaling Group
Após selecionar um grupo de nós adequado, o Cluster Autoscaler aumenta sua capacidade desejada. Os grupos de nós do EKS são baseados em grupos do EC2 Auto Scaling, então aumentar o grupo de nós faz com que instâncias EC2 sejam iniciadas e, em seguida, registradas como nós do Kubernetes.
Esse processo continua até haver capacidade suficiente ou até o grupo de nós atingir o tamanho máximo configurado. Com grupos de nós gerenciados do EKS, todo nó gerenciado pertence a um grupo do EC2 Auto Scaling, e o EKS sincroniza as informações de escalonamento do grupo de nós com as alterações feitas por componentes externos, como o Cluster Autoscaler.
Identificação de nós subutilizados
O Cluster Autoscaler também procura nós que não são mais necessários. Em vez de simplesmente monitorar a utilização real de CPU, ele avalia as solicitações de recursos do Kubernetes e determina se os workloads em execução em um nó poderiam ser agendados em outro lugar do cluster.
Um nó precisa permanecer desnecessário por um período configurado antes de se tornar elegível para remoção. O padrão de --scale-down-unneeded-time é de 10 minutos, embora esse e outros limites de scale-down possam ser ajustados. Esse atraso ajuda a evitar que nós sejam adicionados e removidos repetidamente durante flutuações de curto prazo nos workloads.
Redução segura de nós
Antes de remover um nó, o Cluster Autoscaler executa uma simulação de agendamento para verificar se os pods que podem ser movidos conseguem rodar em outros nós disponíveis. Certos workloads podem impedir o scale-down, incluindo pods protegidos por PodDisruptionBudgets restritivos ou pods que não podem ser movidos com segurança.
Quando um nó pode ser removido, o Cluster Autoscaler coordena sua remoção e reduz a capacidade desejada do grupo de nós correspondente. Com grupos de nós gerenciados do EKS, os encerramentos de nós incluem um comportamento de drenagem automática projetado para remover os workloads de forma controlada antes que a instância EC2 subjacente seja encerrada. Isso permite que o cluster reduza a capacidade ociosa minimizando a interrupção das aplicações em execução.
Como configurar o Cluster Autoscaler no EKS
Configurar o Cluster Autoscaler no Amazon EKS exige preparar os grupos de nós para autoscaling, conceder ao autoscaler permissão para modificar grupos do EC2 Auto Scaling e implantar uma versão do Cluster Autoscaler compatível com a versão do Kubernetes do cluster.
Etapa 1: Configure os limites de escalonamento dos grupos de nós do EKS
Comece configurando a capacidade mínima, máxima e desejada de cada grupo de nós gerenciado do EKS ou grupo autogerenciado do EC2 Auto Scaling que o Cluster Autoscaler vai controlar. O autoscaler só pode ajustar a capacidade dentro desses limites mínimo e máximo configurados.
Por exemplo, um grupo de nós pode ter um tamanho mínimo de 2 nós e máximo de 10. O Cluster Autoscaler pode então aumentar ou diminuir a capacidade desejada entre esses valores conforme a demanda dos workloads muda. A AWS recomenda configurar os grupos de nós de forma que as instâncias dentro do mesmo grupo tenham propriedades de agendamento equivalentes e capacidade de recursos semelhante.
Etapa 2: Configure as permissões IAM do Cluster Autoscaler
O Cluster Autoscaler requer permissões do AWS IAM para inspecionar grupos do Auto Scaling e alterar sua capacidade desejada. A AWS recomenda conceder essas permissões à service account do Kubernetes usada pelo autoscaler, em vez de atribuir permissões amplas a todos os nós de trabalho.
No EKS, isso pode ser configurado usando uma role do IAM associada à service account cluster-autoscaler no namespace kube-system. A política deve permitir que o autoscaler execute as ações necessárias do Auto Scaling, restringindo as operações de escalonamento aos grupos do Auto Scaling associados ao cluster EKS relevante.
Etapa 3: Habilite a descoberta automática de grupos de nós
A AWS recomenda usar a descoberta automática do Cluster Autoscaler em vez de listar manualmente grupos individuais do Auto Scaling. A descoberta automática permite que o autoscaler identifique quais grupos de nós pertencem ao cluster EKS examinando as tags dos grupos do Auto Scaling.
As tags de descoberta mais usadas são:
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedFerramentas como o eksctl podem configurar essas tags automaticamente. Por exemplo, criar um cluster com eksctl create cluster --asg-access adiciona as permissões de autoscaling e as tags de descoberta necessárias.
Etapa 4: Implante o Cluster Autoscaler
Implante o Cluster Autoscaler no cluster EKS, normalmente no namespace kube-system. Ele pode ser instalado usando o manifesto oficial do Kubernetes Cluster Autoscaler ou seu Helm chart.
A implantação deve especificar a AWS como provedor de nuvem e configurar a descoberta automática para o cluster. Por exemplo:
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>A implantação oficial também usa a priority class system-cluster-critical, para que o próprio autoscaler tenha menos chance de ser despejado quando os recursos do cluster ficarem limitados.
Etapa 5: Alinhe a versão do autoscaler à versão do Kubernetes no EKS
Use uma versão do Cluster Autoscaler que corresponda à versão principal e secundária do Kubernetes em execução no EKS. Por exemplo, um cluster com Kubernetes 1.32 geralmente deve executar uma versão 1.32.x do Cluster Autoscaler, e não uma versão destinada a outra versão secundária do Kubernetes.
Manter as versões alinhadas é importante porque o Cluster Autoscaler depende de APIs do Kubernetes e de comportamentos do scheduler que podem mudar entre versões. Ao atualizar um cluster EKS, a versão do autoscaler deve, portanto, ser revisada e atualizada conforme necessário.
Etapa 6: Verifique o funcionamento do Cluster Autoscaler
Após a implantação, verifique se o pod do Cluster Autoscaler está em execução:
kubectl get pods -n kube-systemEm seguida, você pode inspecionar os logs:
kubectl logs -n kube-system deployment/cluster-autoscalerUm teste prático é implantar workloads com solicitações de recursos grandes o suficiente para deixar pods pendentes. Se nenhum nó existente tiver capacidade suficiente, o Cluster Autoscaler deve detectar os pods não agendáveis e aumentar a capacidade desejada de um grupo do Auto Scaling elegível. Quando a demanda diminuir e os nós permanecerem desnecessários, ele pode reduzir o grupo de nós novamente dentro dos limites configurados.
EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
O EKS Cluster Autoscaler e o Horizontal Pod Autoscaler (HPA) operam em camadas diferentes de um ambiente EKS. O Cluster Autoscaler escala os nós de trabalho, enquanto o HPA escala os pods das aplicações. A AWS recomenda usar o autoscaling de workloads, como o HPA, junto com um autoscaler de nós quando as aplicações e a capacidade do cluster precisam responder dinamicamente à demanda.
O Horizontal Pod Autoscaler monitora métricas como CPU, memória ou métricas personalizadas e altera o número de réplicas de um workload, como um Deployment. Se as réplicas adicionais não puderem ser agendadas porque os nós existentes não têm capacidade, o Cluster Autoscaler pode então adicionar nós para acomodar esses pods pendentes.
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| O que ele escala | Nós de trabalho | Pods |
| Gatilho principal | Pods não agendáveis e nós desnecessários | CPU, memória, métricas personalizadas ou externas |
| Objetivo principal | Ajustar a capacidade computacional do cluster | Ajustar a capacidade da aplicação |
| Interação com a infraestrutura AWS | Altera a capacidade do grupo do EC2 Auto Scaling | Altera o número de réplicas dos workloads do Kubernetes |
Por exemplo, um HPA pode aumentar uma aplicação de cinco para dez pods quando a utilização de CPU sobe. Se o cluster não tiver recursos suficientes para os pods adicionais, alguns ficam pendentes, o que pode acionar o Cluster Autoscaler para aumentar a capacidade de nós.
Conteúdo relacionado: leia nosso guia sobre o Kubernetes Vertical Pod Autoscaler (VPA).
EKS Cluster Autoscaler vs. EKS Auto Mode
O EKS Cluster Autoscaler é um componente de autoscaling do Kubernetes gerenciado pelo cliente, enquanto o EKS Auto Mode oferece automação de infraestrutura gerenciada pela AWS que inclui o autoscaling de computação. O Cluster Autoscaler funciona principalmente aumentando ou diminuindo a capacidade desejada de grupos predefinidos do EC2 Auto Scaling. Já o EKS Auto Mode usa um sistema baseado no Karpenter que pode provisionar nós em resposta aos requisitos individuais dos workloads.
Com o Cluster Autoscaler, as organizações continuam responsáveis por instalar e manter o autoscaler e por configurar grupos de nós, grupos do Auto Scaling, permissões IAM e limites de escalonamento adequados. O EKS Auto Mode elimina boa parte desse trabalho operacional: a AWS gerencia o provisionamento de nós, o software dos nós, a aplicação de patches, o autoscaling de computação e diversos recursos de infraestrutura relacionados.
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| Modelo de escalonamento | Escala grupos predefinidos do Auto Scaling | Provisionamento dinâmico de nós baseado no Karpenter |
| Grupos de nós | Normalmente requer grupos de nós gerenciados ou autogerenciados | Usa NodePools e NodeClasses gerenciados |
| Gerenciamento | O cliente instala e opera o autoscaler | A AWS gerencia o autoscaling de computação |
| Seleção de instâncias | Limitada pela capacidade e pelos tipos de instância configurados no grupo de nós | Pode selecionar a capacidade apropriada com base nos requisitos dos workloads |
| Ciclo de vida dos nós | Controlado principalmente por ASGs e pelo Cluster Autoscaler | A AWS gerencia provisionamento, consolidação, atualizações e substituição |
| Outras automações de infraestrutura | Focado no escalonamento de nós | Também gerencia rede, balanceamento de carga, armazenamento em bloco e outros componentes |
O EKS Auto Mode é, portanto, uma opção de infraestrutura gerenciada mais ampla, e não apenas outra versão do Cluster Autoscaler. A AWS afirma que o Auto Mode pode criar nós automaticamente quando os pods não cabem na capacidade existente, consolidar workloads e remover nós que não são mais necessários.
Boas práticas para o EKS Cluster Autoscaler
Confira algumas medidas úteis para ter em mente ao trabalhar com o Cluster Autoscaler no EKS.
1. Use grupos de nós gerenciados do EKS sempre que possível
A AWS recomenda usar grupos de nós gerenciados do EKS com o Cluster Autoscaler. Os grupos de nós gerenciados cuidam de boa parte do ciclo de vida dos nós EC2 para você, incluindo provisionamento, upgrades, registro e encerramento controlado dos nós.
Eles também se integram diretamente aos grupos do EC2 Auto Scaling e incluem recursos que simplificam a operação do Cluster Autoscaler, como a descoberta automática de grupos do Auto Scaling e a drenagem gerenciada durante muitas operações do ciclo de vida dos nós.
2. Mantenha os grupos de nós o mais homogêneos possível
Os nós dentro do mesmo grupo devem ter características de agendamento idênticas, incluindo labels, taints e recursos disponíveis. O Cluster Autoscaler modela um grupo de nós como se seus nós fossem intercambiáveis, então grandes diferenças entre instâncias podem gerar decisões de escalonamento imprecisas.
Ao usar uma Mixed Instances Policy, a AWS recomenda escolher tipos de instância com capacidade semelhante de CPU, memória e GPU. O Cluster Autoscaler usa o primeiro tipo de instância da política ao simular o agendamento; instâncias menores podem deixar pods não agendáveis, enquanto instâncias maiores podem resultar em desperdício de recursos.
3. Minimize o número de grupos de nós
Prefira um número menor de grupos de nós maiores em vez de criar muitos grupos pequenos para aplicações ou times individuais. A cada ciclo de autoscaling, o Cluster Autoscaler avalia os pods não agendáveis em relação aos grupos de nós disponíveis, então aumentar o número de grupos aumenta a sobrecarga de processamento e de API.
A AWS identifica especificamente o excesso de grupos de nós como um antipadrão de escalabilidade no autoscaling. Grupos separados continuam sendo apropriados quando os workloads realmente exigem características de agendamento diferentes, como GPUs, capacidade Spot ou recursos específicos de zona.
4. Defina solicitações de recursos precisas para os pods
Defina solicitações realistas de CPU e memória para os workloads, para que o scheduler do Kubernetes e o Cluster Autoscaler tenham uma representação precisa dos recursos que cada pod exige. O autoscaler baseia suas decisões de escalonamento principalmente nas solicitações de recursos dos pods, e não na utilização real instantânea dos recursos.
Solicitações muito altas podem causar scale-outs desnecessários de nós e um bin-packing ruim, enquanto solicitações muito baixas podem levar à disputa por recursos mesmo quando o Kubernetes parece ter capacidade suficiente. Limites de recursos também podem ser configurados quando apropriado para controlar quanta capacidade adicional um contêiner pode consumir.
5. Use node selectors e taints apenas quando necessário
Use node selectors, afinidade de nós e taints quando os workloads realmente exigirem tipos específicos de nós, e não como a forma padrão de organizar as aplicações. Cada restrição adicional de agendamento reduz o número de nós em que um pod pode rodar e pode forçar o Cluster Autoscaler a manter grupos de nós adicionais.
A AWS recomenda usar mecanismos como namespaces do Kubernetes para o isolamento comum de workloads e tratar node selectors e taints como exceções. Grupos de nós dedicados continuam úteis para workloads com requisitos reais de infraestrutura, como GPUs ou instâncias Spot.
6. Configure os Pod Disruption Budgets com cuidado
Os Pod Disruption Budgets (PDBs) podem proteger a disponibilidade das aplicações durante interrupções voluntárias, mas PDBs excessivamente restritivos podem impedir que o Cluster Autoscaler remova nós que seriam desnecessários. Antes de reduzir a capacidade, o autoscaler precisa determinar se os workloads podem ser despejados com segurança e agendados em outro lugar.
Configure os PDBs para fornecer o nível de disponibilidade necessário sem tornar o despejo voluntário praticamente impossível. Considere também o comportamento específico do ciclo de vida dos nós no EKS: algumas operações de encerramento de grupos de nós gerenciados podem acabar prosseguindo mesmo quando um PDB impede que todos os pods sejam drenados.
7. Use grupos do Auto Scaling multi-AZ quando apropriado
Para workloads sem requisitos de agendamento específicos de Zona de Disponibilidade, a AWS recomenda definir a capacidade regional como um único grupo do EC2 Auto Scaling abrangendo várias Zonas de Disponibilidade. Isso pode reduzir o número de grupos de nós que o Cluster Autoscaler precisa avaliar e melhorar a escalabilidade.
No entanto, workloads vinculados a recursos zonais exigem atenção adicional. Por exemplo, aplicações que usam volumes EBS específicos de zona, afinidade de nós obrigatória baseada em zona ou afinidade de pods específica de zona podem precisar de grupos de nós separados para cada Zona de Disponibilidade. Para aplicações multi-AZ com estado que usam EBS, a AWS recomenda grupos de nós de AZ única junto com --balance-similar-node-groups.
FAQ
O que é o EKS Cluster Autoscaler? O Amazon EKS Cluster Autoscaler é um controlador do Kubernetes que ajusta o número de nós de trabalho em um cluster. Ele adiciona nós quando os pods não podem ser agendados por falta de recursos e remove nós que não são mais necessários.
Como o Cluster Autoscaler decide adicionar nós? Ele verifica a API do Kubernetes aproximadamente a cada 10 segundos em busca de pods que o scheduler não consegue alocar. Para cada um, ele simula o agendamento em novos nós hipotéticos dos grupos de nós disponíveis, escolhe um grupo usando sua estratégia de expansão (expander) e aumenta a capacidade desejada desse grupo até que os pods caibam ou o tamanho máximo seja atingido.
Por que o Cluster Autoscaler não está reduzindo um nó?
Um nó precisa permanecer desnecessário por um tempo definido antes da remoção, e o padrão de --scale-down-unneeded-time é de 10 minutos. O scale-down também pode ser bloqueado por PodDisruptionBudgets restritivos ou por pods que não podem ser movidos com segurança para outros nós.
Qual é a diferença entre o Cluster Autoscaler e o Horizontal Pod Autoscaler? O Cluster Autoscaler escala os nós de trabalho, enquanto o Horizontal Pod Autoscaler escala os pods das aplicações. Eles trabalham juntos. Quando o HPA adiciona réplicas que não cabem nos nós existentes, os pods pendentes podem acionar o Cluster Autoscaler para adicionar nós.
Qual é a diferença entre o Cluster Autoscaler e o EKS Auto Mode? O Cluster Autoscaler é um componente gerenciado pelo cliente que escala grupos predefinidos do EC2 Auto Scaling. O EKS Auto Mode é gerenciado pela AWS e usa um sistema baseado no Karpenter que provisiona nós conforme as necessidades individuais dos workloads. Ele também gerencia outros recursos de infraestrutura, como rede, balanceamento de carga e armazenamento em bloco.
Qual versão do Cluster Autoscaler devo executar no EKS? Use uma versão que corresponda à versão principal e secundária do Kubernetes do seu cluster. Por exemplo, um cluster com Kubernetes 1.32 geralmente deve executar uma versão 1.32.x do Cluster Autoscaler. Revise a versão do autoscaler sempre que atualizar o cluster.
Maximize a eficiência do EKS Cluster Autoscaler com a PerfectScale
Autoscalers de nós como o Cluster Autoscaler aumentam e reduzem nós conforme a demanda, melhorando a disponibilidade do cluster e reduzindo custos com ociosidade. Mas mesmo um autoscaler bem configurado só pode agir com base nas solicitações de recursos que recebe. Contêineres superprovisionados desperdiçam capacidade e forçam o autoscaler a adicionar mais nós do que o necessário, contêineres subprovisionados levam a despejos de pods, pressão nos nós e workloads instáveis, e um bin-packing ineficiente deixa recursos subutilizados enquanto dispara eventos de escalonamento desnecessários. A PerfectScale resolve esses desafios combinando o right-sizing autônomo de workloads com visibilidade profunda dos seus grupos de autoscaling e pools de nós, para que o seu Cluster Autoscaler tome decisões de escalonamento melhores.
Principais recursos da PerfectScale:
- Detecção proativa de erros de configuração: analisa continuamente os workloads para identificar e corrigir erros de configuração como CPU Request Not Set, Memory Request Not Set e Memory Limit Not Set, evitando despejos imprevisíveis, sobrecarga dos nós e autoscaling ineficiente.
- Right-sizing autônomo de workloads: ajusta instantaneamente os recursos dos workloads com base na utilização real e melhora o bin-packing dos pods para aumentar a eficiência do autoscaling, tudo sem intervenção manual.
- Visibilidade de grupos de autoscaling e pools de nós: fornece insights detalhados sobre os custos e a utilização dos seus grupos de autoscaling e pools de nós, ajudando você a identificar ineficiências e alcançar uma distribuição precisa de recursos.
- Seleção ideal de tipos de nó: ajuda você a combinar os tipos de nó com os requisitos de CPU, memória e GPU dos seus workloads para melhorar a utilização, o bin-packing e a eficiência geral do cluster.
- Otimização combinada no nível de nó e de pod: une a otimização no nível de nó ao right-sizing no nível de pod para permitir decisões de escalonamento mais rápidas, melhor desempenho e menor gasto com nuvem.