


EKS Cluster Autoscalerとは
Amazon EKS Cluster Autoscalerは、リソース不足でスケジュールできない保留中のPodを監視し、使用率の低いノードを終了することで、クラスター内のワーカーノード数を自動的に調整するKubernetesコントローラーです。Reddit r/awsの多くのユーザーは、デフォルトのAuto Scalingグループ(ASG)だけでは動的なKubernetesワークロードに対応できないという点で一致しており、リアルタイムのリソース要求に対応するうえでCluster Autoscalerは不可欠な存在となっています。
動作の流れ:
- スケジュール不能なPodの検出: リソース不足やスケジューリング制約によって配置できないPodを監視します。
- スケール対象のEKSノードグループの選定: 利用可能なノードグループに対してPodの配置をシミュレートし、容量追加に適したグループを選択します。
- EC2 Auto Scalingグループの容量の増加: 選択したAuto Scalingグループの希望容量を引き上げ、新しいEC2ワーカーノードをクラスターに参加させます。
- 使用率の低いノードの特定: リソースリクエストとスケジューリング要件に基づき、不要なノード上のワークロードを他へ移動できるかを判断します。
- 安全なノードのスケールイン: 移動可能なPodを再スケジュールできることを確認したうえで、ノードグループの容量を削減し、不要なノードを終了します。
主な設定手順:
- EKSノードグループのスケーリング上限の設定: オートスケーラーが管理する各ノードグループに最小・最大・希望容量を設定します。
- Cluster AutoscalerのIAM権限の設定: 対象となるEC2 Auto Scalingグループの参照と変更を行う権限をオートスケーラーに付与します。
- ノードグループの自動検出の有効化: 対象となるEKSノードグループを検出できるよう、必要なAuto Scalingグループタグを付与します。
- Cluster Autoscalerのデプロイ: クラスターにインストールし、AWSをクラウドプロバイダーとして指定して適切な自動検出設定を行います。
- オートスケーラーのバージョンをEKSのKubernetesバージョンに合わせる: クラスターのKubernetesメジャー・マイナーバージョンに一致するCluster Autoscalerリリースを使用します。
- Cluster Autoscalerの動作確認: オートスケーラーのPodとログを確認し、スケジュール不能なPodが想定どおりノードのスケールアウトをトリガーすることをテストします。
本記事はKubernetesスケジューリングに関する連載記事の一部です
本記事の内容:
- EKS Cluster Autoscalerの仕組み
- EKSにCluster Autoscalerをセットアップする方法
- EKS Cluster AutoscalerとHorizontal Pod Autoscalerの比較
- EKS Cluster AutoscalerとEKS Auto Modeの比較
- EKS Cluster Autoscalerのベストプラクティス
EKS Cluster Autoscalerの仕組み
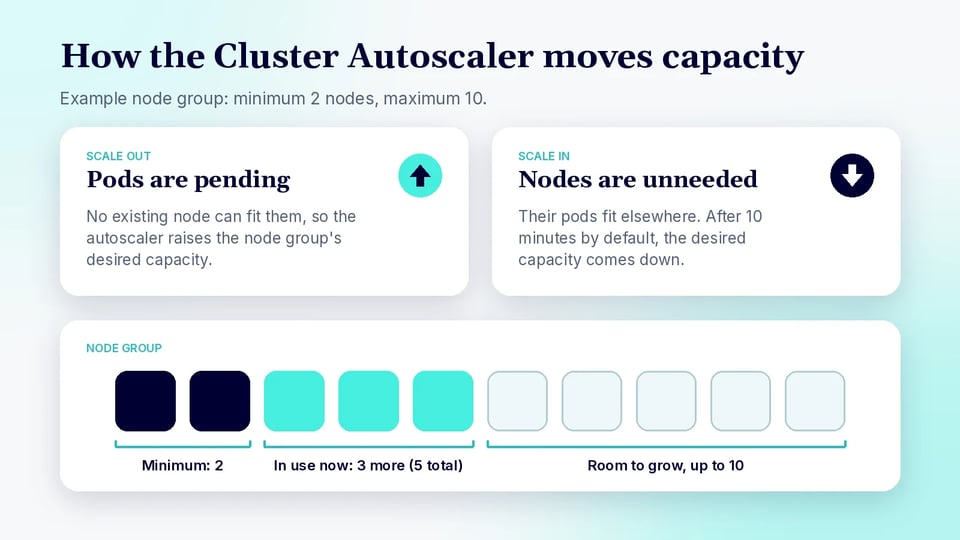
スケジュール不能なPodの検出
Cluster Autoscalerは、既存のどのノードにもスケジューラーが配置できないPodがないか、Kubernetes APIを定期的にチェックします。CPU、メモリ、GPUなどのリソースリクエストを満たせない場合や、ノードセレクター、アフィニティルール、taintといったスケジューリング制約によって実行場所が制限される場合に、Podはスケジュール不能になることがあります。
デフォルトでは、Cluster Autoscalerは約10秒ごとにクラスターをスキャンします。スケジュール不能なPodを検出すると、設定済みのノードグループのいずれかに容量を追加すれば、それらのPodを実行できるかどうかを判断します。
スケール対象のEKSノードグループの選定
Cluster Autoscalerは、スケジュール不能なPodごとに、利用可能なEKSノードグループから作成される仮想的な新規ノードへのスケジューリングをシミュレートします。その際、ノードグループのCPUおよびメモリ容量、ラベル、taint、その他のスケジューリング特性などの要素を考慮します。
AWSは、ノードグループ内のノードが同一のスケジューリング特性を持つことを推奨しています。たとえば、EC2のMixed Instances Policyで使用するインスタンスタイプは、CPU・メモリ・GPU容量が近いものにすべきです。Cluster Autoscalerはスケジューリングのシミュレーション時にポリシー内の最初のインスタンスタイプを使用するためです。適切なグループを特定すると、設定されたexpander戦略に基づいて、どのグループを増やすかが決定されます。
EC2 Auto Scalingグループの容量の増加
適切なノードグループを選択すると、Cluster Autoscalerはその**希望容量(desired capacity)**を増やします。EKSノードグループの実体はEC2 Auto Scalingグループであるため、ノードグループを増やすとEC2インスタンスが起動し、Kubernetesノードとして登録されます。
このプロセスは、十分な容量が確保されるか、ノードグループが設定された最大サイズに達するまで続きます。EKSマネージドノードグループでは、すべてのマネージドノードがEC2 Auto Scalingグループに属しており、EKSはCluster Autoscalerなどの外部コンポーネントによる変更とノードグループのスケーリング情報を同期します。
使用率の低いノードの特定
Cluster Autoscalerは、不要になったノードも探します。実際のCPU使用率を単純に監視するのではなく、Kubernetesのリソースリクエストを評価し、ノード上で実行中のワークロードをクラスター内の他の場所にスケジュールできるかどうかを判断します。
ノードは、設定された期間にわたって不要な状態が続いた場合にのみ削除対象となります。デフォルトの--scale-down-unneeded-timeは10分ですが、この値やその他のスケールダウンのしきい値は調整可能です。この遅延により、短期的なワークロード変動の際にノードの追加と削除が繰り返されるのを防ぎます。
安全なノードのスケールイン
ノードを削除する前に、Cluster Autoscalerはスケジューリングシミュレーションを実行し、移動可能なPodが他の利用可能なノードで実行できることを検証します。制限の厳しいPodDisruptionBudgetで保護されたPodや、安全に移動できないPodなど、一部のワークロードはスケールダウンを妨げることがあります。
ノードを削除できる場合、Cluster Autoscalerはその削除を調整し、対応するノードグループの希望容量を減らします。EKSマネージドノードグループでは、ノードの終了時に自動ドレイン処理が行われ、基盤となるEC2インスタンスが終了される前にワークロードが正常に退避されます。これにより、実行中のアプリケーションへの影響を最小限に抑えながら、未使用の容量を削減できます。
EKSにCluster Autoscalerをセットアップする方法
Amazon EKSでCluster Autoscalerをセットアップするには、オートスケーリング用のノードグループの構成、EC2 Auto Scalingグループを変更する権限の付与、クラスターのKubernetesバージョンと互換性のあるCluster Autoscalerバージョンのデプロイが必要です。
ステップ1:EKSノードグループのスケーリング上限を設定する
まず、Cluster Autoscalerが制御する各EKSマネージドノードグループまたはセルフマネージドのEC2 Auto Scalingグループに対して、最小・最大・希望容量を設定します。オートスケーラーは、設定された最小値と最大値の範囲内でのみ容量を調整できます。
たとえば、あるノードグループの最小サイズを2ノード、最大サイズを10ノードとした場合、Cluster Autoscalerはワークロードの需要に応じてその範囲内で希望容量を増減できます。AWSは、同一グループ内のインスタンスが同等のスケジューリング特性と近いリソース容量を持つようにノードグループを構成することを推奨しています。
ステップ2:Cluster AutoscalerのIAM権限を設定する
Cluster Autoscalerは、Auto Scalingグループを参照し、その希望容量を変更するためのAWS IAM権限を必要とします。AWSは、すべてのワーカーノードに広範な権限を割り当てるのではなく、オートスケーラーが使用するKubernetesサービスアカウントにこれらの権限を付与することを推奨しています。
EKSでは、kube-system名前空間のcluster-autoscalerサービスアカウントに関連付けられたIAMロールを使用して設定できます。ポリシーでは、必要なAuto Scalingアクションの実行を許可しつつ、スケーリング操作を対象のEKSクラスターに関連付けられたAuto Scalingグループに制限する必要があります。
ステップ3:ノードグループの自動検出を有効にする
AWSは、個々のAuto Scalingグループを手動で列挙する代わりに、Cluster Autoscalerの自動検出を使用することを推奨しています。自動検出を使うと、オートスケーラーはAuto Scalingグループのタグを調べることで、どのノードグループがEKSクラスターに属しているかを識別できます。
一般的に使用される検出用タグは次のとおりです:
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedeksctlなどのツールを使えば、これらのタグを自動で設定できます。たとえば、eksctl create cluster --asg-accessでクラスターを作成すると、必要なオートスケーリング権限と検出用タグが追加されます。
ステップ4:Cluster Autoscalerをデプロイする
Cluster AutoscalerをEKSクラスターに、通常はkube-system名前空間にデプロイします。公式のKubernetes Cluster AutoscalerマニフェストまたはHelmチャートを使用してインストールできます。
デプロイでは、AWSをクラウドプロバイダーとして指定し、クラスターの自動検出を設定する必要があります。例:
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>公式のデプロイでは、クラスターのリソースが逼迫した際にオートスケーラー自身が退避されにくくなるよう、system-cluster-critical優先度クラスも使用されています。
ステップ5:オートスケーラーのバージョンをEKSのKubernetesバージョンに合わせる
EKSで実行しているKubernetesのメジャー・マイナーバージョンに一致するCluster Autoscalerリリースを使用してください。たとえば、Kubernetes 1.32のクラスターでは、他のKubernetesマイナーバージョン向けのリリースではなく、原則としてCluster Autoscaler 1.32.x系のリリースを実行すべきです。
バージョンを揃えることが重要なのは、Cluster Autoscalerが、リリースごとに変わりうるKubernetes APIやスケジューラーの動作に依存しているためです。そのため、EKSクラスターをアップグレードする際には、オートスケーラーのバージョンも確認し、必要に応じてアップグレードする必要があります。
ステップ6:Cluster Autoscalerの動作を確認する
デプロイ後、Cluster AutoscalerのPodが実行中であることを確認します:
kubectl get pods -n kube-system続いてログを確認できます:
kubectl logs -n kube-system deployment/cluster-autoscaler実践的なテストとして、Podが保留状態になる程度に大きなリソースリクエストを持つワークロードをデプロイする方法があります。既存のノードに十分な容量がなければ、Cluster Autoscalerがスケジュール不能なPodを検出し、対象のAuto Scalingグループの希望容量を増やすはずです。その後、需要が減少してノードが不要な状態が続けば、設定された上限の範囲内でノードグループをスケールダウンできます。
EKS Cluster AutoscalerとHorizontal Pod Autoscalerの比較
EKS Cluster AutoscalerとHorizontal Pod Autoscaler(HPA)は、EKS環境の異なるレイヤーで動作します。Cluster Autoscalerはワーカーノードをスケールし、HPAはアプリケーションのPodをスケールします。AWSは、アプリケーションとクラスター容量の両方を需要に応じて動的に対応させる必要がある場合、HPAなどのワークロードオートスケーリングをノードオートスケーラーと併用することを推奨しています。
Horizontal Pod Autoscalerは、CPUやメモリ、カスタムメトリクスなどを監視し、Deploymentなどのワークロードのレプリカ数を変更します。既存ノードの容量不足で増やしたレプリカをスケジュールできない場合、Cluster Autoscalerがノードを追加して保留中のPodを収容できます。
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| スケール対象 | ワーカーノード | Pod |
| 主なトリガー | スケジュール不能なPodと不要なノード | CPU、メモリ、カスタム、外部メトリクス |
| 主な目的 | クラスターのコンピューティング容量の調整 | アプリケーション容量の調整 |
| AWSインフラとの連携 | EC2 Auto Scalingグループの容量を変更 | Kubernetesワークロードのレプリカ数を変更 |
たとえば、CPU使用率が上昇した際に、HPAがアプリケーションのPodを5個から10個に増やすことがあります。クラスターに追加Pod分のリソースが不足していると、一部のPodが保留状態となり、それがCluster Autoscalerによるノード容量の増加をトリガーすることがあります。
関連コンテンツ:Kubernetes Vertical Pod Autoscaler(VPA)のガイドもご覧ください。
EKS Cluster AutoscalerとEKS Auto Modeの比較
EKS Cluster Autoscalerはユーザーが管理するKubernetesオートスケーリングコンポーネントであるのに対し、EKS Auto Modeはコンピューティングのオートスケーリングを含むAWSマネージドのインフラ自動化を提供します。Cluster Autoscalerは主に、事前定義されたEC2 Auto Scalingグループの希望容量を増減することで動作します。一方、EKS Auto ModeはKarpenterベースのシステムを使用し、個々のワークロード要件に応じてノードをプロビジョニングできます。
Cluster Autoscalerを使用する場合、組織はオートスケーラーのインストールと保守、適切なノードグループ、Auto Scalingグループ、IAM権限、スケーリング上限の設定に引き続き責任を負います。EKS Auto Modeはこうした運用作業の多くを不要にします。AWSがノードのプロビジョニング、ノードソフトウェア、パッチ適用、コンピューティングのオートスケーリング、および関連するいくつかのインフラ機能を管理します。
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| スケーリングモデル | 事前定義されたAuto Scalingグループをスケール | Karpenterベースの動的ノードプロビジョニング |
| ノードグループ | 通常、マネージドまたはセルフマネージドのノードグループが必要 | マネージドのNodePoolとNodeClassを使用 |
| 管理 | ユーザーがオートスケーラーをインストール・運用 | AWSがコンピューティングのオートスケーリングを管理 |
| インスタンスの選択 | 設定済みノードグループの容量とインスタンスタイプに制約される | ワークロード要件に基づいて適切な容量を選択可能 |
| ノードのライフサイクル | 主にASGとCluster Autoscalerで制御 | AWSがプロビジョニング、統合、更新、置き換えを管理 |
| その他のインフラ自動化 | ノードスケーリングに特化 | ネットワーキング、ロードバランシング、ブロックストレージなども管理 |
したがって、EKS Auto Modeは単なるCluster Autoscalerの別バージョンではなく、より広範なマネージドインフラの選択肢です。AWSによれば、Auto Modeは既存の容量にPodが収まらない場合にノードを自動作成し、ワークロードを統合し、不要になったノードを削除できます。
EKS Cluster Autoscalerのベストプラクティス
EKSでCluster Autoscalerを使用する際に押さえておきたいポイントを紹介します。
1. 可能な限りEKSマネージドノードグループを使用する
AWSは、Cluster AutoscalerとともにEKSマネージドノードグループを使用することを推奨しています。マネージドノードグループは、プロビジョニング、アップグレード、登録、ノードの安全な終了など、EC2ノードのライフサイクル管理の多くを代行します。
また、EC2 Auto Scalingグループと直接統合されており、Auto Scalingグループの自動検出や、多くのノードライフサイクル操作におけるマネージドなドレイン処理など、Cluster Autoscalerの運用を簡素化する機能を備えています。
2. ノードグループを可能な限り均一に保つ
同一ノードグループ内のノードは、ラベル、taint、利用可能なリソースを含め、同一のスケジューリング特性を持つべきです。Cluster Autoscalerはノードグループ内のノードを互いに交換可能なものとしてモデル化するため、インスタンス間の差が大きいと不正確なスケーリング判断につながる可能性があります。
Mixed Instances Policyを使用する場合、AWSはCPU・メモリ・GPU容量が近いインスタンスタイプを選ぶことを推奨しています。Cluster Autoscalerはスケジューリングのシミュレーション時にポリシー内の最初のインスタンスタイプを使用するため、より小さいインスタンスではPodがスケジュール不能のまま残り、より大きいインスタンスではリソースの無駄が生じる可能性があります。
3. ノードグループの数を最小限に抑える
アプリケーションやチームごとに多数の小さなグループを作成するのではなく、少数の大きなノードグループを優先してください。Cluster Autoscalerは各オートスケーリングサイクルで、スケジュール不能なPodを利用可能なノードグループに対して評価するため、グループ数が増えると処理とAPIのオーバーヘッドが増加します。
AWSは、過剰なノードグループをオートスケーリングのスケーラビリティにおけるアンチパターンとして明示的に挙げています。GPU、Spot容量、ゾーン固有のリソースなど、ワークロードが本当に異なるスケジューリング特性を必要とする場合には、グループを分けることが依然として適切です。
4. Podのリソースリクエストを正確に設定する
KubernetesスケジューラーとCluster Autoscalerが各Podの必要リソースを正確に把握できるよう、ワークロードには現実的なCPUおよびメモリのリクエストを定義してください。オートスケーラーは、実際の瞬間的なリソース使用率ではなく、主にPodのリソースリクエストに基づいてスケーリングを判断します。
リクエストが高すぎると不要なノードのスケールアウトやビンパッキングの悪化を招き、低すぎるとKubernetes上では容量が十分に見えてもリソース競合が発生する可能性があります。必要に応じてリソースリミットを設定し、コンテナが消費できる追加容量を制御することもできます。
5. ノードセレクターとtaintは必要な場合にのみ使用する
ノードセレクター、ノードアフィニティ、taintは、アプリケーションを整理するためのデフォルトの手段としてではなく、ワークロードが本当に特定の種類のノードを必要とする場合に使用してください。スケジューリング制約が増えるごとにPodを実行できるノードの数が減り、Cluster Autoscalerが追加のノードグループを維持せざるを得なくなる可能性があります。
AWSは、通常のワークロード分離にはKubernetesの名前空間などの仕組みを使用し、ノードセレクターやtaintは例外として扱うことを推奨しています。GPUやSpotインスタンスなど、実際のインフラ要件を持つワークロードには、専用のノードグループが引き続き有用です。
6. Pod Disruption Budgetを慎重に設定する
Pod Disruption Budget(PDB)は自発的な中断時のアプリケーション可用性を保護できますが、制限が厳しすぎるPDBは、本来不要なノードをCluster Autoscalerが削除するのを妨げる可能性があります。スケールダウンの前に、オートスケーラーはワークロードを安全に退避させて他の場所にスケジュールできるかを判断する必要があります。
自発的な退避が事実上不可能にならない範囲で、必要な可用性レベルを確保できるようPDBを設定してください。また、EKS特有のノードライフサイクルの挙動も考慮しましょう。マネージドノードグループの終了操作の中には、PDBによってすべてのPodをドレインできない場合でも、最終的には処理が進行するものがあります。
7. 適切な場合はマルチAZのAuto Scalingグループを使用する
アベイラビリティゾーン固有のスケジューリング要件を持たないワークロードについては、AWSは複数のアベイラビリティゾーンにまたがる単一のEC2 Auto Scalingグループとしてリージョン単位の容量を定義することを推奨しています。これにより、Cluster Autoscalerが評価すべきノードグループの数が減り、スケーラビリティが向上します。
ただし、ゾーン単位のリソースに紐づくワークロードには追加の考慮が必要です。たとえば、ゾーン固有のEBSボリューム、必須のゾーンベースのノードアフィニティ、ゾーン固有のPodアフィニティを使用するアプリケーションでは、アベイラビリティゾーンごとに個別のノードグループが必要になる場合があります。EBSを使用するステートフルなマルチAZアプリケーションには、AWSは単一AZのノードグループと--balance-similar-node-groupsの併用を推奨しています。
FAQ
EKS Cluster Autoscalerとは何ですか? Amazon EKS Cluster Autoscalerは、クラスター内のワーカーノード数を調整するKubernetesコントローラーです。リソース不足でPodをスケジュールできない場合にノードを追加し、不要になったノードを削除します。
Cluster Autoscalerはどのようにノードの追加を判断しますか? 約10秒ごとにKubernetes APIをチェックし、スケジューラーが配置できないPodを探します。該当するPodごとに、利用可能なノードグループから作成される仮想的な新規ノードへのスケジューリングをシミュレートし、expander戦略を使ってグループを選択し、Podが収まるか最大サイズに達するまでそのグループの希望容量を引き上げます。
Cluster Autoscalerがノードをスケールダウンしないのはなぜですか?
ノードは削除前に一定時間、不要な状態を維持する必要があり、デフォルトの--scale-down-unneeded-timeは10分です。また、制限の厳しいPodDisruptionBudgetや、他のノードへ安全に移動できないPodによってスケールダウンがブロックされることもあります。
Cluster AutoscalerとHorizontal Pod Autoscalerの違いは何ですか? Cluster Autoscalerはワーカーノードをスケールし、Horizontal Pod AutoscalerはアプリケーションのPodをスケールします。両者は連携して動作します。HPAが追加したレプリカが既存ノードに収まらない場合、保留中のPodがCluster Autoscalerによるノード追加をトリガーすることがあります。
Cluster AutoscalerとEKS Auto Modeの違いは何ですか? Cluster Autoscalerは、事前定義されたEC2 Auto Scalingグループをスケールするユーザー管理のコンポーネントです。EKS Auto ModeはAWSが管理し、Karpenterベースのシステムで個々のワークロードのニーズに応じてノードをプロビジョニングします。さらに、ネットワーキング、ロードバランシング、ブロックストレージなど、他のインフラも管理します。
EKSではどのバージョンのCluster Autoscalerを実行すべきですか? クラスターのKubernetesメジャー・マイナーバージョンに一致するリリースを使用してください。たとえば、Kubernetes 1.32のクラスターでは、原則としてCluster Autoscaler 1.32.x系のリリースを実行すべきです。クラスターをアップグレードするたびに、オートスケーラーのバージョンも確認してください。
PerfectScaleでEKS Cluster Autoscalerの効率を最大化
Cluster Autoscalerのようなノードオートスケーラーは、需要に応じてノードを増減させることで、クラスターの可用性を高め、アイドルコストを削減します。しかし、適切に設定されたオートスケーラーであっても、与えられたリソースリクエストに基づいてしか動作できません。過剰にプロビジョニングされたコンテナは容量を浪費し、オートスケーラーに必要以上のノード追加を強います。プロビジョニング不足のコンテナはPodの退避、ノードへの負荷、ワークロードの不安定化を招きます。さらに、非効率なビンパッキングはリソースを十分に活用できないまま、不要なスケーリングイベントを引き起こします。PerfectScaleは、自律的なワークロードのライトサイジングと、オートスケーリンググループおよびノードプールの詳細な可視化を組み合わせることでこれらの課題を解決し、Cluster Autoscalerがより適切なスケーリング判断を下せるようにします。
PerfectScaleの主な機能:
- プロアクティブな設定エラー検出: ワークロードを継続的に分析し、CPU Request未設定、Memory Request未設定、Memory Limit未設定といった設定エラーを特定・解消することで、予測不能な退避、ノードのオーバーコミット、非効率なオートスケーリングを防ぎます。
- 自律的なワークロードのライトサイジング: 実際の使用率に基づいてワークロードのリソースを即座に調整し、Podのビンパッキングを改善してオートスケーリングの効率を高めます。手動の介入は一切不要です。
- オートスケーリンググループとノードプールの可視化: オートスケーリンググループとノードプールのコストと使用率を詳細に把握でき、非効率の特定と正確なリソース配分を支援します。
- 最適なノードタイプの選定: ワークロードのCPU・メモリ・GPU要件に合ったノードタイプの選択を支援し、使用率、ビンパッキング、クラスター全体の効率を向上させます。
- ノードレベルとPodレベルの最適化の組み合わせ: ノードレベルの最適化とPodレベルのライトサイジングを組み合わせることで、より迅速なスケーリング判断、パフォーマンスの向上、クラウド支出の削減を実現します。
PerfectScaleが推測に頼らないKubernetesノードのオートスケーリングをどのように支援するか、詳しくはこちら