


Was ist der EKS Cluster Autoscaler?
Der Amazon EKS Cluster Autoscaler ist ein Kubernetes-Controller, der die Anzahl der Worker Nodes in Ihrem Cluster automatisch anpasst: Er überwacht ausstehende Pods, die aufgrund unzureichender Ressourcen nicht eingeplant werden können, und beendet wenig ausgelastete Nodes. Die meisten Nutzer auf Reddit r/aws sind sich einig, dass Auto Scaling Groups (ASGs) mit Standardeinstellungen allein für dynamische Kubernetes-Workloads nicht ausreichen – der Cluster Autoscaler ist daher unverzichtbar, um Ressourcenanforderungen in Echtzeit zu bedienen.
So funktioniert er:
- Nicht einplanbare Pods erkennen: Überwacht Pods, die aufgrund unzureichender Ressourcen oder Scheduling-Einschränkungen nicht platziert werden können.
- Eine EKS Node Group zum Skalieren auswählen: Simuliert die Pod-Platzierung anhand der verfügbaren Node Groups und wählt eine geeignete Gruppe für zusätzliche Kapazität aus.
- Kapazität der EC2 Auto Scaling Group erhöhen: Erhöht die gewünschte Kapazität der ausgewählten Auto Scaling Group, damit neue EC2 Worker Nodes dem Cluster beitreten können.
- Wenig ausgelastete Nodes identifizieren: Ermittelt anhand von Ressourcenanforderungen und Scheduling-Vorgaben, ob Workloads auf überflüssigen Nodes verlagert werden können.
- Nodes sicher herunterskalieren: Prüft, ob verschiebbare Pods neu eingeplant werden können, bevor die Node-Group-Kapazität reduziert und überflüssige Nodes beendet werden.
Die zentralen Setup-Schritte:
- Skalierungsgrenzen der EKS Node Groups konfigurieren: Legen Sie Minimum, Maximum und gewünschte Kapazität für jede Node Group fest, die der Autoscaler verwalten darf.
- IAM-Berechtigungen für den Cluster Autoscaler konfigurieren: Erteilen Sie dem Autoscaler die Berechtigung, die entsprechenden EC2 Auto Scaling Groups einzusehen und anzupassen.
- Auto-Discovery für Node Groups aktivieren: Setzen Sie die erforderlichen Auto-Scaling-Group-Tags, damit der Autoscaler geeignete EKS Node Groups erkennen kann.
- Cluster Autoscaler bereitstellen: Installieren Sie ihn im Cluster und konfigurieren Sie AWS als Cloud-Provider mit den passenden Auto-Discovery-Einstellungen.
- Autoscaler-Version auf die EKS-Kubernetes-Version abstimmen: Verwenden Sie ein Cluster-Autoscaler-Release, das zur Major- und Minor-Version von Kubernetes im Cluster passt.
- Betrieb des Cluster Autoscalers prüfen: Kontrollieren Sie Pod und Logs des Autoscalers und testen Sie, ob nicht einplanbare Pods wie erwartet eine Node-Erweiterung auslösen.
Dieser Artikel ist Teil einer Serie über Kubernetes-Scheduling
In diesem Artikel:
- Wie funktioniert der EKS Cluster Autoscaler?
- Cluster Autoscaler auf EKS einrichten
- EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
- EKS Cluster Autoscaler vs. EKS Auto Mode
- Best Practices für den EKS Cluster Autoscaler
Wie funktioniert der EKS Cluster Autoscaler?
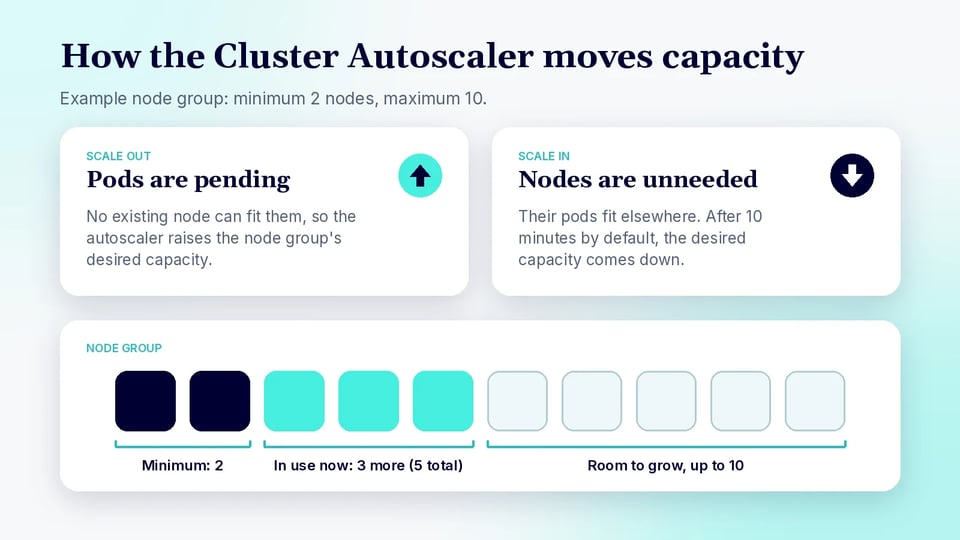
Nicht einplanbare Pods erkennen
Der Cluster Autoscaler prüft regelmäßig über die Kubernetes-API, ob es Pods gibt, die der Scheduler auf keinem vorhandenen Node platzieren kann. Ein Pod kann nicht einplanbar werden, wenn seine Anforderungen an CPU, Arbeitsspeicher, GPU oder andere Ressourcen nicht erfüllt werden können oder wenn Scheduling-Einschränkungen wie Node Selectors, Affinity-Regeln und Taints begrenzen, wo er laufen darf.
Standardmäßig scannt der Cluster Autoscaler den Cluster etwa alle 10 Sekunden. Findet er nicht einplanbare Pods, prüft er, ob zusätzliche Kapazität in einer der konfigurierten Node Groups diesen Pods die Ausführung ermöglichen würde.
Eine EKS Node Group zum Skalieren auswählen
Für jeden nicht einplanbaren Pod simuliert der Cluster Autoscaler das Scheduling auf hypothetischen neuen Nodes aus den verfügbaren EKS Node Groups. Dabei berücksichtigt er Faktoren wie CPU- und Arbeitsspeicherkapazität der Node Group, Labels, Taints und weitere Scheduling-Eigenschaften.
AWS empfiehlt, dass Nodes innerhalb einer Node Group identische Scheduling-Eigenschaften haben. Instance-Typen in einer EC2 Mixed Instances Policy sollten beispielsweise ähnliche CPU-, Arbeitsspeicher- und GPU-Kapazität bieten, weil der Cluster Autoscaler bei der Scheduling-Simulation den ersten Instance-Typ der Policy verwendet. Sobald geeignete Gruppen identifiziert sind, entscheidet die konfigurierte Expander-Strategie, welche Gruppe vergrößert wird.
Kapazität der EC2 Auto Scaling Group erhöhen
Nach der Auswahl einer geeigneten Node Group erhöht der Cluster Autoscaler deren gewünschte Kapazität. EKS Node Groups basieren auf EC2 Auto Scaling Groups; durch das Vergrößern der Node Group werden EC2-Instances gestartet und anschließend als Kubernetes-Nodes registriert.
Dieser Prozess läuft so lange, bis ausreichend Kapazität verfügbar ist oder die Node Group ihre konfigurierte Maximalgröße erreicht. Bei EKS Managed Node Groups gehört jeder verwaltete Node zu einer EC2 Auto Scaling Group, und EKS synchronisiert die Skalierungsinformationen der Node Group mit Änderungen durch externe Komponenten wie den Cluster Autoscaler.
Wenig ausgelastete Nodes identifizieren
Der Cluster Autoscaler sucht außerdem nach Nodes, die nicht mehr benötigt werden. Statt lediglich die tatsächliche CPU-Auslastung zu überwachen, bewertet er die Kubernetes-Ressourcenanforderungen und prüft, ob die Workloads eines Nodes an anderer Stelle im Cluster eingeplant werden könnten.
Ein Node muss über einen konfigurierten Zeitraum hinweg überflüssig bleiben, bevor er für die Entfernung infrage kommt. Der Standardwert für --scale-down-unneeded-time liegt bei 10 Minuten, wobei dieser und andere Scale-Down-Schwellenwerte angepasst werden können. Diese Verzögerung verhindert, dass Nodes bei kurzfristigen Workload-Schwankungen wiederholt hinzugefügt und entfernt werden.
Nodes sicher herunterskalieren
Bevor ein Node entfernt wird, führt der Cluster Autoscaler eine Scheduling-Simulation durch, um sicherzustellen, dass die verschiebbaren Pods auf anderen verfügbaren Nodes laufen können. Bestimmte Workloads können das Herunterskalieren verhindern, etwa Pods, die durch restriktive PodDisruptionBudgets geschützt sind, oder Pods, die sich nicht sicher verschieben lassen.
Kann ein Node entfernt werden, koordiniert der Cluster Autoscaler die Entfernung und reduziert die gewünschte Kapazität der entsprechenden Node Group. Bei EKS Managed Node Groups umfasst die Beendigung von Nodes ein automatisches Draining, das Workloads geordnet verdrängt, bevor die zugrunde liegende EC2-Instance beendet wird. So kann der Cluster ungenutzte Kapazität abbauen und gleichzeitig Störungen für laufende Anwendungen minimieren.
Cluster Autoscaler auf EKS einrichten
Für die Einrichtung des Cluster Autoscalers auf Amazon EKS müssen Sie die Node Groups für das Autoscaling konfigurieren, dem Autoscaler die Berechtigung zum Anpassen der EC2 Auto Scaling Groups erteilen und eine Cluster-Autoscaler-Version bereitstellen, die mit der Kubernetes-Version des Clusters kompatibel ist.
Schritt 1: Skalierungsgrenzen der EKS Node Groups konfigurieren
Konfigurieren Sie zunächst Minimum, Maximum und gewünschte Kapazität für jede EKS Managed Node Group oder selbstverwaltete EC2 Auto Scaling Group, die der Cluster Autoscaler steuern soll. Der Autoscaler kann die Kapazität nur innerhalb dieser konfigurierten Grenzen anpassen.
Beispiel: Eine Node Group könnte eine Mindestgröße von 2 und eine Maximalgröße von 10 Nodes haben. Der Cluster Autoscaler kann die gewünschte Kapazität dann je nach Workload-Bedarf zwischen diesen Werten erhöhen oder verringern. AWS empfiehlt, Node Groups so zu konfigurieren, dass Instances innerhalb derselben Gruppe gleichwertige Scheduling-Eigenschaften und eine ähnliche Ressourcenkapazität haben.
Schritt 2: IAM-Berechtigungen für den Cluster Autoscaler konfigurieren
Der Cluster Autoscaler benötigt AWS-IAM-Berechtigungen, um Auto Scaling Groups einzusehen und deren gewünschte Kapazität zu ändern. AWS empfiehlt, diese Berechtigungen dem vom Autoscaler verwendeten Kubernetes Service Account zu erteilen, statt jedem Worker Node weitreichende Berechtigungen zuzuweisen.
Auf EKS lässt sich das über eine IAM-Rolle konfigurieren, die mit dem cluster-autoscaler Service Account im Namespace kube-system verknüpft ist. Die Policy sollte dem Autoscaler die erforderlichen Auto-Scaling-Aktionen erlauben und Skalierungsoperationen gleichzeitig auf die Auto Scaling Groups des jeweiligen EKS-Clusters beschränken.
Schritt 3: Auto-Discovery für Node Groups aktivieren
AWS empfiehlt, die Auto-Discovery des Cluster Autoscalers zu nutzen, statt einzelne Auto Scaling Groups manuell aufzulisten. Über Auto-Discovery erkennt der Autoscaler anhand der Auto-Scaling-Group-Tags, welche Node Groups zum EKS-Cluster gehören.
Die üblicherweise verwendeten Discovery-Tags sind:
k8s.io/cluster-autoscaler/enabled = truek8s.io/cluster-autoscaler/<cluster-name> = ownedTools wie eksctl können diese Tags automatisch setzen. Beispiel: Beim Erstellen eines Clusters mit eksctl create cluster --asg-access werden die erforderlichen Autoscaling-Berechtigungen und Discovery-Tags hinzugefügt.
Schritt 4: Cluster Autoscaler bereitstellen
Stellen Sie den Cluster Autoscaler im EKS-Cluster bereit, typischerweise im Namespace kube-system. Die Installation erfolgt über das offizielle Kubernetes-Cluster-Autoscaler-Manifest oder das zugehörige Helm-Chart.
Das Deployment muss AWS als Cloud-Provider angeben und Auto-Discovery für den Cluster konfigurieren. Beispiel:
--cloud-provider=aws--node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name>Das offizielle Deployment verwendet zudem die Priority Class system-cluster-critical, damit der Autoscaler selbst bei knappen Cluster-Ressourcen seltener verdrängt wird.
Schritt 5: Autoscaler-Version auf die EKS-Kubernetes-Version abstimmen
Verwenden Sie ein Cluster-Autoscaler-Release, das zur Major- und Minor-Version von Kubernetes auf EKS passt. Beispiel: Ein Kubernetes-1.32-Cluster sollte in der Regel ein Cluster-Autoscaler-Release der Version 1.32.x ausführen und kein Release für eine andere Kubernetes-Minor-Version.
Die Versionsabstimmung ist wichtig, weil der Cluster Autoscaler von Kubernetes-APIs und vom Scheduler-Verhalten abhängt, die sich zwischen Releases ändern können. Beim Upgrade eines EKS-Clusters sollte die Autoscaler-Version daher geprüft und bei Bedarf aktualisiert werden.
Schritt 6: Betrieb des Cluster Autoscalers prüfen
Prüfen Sie nach dem Deployment, ob der Cluster-Autoscaler-Pod läuft:
kubectl get pods -n kube-systemAnschließend können Sie die Logs einsehen:
kubectl logs -n kube-system deployment/cluster-autoscalerEin praktischer Test: Stellen Sie Workloads mit so hohen Ressourcenanforderungen bereit, dass Pods ausstehend bleiben. Hat kein vorhandener Node ausreichend Kapazität, sollte der Cluster Autoscaler die nicht einplanbaren Pods erkennen und die gewünschte Kapazität einer geeigneten Auto Scaling Group erhöhen. Sinkt der Bedarf später und bleiben Nodes überflüssig, kann er die Node Group innerhalb der konfigurierten Grenzen wieder herunterskalieren.
EKS Cluster Autoscaler vs. Horizontal Pod Autoscaler
Der EKS Cluster Autoscaler und der Horizontal Pod Autoscaler (HPA) arbeiten auf unterschiedlichen Ebenen einer EKS-Umgebung. Der Cluster Autoscaler skaliert Worker Nodes, der HPA skaliert Anwendungs-Pods. AWS empfiehlt, Workload-Autoscaling wie den HPA mit einem Node-Autoscaler zu kombinieren, wenn sowohl Anwendungen als auch Cluster-Kapazität dynamisch auf die Nachfrage reagieren müssen.
Der Horizontal Pod Autoscaler überwacht Metriken wie CPU, Arbeitsspeicher oder benutzerdefinierte Metriken und ändert die Replica-Anzahl eines Workloads, etwa eines Deployments. Können zusätzliche Replicas nicht eingeplant werden, weil den vorhandenen Nodes Kapazität fehlt, kann der Cluster Autoscaler Nodes hinzufügen, um die ausstehenden Pods unterzubringen.
| EKS Cluster Autoscaler | Horizontal Pod Autoscaler | |
|---|---|---|
| Was skaliert wird | Worker Nodes | Pods |
| Primärer Auslöser | Nicht einplanbare Pods und überflüssige Nodes | CPU-, Arbeitsspeicher-, benutzerdefinierte oder externe Metriken |
| Hauptzweck | Compute-Kapazität des Clusters anpassen | Anwendungskapazität anpassen |
| Interaktion mit der AWS-Infrastruktur | Ändert die Kapazität der EC2 Auto Scaling Group | Ändert die Replica-Anzahl von Kubernetes-Workloads |
Ein Beispiel: Ein HPA könnte eine Anwendung bei steigender CPU-Auslastung von fünf auf zehn Pods erweitern. Reichen die Cluster-Ressourcen für die zusätzlichen Pods nicht aus, bleiben einige ausstehend – was den Cluster Autoscaler veranlassen kann, die Node-Kapazität zu erhöhen.
Verwandte Inhalte: Lesen Sie unseren Leitfaden zum Kubernetes Vertical Pod Autoscaler (VPA).
EKS Cluster Autoscaler vs. EKS Auto Mode
Der EKS Cluster Autoscaler ist eine kundenverwaltete Kubernetes-Autoscaling-Komponente, während EKS Auto Mode eine von AWS verwaltete Infrastrukturautomatisierung inklusive Compute-Autoscaling bietet. Der Cluster Autoscaler arbeitet primär, indem er die gewünschte Kapazität vordefinierter EC2 Auto Scaling Groups erhöht oder verringert. EKS Auto Mode nutzt stattdessen ein Karpenter-basiertes System, das Nodes passend zu den Anforderungen einzelner Workloads bereitstellen kann.
Beim Cluster Autoscaler bleiben Unternehmen selbst dafür verantwortlich, den Autoscaler zu installieren und zu warten sowie geeignete Node Groups, Auto Scaling Groups, IAM-Berechtigungen und Skalierungsgrenzen zu konfigurieren. EKS Auto Mode nimmt Ihnen einen Großteil dieser operativen Arbeit ab: AWS übernimmt Node-Bereitstellung, Node-Software, Patching, Compute-Autoscaling und mehrere verwandte Infrastrukturfunktionen.
| EKS Cluster Autoscaler | EKS Auto Mode | |
|---|---|---|
| Skalierungsmodell | Skaliert vordefinierte Auto Scaling Groups | Karpenter-basierte dynamische Node-Bereitstellung |
| Node Groups | Erfordert in der Regel verwaltete oder selbstverwaltete Node Groups | Nutzt verwaltete NodePools und NodeClasses |
| Verwaltung | Kunde installiert und betreibt den Autoscaler | AWS verwaltet das Compute-Autoscaling |
| Instance-Auswahl | Begrenzt durch konfigurierte Node-Group-Kapazität und Instance-Typen | Kann passende Kapazität anhand der Workload-Anforderungen auswählen |
| Node-Lebenszyklus | Primär über ASGs und Cluster Autoscaler gesteuert | AWS verwaltet Bereitstellung, Konsolidierung, Updates und Austausch |
| Weitere Infrastrukturautomatisierung | Fokus auf Node-Skalierung | Verwaltet zusätzlich Networking, Load Balancing, Block Storage und weitere Komponenten |
EKS Auto Mode ist damit eine umfassendere verwaltete Infrastrukturoption und nicht einfach eine weitere Variante des Cluster Autoscalers. Laut AWS kann Auto Mode automatisch Nodes erstellen, wenn Pods nicht auf vorhandene Kapazität passen, Workloads konsolidieren und nicht mehr benötigte Nodes entfernen.
Best Practices für den EKS Cluster Autoscaler
Hier sind einige bewährte Maßnahmen für die Arbeit mit dem Cluster Autoscaler in EKS.
1. EKS Managed Node Groups verwenden, wo immer möglich
AWS empfiehlt, den Cluster Autoscaler mit EKS Managed Node Groups zu betreiben. Managed Node Groups übernehmen einen Großteil des EC2-Node-Lebenszyklus für Sie, einschließlich Bereitstellung, Upgrades, Registrierung und geordneter Node-Beendigung.
Sie sind außerdem direkt in EC2 Auto Scaling Groups integriert und bieten Funktionen, die den Betrieb des Cluster Autoscalers vereinfachen, etwa die automatische Erkennung der Auto Scaling Groups und verwaltetes Draining bei vielen Node-Lebenszyklus-Operationen.
2. Node Groups so homogen wie möglich halten
Nodes innerhalb derselben Node Group sollten identische Scheduling-Eigenschaften haben, einschließlich Labels, Taints und verfügbarer Ressourcen. Der Cluster Autoscaler behandelt eine Node Group so, als wären ihre Nodes austauschbar – große Unterschiede zwischen Instances können daher zu ungenauen Skalierungsentscheidungen führen.
Bei einer Mixed Instances Policy empfiehlt AWS, Instance-Typen mit ähnlicher CPU-, Arbeitsspeicher- und GPU-Kapazität zu wählen. Der Cluster Autoscaler verwendet bei der Scheduling-Simulation den ersten Instance-Typ der Policy; kleinere Instances können dazu führen, dass Pods nicht einplanbar bleiben, während größere Instances Ressourcen verschwenden können.
3. Die Anzahl der Node Groups minimieren
Setzen Sie lieber auf wenige große Node Groups, statt viele kleine Gruppen für einzelne Anwendungen oder Teams anzulegen. In jedem Autoscaling-Zyklus gleicht der Cluster Autoscaler nicht einplanbare Pods mit den verfügbaren Node Groups ab – mehr Gruppen bedeuten also mehr Verarbeitungs- und API-Overhead.
AWS nennt eine übermäßige Anzahl von Node Groups explizit als Anti-Pattern für die Skalierbarkeit des Autoscalings. Separate Gruppen sind weiterhin sinnvoll, wenn Workloads tatsächlich unterschiedliche Scheduling-Eigenschaften benötigen, etwa GPUs, Spot-Kapazität oder zonenspezifische Ressourcen.
4. Präzise Pod-Ressourcenanforderungen setzen
Definieren Sie realistische CPU- und Arbeitsspeicheranforderungen für Workloads, damit der Kubernetes-Scheduler und der Cluster Autoscaler ein genaues Bild der Ressourcen haben, die jeder Pod benötigt. Der Autoscaler stützt seine Skalierungsentscheidungen primär auf die Ressourcenanforderungen der Pods, nicht auf die tatsächliche momentane Ressourcennutzung.
Zu hohe Requests können unnötige Node-Erweiterungen und schlechtes Bin Packing verursachen, während zu niedrige Requests zu Ressourcenkonflikten führen können, selbst wenn Kubernetes scheinbar ausreichend Kapazität hat. Wo sinnvoll, lassen sich zusätzlich Ressourcenlimits konfigurieren, um zu steuern, wie viel zusätzliche Kapazität ein Container verbrauchen darf.
5. Node Selectors und Taints nur bei Bedarf einsetzen
Nutzen Sie Node Selectors, Node Affinity und Taints nur dann, wenn Workloads tatsächlich bestimmte Node-Typen benötigen – nicht als Standardweg, um Anwendungen zu organisieren. Jede zusätzliche Scheduling-Einschränkung reduziert die Anzahl der Nodes, auf denen ein Pod laufen kann, und kann den Cluster Autoscaler zwingen, zusätzliche Node Groups vorzuhalten.
AWS empfiehlt, für die gewöhnliche Workload-Isolation Mechanismen wie Kubernetes-Namespaces zu verwenden und Node Selectors sowie Taints als Ausnahme zu behandeln. Dedizierte Node Groups bleiben sinnvoll für Workloads mit echten Infrastrukturanforderungen, etwa GPUs oder Spot-Instances.
6. Pod Disruption Budgets sorgfältig konfigurieren
Pod Disruption Budgets (PDBs) können die Verfügbarkeit von Anwendungen bei freiwilligen Unterbrechungen schützen, doch zu restriktive PDBs können den Cluster Autoscaler daran hindern, eigentlich überflüssige Nodes zu entfernen. Vor dem Herunterskalieren muss der Autoscaler feststellen, ob sich Workloads sicher verdrängen und anderswo einplanen lassen.
Konfigurieren Sie PDBs so, dass sie die erforderliche Verfügbarkeit gewährleisten, ohne freiwillige Evictions praktisch unmöglich zu machen. Berücksichtigen Sie außerdem das EKS-spezifische Node-Lebenszyklusverhalten: Einige Beendigungsoperationen von Managed Node Groups können letztlich auch dann fortgesetzt werden, wenn ein PDB das Draining aller Pods verhindert.
7. Multi-AZ Auto Scaling Groups nutzen, wo es passt
Für Workloads ohne zonenspezifische Scheduling-Anforderungen empfiehlt AWS, regionale Kapazität als eine einzige EC2 Auto Scaling Group über mehrere Availability Zones hinweg zu definieren. Das kann die Anzahl der Node Groups reduzieren, die der Cluster Autoscaler bewerten muss, und die Skalierbarkeit verbessern.
Workloads mit Bindung an zonale Ressourcen erfordern jedoch zusätzliche Überlegungen. Anwendungen mit zonenspezifischen EBS-Volumes, verpflichtender zonenbasierter Node Affinity oder zonenspezifischer Pod Affinity benötigen unter Umständen separate Node Groups pro Availability Zone. Für zustandsbehaftete Multi-AZ-Anwendungen mit EBS empfiehlt AWS Single-AZ Node Groups in Kombination mit --balance-similar-node-groups.
FAQ
Was ist der EKS Cluster Autoscaler? Der Amazon EKS Cluster Autoscaler ist ein Kubernetes-Controller, der die Anzahl der Worker Nodes in einem Cluster anpasst. Er fügt Nodes hinzu, wenn Pods aufgrund unzureichender Ressourcen nicht eingeplant werden können, und entfernt Nodes, die nicht mehr benötigt werden.
Wie entscheidet der Cluster Autoscaler, ob Nodes hinzugefügt werden? Er prüft etwa alle 10 Sekunden über die Kubernetes-API, ob es Pods gibt, die der Scheduler nicht platzieren kann. Für jeden dieser Pods simuliert er das Scheduling auf hypothetischen neuen Nodes aus den verfügbaren Node Groups, wählt über seine Expander-Strategie eine Gruppe aus und erhöht deren gewünschte Kapazität, bis die Pods passen oder die Maximalgröße erreicht ist.
Warum skaliert der Cluster Autoscaler einen Node nicht herunter?
Ein Node muss vor der Entfernung für eine festgelegte Zeit überflüssig bleiben; der Standardwert für --scale-down-unneeded-time liegt bei 10 Minuten. Das Herunterskalieren kann außerdem durch restriktive PodDisruptionBudgets oder durch Pods blockiert werden, die sich nicht sicher auf andere Nodes verschieben lassen.
Worin unterscheiden sich Cluster Autoscaler und Horizontal Pod Autoscaler? Der Cluster Autoscaler skaliert Worker Nodes, während der Horizontal Pod Autoscaler Anwendungs-Pods skaliert. Beide arbeiten zusammen. Fügt der HPA Replicas hinzu, die nicht auf die vorhandenen Nodes passen, können die ausstehenden Pods den Cluster Autoscaler veranlassen, Nodes hinzuzufügen.
Worin unterscheiden sich Cluster Autoscaler und EKS Auto Mode? Der Cluster Autoscaler ist eine kundenverwaltete Komponente, die vordefinierte EC2 Auto Scaling Groups skaliert. EKS Auto Mode wird von AWS verwaltet und nutzt ein Karpenter-basiertes System, das Nodes für individuelle Workload-Anforderungen bereitstellt. Außerdem verwaltet es weitere Infrastruktur wie Networking, Load Balancing und Block Storage.
Welche Cluster-Autoscaler-Version sollte ich auf EKS verwenden? Verwenden Sie ein Release, das zur Major- und Minor-Version von Kubernetes in Ihrem Cluster passt. Ein Kubernetes-1.32-Cluster sollte beispielsweise in der Regel ein Cluster-Autoscaler-Release der Version 1.32.x ausführen. Prüfen Sie die Autoscaler-Version bei jedem Cluster-Upgrade.
Mehr Effizienz für den EKS Cluster Autoscaler mit PerfectScale
Node-Autoscaler wie der Cluster Autoscaler skalieren Nodes bedarfsgerecht hoch und herunter, verbessern die Cluster-Verfügbarkeit und senken Leerlaufkosten. Doch selbst ein gut konfigurierter Autoscaler kann nur mit den Ressourcenanforderungen arbeiten, die er erhält. Überdimensionierte Container verschwenden Kapazität und zwingen den Autoscaler, mehr Nodes als nötig hinzuzufügen; unterdimensionierte Container führen zu Pod-Evictions, Druck auf die Nodes und instabilen Workloads; ineffizientes Bin Packing lässt Ressourcen ungenutzt und löst zugleich unnötige Skalierungsereignisse aus. PerfectScale löst diese Herausforderungen, indem es autonomes Workload-Right-Sizing mit tiefem Einblick in Ihre Autoscaling Groups und Node Pools kombiniert – damit Ihr Cluster Autoscaler bessere Skalierungsentscheidungen trifft.
Zentrale Funktionen von PerfectScale:
- Proaktive Erkennung von Konfigurationsfehlern: Analysiert Workloads kontinuierlich, um Konfigurationsfehler wie CPU Request Not Set, Memory Request Not Set und Memory Limit Not Set zu identifizieren und zu beheben – und verhindert so unvorhersehbare Evictions, Node-Overcommitment und ineffizientes Autoscaling.
- Autonomes Workload-Right-Sizing: Passt Workload-Ressourcen sofort an die tatsächliche Auslastung an und verbessert das Pod-Bin-Packing für effizienteres Autoscaling – ganz ohne manuelle Eingriffe.
- Transparenz über Autoscaling Groups und Node Pools: Liefert detaillierte Einblicke in Kosten und Auslastung Ihrer Autoscaling Groups und Node Pools und hilft Ihnen, Ineffizienzen aufzudecken und Ressourcen präzise zu verteilen.
- Optimale Auswahl von Node-Typen: Unterstützt Sie dabei, Node-Typen auf die CPU-, Arbeitsspeicher- und GPU-Anforderungen Ihrer Workloads abzustimmen, um Auslastung, Bin Packing und die gesamte Cluster-Effizienz zu verbessern.
- Kombinierte Optimierung auf Node- und Pod-Ebene: Verbindet Optimierung auf Node-Ebene mit Right-Sizing auf Pod-Ebene für schnellere Skalierungsentscheidungen, bessere Performance und geringere Cloud-Ausgaben.
Erfahren Sie, wie PerfectScale Kubernetes-Nodes ohne Rätselraten skaliert