

En un clúster multitenant de Kubernetes, la observabilidad te dice que un nodo está saturado o que el clúster está sobredimensionado. No te dice qué tenant lo causó ni qué hay que cambiar. En esa brecha, entre el síntoma que puedes ver y el tenant responsable, es donde tanto el costo como la responsabilidad se pierden con facilidad.
Esto importa porque hoy casi nadie opera un clúster por equipo. Cuando varios equipos comparten un nodepool, lo que cada workload reserva y lo que realmente usa empiezan a distanciarse. Tus dashboards muestran el resultado, pero no muestran de quién es. En este artículo repasamos por qué esa brecha empeora en clústeres compartidos, por qué la observabilidad estándar no puede cerrarla y cómo se ve una solución real tanto para los equipos de plataforma como de FinOps.
Las dos preguntas que la observabilidad no puede responder en un clúster compartido
Abre cualquier dashboard de monitoreo de Kubernetes y verás de todo: uso de CPU y memoria por nodo, saturación, throttling, presión. Lo que normalmente no puedes ver, y rápido, son las dos preguntas que realmente importan cuando algo falla:
- ¿Qué tenant lo causó?
- ¿Qué hay que cambiar?
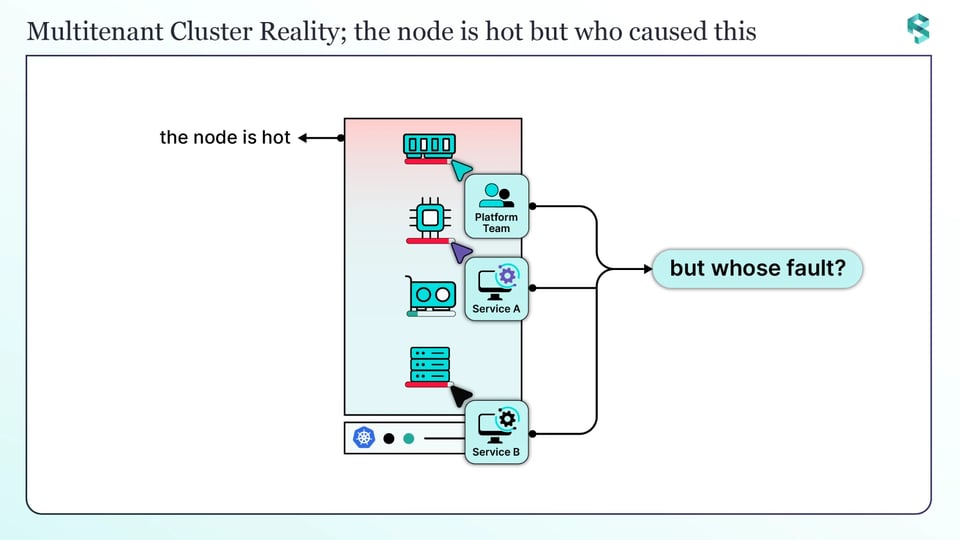
Y hay mucho que explicar. La investigación de Datadog sobre contenedores encontró que la mayoría de los workloads usan menos del 25% de la CPU que solicitan y menos de la mitad de la memoria que solicitan. La mayor parte de lo que un clúster reserva —y paga— permanece ociosa en lugar de ejecutar trabajo. En un clúster de un solo tenant, eso es simplemente pérdida. En un clúster multitenant, además es un problema de responsabilidad: la factura llega como un único número para todo el clúster, y nada en ella indica qué equipo infló el gasto con su colchón de recursos.
VISUAL 1 - Puedes ver que el nodo está caliente, no de quién es la culpa.
Esta brecha, entre un clúster saturado y el tenant que lo causó, es exactamente lo que trabajamos en vivo en nuestro workshop, Operating Kubernetes Multitenancy, el 29 de septiembre. Reserva tu lugar
Requests vs. uso real: la brecha que oculta la causa
Para ver de dónde viene la pérdida, hay que mirar dos números por workload: lo que solicita y lo que realmente usa.
Un request es lo que un workload reserva. El scheduler ubica los pods según sus requests, las cuotas los contabilizan y la mayoría de las herramientas de costos también facturan sobre ellos. El uso real es lo que el contenedor consume de verdad en tiempo de ejecución. En un workload sano, estos dos números están cerca. En la mayoría de los clústeres reales, no.
Se distancian porque los requests se configuran una vez y luego se olvidan: se copian de otro servicio, se inflan por seguridad, se heredan del valor por defecto de un Helm chart y nunca se revisan a medida que el workload cambia. Si los configuras demasiado altos, reservas capacidad que nadie usa. Si los configuras demasiado bajos, el workload se queda sin CPU cuando el nodo está ocupado, o pasa al frente de la fila de desalojo cuando al nodo le falta memoria. En cualquier caso, el request deja de reflejar la realidad.
En un clúster compartido, esto puede ocurrir en muchos workloads al mismo tiempo. Un nodo infrautilizado no es un solo workload mal configurado: es un desajuste entre requests y uso en muchos tenants a la vez. La observabilidad te muestra el nodo infrautilizado. No te muestra qué requests de qué tenant son la razón.
Por qué la observabilidad por sí sola no basta en entornos multitenant
El monitoreo estándar te muestra lo que está pasando en tu infraestructura, pero no te dice qué tenant es dueño del costo. En un clúster compartido, esto se manifiesta de cuatro maneras:
No muestra el costo en ninguna parte. Puedes ver qué pods consumen qué; para eso están justamente las métricas de cAdvisor y kubelet. Lo que no muestran es el costo de ese uso, ni a qué tenant pertenece.
Muestra el uso, no la brecha de configuración. Ves lo que consume un workload, no que reservó cinco veces lo que necesita, que es justo lo que cambiarías.
Está centrado en el nodo, no en el tenant. Las métricas de nodo mezclan a todos los tenants de ese nodo. Separarlas por equipo implica escarbar en labels a mano, y los recursos compartidos - un nodo, una base de datos, la red - directamente no se pueden dividir de forma limpia por tenant.
Es reactivo. Te enteras después de la saturación, el throttling o el desalojo, no antes.
Debajo de todo esto se esconde un falso dilema. Los equipos asumen que deben elegir entre eficiencia y responsabilidad. Los clústeres y namespaces compartidos empaquetan los workloads de forma densa y mejoran la utilización, pero dificultan ver qué tenant es dueño de qué porción del costo. Darle a cada tenant su propio clúster, o incluso un nodepool dedicado, aclara la propiedad, pero agrega sobrecarga de gestión y aun así deja capacidad varada. No deberías tener que elegir entre la eficiencia de compartir el clúster y saber a quién pertenece el número.
Por qué los límites propios de Kubernetes no la cierran
Kubernetes sí te da herramientas para trazar líneas entre tenants: namespaces, ResourceQuotas y LimitRanges. Son buenas para controlar lo que un tenant puede usar. No fueron diseñadas para decirte quién es responsable del costo.
Un namespace puede contener workloads de más de un equipo. Los workloads se mueven. Una cuota te indica el techo permitido para un tenant, e incluso puedes revisar cuánto está usando un namespace con kubectl describe resourcequota. Pero eso es uso de recursos, no costo, y un namespace no siempre equivale a un tenant. Así que estos límites te ayudan a contener a los tenants, pero por sí solos no se corresponden de forma limpia con la propiedad del costo. Esa brecha hay que llenarla de otra manera.
Lo que realmente cierra la brecha: optimización y atribución
Cerrar la brecha requiere dos tareas distintas, y conviene mantenerlas separadas, porque funcionan de maneras diferentes.
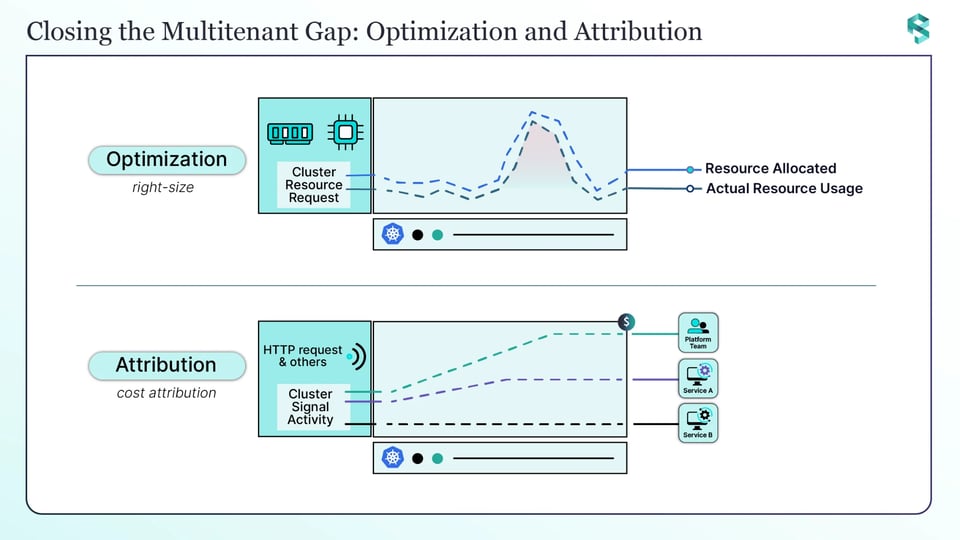
Optimización: right-sizing de cómputo y memoria según el uso real. Esto responde "qué cambiar". Se trata de comparar continuamente lo que cada workload solicita contra lo que realmente usa, y convertir la brecha en un cambio concreto: este workload puede reducir su request de CPU, aquel necesita más memoria. Aquí es donde trabaja PerfectScale. Observa los requests frente al uso real en todo el clúster y te entrega el cambio a aplicar, por workload, para que los nodos infrautilizados dejen de estarlo. Esta parte se mide en CPU y memoria.
Atribución: vincular el costo al tenant que lo generó. Esto responde "quién", y funciona distinto de la optimización. Esta es la parte que los equipos suelen hacer mal. Como los tenants comparten nodos, normalmente no puedes dividir de forma limpia la CPU y la memoria de un nodo entre clientes. No existe una línea nítida en un nodo compartido que diga que tanta memoria pertenece al cliente A y tanta al cliente B. Por eso, la atribución de costos por tenant suele basarse en una señal que representa la actividad real de cada tenant en el clúster: su porción del volumen de solicitudes HTTP, el número de mensajes que produce y consume en un clúster Kafka compartido, u otro indicador de trabajo que puedas vincular directamente a un tenant. Cuando corre un workload separado por tenant, puedes atribuir según los requests y el uso propios de ese workload. Esto es lo que hace Attribute™ by DoiT: lee esa actividad del tráfico del clúster y reparte el costo compartido entre tenants según ella, sin ningún proyecto de etiquetado que mantener.
No mezcles las dos. La optimización FinOps se mide en cómputo y memoria. La atribución por tenant se mide con lo que mejor represente la actividad de cada tenant en el clúster. Al combinarlas, el costo compartido de Kubernetes se convierte en algo que puedes reducir y, a la vez, rendir cuentas: PerfectScale muestra dónde la infraestructura puede correr con más eficiencia, y Attribute reparte la factura compartida entre tenants según su actividad.
Visual 2 - Dos tareas distintas. (explicadas arriba: PS y Attribute)
¿Quieres ver la optimización y la atribución por tenant funcionando en un clúster multitenant en vivo, sin diapositivas? Eso es lo que recorremos en nuestro workshop del 29 de septiembre. Reserva tu lugar
Qué significa esto para los equipos de plataforma y FinOps
Vale la pena cerrar esta brecha porque hay dos equipos atrapados del lado equivocado.
Plataforma obtiene una respuesta rápida y confiable a "qué tenant, y qué cambiamos", en lugar de convertir cada evento de saturación en una búsqueda del workload responsable a través de los namespaces.
FinOps obtiene una vista por tenant de cuánto costó operar cada tenant y quién puede actuar al respecto, de modo que el chargeback y el showback se convierten en un hecho que ambas partes pueden ver, no en una negociación sobre de quién era el workload.
Esa es la verdadera recompensa. Conservas la eficiencia de un clúster compartido y obtienes la responsabilidad de clústeres separados, sin pagar por clústeres separados.
Operar Kubernetes multitenant con PerfectScale by DoiT
Los clústeres compartidos te dan eficiencia, pero ocultan la propiedad. Cerrar esa brecha a mano, tenant por tenant y saturación por saturación, no se sostiene.
PerfectScale by DoiT es una plataforma de optimización de Kubernetes que prioriza la resiliencia: compara continuamente lo que tus workloads solicitan contra lo que realmente usan y convierte esa brecha en right-sizing que puedes aplicar de forma manual o automática, para que los nodos compartidos dejen de cargar capacidad que nadie usa, y para que el colchón de un tenant no se convierta en el nodo lento y la factura inflada de todos. En combinación con Attribute by DoiT, que reparte la porción del costo compartido de cada tenant según su actividad, obtienes ambos lados del problema multitenant: operar el clúster con eficiencia y saber cuánto cuesta operar cada tenant. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres compartidos eficientes y confiables a la vez.
Regístrate o agenda una sesión técnica para verlo en tu propio clúster.
Antes de irte: nuestro workshop, Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches, es el 29 de septiembre a las 11 AM ET, con Vikram Seshadri y Hili Paryenti del equipo de Attribute respondiendo tus preguntas en vivo. Reserva tu lugar .