PerfectScale
**Warum Kubernetes Observability für Multitenant-Cluster nicht ausreicht**
Ihre Dashboards zeigen einen ausgelasteten Node. Sie zeigen nicht, welcher Tenant ihn verursacht hat – oder was Sie ändern müssen.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


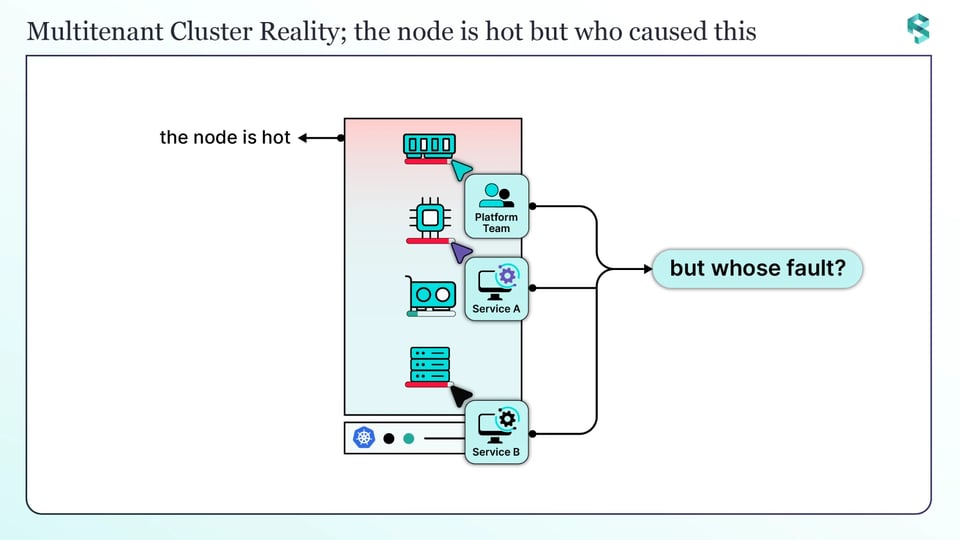
In einem Multitenant-Kubernetes-Cluster sagt Ihnen Observability, dass ein Node ausgelastet oder der Cluster überprovisioniert ist. Sie sagt Ihnen nicht, welcher Tenant das verursacht hat – oder was geändert werden muss. In dieser Lücke zwischen dem sichtbaren Symptom und dem verantwortlichen Tenant gehen Kosten und Verantwortung schnell verloren.
Das ist relevant, weil kaum noch jemand einen Cluster pro Team betreibt. Sobald sich Teams einen Nodepool teilen, driften das, was jeder Workload reserviert, und das, was er tatsächlich nutzt, auseinander. Ihre Dashboards zeigen das Ergebnis. Sie zeigen nicht, wer dafür verantwortlich ist. Dieser Artikel erklärt, warum diese Lücke in geteilten Clustern größer wird, warum Standard-Observability sie nicht schließen kann und wie eine echte Lösung für Platform- und FinOps-Teams aussieht.
Die zwei Fragen, die Observability in einem geteilten Cluster nicht beantworten kann
Öffnen Sie ein beliebiges Kubernetes-Monitoring-Dashboard, und Sie sehen jede Menge: CPU- und Speichernutzung pro Node, Auslastung, Throttling, Ressourcendruck. Was Sie in der Regel nicht schnell sehen, sind die beiden Fragen, auf die es ankommt, wenn etwas nicht stimmt:
- Welcher Tenant hat es verursacht?
- Was muss geändert werden?
Und es gibt einiges zu verantworten. Datadogs Untersuchung zu Containern hat gezeigt, dass die meisten Workloads weniger als 25 % der angeforderten CPU und weniger als die Hälfte des angeforderten Speichers nutzen. Der Großteil dessen, was ein Cluster reserviert – und bezahlt –, liegt brach, statt Arbeit zu verrichten. In einem Single-Tenant-Cluster ist das schlicht Verschwendung. In einem Multitenant-Cluster ist es zusätzlich ein Verantwortungsproblem: Die Rechnung kommt als eine einzige Zahl für den gesamten Cluster, und nichts darin verrät, welches Team mit seinen Puffern die Kosten getrieben hat.
VISUAL 1 - Sie sehen, dass der Node heißläuft – nicht, wer dafür verantwortlich ist.
Genau diese Lücke – zwischen einem ausgelasteten Cluster und dem Tenant, der ihn verursacht hat – gehen wir live in unserem Workshop Operating Kubernetes Multitenancy am 29. September durch. Jetzt Platz sichern
Requests vs. tatsächliche Nutzung: die Lücke, die die Ursache verschleiert
Um zu sehen, woher die Verschwendung kommt, müssen Sie pro Workload zwei Zahlen betrachten: was er anfordert und was er tatsächlich nutzt.
Ein Request ist das, was ein Workload reserviert. Der Scheduler platziert Pods anhand ihrer Requests, Quotas rechnen mit ihnen, und die meisten Kostentools rechnen ebenfalls danach ab. Die tatsächliche Nutzung ist das, was der Container zur Laufzeit wirklich verbraucht. Bei einem gesunden Workload liegen diese beiden Werte nah beieinander. In den meisten realen Clustern tun sie das nicht.
Sie driften auseinander, weil Requests einmal gesetzt und dann vergessen werden: von einem anderen Service kopiert, sicherheitshalber großzügig gepolstert, aus einem Helm-Chart-Default übernommen – und nie wieder angepasst, obwohl sich der Workload verändert hat. Setzt man sie zu hoch, reserviert man Kapazität, die niemand nutzt. Setzt man sie zu niedrig, bekommt der Workload zu wenig CPU, wenn der Node ausgelastet ist, oder rückt in der Eviction-Reihenfolge nach vorn, wenn dem Node der Speicher knapp wird. So oder so: Der Request bildet die Realität nicht mehr ab.
In einem geteilten Cluster kann das bei vielen Workloads gleichzeitig passieren. Ein unterausgelasteter Node ist nicht ein einzelner schlechter Workload. Es ist ein Missverhältnis zwischen Requests und Nutzung über viele Tenants hinweg – gleichzeitig. Observability zeigt Ihnen den unterausgelasteten Node. Sie zeigt Ihnen nicht, wessen Requests der Grund dafür sind.
Warum Observability allein für Multitenancy nicht ausreicht
Standard-Monitoring zeigt Ihnen, was in Ihrer Infrastruktur passiert – aber nicht, welcher Tenant die Kosten dafür trägt. In einem geteilten Cluster zeigt sich das auf vier Arten:
Es zeigt Kosten nirgendwo. Sie können sehen, welche Pods was verbrauchen; genau dafür gibt es cAdvisor- und kubelet-Metriken. Was sie nicht zeigen, sind die Kosten dieser Nutzung – oder welcher Tenant sie verantwortet.
Es zeigt Nutzung, nicht die Konfigurationslücke. Sie sehen, was ein Workload verbraucht – nicht, dass er das Fünffache dessen reserviert hat, was er braucht. Und genau das wäre der Punkt, an dem Sie ansetzen würden.
Es ist Node-zentriert, nicht Tenant-zentriert. Node-Metriken vermischen alle Tenants auf diesem Node. Sie pro Team auseinanderzuziehen bedeutet, sich von Hand durch Labels zu graben – und geteilte Ressourcen - ein Node, eine Datenbank, das Netzwerk - lassen sich überhaupt nicht sauber pro Tenant aufteilen.
Es ist reaktiv. Sie erfahren von der Auslastung, dem Throttling oder der Eviction erst hinterher, nicht vorher.
Unter all dem versteckt sich ein falscher Zielkonflikt. Teams glauben, sie müssten sich zwischen Effizienz und Verantwortlichkeit entscheiden. Geteilte Cluster und Namespaces packen Workloads dicht zusammen und verbessern die Auslastung, machen es aber schwer zu erkennen, welcher Tenant welchen Anteil der Kosten verantwortet. Gibt man jedem Tenant einen eigenen Cluster oder auch nur einen dedizierten Nodepool, wird die Zuordnung klarer – aber der Verwaltungsaufwand steigt, und Kapazität bleibt trotzdem ungenutzt liegen. Sie sollten sich nicht zwischen der Effizienz von Multitenancy und dem Wissen, wer für welche Zahl verantwortlich ist, entscheiden müssen.
Warum die Bordmittel von Kubernetes die Lücke nicht schließen
Kubernetes bietet durchaus Werkzeuge, um Grenzen zwischen Tenants zu ziehen: Namespaces, ResourceQuotas und LimitRanges. Sie sind gut darin zu kontrollieren, was ein Tenant nutzen darf. Sie sind nicht dafür gebaut, Ihnen zu sagen, wer für die Kosten verantwortlich ist.
Ein Namespace kann Workloads mehrerer Teams enthalten. Workloads wandern. Eine Quota nennt Ihnen die Obergrenze, die einem Tenant erlaubt ist, und mit kubectl describe resourcequota können Sie sogar prüfen, wie viel davon ein Namespace nutzt. Aber das ist Ressourcennutzung, nicht Kosten – und ein Namespace ist nicht immer ein Tenant. Diese Grenzen helfen Ihnen also, Tenants einzuhegen, aber für sich genommen lassen sie sich nicht sauber auf Kostenverantwortung abbilden. Diese Lücke muss anders gefüllt werden.
Was die Lücke wirklich schließt: Optimierung und Attribution
Um die Lücke zu schließen, braucht es zwei unterschiedliche Aufgaben – und es hilft, sie getrennt zu halten, denn sie funktionieren unterschiedlich.
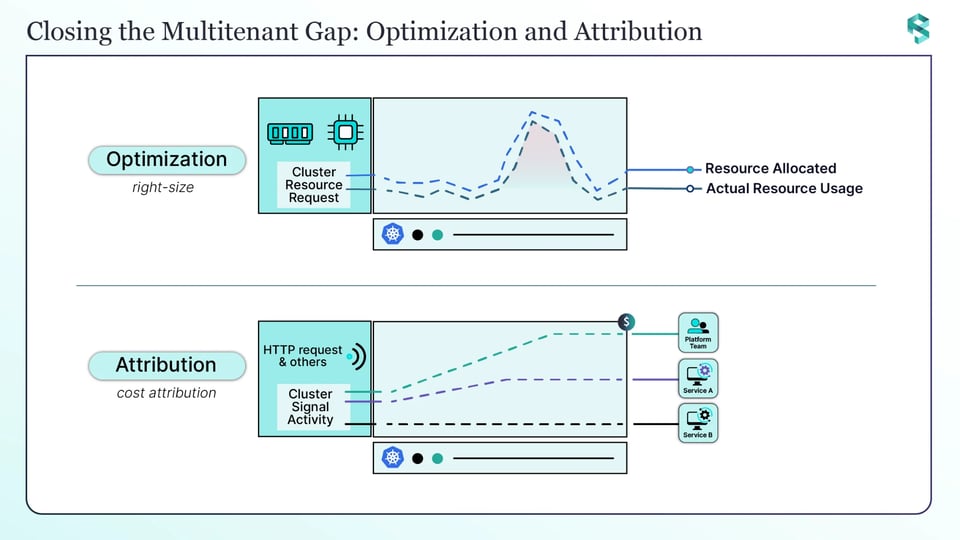
Optimierung: Compute und Speicher per Right-Sizing an die reale Nutzung anpassen. Das beantwortet die Frage "Was muss geändert werden?". Vergleichen Sie kontinuierlich, was jeder Workload anfordert, mit dem, was er tatsächlich nutzt, und übersetzen Sie die Lücke in eine konkrete Änderung: Dieser Workload kann seinen CPU-Request senken, jener braucht mehr Speicher. Genau hier setzt PerfectScale an. Es beobachtet Requests im Verhältnis zur realen Nutzung im gesamten Cluster und liefert Ihnen pro Workload die passende Änderung – damit unterausgelastete Nodes nicht länger unterausgelastet sind. Dieser Teil wird in CPU und Speicher gemessen.
Attribution: die Kosten dem Tenant zuordnen, der sie verursacht hat. Das beantwortet die Frage "Wer?" – und funktioniert anders als die Optimierung. Genau hier machen Teams Fehler. Weil sich Tenants Nodes teilen, lassen sich CPU und Speicher eines Nodes in der Regel nicht sauber zwischen Kunden aufteilen. Auf einem geteilten Node gibt es keine klare Linie, die sagt: So viel Speicher gehört Kunde A, so viel Kunde B. Die Kostenzuordnung pro Tenant basiert deshalb üblicherweise auf einem Signal, das für die tatsächliche Aktivität jedes Tenants im Cluster steht: sein Anteil am HTTP-Request-Volumen, die Anzahl der Nachrichten, die er auf einem geteilten Kafka-Cluster produziert und konsumiert, oder ein anderer Arbeitsindikator, der sich direkt einem Tenant zuordnen lässt. Läuft pro Tenant ein eigener Workload, können Sie stattdessen anhand der Requests und Nutzung dieses Workloads zuordnen. Genau das macht Attribute™ by DoiT: Es liest diese Aktivität aus dem Traffic des Clusters und verteilt die geteilten Kosten danach auf die Tenants – ganz ohne Tagging-Projekt, das gepflegt werden müsste.
Halten Sie beide Aufgaben auseinander. FinOps-Optimierung wird in Compute und Speicher gemessen. Die Attribution pro Tenant wird an dem gemessen, was die Aktivität jedes Tenants im Cluster am besten abbildet. Zusammen machen sie geteilte Kubernetes-Kosten zu etwas, das Sie sowohl senken als auch zuordnen können: PerfectScale zeigt, wo die Infrastruktur effizienter laufen kann, und Attribute verteilt die gemeinsame Rechnung anhand der Aktivität auf die Tenants.
Visual 2 - Zwei verschiedene Aufgaben. (oben erläutert: PS und Attribute)
Sie möchten Optimierung und Attribution pro Tenant live auf einem laufenden Multitenant-Cluster sehen – ganz ohne Folien? Genau das zeigt unser Workshop am 29. September. Jetzt Platz sichern
Was das für Platform- und FinOps-Teams bedeutet
Diese Lücke lohnt sich zu schließen, weil zwei Teams auf der falschen Seite davon feststecken.
Platform-Teams bekommen eine schnelle, verlässliche Antwort auf "Welcher Tenant – und was ändern wir?", statt jedes Auslastungsereignis in eine Suche nach dem verantwortlichen Workload quer durch alle Namespaces zu verwandeln.
FinOps-Teams bekommen eine Sicht pro Tenant darauf, was der Betrieb jedes Tenants kostet und wer daran etwas ändern kann. Chargeback und Showback werden so zu einem Fakt, den beide Seiten sehen – nicht zu einer Verhandlung darüber, wessen Workload es war.
Das ist der eigentliche Gewinn. Sie behalten die Effizienz eines geteilten Clusters und bekommen die Verantwortlichkeit getrennter Cluster – ohne für getrennte Cluster zu bezahlen.
Multitenant-Kubernetes betreiben mit PerfectScale by DoiT
Geteilte Cluster bringen Effizienz, verschleiern aber die Verantwortung. Diese Lücke von Hand zu schließen – über jeden Tenant und jedes Auslastungsereignis hinweg – hält auf Dauer nicht durch.
PerfectScale by DoiT ist eine Resiliency-First-Plattform zur Kubernetes-Optimierung, die kontinuierlich vergleicht, was Ihre Workloads anfordern und was sie tatsächlich nutzen, und die Lücke in Right-Sizing übersetzt, das Sie manuell oder automatisch anwenden können. So schleppen geteilte Nodes keine Kapazität mehr mit, die niemand nutzt – und die Puffer eines Tenants werden nicht zum langsamen Node und zur aufgeblähten Rechnung für alle. Zusammen mit Attribute by DoiT, das den Anteil jedes Tenants an den geteilten Kosten anhand seiner Aktivität aufteilt, decken Sie beide Seiten des Multitenant-Problems ab: den Cluster effizient betreiben und wissen, was jeder Tenant kostet. Teams wie Paramount Pictures und Creditas setzen auf PerfectScale, um geteilte Cluster effizient und zuverlässig zu halten.
Jetzt registrieren oder eine technische Session buchen – und sehen Sie es auf Ihrem eigenen Cluster.
Bevor Sie gehen: Unser Workshop Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches findet am 29. September um 11 Uhr ET statt – mit Vikram Seshadri und Hili Paryenti aus dem Attribute-Team, die Ihre Fragen live beantworten. Jetzt Platz sichern .