PerfectScale
**Pourquoi l'observabilité Kubernetes ne suffit pas pour les clusters multi-tenants**
Vos dashboards montrent un nœud saturé. Ils ne montrent pas quel tenant en est la cause, ni ce qu'il faut changer.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


Dans un cluster Kubernetes multi-tenant, l'observabilité vous indique qu'un nœud est saturé ou que le cluster est surprovisionné. Elle ne vous dit pas quel tenant en est la cause, ni ce qu'il faut changer. Cet écart entre le symptôme visible et le tenant responsable est précisément là où coûts et responsabilités se perdent facilement.
Le sujet est d'autant plus important que presque plus personne n'exploite un cluster par équipe. Dès que plusieurs équipes partagent un nodepool, ce que chaque workload réserve et ce qu'il consomme réellement commencent à diverger. Vos dashboards affichent le résultat. Ils ne montrent pas qui en est propriétaire. Cet article explique pourquoi cet écart s'aggrave dans les clusters partagés, pourquoi l'observabilité standard ne peut pas le combler, et à quoi ressemble une vraie solution, tant pour les équipes plateforme que FinOps.
Les deux questions auxquelles l'observabilité ne peut pas répondre dans un cluster partagé
Ouvrez n'importe quel dashboard de monitoring Kubernetes et vous verrez beaucoup de choses : utilisation CPU et mémoire par nœud, saturation, throttling, pression. Ce que vous ne voyez généralement pas, rapidement, ce sont les deux questions qui comptent vraiment quand quelque chose ne va pas :
- Quel tenant en est la cause ?
- Que faut-il changer ?
Et il y a de quoi rendre des comptes. L'étude de Datadog sur les conteneurs montre que la plupart des workloads utilisent moins de 25 % du CPU qu'ils demandent, et moins de la moitié de la mémoire demandée. L'essentiel de ce qu'un cluster réserve — et paie — reste inutilisé au lieu d'exécuter du travail. Dans un cluster mono-tenant, ce n'est que du gaspillage. Dans un cluster multi-tenant, c'est aussi un problème de responsabilité : la facture arrive sous la forme d'un montant unique pour tout le cluster, et rien n'y indique quelle équipe a gonflé la dépense avec ses marges de sécurité.
VISUEL 1 - Vous voyez que le nœud est saturé, pas qui en est responsable.
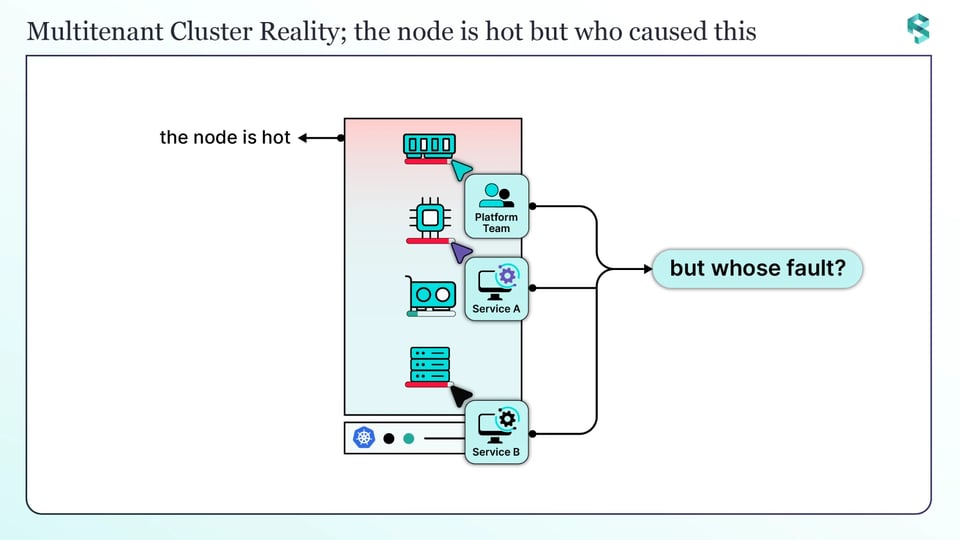
Cet écart, entre un cluster saturé et le tenant qui en est la cause, est exactement ce que nous décortiquons en direct dans notre workshop, Operating Kubernetes Multitenancy, le 29 septembre. Réservez votre place
Requests face à l'usage réel : l'écart qui masque la cause
Pour comprendre d'où vient le gaspillage, il faut examiner deux chiffres par workload : ce qu'il demande, et ce qu'il consomme réellement.
Une request, c'est ce qu'un workload réserve. Le scheduler place les pods en fonction de leurs requests, les quotas les comptabilisent, et la plupart des outils de coûts facturent sur cette base également. L'usage réel, c'est ce que le conteneur consomme effectivement à l'exécution. Dans un workload sain, ces deux valeurs sont proches. Dans la plupart des clusters réels, ce n'est pas le cas.
Elles divergent parce que les requests sont définies une fois puis oubliées : copiées d'un autre service, gonflées par précaution, héritées d'une valeur par défaut d'un chart Helm, et jamais revues alors que le workload a évolué. Trop hautes, vous réservez de la capacité que personne n'utilise. Trop basses, le workload est privé de CPU quand le nœud est chargé, ou remonte en tête de liste d'éviction quand le nœud manque de mémoire. Dans les deux cas, la request ne correspond plus à la réalité.
Dans un cluster partagé, cela peut se produire sur de nombreux workloads en même temps. Un nœud sous-utilisé, ce n'est pas un seul workload mal configuré. C'est un décalage entre requests et usage réel sur de nombreux tenants à la fois. L'observabilité vous montre le nœud sous-utilisé. Elle ne vous dit pas quel tenant, via ses requests, en est la cause.
Pourquoi l'observabilité seule ne suffit pas en multi-tenant
Le monitoring standard vous montre ce qui se passe dans votre infrastructure, mais il ne vous dit pas quel tenant en porte le coût. Dans un cluster partagé, cela se manifeste de quatre façons :
Le coût n'apparaît nulle part. Vous voyez quels pods consomment quoi ; c'est exactement le rôle des métriques cAdvisor et kubelet. Ce qu'elles ne montrent pas, c'est le coût de cet usage, ni quel tenant en est propriétaire.
Il montre l'usage, pas l'écart de configuration. Vous voyez ce qu'un workload consomme, pas qu'il a réservé cinq fois ce dont il a besoin — c'est-à-dire précisément ce que vous devriez changer.
Il est centré sur les nœuds, pas sur les tenants. Les métriques de nœud mélangent tous les tenants présents sur ce nœud. Les séparer par équipe implique d'éplucher les labels à la main, et les ressources partagées - un nœud, une base de données, le réseau - ne peuvent tout simplement pas être découpées proprement par tenant.
Il est réactif. Vous découvrez la saturation, le throttling ou l'éviction après coup, pas avant.
Un faux dilemme se cache derrière tout cela. Les équipes pensent devoir choisir entre efficacité et responsabilité. Les clusters et namespaces partagés densifient les workloads et améliorent l'utilisation, mais rendent difficile de savoir quel tenant porte quelle part du coût. Donner à chaque tenant son propre cluster, voire un nodepool dédié, clarifie la propriété mais alourdit la gestion et laisse malgré tout de la capacité inexploitée. Vous ne devriez pas avoir à choisir entre l'efficacité du multi-tenant et la capacité à savoir qui porte la facture.
Pourquoi les frontières natives de Kubernetes ne comblent pas cet écart
Kubernetes fournit bien des outils pour tracer des frontières entre tenants : namespaces, ResourceQuotas et LimitRanges. Ils excellent à contrôler ce qu'un tenant peut consommer. Ils ne sont pas conçus pour dire qui est responsable du coût.
Un namespace peut héberger les workloads de plusieurs équipes. Les workloads se déplacent. Un quota indique le plafond autorisé pour un tenant, et vous pouvez même vérifier la part consommée par un namespace avec kubectl describe resourcequota. Mais il s'agit d'usage de ressources, pas de coût, et un namespace ne correspond pas toujours à un seul tenant. Ces frontières aident donc à contenir les tenants, mais à elles seules, elles ne se traduisent pas proprement en propriété des coûts. Cet écart doit être comblé autrement.
Ce qui comble réellement l'écart : optimisation et attribution
Combler cet écart exige deux tâches distinctes, et mieux vaut les garder séparées, car elles fonctionnent différemment.
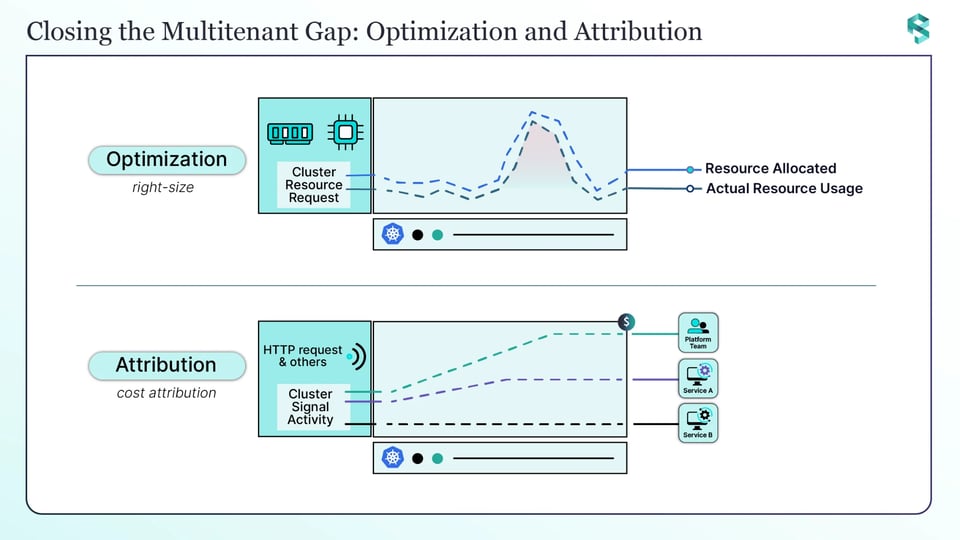
L'optimisation : le right-sizing du compute et de la mémoire selon l'usage réel. Elle répond à la question que changer. Comparez en continu ce que chaque workload demande et ce qu'il consomme réellement, puis transformez l'écart en changement concret : ce workload peut réduire sa request CPU, celui-là a besoin de plus de mémoire. C'est là qu'intervient PerfectScale. Il surveille les requests par rapport à l'usage réel sur l'ensemble du cluster et vous indique le changement à appliquer, workload par workload, pour que les nœuds sous-utilisés cessent de l'être. Cette partie se mesure en CPU et en mémoire.
L'attribution : relier le coût au tenant qui l'a généré. Elle répond à la question qui, et fonctionne différemment de l'optimisation. C'est là que les équipes se trompent. Comme les tenants partagent les nœuds, il est généralement impossible de répartir proprement le CPU et la mémoire d'un nœud entre clients. Rien, sur un nœud partagé, ne délimite clairement la mémoire du client A de celle du client B. L'attribution des coûts par tenant s'appuie donc habituellement sur un signal représentatif de l'activité réelle de chaque tenant dans le cluster : sa part du volume de requêtes HTTP, le nombre de messages produits et consommés sur un cluster Kafka partagé, ou tout autre indicateur d'activité directement rattachable à un tenant. Quand un workload distinct tourne par tenant, on peut attribuer selon les requests et l'usage propres de ce workload. C'est précisément ce que fait Attribute™ by DoiT : il lit cette activité dans le trafic du cluster et répartit le coût partagé entre tenants en conséquence, sans projet de tagging à maintenir.
Ne confondez pas les deux. L'optimisation FinOps se mesure en compute et en mémoire. L'attribution par tenant se mesure via l'indicateur qui représente le mieux l'activité de chaque tenant dans le cluster. Combinez les deux, et le coût Kubernetes partagé devient quelque chose que vous pouvez à la fois réduire et imputer : PerfectScale montre où l'infrastructure peut gagner en efficacité, et Attribute répartit la facture partagée entre tenants selon leur activité.
Visuel 2 - Deux tâches distinctes. (PS et Attribute, expliqués ci-dessus)
Envie de voir l'optimisation et l'attribution par tenant fonctionner sur un vrai cluster multi-tenant, sans slides ? C'est exactement ce que propose notre workshop du 29 septembre. Réservez votre place
Ce que cela change pour les équipes plateforme et FinOps
Si cet écart mérite d'être comblé, c'est parce que deux équipes en subissent les conséquences.
L'équipe plateforme obtient une réponse rapide et fiable à la question quel tenant, et que changeons-nous, au lieu de transformer chaque saturation en chasse au workload responsable à travers les namespaces.
L'équipe FinOps obtient une vue par tenant du coût d'exécution de chacun et de qui peut agir, si bien que le chargeback et le showback deviennent un fait visible des deux côtés, et non une négociation pour savoir à qui appartenait le workload.
C'est là le vrai gain. Vous conservez l'efficacité d'un cluster partagé et vous obtenez la responsabilisation de clusters séparés, sans en payer le prix.
Exploiter Kubernetes en multi-tenant avec PerfectScale by DoiT
Les clusters partagés apportent l'efficacité mais masquent la propriété. Combler cet écart à la main, tenant par tenant et incident par incident, ne tient pas la distance.
PerfectScale by DoiT est une plateforme d'optimisation Kubernetes qui place la résilience au premier plan : elle compare en continu ce que vos workloads demandent et ce qu'ils consomment réellement, puis transforme l'écart en right-sizing applicable manuellement ou automatiquement — pour que les nœuds partagés cessent de porter de la capacité inutilisée, et que les marges d'un tenant ne se traduisent pas, pour tous, par un nœud lent et une facture gonflée. Associé à Attribute by DoiT, qui répartit la part de chaque tenant dans le coût partagé selon son activité, vous couvrez les deux faces du problème multi-tenant : exploiter le cluster efficacement, et connaître le coût d'exécution de chaque tenant. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour garder leurs clusters partagés à la fois efficaces et fiables.
Créez un compte ou réservez une session technique pour le voir à l'œuvre sur votre propre cluster.
Avant de partir : notre workshop, Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches, a lieu le 29 septembre à 11 h (heure de l'Est), avec Vikram Seshadri et Hili Paryenti de l'équipe Attribute pour répondre à vos questions en direct. Réservez votre place .