

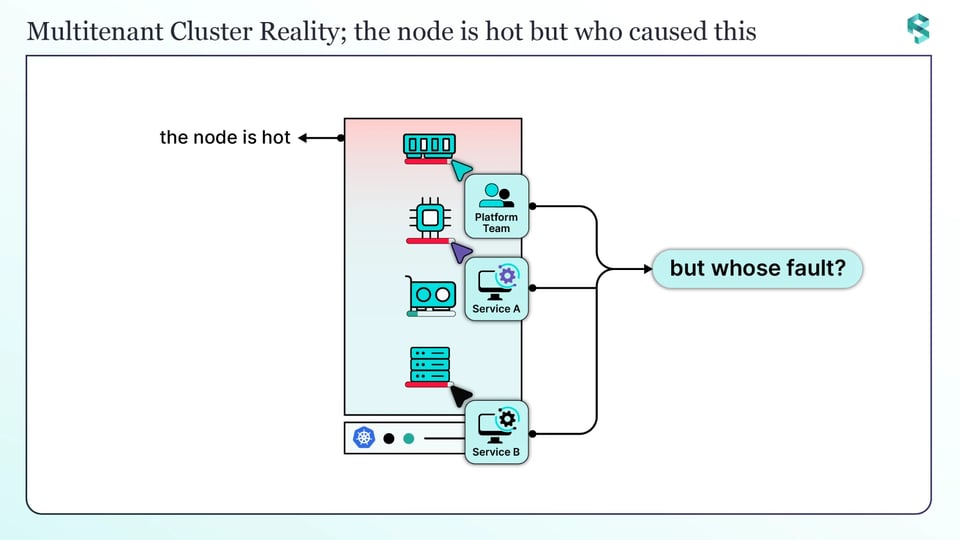
In un cluster Kubernetes multi-tenant, l'observability segnala che un nodo è saturo o che il cluster è sovradimensionato. Non dice quale tenant ne è la causa, né cosa va cambiato. È in questo divario, tra il sintomo visibile e il tenant che ne è responsabile, che costi e responsabilità rischiano di perdersi.
Il tema è rilevante perché ormai quasi nessuno gestisce un cluster per ogni team. Quando più team condividono un node pool, ciò che ogni workload riserva e ciò che utilizza davvero iniziano a divergere. Le dashboard mostrano il risultato, non chi ne è responsabile. In questo articolo vediamo perché il divario peggiora nei cluster condivisi, perché l'observability standard non riesce a colmarlo e come si presenta una soluzione reale per i team platform e FinOps.
Le due domande a cui l'observability non sa rispondere in un cluster condiviso
Aprendo una qualsiasi dashboard di monitoraggio Kubernetes si vede molto: utilizzo di CPU e memoria per nodo, saturazione, throttling, pressione. Ciò che di solito non si vede, e in fretta, sono le risposte alle due domande che contano davvero quando qualcosa non va:
- Quale tenant ha causato il problema?
- Cosa bisogna cambiare?
E c'è molto di cui rendere conto. La ricerca di Datadog sui container ha rilevato che la maggior parte dei workloads utilizza meno del 25% della CPU richiesta e meno della metà della memoria richiesta. Gran parte di ciò che un cluster riserva, e paga, resta inutilizzato invece di eseguire lavoro. In un cluster single-tenant è semplicemente spreco. In un cluster multi-tenant è anche un problema di accountability: la fattura arriva come un unico numero per l'intero cluster e nulla, al suo interno, dice quale team, con i suoi margini sovradimensionati, ha generato la spesa.
VISUAL 1 - Si vede che il nodo è saturo, non di chi è la colpa.
Questo divario, tra un cluster saturo e il tenant che l'ha causato, è esattamente ciò che affrontiamo dal vivo nel nostro workshop, Operating Kubernetes Multitenancy, il 29 settembre. Riserva il tuo posto
Request vs utilizzo effettivo: il divario che nasconde la causa
Per capire da dove nasce lo spreco, bisogna guardare due numeri per ogni workload: ciò che richiede e ciò che utilizza davvero.
Una request è ciò che un workload riserva. Lo scheduler colloca i pod in base alle loro request, le quote le conteggiano e anche la maggior parte degli strumenti di costo fattura su di esse. L'utilizzo effettivo è ciò che il container consuma realmente a runtime. In un workload sano i due valori sono vicini. Nella maggior parte dei cluster reali non lo sono.
Divergono perché le request vengono impostate una volta e poi dimenticate: copiate da un altro servizio, gonfiate per sicurezza, ereditate dal default di un chart Helm e mai riviste al variare del workload. Se sono troppo alte, si riserva capacità che nessuno usa. Se sono troppo basse, il workload resta a corto di CPU quando il nodo è sotto carico, o finisce in cima alla lista di eviction quando il nodo esaurisce la memoria. In entrambi i casi, la request smette di rispecchiare la realtà.
In un cluster condiviso questo può accadere su molti workloads contemporaneamente. Un nodo sottoutilizzato non è un singolo workload mal configurato: è un disallineamento tra request e utilizzo su molti tenant allo stesso tempo. L'observability mostra il nodo sottoutilizzato. Non mostra quali request, e di quale tenant, ne sono la causa.
Perché l'observability da sola non basta per il multi-tenant
Il monitoraggio standard mostra cosa sta succedendo nell'infrastruttura, ma non dice quale tenant ne possiede il costo. In un cluster condiviso questo si manifesta in quattro modi:
Non mostra il costo da nessuna parte. Si può vedere quali pod consumano cosa; è esattamente lo scopo delle metriche di cAdvisor e kubelet. Ciò che non mostrano è il costo di quell'utilizzo, né quale tenant ne è titolare.
Mostra l'utilizzo, non il divario di configurazione. Si vede cosa consuma un workload, non che ha riservato cinque volte ciò di cui ha bisogno, ovvero l'elemento su cui si dovrebbe davvero intervenire.
È centrato sul nodo, non sul tenant. Le metriche di nodo mescolano tutti i tenant presenti su quel nodo. Separarle per team significa scavare a mano tra le label, e le risorse condivise - un nodo, un database, la rete - non possono affatto essere suddivise in modo netto per tenant.
È reattivo. Il problema si scopre dopo la saturazione, il throttling o l'eviction, non prima.
Sotto tutto questo si nasconde un falso compromesso. I team pensano di dover scegliere tra efficienza e accountability. Cluster e namespace condivisi concentrano i workloads in modo compatto e migliorano l'utilizzo, ma rendono difficile capire quale tenant possiede quale fetta del costo. Assegnare a ogni tenant un cluster dedicato, o anche solo un node pool dedicato, rende più chiara la titolarità ma aggiunge overhead di gestione e lascia comunque capacità inutilizzata. Non si dovrebbe dover scegliere tra l'efficienza del multi-tenant e sapere a chi appartiene quella cifra.
Perché i confini nativi di Kubernetes non lo colmano
Kubernetes offre strumenti per tracciare confini tra i tenant: namespace, ResourceQuota e LimitRange. Sono efficaci nel controllare ciò che un tenant può usare. Non sono pensati per dire chi è responsabile del costo.
Un namespace può contenere workloads di più team. I workloads si spostano. Una quota indica il tetto consentito a un tenant, e si può persino verificare quanto ne sta usando un namespace con kubectl describe resourcequota. Ma quello è utilizzo di risorse, non costo, e un namespace non corrisponde sempre a un solo tenant. Questi confini aiutano quindi a contenere i tenant, ma da soli non si mappano in modo pulito sulla titolarità dei costi. Quel divario va colmato in un altro modo.
Cosa colma davvero il divario: ottimizzazione e attribuzione
Colmare il divario richiede due lavori diversi, e conviene tenerli separati, perché funzionano in modi differenti.
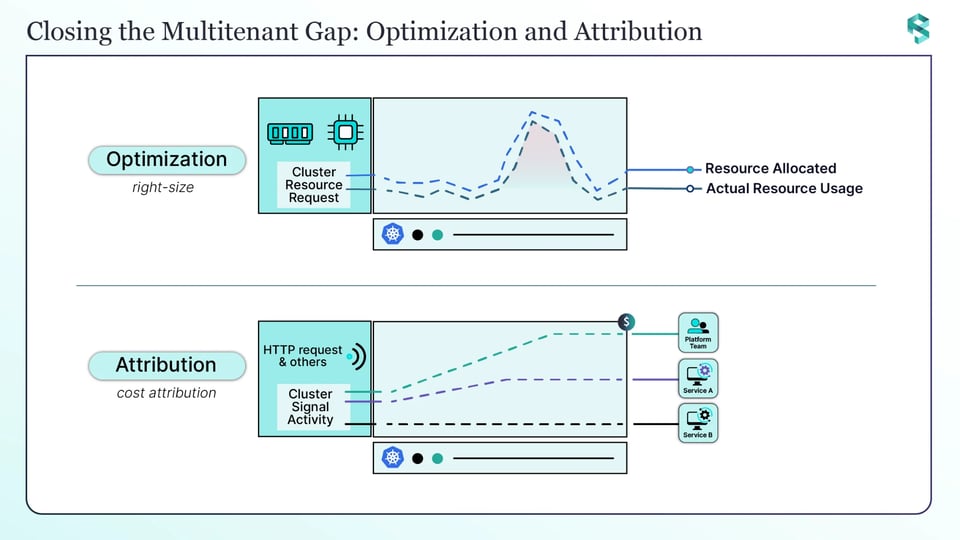
Ottimizzazione: right-sizing di compute e memoria sull'utilizzo reale. Risponde alla domanda "cosa cambiare". Si confronta continuamente ciò che ogni workload richiede con ciò che utilizza davvero e si trasforma il divario in una modifica specifica: questo workload può ridurre la sua request di CPU, quell'altro ha bisogno di più memoria. È qui che opera PerfectScale: osserva le request rispetto all'utilizzo reale in tutto il cluster e indica la modifica da applicare, workload per workload, così i nodi sottoutilizzati smettono di esserlo. Questa parte si misura in CPU e memoria.
Attribuzione: legare il costo al tenant che l'ha generato. Risponde alla domanda "chi", e funziona in modo diverso dall'ottimizzazione. È la parte che i team sbagliano. Poiché i tenant condividono i nodi, di solito non è possibile suddividere in modo netto CPU e memoria di un nodo tra i clienti. Su un nodo condiviso non esiste una linea precisa che dica: questa memoria appartiene al cliente A e quella al cliente B. L'attribuzione dei costi per tenant si basa quindi, in genere, su un segnale che rappresenta l'attività reale di ciascun tenant nel cluster: la sua quota di volume di richieste HTTP, il numero di messaggi che produce e consuma su un cluster Kafka condiviso, o un altro indicatore di lavoro riconducibile direttamente a un tenant. Quando per ogni tenant gira un workload separato, si può invece attribuire in base alle request e all'utilizzo di quel workload. È ciò che fa Attribute™ by DoiT: legge quell'attività dal traffico del cluster e ripartisce di conseguenza il costo condiviso tra i tenant, senza alcun progetto di tagging da mantenere.
Teniamo distinte le due cose. L'ottimizzazione FinOps si misura in compute e memoria. L'attribuzione per tenant si misura con ciò che meglio rappresenta l'attività di ciascun tenant nel cluster. Mettendole insieme, il costo di Kubernetes condiviso diventa qualcosa che si può sia ridurre sia rendicontare: PerfectScale mostra dove l'infrastruttura può funzionare in modo più efficiente e Attribute ripartisce la fattura condivisa tra i tenant in base alla loro attività.
Visual 2 - Due lavori diversi. (PS e Attribute, come spiegato sopra)
Vuoi vedere ottimizzazione e attribuzione per tenant girare dal vivo su un cluster multi-tenant, senza slide? È esattamente quello che mostreremo nel workshop del 29 settembre. Riserva il tuo posto
Cosa significa per i team platform e FinOps
Il motivo per cui vale la pena colmare questo divario è che due team ne restano bloccati dal lato sbagliato.
Il team platform ottiene una risposta rapida e affidabile a "quale tenant, e cosa cambiamo", invece di trasformare ogni evento di saturazione in una caccia al workload responsabile tra i namespace.
Il team FinOps ottiene una vista per tenant di quanto costa far girare ciascun tenant e di chi può intervenire, così chargeback e showback diventano un dato che entrambe le parti possono vedere, non una trattativa su a chi appartenesse il workload.
È questo il vero vantaggio: si mantiene l'efficienza di un cluster condiviso e si ottiene l'accountability di cluster separati, senza pagarne il prezzo.
Gestire Kubernetes multi-tenant con PerfectScale by DoiT
I cluster condivisi offrono efficienza ma nascondono la titolarità. Colmare quel divario a mano, per ogni tenant e per ogni evento di saturazione, non regge.
PerfectScale by DoiT è una piattaforma di ottimizzazione Kubernetes che mette la resilienza al primo posto: confronta continuamente ciò che i workloads richiedono con ciò che utilizzano davvero e trasforma il divario in right-sizing applicabile manualmente o in automatico, così i nodi condivisi smettono di farsi carico di capacità che nessuno usa e i margini sovradimensionati di un tenant non diventano il nodo lento e la fattura gonfiata di tutti. In coppia con Attribute by DoiT, che ripartisce la quota di costo condiviso di ciascun tenant in base alla sua attività, si ottengono entrambe le facce del problema multi-tenant: gestire il cluster in modo efficiente e sapere quanto costa far girare ogni tenant. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere i cluster condivisi efficienti e affidabili al tempo stesso.
Registrati oppure prenota una sessione tecnica per vederlo sul tuo cluster.
Prima di andare: il nostro workshop, Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches, si terrà il 29 settembre alle 11:00 ET, con Vikram Seshadri e Hili Paryenti del team Attribute che risponderanno alle domande in diretta. Riserva il tuo posto .