

Em um cluster Kubernetes multitenant, a observabilidade mostra que um node está saturado ou que o cluster está superprovisionado. Ela não mostra qual tenant causou isso, nem o que precisa mudar. Essa lacuna, entre o sintoma que você consegue ver e o tenant que é o responsável, é onde custo e responsabilidade se perdem com facilidade.
Isso importa porque quase ninguém roda mais um cluster por equipe. Quando as equipes passam a compartilhar um nodepool, o que cada workload reserva e o que ele realmente usa começam a se distanciar. Seus dashboards mostram o resultado. Não mostram de quem é a responsabilidade. Este artigo explica por que essa lacuna piora em clusters compartilhados, por que a observabilidade padrão não consegue fechá-la e como é uma solução de verdade, tanto para a equipe de plataforma quanto para a de FinOps.
As duas perguntas que a observabilidade não responde em um cluster compartilhado
Abra qualquer dashboard de monitoramento de Kubernetes e você verá bastante coisa: uso de CPU e memória por node, saturação, throttling, pressão. O que normalmente não dá para ver, com rapidez, são as duas perguntas que realmente importam quando algo está errado:
- Qual tenant causou o problema?
- O que precisa mudar?
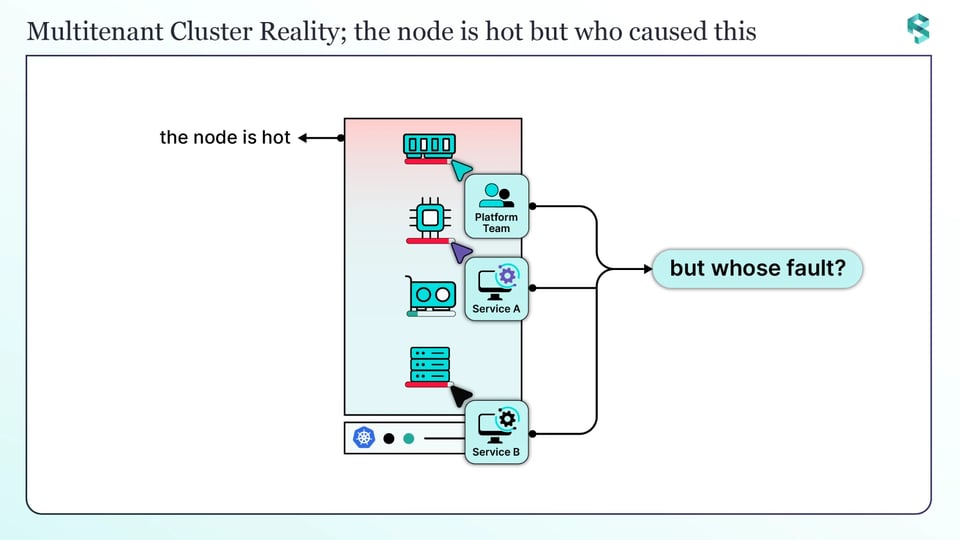
E há muito a explicar. A pesquisa da Datadog sobre contêineres mostrou que a maioria dos workloads usa menos de 25% da CPU que solicita e menos da metade da memória que solicita. A maior parte do que um cluster reserva, e paga, fica ociosa em vez de executar trabalho. Em um cluster single-tenant, isso é apenas desperdício. Em um cluster multitenant, é também um problema de responsabilização: a fatura chega como um único número para o cluster inteiro, e nada nela diz qual folga de qual equipe puxou o gasto.
VISUAL 1 - Você vê que o node está sobrecarregado, mas não de quem é a culpa.
Essa lacuna, entre um cluster saturado e o tenant que a causou, é exatamente o que trabalhamos ao vivo no nosso workshop, Operating Kubernetes Multitenancy, em 29 de setembro. Garanta sua vaga
Requests vs. uso real: a lacuna que esconde a causa
Para entender de onde vem o desperdício, é preciso olhar dois números por workload: o que ele solicita e o que realmente usa.
Um request é o que um workload reserva. O scheduler posiciona os pods pelos requests, as quotas os contabilizam e a maioria das ferramentas de custo também cobra com base neles. O uso real é o que o contêiner de fato consome em tempo de execução. Em um workload saudável, esses dois números ficam próximos. Na maioria dos clusters reais, não ficam.
Eles se distanciam porque os requests são definidos uma vez e depois esquecidos: copiados de outro serviço, inflados por segurança, herdados de um default de Helm chart e nunca revisados conforme o workload mudou. Se forem altos demais, você reserva capacidade que ninguém usa. Se forem baixos demais, o workload fica sem CPU quando o node está ocupado, ou vai para a frente da fila de eviction quando falta memória no node. De qualquer forma, o request deixa de refletir a realidade.
Em um cluster compartilhado, isso pode acontecer em muitos workloads ao mesmo tempo. Um node subutilizado não é um único workload problemático. É um descompasso entre requests e uso em vários tenants de uma só vez. A observabilidade mostra o node subutilizado. Não mostra de qual tenant são os requests que causam isso.
Por que a observabilidade sozinha não basta para multitenancy
O monitoramento padrão mostra o que está acontecendo na sua infraestrutura, mas não diz qual tenant é dono do custo disso. Em um cluster compartilhado, isso aparece de quatro formas:
Ele não mostra custo em lugar nenhum. Dá para ver quais pods estão consumindo o quê; é exatamente para isso que servem as métricas do cAdvisor e do kubelet. O que elas não mostram é o custo desse uso, nem qual tenant é o responsável por ele.
Ele mostra uso, não a lacuna de configuração. Você vê o que um workload consome, não que ele reservou cinco vezes o que precisa, que é justamente o que você mudaria.
Ele é centrado no node, não no tenant. As métricas de node misturam todos os tenants daquele node. Separá-las por equipe significa vasculhar labels manualmente, e recursos compartilhados - um node, um banco de dados, a rede - simplesmente não podem ser divididos de forma limpa por tenant.
Ele é reativo. Você fica sabendo depois da saturação, do throttling ou da eviction, não antes.
Há um falso trade-off escondido debaixo de tudo isso. As equipes assumem que precisam escolher entre eficiência e responsabilização. Clusters e namespaces compartilhados empacotam workloads de forma densa e melhoram a utilização, mas dificultam ver qual tenant é dono de qual fatia do custo. Dar a cada tenant seu próprio cluster, ou mesmo um nodepool dedicado, deixa a propriedade mais clara, mas adiciona overhead de gestão e ainda deixa capacidade parada. Você não deveria ter que escolher entre a eficiência da multitenancy e saber quem é dono do número.
Por que as fronteiras nativas do Kubernetes não fecham essa lacuna
O Kubernetes oferece, sim, ferramentas para traçar linhas entre tenants: namespaces, ResourceQuotas e LimitRanges. Elas são boas para controlar o que um tenant pode usar. Não foram feitas para dizer quem é responsável pelo custo.
Um namespace pode conter workloads de mais de uma equipe. Workloads se movem. Uma quota diz o teto permitido a um tenant, e você pode até verificar quanto dele um namespace está usando com kubectl describe resourcequota. Mas isso é uso de recursos, não custo, e um namespace nem sempre corresponde a um único tenant. Ou seja, essas fronteiras ajudam a conter os tenants, mas, sozinhas, não se mapeiam de forma limpa para a propriedade do custo. Essa lacuna precisa ser preenchida de outra maneira.
O que realmente fecha a lacuna: otimização e atribuição
Fechar a lacuna exige dois trabalhos diferentes, e vale mantê-los separados, porque funcionam de formas distintas.
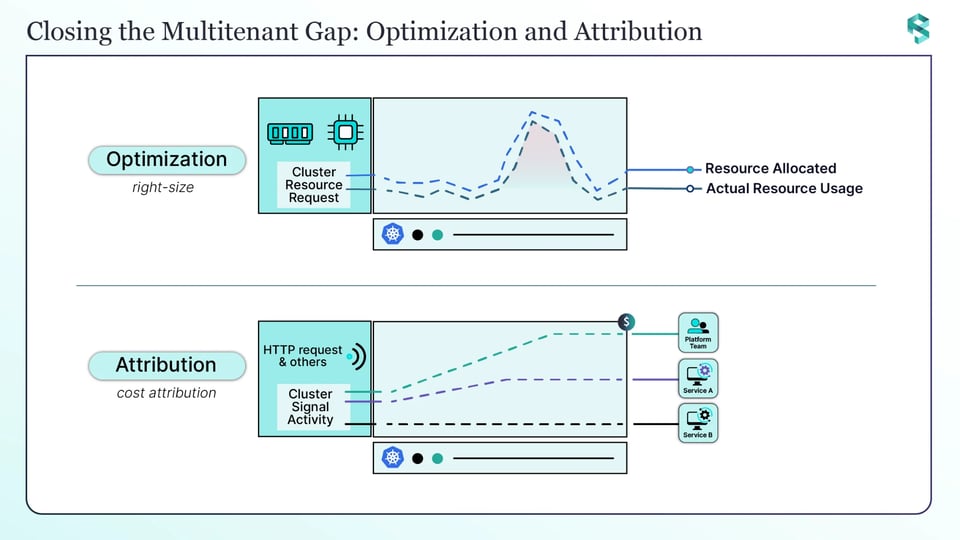
Otimização: right-sizing de computação e memória com base no uso real. Isso responde "o que mudar". Compare continuamente o que cada workload solicita com o que ele realmente usa e transforme a diferença em uma mudança específica: este workload pode reduzir seu request de CPU, aquele precisa de mais memória. É aqui que o PerfectScale atua. Ele acompanha requests versus uso real em todo o cluster e entrega a mudança a fazer, por workload, para que nodes subutilizados deixem de ser subutilizados. Essa parte é medida em CPU e memória.
Atribuição: vincular o custo ao tenant que o gerou. Isso responde "quem", e funciona de forma diferente da otimização. É aqui que as equipes erram. Como os tenants compartilham nodes, geralmente não dá para dividir de forma limpa a CPU e a memória de um node entre clientes. Não existe uma linha nítida em um node compartilhado dizendo que tanta memória pertence ao cliente A e tanta ao cliente B. Por isso, a atribuição de custo por tenant costuma se basear em um sinal que representa a atividade real de cada tenant no cluster: sua fatia do volume de requisições HTTP, o número de mensagens que ele produz e consome em um cluster Kafka compartilhado ou outro indicador de trabalho que você consiga vincular diretamente a um tenant. Quando há um workload separado por tenant, você pode atribuir pelos requests e pelo uso desse próprio workload. É isso que o Attribute™ by DoiT faz: ele lê essa atividade a partir do tráfego do cluster e divide o custo compartilhado entre os tenants com base nela, sem nenhum projeto de tagging para manter.
Mantenha os dois bem separados. A otimização de FinOps é medida em computação e memória. A atribuição por tenant é medida pelo que melhor representa a atividade de cada tenant no cluster. Junte os dois e o custo compartilhado de Kubernetes vira algo que você pode tanto reduzir quanto prestar contas: o PerfectScale mostra onde a infraestrutura pode rodar com mais eficiência, e o Attribute divide a fatura compartilhada entre os tenants pela atividade de cada um.
Visual 2 - Dois trabalhos diferentes. (PS e Attribute, explicados acima)
Quer ver otimização e atribuição por tenant rodando em um cluster multitenant ao vivo, sem slides? É isso que nosso workshop de 29 de setembro apresenta. Garanta sua vaga
O que isso significa para plataforma e FinOps
Vale fechar essa lacuna porque duas equipes estão presas do lado errado dela.
Plataforma ganha uma resposta rápida e confiável para "qual tenant, e o que mudamos", em vez de transformar cada evento de saturação em uma caça ao workload responsável entre namespaces.
FinOps ganha uma visão por tenant de quanto custou rodar cada tenant e de quem pode agir sobre isso, para que chargeback e showback virem um fato que os dois lados enxergam, e não uma negociação sobre de quem era o workload.
Esse é o verdadeiro ganho. Você mantém a eficiência de um cluster compartilhado e obtém a responsabilização de clusters separados, sem pagar por clusters separados.
Operando Kubernetes multitenant com o PerfectScale by DoiT
Clusters compartilhados trazem eficiência, mas escondem a propriedade. Fechar essa lacuna manualmente, para cada tenant e cada evento de saturação, não se sustenta.
O PerfectScale by DoiT é uma plataforma de otimização de Kubernetes com foco em resiliência que compara continuamente o que seus workloads solicitam com o que realmente usam e transforma a diferença em right-sizing que você pode aplicar manual ou automaticamente, para que nodes compartilhados deixem de carregar capacidade que ninguém usa e para que a folga de um tenant não vire o node lento e a fatura inflada de todo mundo. Combinado com o Attribute by DoiT, que divide a fatia de cada tenant no custo compartilhado pela atividade de cada um, você resolve os dois lados do problema multitenant: rodar o cluster com eficiência e saber quanto custa rodar cada tenant. Equipes como Paramount Pictures e Creditas usam o PerfectScale para manter clusters compartilhados eficientes e confiáveis ao mesmo tempo.
Cadastre-se ou agende uma sessão técnica para ver tudo isso no seu próprio cluster.
Antes de sair: nosso workshop, Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches, acontece em 29 de setembro, às 11h (ET), com Vikram Seshadri e Hili Paryenti, do time do Attribute, respondendo suas perguntas ao vivo. Garanta sua vaga .