

マルチテナントのKubernetesクラスタでは、可観測性によってノードが飽和していることや、クラスタが過剰にプロビジョニングされていることは分かります。しかし、どのテナントがその原因なのか、何を変えるべきなのかは分かりません。目に見える症状と、責任を負うべきテナントの間にあるこのギャップこそ、コストと責任の所在が簡単に見失われてしまう場所です。
これが重要なのは、チームごとに1つのクラスタを運用するケースがほとんどなくなったからです。複数のチームがノードプールを共有し始めると、各ワークロードが予約するリソースと実際に使用するリソースが乖離し始めます。ダッシュボードにはその結果が表示されますが、誰の責任かは表示されません。本記事では、共有クラスタでこのギャップがなぜ悪化するのか、標準的な可観測性ではなぜ解消できないのか、そしてプラットフォームチームとFinOpsチームの双方にとって本当の解決策がどのようなものかを解説します。
共有クラスタで可観測性が答えられない2つの問い
Kubernetesの監視ダッシュボードを開けば、多くの情報が見えます。ノードごとのCPUとメモリの使用率、飽和、スロットリング、負荷などです。しかし、何か問題が起きたときに本当に重要な次の2つの問いには、通常すぐには答えられません。
- どのテナントが原因なのか?
- 何を変える必要があるのか?
そして、答えるべきことは山ほどあります。コンテナに関するDatadogの調査によると、ほとんどのワークロードはリクエストしたCPUの25%未満、メモリの半分未満しか使用していません。クラスタが予約し、費用を支払っているリソースの大半は、処理を実行するのではなく遊休状態にあります。シングルテナントのクラスタであれば、それは単なる無駄です。しかしマルチテナントのクラスタでは、説明責任の問題にもなります。請求はクラスタ全体で1つの数字として届き、どのチームの余剰確保が支出を押し上げたのかは、どこにも書かれていないのです。
VISUAL 1 - ノードが高負荷であることは分かっても、誰の責任かは分かりません。
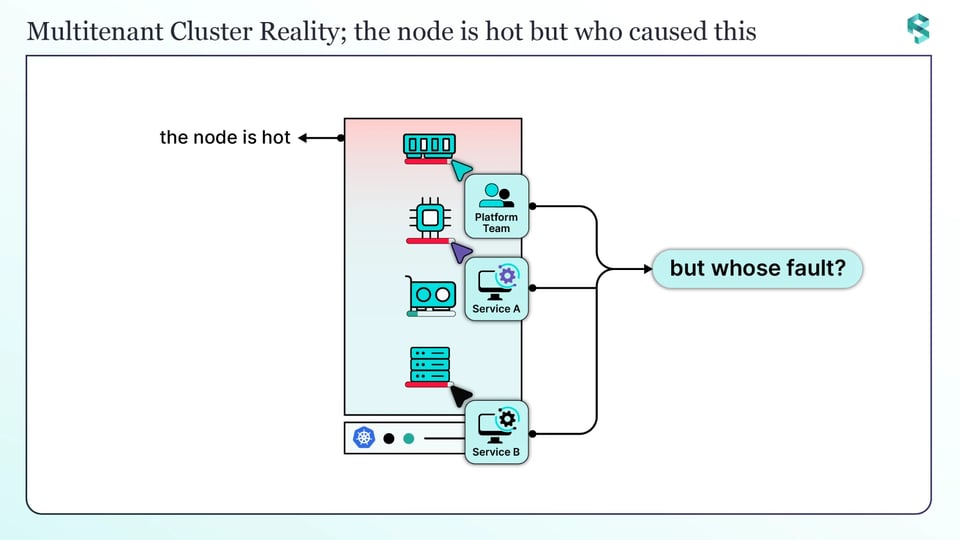
飽和したクラスタと、その原因となったテナントの間にあるこのギャップこそ、9月29日開催のワークショップ「Operating Kubernetes Multitenancy」でライブで取り組むテーマです。席を確保する
リクエストと実使用量:原因を隠すギャップ
無駄がどこから来るのかを知るには、ワークロードごとに2つの数字を見る必要があります。リクエストしている量と、実際に使用している量です。
リクエストとは、ワークロードが予約するリソースです。スケジューラはリクエストに基づいてPodを配置し、クォータもリクエストをカウントし、ほとんどのコストツールもリクエストに基づいて課金します。実使用量とは、コンテナが実行時に実際に消費する量です。健全なワークロードではこの2つは近い値になりますが、実際のクラスタの多くではそうなっていません。
両者が乖離するのは、リクエストが一度設定されると忘れられてしまうからです。別のサービスからコピーされたり、安全のために多めに設定されたり、Helmチャートのデフォルトから引き継がれたりしたまま、ワークロードが変化しても見直されません。高く設定しすぎれば、誰も使わないキャパシティを予約することになります。低く設定しすぎれば、ノードが混雑しているときにワークロードがCPU不足に陥ったり、ノードのメモリが逼迫したときにEvictionの優先対象になったりします。いずれにせよ、リクエストは実態と一致しなくなります。
共有クラスタでは、これが多数のワークロードで同時に起こり得ます。使用率の低いノードは、1つの問題のあるワークロードが原因ではありません。多数のテナントにまたがるリクエストと実使用量のミスマッチが同時に起きているのです。可観測性は使用率の低いノードを見せてくれますが、どのテナントのリクエストがその原因なのかは示してくれません。
マルチテナンシーには可観測性だけでは不十分な理由
標準的な監視はインフラで何が起きているかを示しますが、そのコストをどのテナントが負担すべきかは教えてくれません。共有クラスタでは、これは4つの形で現れます。
**コストがどこにも表示されない。**どのPodが何を消費しているかは分かります。それこそがcAdvisorやkubeletのメトリクスの役割です。しかし、その使用量のコストや、どのテナントがそれを負担すべきかは示されません。
**使用量は見えても、設定のギャップは見えない。**ワークロードが何を消費しているかは分かりますが、必要量の5倍を予約していること、つまり実際に変更すべき点は分かりません。
**ノード中心であり、テナント中心ではない。**ノードのメトリクスは、そのノード上のすべてのテナントを混ぜ合わせてしまいます。チームごとに切り分けるにはラベルを手作業で掘り起こす必要があり、ノード、データベース、ネットワークといった共有リソースは、そもそもテナント単位できれいに分割できません。
**事後対応である。**飽和、スロットリング、Evictionが起きた後に気づくのであって、事前には分かりません。
この根底には、誤ったトレードオフが潜んでいます。チームは効率性と説明責任のどちらかを選ばなければならないと思い込んでいます。共有クラスタとNamespaceはワークロードを高密度に詰め込んで使用率を高めますが、コストのどの部分をどのテナントが負担すべきかは見えにくくなります。テナントごとに専用のクラスタや専用のノードプールを与えれば所有権は明確になりますが、管理のオーバーヘッドが増え、キャパシティは依然として塩漬けのままです。マルチテナンシーの効率性と、数字の責任者を把握することの、どちらかを選ぶ必要はないはずです。
Kubernetes標準の境界機能では解決できない理由
Kubernetesには、テナント間に線を引くためのツールが用意されています。Namespace、ResourceQuota、LimitRangeです。これらはテナントが使用できるリソースを制御するのには優れていますが、誰がコストの責任者なのかを教えるようには作られていません。
1つのNamespaceに複数のチームのワークロードが含まれることがあります。ワークロードは移動します。クォータはテナントに許可された上限を示し、kubectl describe resourcequotaでNamespaceがどれだけ使用しているかを確認することもできます。しかし、それはリソース使用量であってコストではなく、Namespaceが常に1つのテナントに対応するとも限りません。つまり、これらの境界はテナントを封じ込めるのには役立ちますが、それだけではコストの所有権にきれいにマッピングできないのです。このギャップは別の方法で埋める必要があります。
ギャップを本当に埋めるもの:最適化とアトリビューション
このギャップを埋めるには2つの異なる作業が必要であり、それぞれ仕組みが異なるため、分けて考えることが重要です。
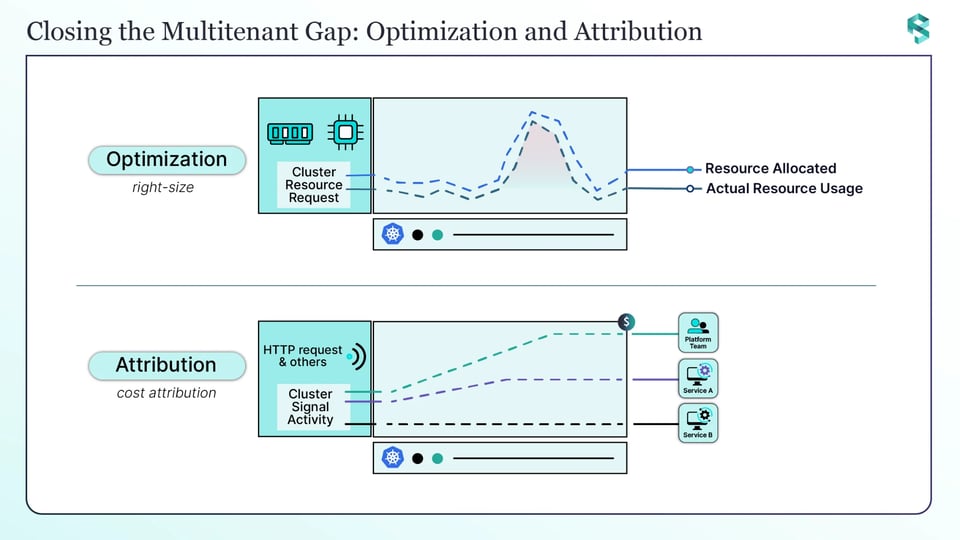
**最適化:コンピュートとメモリを実使用量に合わせてライトサイジングする。**これは「何を変えるべきか」に答えるものです。各ワークロードのリクエストと実使用量を継続的に比較し、そのギャップを具体的な変更に落とし込みます。このワークロードはCPUリクエストを下げられる、あのワークロードはメモリを増やす必要がある、といった具合です。ここで機能するのがPerfectScaleです。クラスタ全体でリクエストと実使用量を監視し、ワークロードごとに実施すべき変更を提示するため、使用率の低いノードが使用率の低いままではなくなります。この部分はCPUとメモリで測定されます。
**アトリビューション:コストを、それを発生させたテナントに紐づける。**これは「誰が」に答えるもので、最適化とは異なる仕組みで動きます。ここがチームの間違えやすいポイントです。テナントはノードを共有しているため、通常、1つのノードのCPUとメモリを顧客間できれいに分割することはできません。共有ノード上に、このメモリは顧客A、あのメモリは顧客Bのもの、という明確な線は存在しないのです。そのため、テナント別のコストアトリビューションは通常、各テナントのクラスタ内での実際のアクティビティを表すシグナルに基づきます。HTTPリクエスト量に占める割合、共有Kafkaクラスタで生成・消費するメッセージ数、あるいはテナントに直接紐づけられるその他の作業指標などです。テナントごとに個別のワークロードが動いている場合は、そのワークロード自体のリクエストと使用量で按分することもできます。これこそがAttribute™ by DoiTの仕組みです。クラスタのトラフィックからそのアクティビティを読み取り、それに基づいて共有コストをテナント間で分割します。維持すべきタグ付けプロジェクトは不要です。
この2つを混同しないでください。FinOpsの最適化はコンピュートとメモリで測定されます。テナント別のアトリビューションは、クラスタ内の各テナントのアクティビティを最もよく表す指標で測定されます。この2つを組み合わせれば、共有Kubernetesのコストは、削減も説明もできるものになります。PerfectScaleはインフラをより効率的に運用できる箇所を示し、Attributeはアクティビティに基づいて共有の請求をテナント間で分割します。
Visual 2 - 2つの異なる役割。(上記のPSとAttributeの説明)
最適化とテナント別アトリビューションが、スライドなしで実際のマルチテナントクラスタ上で動く様子を見てみませんか?それこそが9月29日のワークショップの内容です。席を確保する
プラットフォームとFinOpsにとっての意味
このギャップを埋める価値があるのは、2つのチームがその不利な側に取り残されているからです。
プラットフォームチームは、飽和イベントのたびにNamespaceを横断して原因のワークロードを探し回る代わりに、「どのテナントで、何を変えるべきか」に対する迅速で信頼できる答えを得られます。
FinOpsは、各テナントの運用コストと、それに対処できる担当者をテナント別に把握できるため、チャージバックとショーバックが、どちらのワークロードだったかを巡る交渉ではなく、双方が確認できる事実になります。
これこそが本当の成果です。共有クラスタの効率性を維持しながら、個別クラスタの説明責任を、個別クラスタの費用を払うことなく手に入れられます。
PerfectScale by DoiTで実現するマルチテナントKubernetes運用
共有クラスタは効率性をもたらす一方で、所有権を見えなくします。このギャップを、すべてのテナントとすべての飽和イベントにわたって手作業で埋め続けることはできません。
PerfectScale by DoiTは、レジリエンシーを最優先するKubernetes最適化プラットフォームです。ワークロードのリクエストと実使用量を継続的に比較し、そのギャップを手動または自動で適用できるライトサイジングに変換します。これにより、共有ノードが誰も使わないキャパシティを抱え込むことがなくなり、1つのテナントの余剰確保が、全員にとっての遅いノードと膨れ上がった請求になることを防ぎます。各テナントのアクティビティに基づいて共有コストの負担分を分割するAttribute by DoiTと組み合わせれば、マルチテナント問題の両面、つまりクラスタの効率的な運用と、各テナントの運用コストの把握を実現できます。Paramount PicturesやCreditasといったチームが、共有クラスタの効率性と信頼性を両立させるためにPerfectScaleを運用しています。
今すぐ登録するか、技術セッションを予約して、ご自身のクラスタでお試しください。
最後にお知らせです。ワークショップ「Operating Kubernetes Multitenancy: Shared Cluster, Separate Headaches」を9月29日 米国東部時間午前11時に開催します。AttributeチームのVikram SeshadriとHili Paryentiがライブで質問にお答えします。席を確保する 。