


El problema del noisy neighbor (o "vecino ruidoso") en Kubernetes ocurre cuando un workload en un nodo compartido consume más de lo que le corresponde de CPU, memoria, disco o red, y deja sin recursos o ralentiza a los demás workloads que corren a su lado. Es un efecto secundario de la multitenencia: en cuanto agrupas muchas aplicaciones o equipos en el mismo clúster, empiezan a competir por los mismos recursos del nodo.
Esto es importante porque Kubernetes agrupa los pods a propósito para reducir costos. Ese mismo agrupamiento es lo que permite que un pod que se porta mal perjudique a los que tiene alrededor. La buena noticia es que Kubernetes te da los controles para evitarlo. En este artículo repasamos qué es exactamente el problema, por qué hace más daño del que muchos esperan, y las configuraciones y hábitos que lo solucionan.
¿Qué es el problema del noisy neighbor en Kubernetes?
Un nodo de Kubernetes tiene una cantidad fija de CPU y memoria. Cada pod que se programa en ese nodo consume del mismo pool. Cuando un pod usa mucho más de lo que debería, queda menos para todos los demás en ese nodo. Ese es el problema del noisy neighbor.
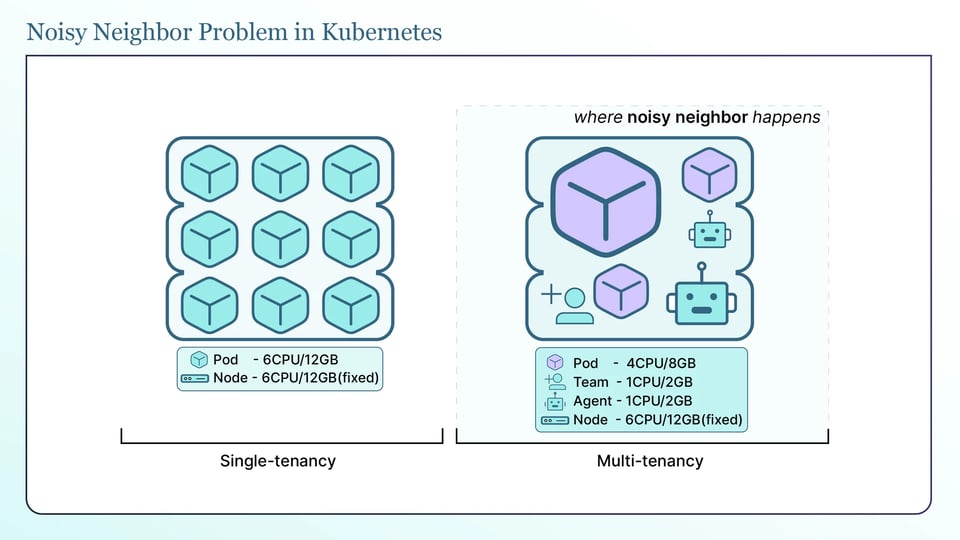
Se le llama subproducto de la multitenencia porque solo aparece cuando se comparte. Cuando varios equipos comparten un clúster con un número fijo de nodos, un equipo puede terminar usando más de lo que le corresponde. Un clúster de un solo tenant, con una app por nodo, rara vez tiene este problema. Un clúster compartido con muchos equipos, muchos namespaces y un bin-packing agresivo lo tiene todo el tiempo.
Para entender por qué un pod puede perjudicar a otro, hay que saber cómo reparte Kubernetes la CPU y la memoria. Se comportan de forma muy distinta:
La CPU es compresible. Si un pod quiere más CPU de la que hay libre, el kernel simplemente lo hace esperar. No se cae nada. Cuando defines un límite de CPU, Kubernetes lo aplica mediante throttling: el kernel limita el contenedor a su límite y no puede pasar de ahí. Cuando todo el nodo está ocupado, Kubernetes reparte el tiempo de CPU en proporción al request de CPU de cada pod. Así, un pod que declaró un request real sigue recibiendo su parte, mientras que uno que no declaró nada puede quedarse sin recursos.
La memoria es incompresible. No puedes hacer que un proceso "espere" por memoria que ya necesita. Si un contenedor supera su límite de memoria, el kernel lo mata con un OOM (out of memory) kill. Y si a todo el nodo se le acaba la memoria, Kubernetes no le pide amablemente a nadie que baje el ritmo: empieza a eliminar pods. Ahí es donde ocurre el verdadero daño.
Los noisy neighbors son, en el fondo, un problema de multitenencia, y empeora cuantos más equipos comparten un clúster. Eso es exactamente lo que veremos en vivo el 29 de septiembre, sobre un clúster real. Reserva tu lugar.
Por qué importa el problema del noisy neighbor
Lo sorprendente es quién sale perjudicado. Muchas veces no es el pod glotón.
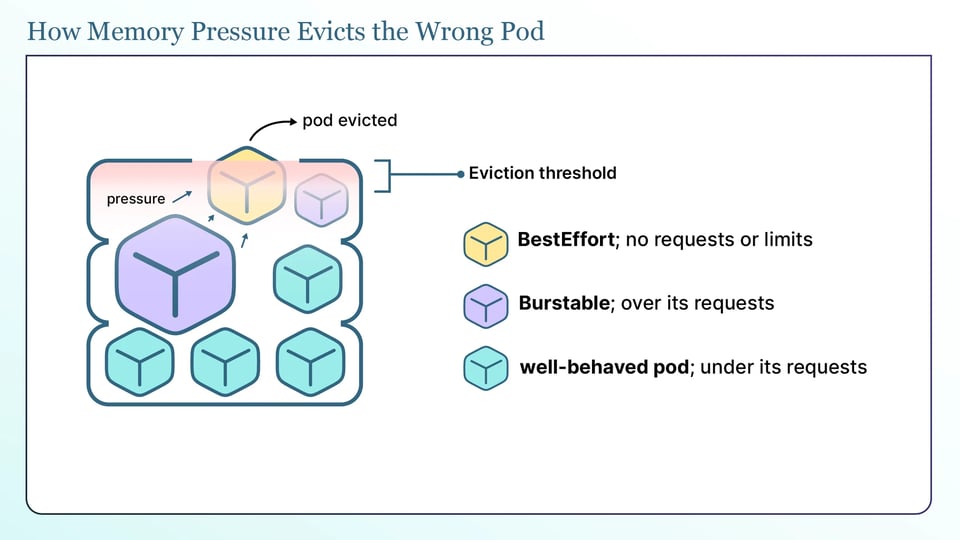
Cuando un nodo se queda sin memoria, el kubelet interviene y empieza a expulsar pods para liberar memoria. Es una acción a nivel de nodo. El kubelet monitorea una señal del nodo como memory.available y, una vez que se cruza el umbral de expulsión, elige qué pods eliminar.
¿Cómo los elige? No según "quién es el ruidoso". El kubelet ordena los pods según si su uso supera sus requests y luego según la prioridad del pod. Un pod que se mantiene por debajo de sus requests se expulsa al final. Un pod que supera sus requests es candidato, aunque no sea el pod que causó la presión.
Aquí es donde las cosas salen mal para quien definió los requests más débiles. Cuando al nodo se le acaba la memoria, el kubelet no expulsa al pod que causó la presión. Expulsa primero a los pods menos protegidos: primero van los pods sin requests ni limits (BestEffort), luego los que usan más de lo que solicitaron. Los pods que se mantienen dentro de sus requests, y los pods Guaranteed, se expulsan al final. Así que un workload pequeño que no definió requests, solo por mantener su configuración simple, puede ser el primero en morir en cuanto cualquier otro workload llene el nodo, aunque no haya hecho nada malo. El pod que omitió sus requests paga por una presión que creó otro.
Hay otros dos comportamientos de expulsión que es importante conocer:
Los pods Guaranteed están protegidos de la expulsión, pero no del OOM killer: un pod donde cada contenedor tiene requests y limits iguales obtiene la clase de calidad de servicio Guaranteed, y el kubelet lo expulsa al final. Pero si ese mismo pod alcanza su propio límite de memoria, el OOM killer del kernel se activa igual y mata el contenedor. Guaranteed te protege de la expulsión a nivel de nodo, no de tu propio límite.
El ruido de CPU afecta sobre todo a los pods que omitieron sus requests: como la CPU se reparte según el peso de los requests, un pod con un request de CPU bien definido conserva su parte incluso cuando el nodo está bajo carga intensa. Los que sufren son los pods que no definieron ningún request de CPU. Reciben lo que sobra, que bajo carga puede ser casi nada.
Así que el costo del problema del noisy neighbor no es solo un pod lento. Son expulsiones y OOM kills que caen sobre workloads que no hicieron nada malo, picos de latencia en servicios que omitieron sus requests, y reinicios que rompen tus SLOs. Y es difícil de depurar, porque el síntoma aparece en la víctima, no en la causa.
Cómo prevenir el problema del noisy neighbor en Kubernetes
La solución consiste en varias capas que funcionan en conjunto: definir requests y limits, poner topes a los namespaces con quotas, ajustar los valores a la medida justa, automatizar ese right-sizing y tener visibilidad de quién está usando qué.
a. Define requests y limits de recursos
Esta es la base. Todo lo demás se construye sobre ella.
Un request es lo que el pod reserva. El scheduler usa el request para elegir un nodo, y el kubelet reserva al menos esa cantidad para el contenedor. Un limit es el techo que el pod no puede superar. Esto es lo que hace cada uno en la práctica:
| Configuración | Qué controla | Qué pasa al alcanzarlo |
|---|---|---|
| Request de CPU | Reserva CPU y define la parte del pod cuando el nodo está ocupado | El pod puede usar más si hay CPU libre |
| Limit de CPU | Pone un tope a la CPU | Throttling en el límite; nunca se mata el pod |
| Request de memoria | Reserva memoria y determina la programación y el orden de expulsión | El pod puede usar más si hay memoria libre |
| Limit de memoria | Pone un tope a la memoria | OOM kill si lo supera |
Del comportamiento de la CPU y la memoria se desprenden dos reglas prácticas:
Para la memoria, define siempre un request y establece el limit igual a él. Así el pod nunca podrá usar más de lo que reservó, no será el que empuje al nodo a la presión, y se expulsará al final. (Definir requests de CPU y memoria iguales a los limits en todos los contenedores le da al pod completo la clase Guaranteed, la protección más fuerte, pero eso implica definir también limits de CPU, con el trade-off de throttling de la regla de CPU de abajo.) Un pod sin limit de memoria es justamente el que puede comerse el nodo entero.
Para la CPU, define siempre un request para que el pod conserve su parte bajo carga. Ten cuidado con los limits de CPU: como la CPU es compresible, un limit sobre todo frena al pod que lo tiene y apenas protege a los vecinos (el peso de los requests ya se encarga de eso). Muchos equipos definen requests de CPU y omiten los limits de CPU en servicios sensibles a la latencia para evitar el throttling. Pruébalo con tus propios workloads en lugar de tratarlo como una regla.
Un detalle a tener en cuenta: si defines un limit pero no un request, Kubernetes copia el limit y lo usa como request. Eso no siempre es lo que quieres, así que define ambos de forma deliberada.
b. Pon un tope a cada namespace con resource quotas
Los requests y limits funcionan por pod. Un ResourceQuota funciona por namespace. Establece un tope estricto al total de CPU, memoria y cantidad de objetos que puede usar un namespace, para que un equipo no pueda quedarse con todo el clúster.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"El quota se aplica al momento de la admisión. Si un pod nuevo hiciera que el namespace supere el tope, el servidor de API lo rechaza. Los pods que ya están corriendo no se tocan.
Una vez que un namespace tiene un quota de cómputo, cada pod dentro de él debe definir los requests y limits correspondientes, o el pod se rechaza. Suena estricto, pero de eso se trata: obliga a cada pod a declarar lo que necesita, que es justamente lo que frena a los noisy neighbors.
Para que eso no sea un dolor de cabeza, combina el quota con un LimitRange. Un LimitRange cumple dos funciones útiles en un namespace: define requests y limits por defecto que se inyectan en cualquier pod que olvidó configurarlos, y establece un mínimo y un máximo por contenedor para que ningún pod pueda pedir una porción gigante. El quota fija el presupuesto del namespace; el LimitRange evita que un solo pod lo acapare todo y completa con valores por defecto razonables.
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
En un namespace con un ResourceQuota, subir los requests de un workload cuenta contra el presupuesto del namespace, así que un optimizador tiene que evitar romper el quota. El soporte de ResourceQuota en Full mode de PerfectScale hace que su right-sizing tenga en cuenta el quota: sube los requests y limits de un workload hasta el margen que el quota todavía permite, de modo que los namespaces gobernados por quotas se ajustan como cualquier otro, en lugar de quedar subaprovisionados solo para mantenerse cómodamente por debajo del tope.
¿Quieres verlo en un clúster en vivo y no solo en esta página? Súmate a nuestro webinar de multitenencia el 29 de septiembre. Reserva tu lugar.
c. Ajusta los valores al uso real
Los quotas y limits solo ayudan si los números son correctos. Los valores que se definen una vez y se olvidan suelen estar mal, y mal en ambas direcciones.
Si defines requests demasiado altos, reservas capacidad que nadie usa. El scheduler cree que el nodo está lleno, así que reparte los pods en más nodos de los que necesitas, y tu factura sube. Si los defines demasiado bajos, tienes el problema opuesto: con muy poco request de CPU, el pod se queda sin CPU cuando el nodo está ocupado; con muy poca memoria, el pod supera su request, lo que lo acerca al frente de la fila de expulsión cuando al nodo se le acaba la memoria. En ambos casos, vuelves al problema del noisy neighbor.
El right-sizing consiste en definir requests y limits que coincidan con lo que el workload realmente usa. PerfectScale hace exactamente eso: compara lo que cada workload solicita contra lo que realmente usa, y te da el número que debes configurar, por workload. Pero configurarlo una vez es la parte fácil. Lo difícil es mantener los números correctos a medida que el workload cambia.
d. Automatízalo, porque los workloads cambian
El right-sizing no es una tarea puntual. El tráfico cambia, se lanzan nuevas funcionalidades, y una nueva versión puede cambiar cuánta memoria o CPU necesita un servicio. Los valores que ajustaste el mes pasado pueden estar mal hoy, y los requests desactualizados son la forma en que un workload vuelve a convertirse, sin que nadie lo note, en un noisy neighbor.
Hacer esto a mano en cientos de workloads no escala, y es lo bastante tedioso como para que se deje de hacer. La respuesta viable es la automatización, que es lo que hace PerfectScale: monitorea el uso real de forma continua y mantiene los requests y limits de cada workload en el punto correcto a medida que evolucionan, en lugar de dejarlo en una hoja de cálculo que alguien actualiza una vez por trimestre. Aquí entra el factor confiabilidad: el aislamiento solo se sostiene si los números se mantienen correctos, y los números solo se mantienen correctos si algo se encarga de que así sea.
e. Ten visibilidad de quién está usando qué
No puedes arreglar un noisy neighbor que no puedes ver. Cuando un nodo está bajo presión, o un namespace supera su quota, la primera pregunta siempre es "¿qué workload y qué equipo?". Sin el uso desglosado por namespace y por equipo, estás adivinando.
Tener visibilidad significa poder responder rápido: qué workloads están usando más que sus requests, qué namespaces están cerca de su quota, y cuánto está usando y costando realmente cada equipo.
Aquí es donde ayuda Attribute™ by DoiT. Observa el consumo real en tiempo de ejecución y lo asocia al workload y al equipo que lo generó, sin necesidad de un proyecto de etiquetado. Así, en lugar de adivinar, puedes ver exactamente qué workload es el noisy neighbor, y cuánto está usando y costando realmente cada equipo.
Lo que los requests y quotas no cubren
Seamos honestos sobre sus alcances: los requests, limits, quotas y LimitRanges cubren la CPU y la memoria. No resuelven directamente todos los tipos de noisy neighbor.
El I/O de disco y el ancho de banda de red no se controlan del todo con estas configuraciones. Un pod que usa demasiado disco o ancho de banda de red aún puede ralentizar a otros pods en el mismo nodo. Para manejarlo necesitas otras herramientas, como node pools separados para workloads pesados, controles de I/O a nivel de almacenamiento y limitación de tráfico de red a través de tu CNI. El uso de disco local se puede gestionar hasta cierto punto con requests y limits de ephemeral-storage, pero estos no controlan la velocidad ni el rendimiento del disco.
La conclusión no es que estas herramientas sean débiles, sino que "noisy neighbor" abarca más que CPU y memoria, y una respuesta completa también contempla los demás recursos.
Mantén tus workloads sanos con PerfectScale by DoiT
El problema del noisy neighbor se reduce a que dos cosas se cumplan al mismo tiempo: que cada workload declare lo que necesita, y que esos números se mantengan correctos a medida que los workloads cambian. Hacerlo a mano en un clúster real no se sostiene.
PerfectScale by DoiT es una plataforma de optimización de Kubernetes que pone la resiliencia primero: monitorea continuamente tus workloads en busca de riesgos derivados de los recursos (OOM kills, throttling de CPU y expulsiones) y los convierte en recomendaciones de right-sizing que puedes aplicar de forma manual o autónoma. Mantiene los requests y limits alineados con el uso real a medida que tus workloads evolucionan, para que un tenant no se convierta silenciosamente en el problema de todos los demás, y te da la visibilidad por namespace y por equipo para ver exactamente quién está usando qué. Equipos como Paramount Pictures y Creditas lo usan para mantener sus clústeres eficientes y confiables a la vez.
Regístrate o agenda una sesión técnica para verlo en tu propio clúster.
Antes de irte: nuestro webinar de multitenencia es el 29 de septiembre. El mismo problema de este artículo, pero en vivo sobre un clúster real y con respuestas a tus preguntas. [Reserva tu lugar]