


Il problema del noisy neighbor ("vicino rumoroso") in Kubernetes si verifica quando un workload su un nodo condiviso usa più di quanto gli spetterebbe di CPU, memoria, disco o rete, sottraendo risorse agli altri workloads in esecuzione sullo stesso nodo o rallentandoli. È un effetto collaterale della multitenancy: nel momento in cui molte app o molti team vengono raggruppati sullo stesso cluster, iniziano a competere per le stesse risorse del nodo.
Il tema è importante perché Kubernetes raggruppa i pod di proposito, per risparmiare. Ma è proprio questa densità a permettere a un pod che si comporta male di danneggiare quelli circostanti. La buona notizia è che Kubernetes mette a disposizione i controlli per fermarlo. Questo articolo spiega in cosa consiste davvero il problema, perché fa più danni di quanto ci si aspetti, e quali impostazioni e abitudini lo risolvono.
Cos'è il problema del noisy neighbor in Kubernetes?
Un nodo Kubernetes ha una quantità fissa di CPU e memoria. Ogni pod schedulato su quel nodo attinge allo stesso pool. Quando un pod usa molto più del dovuto, ne resta meno per tutti gli altri su quel nodo. Questo è il problema del noisy neighbor.
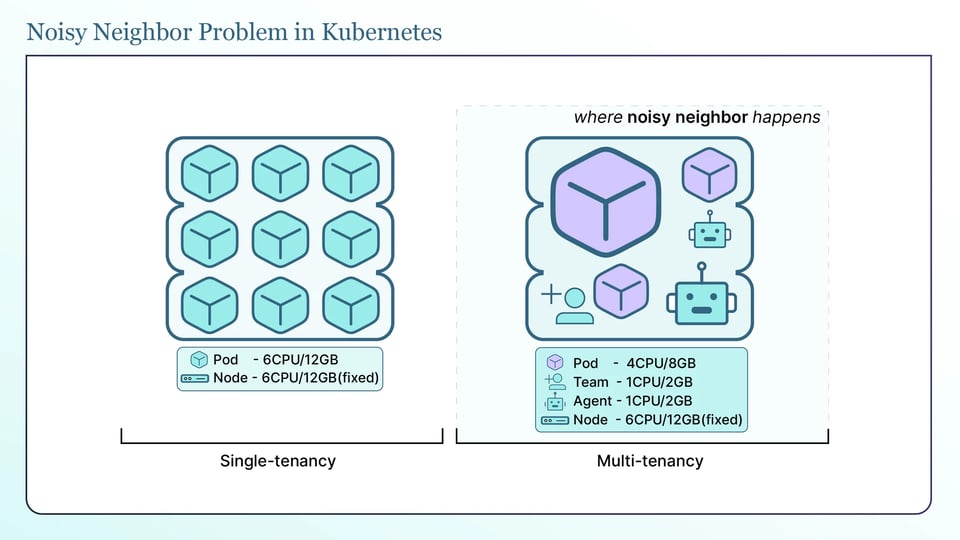
Viene definito un sottoprodotto della multitenancy perché si manifesta solo quando si condivide. Quando più team condividono un cluster con un numero fisso di nodi, un team può finire per usare più di quanto gli spetterebbe. Un cluster single-tenant con una sola app per nodo raramente ha questo problema. Un cluster condiviso con molti team, molti namespace e un bin-packing spinto lo ha in continuazione.
Per capire perché un pod può danneggiarne un altro, bisogna sapere come Kubernetes distribuisce CPU e memoria. Le due risorse si comportano in modo molto diverso:
La CPU è comprimibile. Se un pod vuole più CPU di quella disponibile, il kernel lo fa semplicemente aspettare. Non si blocca nulla. Quando si imposta un limit sulla CPU, Kubernetes lo applica tramite throttling: il kernel vincola il container al suo limit, e non può andare oltre. Quando l'intero nodo è occupato, Kubernetes ripartisce il tempo di CPU in proporzione alla CPU request di ciascun pod. Quindi un pod che ha dichiarato una request realistica continua a ricevere la sua fetta, mentre un pod che non ha dichiarato nulla può restare a secco.
La memoria è incomprimibile. Non si può far "aspettare" un processo per la memoria di cui ha già bisogno. Se un container supera il suo limit di memoria, il kernel lo termina con un OOM (out of memory) kill. E se l'intero nodo resta a corto di memoria, Kubernetes non chiede gentilmente a nessuno di rallentare: inizia a rimuovere pod. È qui che avviene il danno vero.
I noisy neighbor sono in realtà un problema di multitenancy, e peggiora man mano che aumentano i team che condividono un cluster. È esattamente ciò che tratteremo dal vivo il 29 settembre, su un cluster reale. Riservi il suo posto.
Perché il problema del noisy neighbor è importante
La parte sorprendente è chi ne fa le spese. Spesso non è il pod ingordo.
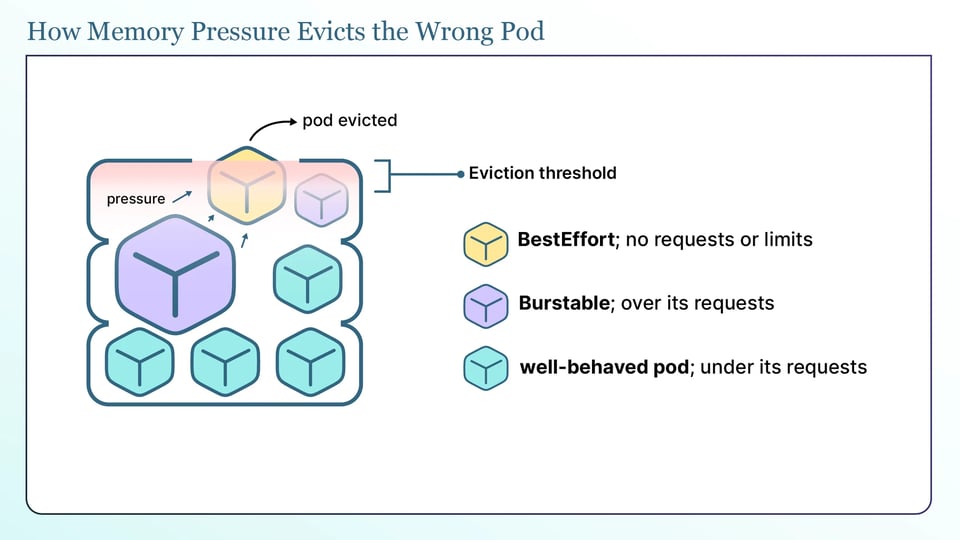
Quando un nodo resta a corto di memoria, il kubelet interviene e inizia a fare eviction dei pod per liberare memoria. È un'azione a livello di nodo. Il kubelet osserva un segnale del nodo come memory.available e, una volta superata la soglia di eviction, sceglie quali pod rimuovere.
Come sceglie? Non in base a "chi è quello rumoroso". Il kubelet classifica i pod in base al fatto che il loro utilizzo superi le loro request, e poi in base alla priorità del pod. Un pod che resta sotto le sue request viene rimosso per ultimo. Un pod che supera le sue request è un candidato, anche se non è il pod che ha causato la pressione.
È qui che le cose vanno male per chi ha impostato le request più deboli. Quando il nodo resta a corto di memoria, il kubelet non rimuove il pod che ha causato la pressione. Rimuove prima i pod meno protetti: prima quelli senza request né limit (BestEffort), poi quelli che usano più di quanto richiesto. I pod che restano entro le proprie request, e i pod Guaranteed, vengono rimossi per ultimi. Così un piccolo workload che non ha impostato le request, magari solo per mantenere semplice la configurazione, può essere il primo a essere terminato nel momento in cui un altro workload riempie il nodo, pur non avendo fatto nulla di male. Il pod che ha saltato le request paga per una pressione creata da qualcun altro.
Ci sono altri due comportamenti dell'eviction importanti da conoscere:
I pod Guaranteed sono protetti dall'eviction, ma non dall'OOM killer: un pod in cui ogni container ha request e limit uguali ottiene la classe di quality of service Guaranteed, e il kubelet lo rimuove per ultimo. Ma se quello stesso pod raggiunge il proprio limit di memoria, l'OOM killer del kernel scatta comunque e termina il container. Guaranteed protegge dall'eviction a livello di nodo, non dal proprio limit.
Il rumore sulla CPU colpisce soprattutto i pod che hanno saltato le request: poiché la CPU viene condivisa in base al peso delle request, un pod con una CPU request adeguata mantiene la sua quota anche quando il nodo è sotto carico pesante. A soffrire sono i pod che non hanno impostato alcuna CPU request: ricevono ciò che avanza, che sotto carico può essere quasi nulla.
Quindi il costo del problema del noisy neighbor non è solo un pod lento. Sono eviction e OOM kill che colpiscono workloads che non hanno fatto nulla di male, picchi di latenza su servizi che hanno saltato le request e riavvii che violano gli SLO. Ed è difficile da debuggare, perché il sintomo compare sulla vittima, non sulla causa.
Come prevenire il problema del noisy neighbor in Kubernetes
La soluzione è fatta di alcuni livelli che lavorano insieme: impostare request e limit, limitare i namespace con le quote, dimensionare correttamente i valori, automatizzare il right-sizing e ottenere visibilità su chi sta usando cosa.
a. Impostare request e limit sulle risorse
Questa è la base. Tutto il resto si costruisce sopra.
Una request è ciò che il pod riserva. Lo scheduler usa la request per scegliere un nodo, e il kubelet riserva al container almeno quella quantità. Un limit è il tetto che il pod non può superare. Ecco cosa fa concretamente ciascuno:
| Impostazione | Cosa controlla | Cosa succede quando viene raggiunta |
|---|---|---|
| CPU request | Riserva CPU, definisce la quota del pod quando il nodo è occupato | Il pod può usarne di più se c'è CPU libera |
| CPU limit | Pone un tetto alla CPU | Throttling al raggiungimento del limit, mai terminato |
| Memory request | Riserva memoria, determina lo scheduling e l'ordine di eviction | Il pod può usarne di più se c'è memoria libera |
| Memory limit | Pone un tetto alla memoria | OOM kill se lo supera |
Dal comportamento di CPU e memoria derivano due regole pratiche:
Per la memoria, impostare sempre una request, con un limit uguale a essa. In questo modo il pod non potrà mai usare più di quanto riservato, quindi non sarà lui a mettere sotto pressione il nodo, e verrà rimosso per ultimo. (Impostare request di CPU e memoria uguali ai limit su ogni container assegna all'intero pod la classe Guaranteed, la protezione più forte, ma significa impostare anche i limit di CPU, con il compromesso del throttling descritto nella regola sulla CPU qui sotto.) Un limit di memoria mancante è il modo in cui un solo pod si mangia l'intero nodo.
Per la CPU, impostare sempre una request in modo che il pod mantenga la sua quota sotto carico. Attenzione ai limit di CPU: poiché la CPU è comprimibile, un limit per lo più rallenta il pod che lo possiede e fa poco per proteggere i vicini (il peso delle request lo fa già). Molti team impostano le CPU request e omettono i limit di CPU sui servizi sensibili alla latenza, per evitare il throttling. Meglio testarlo sui propri workloads, invece di trattarlo come una regola assoluta.
Un'insidia da conoscere: se si imposta un limit ma nessuna request, Kubernetes copia il limit e lo usa come request. Non è sempre ciò che si vuole, quindi meglio impostarli entrambi in modo esplicito.
b. Porre un tetto a ogni namespace con le resource quota
Request e limit funzionano a livello di singolo pod. Una ResourceQuota funziona a livello di namespace: impone un tetto rigido al totale di CPU, memoria e numero di oggetti che un namespace può usare, così un solo team non può prendersi l'intero cluster.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"La quota viene applicata in fase di admission. Se un nuovo pod facesse superare il tetto al namespace, l'API server lo rifiuta. I pod già in esecuzione non vengono toccati.
Una volta che un namespace ha una quota di compute, ogni pod al suo interno deve impostare le request e i limit corrispondenti, altrimenti viene rifiutato. Sembra rigido, ma è proprio questo il punto: obbliga ogni pod a dichiarare ciò di cui ha bisogno, che è esattamente ciò che ferma i noisy neighbor.
Per rendere tutto indolore, conviene abbinare la quota a un LimitRange. Un LimitRange svolge due compiti utili in un namespace: imposta request e limit di default che vengono iniettati in qualsiasi pod che si sia dimenticato di definirli, e stabilisce un minimo e un massimo per container, così nessun singolo pod può chiedere una fetta gigantesca. La quota fissa il budget del namespace; il LimitRange impedisce a un solo pod di accaparrarselo tutto e inserisce valori di default ragionevoli.
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
In un namespace con una ResourceQuota, aumentare le request di un workload incide sul budget del namespace, quindi un ottimizzatore deve evitare di sforare la quota. Il supporto alle ResourceQuota in modalità Full di PerfectScale rende il right-sizing consapevole delle quote: aumenta request e limit di un workload fino allo spazio che la quota consente ancora, così i namespace governati da quote vengono dimensionati correttamente come tutti gli altri, invece di restare sottodimensionati per stare prudentemente sotto il tetto.
Vuole vederlo su un cluster reale, non solo sulla pagina? Partecipi al nostro webinar sulla multitenancy il 29 settembre. Riservi il suo posto.
c. Fare right-sizing in base all'utilizzo reale
Quote e limit aiutano solo se i numeri sono giusti. I valori impostati una volta e poi dimenticati di solito sono sbagliati, e sbagliati in entrambe le direzioni.
Request troppo alte riservano capacità che nessuno usa. Lo scheduler pensa che il nodo sia pieno, quindi distribuisce i pod su più nodi del necessario, e i costi salgono. Request troppo basse creano il problema opposto: con una CPU request insufficiente il pod resta a corto di CPU quando il nodo è occupato; con troppa poca memoria il pod supera la sua request, il che lo porta in cima alla lista dei candidati all'eviction quando il nodo resta a corto di memoria. In entrambi i casi si torna al problema del noisy neighbor.
Fare right-sizing significa impostare request e limit in linea con ciò che il workload usa davvero. PerfectScale fa esattamente questo: confronta ciò che ogni workload richiede con ciò che usa effettivamente e fornisce il valore da impostare, workload per workload. Ma impostarlo una volta è la parte facile. La parte difficile è mantenere i numeri corretti man mano che il workload cambia.
d. Automatizzare, perché i workloads cambiano
Il right-sizing non è un'attività una tantum. Il traffico cambia, le funzionalità vengono rilasciate e una nuova release può cambiare quanta memoria o CPU serve a un servizio. I valori messi a punto il mese scorso possono essere sbagliati oggi, e le request obsolete sono il modo in cui un workload torna silenziosamente a essere un noisy neighbor.
Farlo a mano su centinaia di workloads non scala, ed è così noioso che prima o poi si smette di farlo. La risposta praticabile è l'automazione, che è ciò che fa PerfectScale: continua a osservare l'utilizzo reale e mantiene corrette le request e i limit di ogni workload man mano che evolve, invece di lasciare il compito a un foglio di calcolo che qualcuno aggiorna una volta a trimestre. Questo è l'aspetto legato all'affidabilità: l'isolamento regge solo se i numeri restano giusti, e i numeri restano giusti solo se qualcosa li mantiene tali.
e. Ottenere visibilità su chi sta usando cosa
Non si può correggere un noisy neighbor che non si vede. Quando un nodo è sotto pressione, o un namespace ha superato la sua quota, la prima domanda è sempre "quale workload, e quale team?". Senza un dettaglio dell'utilizzo per namespace e per team, si va a tentativi.
Visibilità significa poter rispondere rapidamente a queste domande: quali workloads stanno usando più delle loro request, quali namespace sono vicini alla loro quota e quanto ogni team sta effettivamente consumando e spendendo.
È qui che entra in gioco Attribute™ by DoiT. Osserva il consumo reale a runtime e lo riconduce al workload e al team che lo hanno generato, senza bisogno di alcun progetto di tagging. Così, invece di andare a tentativi, può vedere esattamente quale workload è il noisy neighbor, cosa usa davvero ogni team e quanto costa.
Cosa request e quote non coprono
Bisogna essere onesti su cosa resta fuori: request, limit, quote e LimitRange coprono CPU e memoria. Non risolvono direttamente ogni tipo di noisy neighbor.
L'I/O su disco e la larghezza di banda di rete non sono pienamente controllati da queste impostazioni. Un pod che usa troppo disco o troppa banda di rete può comunque rallentare gli altri pod sullo stesso nodo. Per gestirlo servono strumenti diversi, come node pool separati per i workloads pesanti, controlli sull'I/O a livello di storage e traffic shaping tramite la CNI. L'uso del disco locale può essere gestito in parte con request e limit su ephemeral-storage, ma questi non controllano la velocità né il throughput del disco.
Il punto non è che questi strumenti siano deboli. È che "noisy neighbor" copre più di CPU e memoria, e una soluzione completa deve tenere conto anche delle altre risorse.
Mantenere i workloads in salute con PerfectScale by DoiT
Il problema del noisy neighbor si riduce a due condizioni che devono valere allo stesso tempo: ogni workload dichiara ciò di cui ha bisogno, e quei numeri restano corretti man mano che i workloads cambiano. Farlo a mano su un cluster reale non regge.
PerfectScale by DoiT è una piattaforma di ottimizzazione per Kubernetes che mette la resilienza al primo posto: monitora continuamente i suoi workloads alla ricerca di rischi legati alle risorse (OOM kill, throttling della CPU ed eviction) e li trasforma in raccomandazioni di right-sizing applicabili manualmente o in modo autonomo. Mantiene request e limit allineati all'utilizzo reale man mano che i workloads evolvono, così un tenant non cresce silenziosamente fino a diventare un problema per tutti gli altri, e offre la visibilità per namespace e per team necessaria per vedere esattamente chi sta usando cosa. Team come Paramount Pictures e Creditas lo utilizzano per mantenere i cluster efficienti e affidabili allo stesso tempo.
Si registri o prenoti una sessione tecnica per vederlo in azione sul suo cluster.
Un'ultima cosa prima di salutarci: il nostro webinar sulla multitenancy si terrà il 29 settembre. Lo stesso problema di questo articolo, ma dal vivo su un cluster reale, con risposte alle sue domande. [Riservi il suo posto]