


Kubernetesにおけるノイジーネイバー問題とは、共有ノード上の1つのワークロードがCPU、メモリ、ディスク、ネットワークを公平な取り分以上に使用し、同じノードで動く他のワークロードのリソースを枯渇させたり、動作を遅くしたりする現象です。これはマルチテナンシーの副作用です。多くのアプリやチームを同じクラスタに詰め込んだ瞬間、それらは同じノードリソースを奪い合うようになります。
これが重要なのは、Kubernetesがコスト削減のために意図的にPodを詰め込んで配置するからです。この詰め込みこそが、行儀の悪い1つのPodが周囲のPodに悪影響を与える原因にもなります。幸い、Kubernetesにはこれを防ぐための制御の仕組みが用意されています。本記事では、この問題の実態、想像以上に深刻な理由、そして解決するための設定と運用習慣を解説します。
Kubernetesのノイジーネイバー問題とは?
Kubernetesのノードには、決まった量のCPUとメモリがあります。そのノードにスケジュールされたすべてのPodは、同じプールからリソースを消費します。1つのPodが本来使うべき量をはるかに超えて使うと、そのノード上の他のPodに残る分が少なくなります。これがノイジーネイバー問題です。
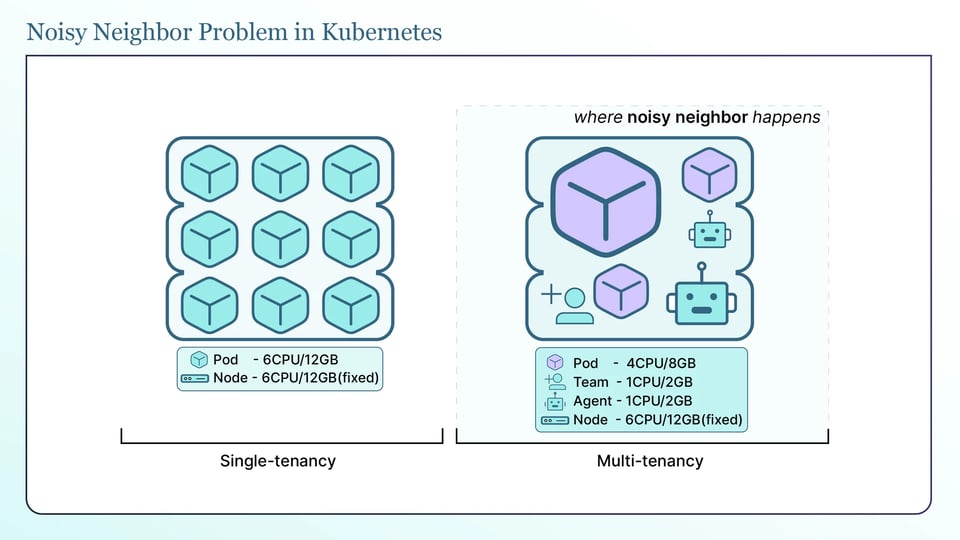
これがマルチテナンシーの副産物と呼ばれるのは、共有したときにだけ現れるからです。複数のチームが決まった数のノードを持つクラスタを共有すると、1つのチームが公平な取り分以上を使ってしまうことがあります。ノードごとに1つのアプリしか動かないシングルテナントのクラスタでは、この問題はほとんど発生しません。多くのチーム、多くのnamespace、そして高密度なビンパッキングを行う共有クラスタでは、常に発生します。
あるPodが別のPodに悪影響を与える理由を理解するには、KubernetesがCPUとメモリをどのように割り当てるかを知る必要があります。この2つの挙動は大きく異なります。
CPUは圧縮可能なリソースです。 Podが空き以上のCPUを要求しても、カーネルは待たせるだけです。クラッシュは起きません。CPU limitを設定すると、Kubernetesはスロットリングによってそれを強制します。カーネルはコンテナをlimitで頭打ちにし、それを超えることはできません。ノード全体が混雑しているとき、KubernetesはCPU時間を各PodのCPU request に比例して分配します。つまり、きちんとrequestを宣言したPodは自分の取り分を確保し続けられますが、何も宣言していないPodは枯渇する可能性があります。
メモリは圧縮不可能なリソースです。 すでに必要としているメモリをプロセスに「待たせる」ことはできません。コンテナがmemory limitを超えると、カーネルはOOM(メモリ不足) killでそれを強制終了します。そしてノード全体のメモリが不足しても、Kubernetesは誰かに丁寧に減速をお願いしたりはしません。Podの削除を始めます。ここで本当の被害が発生します。
ノイジーネイバーは本質的にマルチテナンシーの問題であり、クラスタを共有するチームが増えるほど深刻になります。まさにこのテーマを、9月29日に実際のクラスタを使ってライブで解説します。参加登録する
ノイジーネイバー問題が重要な理由
意外なのは、被害を受けるのが誰かという点です。多くの場合、リソースを貪ったPodではありません。
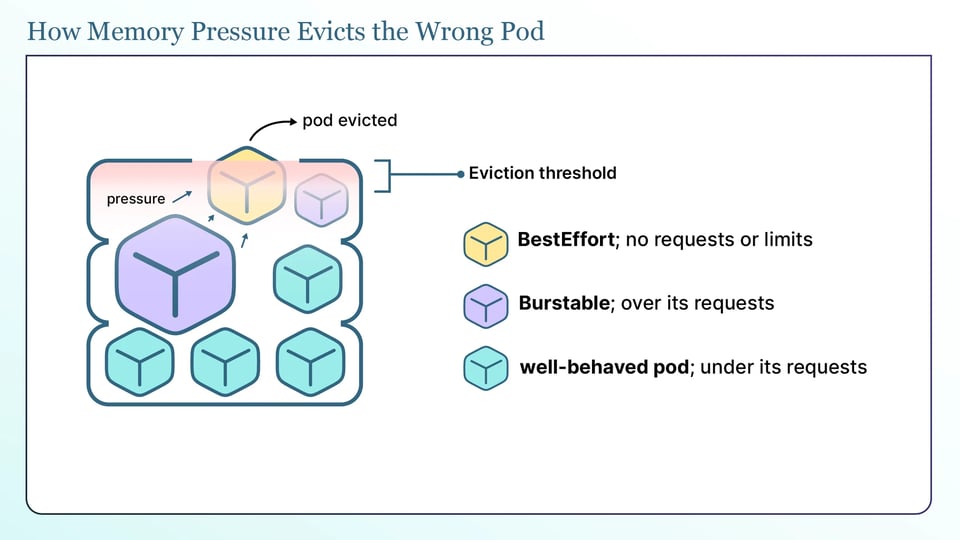
ノードのメモリが不足すると、kubeletが介入し、メモリを解放するためにPodのエビクションを始めます。これはノードレベルのアクションです。kubeletは memory.available のようなノードのシグナルを監視し、エビクションのしきい値を超えると、削除するPodを選びます。
どのように選ぶのでしょうか。「どれがノイジーなPodか」ではありません。kubeletは、使用量がrequestsを超えているかどうか、次にPodの優先度でPodをランク付けします。requestsの範囲内に収まっているPodは最後にエビクトされます。requestsを超えているPodは、圧迫の原因でなくても候補になります。
ここで、最も弱いrequestsを設定した人が割を食うことになります。ノードのメモリが不足したとき、kubeletは圧迫の原因となったPodをエビクトするのではなく、最も保護されていないPodから先にエビクトします。requestsもlimitsも設定していないPod(BestEffort)が最初で、次にrequestsを超えて使用しているPodです。requestsの範囲内に収まっているPodとGuaranteedのPodは最後にエビクトされます。つまり、設定をシンプルに保つためだけにrequestsを設定しなかった小さなワークロードは、何も悪いことをしていないのに、他のワークロードがノードを埋めた瞬間に真っ先にkillされる可能性があります。requestsを省略したPodが、他人が生み出した圧迫のツケを払うのです。
知っておくべきエビクションの挙動が、さらに2つあります。
GuaranteedのPodはエビクションからは保護されますが、OOM killerからは保護されません。すべてのコンテナでrequestsとlimitsが等しいPodはGuaranteedのQoS(サービス品質)クラスとなり、kubeletは最後にエビクトします。しかし、そのPod自身がmemory limitに達すると、カーネルのOOM killerは発動してコンテナをkillします。Guaranteedが守ってくれるのはノードレベルのエビクションからであって、自分自身のlimitからではありません。
CPUのノイズで主に被害を受けるのは、requestsを省略したPodです。CPUはrequestの重みで分配されるため、適切なCPU requestを持つPodは、ノードが高負荷でも自分の取り分を維持します。苦しむのは、CPU requestをまったく設定していないPodです。残り物しかもらえず、高負荷時にはほとんどゼロになることもあります。
つまり、ノイジーネイバー問題のコストは、Podが遅くなるだけではありません。何も悪くないワークロードに降りかかるエビクションやOOM kill、requestsを省略したサービスのレイテンシ急上昇、そしてSLOを壊す再起動です。しかもデバッグが難しいのは、症状が原因側ではなく被害者側に現れるからです。
Kubernetesでノイジーネイバー問題を防ぐ方法
解決策は、連携して機能するいくつかのレイヤーです。requestsとlimitsを設定し、クォータでnamespaceに上限を設け、値をライトサイジングし、そのライトサイジングを自動化し、誰が何を使っているかを可視化します。
a. リソースのrequestsとlimitsを設定する
これがすべての土台です。他のすべてはこの上に成り立ちます。
requestはPodが予約する量です。スケジューラはrequestを使ってノードを選び、kubeletはコンテナのために最低でもその分を確保します。limitはPodが超えられない上限です。それぞれが実際に何をするのかを整理します。
| 設定 | 制御する内容 | 到達時の挙動 |
|---|---|---|
| CPU request | CPUを予約し、ノードが混雑しているときのPodの取り分を決める | CPUに空きがあれば、Podはそれ以上使える |
| CPU limit | CPUの上限を設定する | 上限でスロットリングされるが、killされることはない |
| Memory request | メモリを予約し、スケジューリングとエビクションの順位を決める | メモリに空きがあれば、Podはそれ以上使える |
| Memory limit | メモリの上限を設定する | 超えるとOOM killされる |
CPUとメモリの挙動から、2つの実践的なルールが導かれます。
メモリについては、必ずrequestを設定し、limitを同じ値にしてください。そうすればPodは予約した以上を使えないため、ノードを圧迫状態に追い込むPodにはならず、エビクトされるのも最後になります。(すべてのコンテナでCPUとメモリのrequestsをlimitsと等しく設定すると、Pod全体がGuaranteedクラスという最も強い保護を得られますが、それはCPU limitsも設定することを意味し、下記のCPUルールにあるスロットリングとのトレードオフが生じます。)memory limitの欠如こそ、1つのPodがノード全体を食い尽くす原因です。
CPUについては、必ずrequestを設定し、高負荷時にもPodが取り分を維持できるようにしてください。CPU limitsには注意が必要です。CPUは圧縮可能なため、limitは主にそれを設定したPod自身をスロットリングするだけで、隣人の保護にはほとんど寄与しません(それはrequestの重みがすでに担っています)。多くのチームは、レイテンシに敏感なサービスではスロットリングを避けるためにCPU requestsを設定し、CPU limitsを省略しています。これをルールとして鵜呑みにせず、ご自身のワークロードでテストしてください。
知っておくべき落とし穴が1つあります。limitだけ設定してrequestを設定しない場合、Kubernetesはlimitの値をコピーしてrequestとして使います。これは常に望ましいとは限らないため、両方を意図的に設定してください。
b. ResourceQuotaで各namespaceに上限を設ける
requestsとlimitsはPod単位で機能します。ResourceQuotaはnamespace単位で機能します。namespaceが使用できるCPU、メモリ、オブジェクト数の合計にハードリミットを設定するため、1つのチームがクラスタ全体を占有することを防げます。
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"クォータはアドミッション時に適用されます。新しいPodによってnamespaceが上限を超える場合、APIサーバーはそれを拒否します。すでに実行中のPodには影響しません。
namespaceにコンピュートクォータが設定されると、その中のすべてのPodは対応するrequestsとlimitsを設定しなければならず、設定しないPodは拒否されます。厳しく聞こえますが、それこそが狙いです。すべてのPodに必要量の宣言を強制することが、まさにノイジーネイバーを防ぐのです。
この運用を負担なく回すには、クォータとLimitRangeを組み合わせます。LimitRangeはnamespace内で2つの有用な役割を果たします。設定を忘れたPodに注入されるデフォルトのrequestsとlimitsを定めることと、コンテナごとの最小値と最大値を設定して、1つのPodが巨大な取り分を要求できないようにすることです。クォータがnamespaceの予算を定め、LimitRangeが1つのPodによる独占を防ぎ、妥当なデフォルト値を補ってくれます。
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
ResourceQuotaのあるnamespaceでは、ワークロードのrequestsを引き上げるとnamespaceの予算にカウントされるため、最適化ツールはクォータの超過を避けなければなりません。PerfectScaleのFullモードによるResourceQuotaサポートは、ライトサイジングをクォータ対応にします。クォータの残り枠の範囲内でワークロードのrequestsとlimitsを引き上げるため、クォータで管理されたnamespaceも、上限を安全に下回るために過小プロビジョニングのまま放置されるのではなく、他のnamespaceと同じようにライトサイジングされます。
この内容を、記事の上だけでなく実際のクラスタで見てみませんか?9月29日開催のマルチテナンシーウェビナーにご参加ください。参加登録する
c. 実際の使用量に合わせてライトサイジングする
クォータとlimitsが役立つのは、数値が正しいときだけです。一度設定して忘れられた値は、たいてい間違っており、しかも両方向に間違っています。
requestsを高く設定しすぎると、誰も使わない容量を予約することになります。スケジューラはノードが満杯だと判断するため、必要以上のノードにPodを分散させ、請求額が膨らみます。低く設定しすぎると逆の問題が起きます。CPU requestが少なすぎると、ノードが混雑したときにPodがCPU不足に陥ります。メモリが少なすぎると、Podがrequestを超過し、ノードのメモリが不足したときにエビクション候補の上位に押し上げられます。どちらにしても、ノイジーネイバー問題に逆戻りです。
ライトサイジングとは、ワークロードが実際に使用する量に合わせてrequestsとlimitsを設定することです。PerfectScaleはまさにこれを行います。各ワークロードのrequestと実際の使用量を比較し、ワークロードごとに設定すべき数値を提示します。ただし、一度設定するのは簡単な部分です。難しいのは、ワークロードの変化に合わせて数値を正しく保ち続けることです。
d. ワークロードは変化する。だから自動化する
ライトサイジングは一度きりの作業ではありません。トラフィックは変化し、機能はリリースされ、新しいリリースによってサービスが必要とするメモリやCPUの量は変わります。先月チューニングした値は今日には間違っているかもしれず、古くなったrequestsこそが、ワークロードが静かに再びノイジーネイバーへと変わっていく原因です。
これを数百のワークロードにわたって手作業で行うのはスケールしませんし、退屈すぎていずれ誰もやらなくなります。現実的な答えは自動化であり、それがPerfectScaleの役割です。実際の使用量を監視し続け、変化に合わせて各ワークロードのrequestsとlimitsを正しく保ちます。誰かが四半期に一度更新するスプレッドシートに任せるのではありません。これは信頼性の話でもあります。分離が機能するのは数値が正しい間だけであり、数値を正しく保つには、それを維持し続ける仕組みが必要なのです。
e. 誰が何を使っているかを可視化する
見えないノイジーネイバーは直せません。ノードが圧迫されているとき、あるいはnamespaceがクォータを超えているとき、最初の質問は常に「どのワークロードか、どのチームか」です。namespace別・チーム別の使用量が把握できていなければ、推測するしかありません。
可視化とは、次の問いにすぐ答えられる状態を指します。どのワークロードがrequests以上を使っているか、どのnamespaceがクォータに近づいているか、そして各チームが実際にどれだけ使い、どれだけコストをかけているか。
ここで役立つのが、DoiTのAttribute™です。実行時の実際の消費量を監視し、それを引き起こしたワークロードとチームにマッピングします。タグ付けプロジェクトは不要です。推測する代わりに、どのワークロードがノイジーネイバーなのか、そして各チームが実際に何を使いいくらコストをかけているのかを正確に把握できます。
requestsとクォータでカバーできないもの
限界についても正直に述べておきます。requests、limits、クォータ、LimitRangeがカバーするのはCPUとメモリです。あらゆる種類のノイジーネイバーを直接解決するわけではありません。
ディスクI/Oとネットワーク帯域は、これらの設定では完全には制御できません。ディスクやネットワーク帯域を使いすぎるPodは、依然として同じノード上の他のPodを遅くする可能性があります。これに対処するには別のツールが必要です。たとえば、重いワークロード向けの専用ノードプール、ストレージレベルのI/O制御、CNIによるネットワークシェーピングなどです。ローカルディスクの使用量は ephemeral-storage のrequestsとlimitsである程度管理できますが、ディスクの速度やスループットは制御できません。
ここでの教訓は、これらのツールが弱いということではありません。「ノイジーネイバー」はCPUとメモリにとどまらない問題であり、完全な答えには他のリソースへの対策も含まれる、ということです。
PerfectScale by DoiTでワークロードを健全に保つ
ノイジーネイバー問題は、突き詰めれば2つの条件を同時に満たせるかどうかです。すべてのワークロードが必要量を宣言していること、そしてワークロードの変化に合わせてその数値が正しくあり続けることです。実運用のクラスタでこれを手作業で行うのは現実的ではありません。
PerfectScale by DoiTは、レジリエンシーを最優先に設計されたKubernetes最適化プラットフォームです。ワークロードをリソース起因のリスク(OOM kill、CPUスロットリング、エビクション)について監視し続け、それを手動でも自律的にも適用できるライトサイジングの推奨に変換します。ワークロードの変化に合わせてrequestsとlimitsを実際の使用量に一致させ続けるため、1つのテナントが気づかぬうちに全員の問題へと育つことがなく、namespace別・チーム別の可視性によって誰が何を使っているかを正確に把握できます。Paramount PicturesやCreditasのようなチームが、クラスタの効率と信頼性の両立のために利用しています。
サインアップするか、テクニカルセッションを予約して、ご自身のクラスタでお試しください。
最後にもう1つ。マルチテナンシーウェビナーを9月29日に開催します。本記事と同じ問題を、実際のクラスタ上でライブでお見せし、皆様のご質問にもお答えします。[参加登録する]