


Das Noisy-Neighbor-Problem in Kubernetes entsteht, wenn ein Workload auf einem geteilten Node mehr als seinen fairen Anteil an CPU, Arbeitsspeicher, Festplatte oder Netzwerk beansprucht und damit die anderen Workloads auf demselben Node ausbremst oder aushungert. Es ist ein Nebeneffekt von Multitenancy: Sobald viele Apps oder Teams auf demselben Cluster laufen, konkurrieren sie um dieselben Node-Ressourcen.
Das ist wichtig, weil Kubernetes Pods bewusst dicht packt, um Kosten zu sparen. Genau dieses dichte Packen ermöglicht es aber auch, dass ein einzelner Pod, der sich schlecht verhält, seinen Nachbarn schadet. Die gute Nachricht: Kubernetes gibt Ihnen die nötigen Stellschrauben an die Hand. Dieser Artikel erklärt, worin das Problem tatsächlich besteht, warum es mehr Schaden anrichtet als erwartet, und mit welchen Einstellungen und Gewohnheiten Sie es beheben.
Was ist das Noisy-Neighbor-Problem in Kubernetes?
Ein Kubernetes-Node hat eine feste Menge an CPU und Arbeitsspeicher. Jeder Pod, der auf diesem Node eingeplant wird, schöpft aus demselben Pool. Nutzt ein Pod deutlich mehr, als er sollte, bleibt für alle anderen auf dem Node weniger übrig. Das ist das Noisy-Neighbor-Problem.
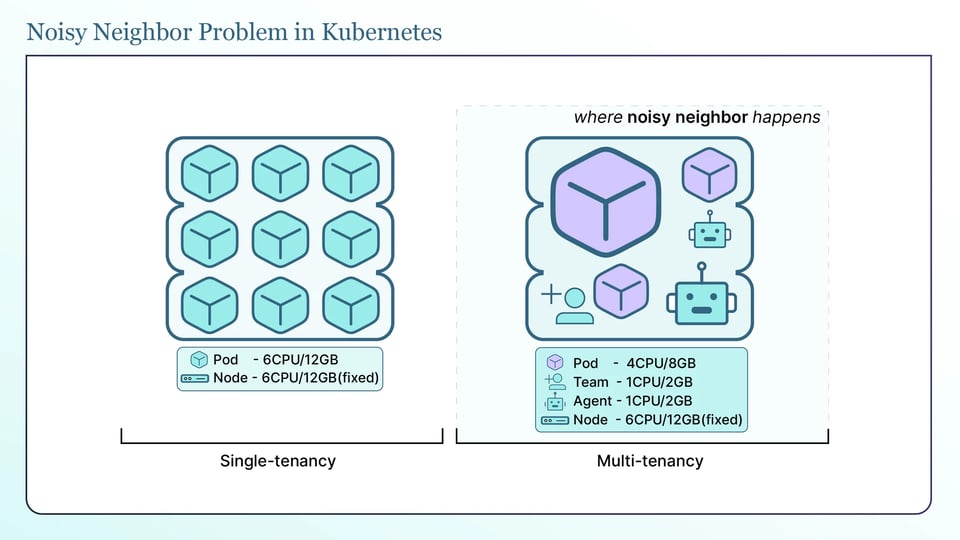
Man nennt es ein Nebenprodukt der Multitenancy, weil es nur auftritt, wenn geteilt wird. Wenn sich mehrere Teams einen Cluster mit einer festen Anzahl von Nodes teilen, kann ein Team mehr als seinen fairen Anteil beanspruchen. Ein Single-Tenant-Cluster mit einer App pro Node hat dieses Problem selten. Ein geteilter Cluster mit vielen Teams, vielen Namespaces und engem Bin-Packing hat es ständig.
Um zu verstehen, warum ein Pod einem anderen schaden kann, müssen Sie wissen, wie Kubernetes CPU und Arbeitsspeicher verteilt. Die beiden verhalten sich sehr unterschiedlich:
CPU ist komprimierbar. Will ein Pod mehr CPU, als frei ist, lässt ihn der Kernel einfach warten. Nichts stürzt ab. Wenn Sie ein CPU-Limit setzen, erzwingt Kubernetes es per Throttling: Der Kernel deckelt den Container bei seinem Limit, darüber hinaus geht nichts. Ist der gesamte Node ausgelastet, verteilt Kubernetes die CPU-Zeit proportional zum CPU-Request jedes Pods. Ein Pod mit einem realistischen Request bekommt also weiterhin seinen Anteil, während ein Pod ohne Angaben leer ausgehen kann.
Arbeitsspeicher ist nicht komprimierbar. Sie können einen Prozess nicht auf Speicher "warten" lassen, den er bereits braucht. Überschreitet ein Container sein Memory-Limit, beendet ihn der Kernel mit einem OOM (out of memory) Kill. Und wenn dem gesamten Node der Speicher ausgeht, bittet Kubernetes niemanden höflich, langsamer zu machen – es beginnt, Pods zu entfernen. Genau hier entsteht der eigentliche Schaden.
Noisy Neighbors sind im Kern ein Multitenancy-Problem, und es wird umso größer, je mehr Teams sich einen Cluster teilen. Genau das zeigen wir am 29. September live auf einem echten Cluster. Sichern Sie sich Ihren Platz.
Warum das Noisy-Neighbor-Problem so schwer wiegt
Das Überraschende ist, wen es trifft. Oft ist es nicht der gierige Pod.
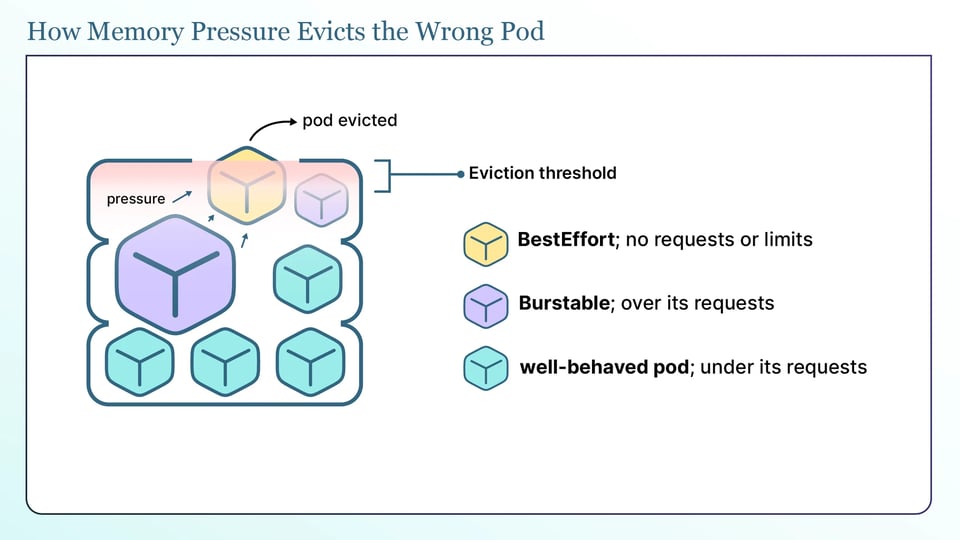
Wenn einem Node der Arbeitsspeicher knapp wird, greift das Kubelet ein und beginnt, Pods zu evicten, um Speicher freizugeben. Das passiert auf Node-Ebene. Das Kubelet beobachtet ein Node-Signal wie memory.available, und sobald der Eviction-Schwellenwert überschritten wird, wählt es Pods zum Entfernen aus.
Und wie wählt es aus? Nicht danach, "wer der Störenfried ist". Das Kubelet sortiert Pods danach, ob ihre Nutzung über ihren Requests liegt, und anschließend nach Pod-Priorität. Ein Pod, der unter seinen Requests bleibt, wird zuletzt evicted. Ein Pod, der über seinen Requests liegt, ist ein Kandidat – selbst wenn er den Druck gar nicht verursacht hat.
Genau hier trifft es denjenigen, der die schwächsten Requests gesetzt hat. Wird der Speicher auf dem Node knapp, evicted das Kubelet nicht den Pod, der den Druck verursacht hat. Es entfernt zuerst die am schlechtesten geschützten Pods: Pods ohne Requests oder Limits (BestEffort) fliegen zuerst, dann Pods, die mehr nutzen, als sie angefordert haben. Pods, die innerhalb ihrer Requests bleiben, und Guaranteed-Pods werden zuletzt evicted. Ein kleiner Workload, der keine Requests gesetzt hat – nur um seine Konfiguration einfach zu halten – kann also als Erster beendet werden, sobald ein anderer Workload den Node füllt, obwohl er nichts falsch gemacht hat. Der Pod, der seine Requests ausgelassen hat, zahlt für den Druck, den jemand anderes erzeugt hat.
Zwei weitere Eviction-Verhaltensweisen sollten Sie kennen:
Guaranteed-Pods sind vor Eviction geschützt, aber nicht vor dem OOM-Killer: Ein Pod, bei dem jeder Container identische Requests und Limits hat, erhält die Quality-of-Service-Klasse Guaranteed, und das Kubelet evicted ihn zuletzt. Erreicht derselbe Pod jedoch sein eigenes Memory-Limit, schlägt der OOM-Killer des Kernels trotzdem zu und beendet den Container. Guaranteed schützt vor Eviction auf Node-Ebene, nicht vor dem eigenen Limit.
CPU-Noise trifft vor allem Pods ohne Requests: Weil CPU nach Request-Gewichtung geteilt wird, behält ein Pod mit einem ordentlichen CPU-Request seinen Anteil, selbst wenn der Node stark ausgelastet ist. Leidtragende sind die Pods, die gar keinen CPU-Request gesetzt haben. Sie bekommen, was übrig bleibt – und das kann unter Last fast nichts sein.
Die Kosten des Noisy-Neighbor-Problems sind also nicht nur ein langsamer Pod. Es sind Evictions und OOM-Kills, die Workloads treffen, die nichts falsch gemacht haben, Latenzspitzen bei Services, die ihre Requests ausgelassen haben, und Neustarts, die Ihre SLOs reißen. Und es ist schwer zu debuggen, weil das Symptom beim Opfer sichtbar wird, nicht bei der Ursache.
So verhindern Sie das Noisy-Neighbor-Problem in Kubernetes
Die Lösung besteht aus mehreren Ebenen, die zusammenspielen: Requests und Limits setzen, Namespaces per Quota deckeln, die Werte richtig dimensionieren, das Right-Sizing automatisieren und Transparenz darüber schaffen, wer was nutzt.
a. Resource Requests und Limits setzen
Das ist das Fundament. Alles Weitere baut darauf auf.
Ein Request ist das, was der Pod reserviert. Der Scheduler nutzt den Request, um einen Node auszuwählen, und das Kubelet hält mindestens diese Menge für den Container vor. Ein Limit ist die Obergrenze, die der Pod nicht überschreiten kann. Das bewirken die einzelnen Einstellungen:
| Einstellung | Was sie steuert | Was beim Erreichen passiert |
|---|---|---|
| CPU-Request | Reserviert CPU, bestimmt den Anteil des Pods bei ausgelastetem Node | Pod kann mehr nutzen, wenn CPU frei ist |
| CPU-Limit | Deckelt CPU | Beim Limit gedrosselt, nie beendet |
| Memory-Request | Reserviert Speicher, bestimmt Scheduling und Eviction-Reihenfolge | Pod kann mehr nutzen, wenn Speicher frei ist |
| Memory-Limit | Deckelt Speicher | OOM-Kill bei Überschreitung |
Aus dem Verhalten von CPU und Arbeitsspeicher folgen zwei praktische Regeln:
Für Arbeitsspeicher setzen Sie immer einen Request und ein Limit in gleicher Höhe. So kann der Pod nie mehr nutzen, als er reserviert hat – er wird also nicht der Pod sein, der den Node unter Druck setzt, und er wird zuletzt evicted. (Wenn Sie bei jedem Container CPU- und Memory-Requests gleich den Limits setzen, erhält der gesamte Pod die Guaranteed-Klasse, den stärksten Schutz. Das bedeutet allerdings auch CPU-Limits – mit dem Throttling-Kompromiss aus der CPU-Regel unten.) Ein fehlendes Memory-Limit ist der klassische Weg, wie ein Pod den ganzen Node frisst.
Für CPU setzen Sie immer einen Request, damit der Pod unter Last seinen Anteil behält. Bei CPU-Limits ist Vorsicht geboten: Weil CPU komprimierbar ist, drosselt ein Limit vor allem den Pod selbst und schützt die Nachbarn kaum (das erledigt bereits die Request-Gewichtung). Viele Teams setzen CPU-Requests und verzichten bei latenzsensiblen Services auf CPU-Limits, um Throttling zu vermeiden. Testen Sie das für Ihre eigenen Workloads, statt es als feste Regel zu behandeln.
Ein Stolperstein, den Sie kennen sollten: Wenn Sie ein Limit setzen, aber keinen Request, übernimmt Kubernetes das Limit als Request. Das ist nicht immer gewollt – setzen Sie also beides bewusst.
b. Jeden Namespace mit Resource Quotas deckeln
Requests und Limits wirken pro Pod. Eine ResourceQuota wirkt pro Namespace. Sie setzt eine harte Obergrenze für die gesamte CPU, den Arbeitsspeicher und die Objektanzahl eines Namespace, damit ein einzelnes Team nicht den ganzen Cluster beansprucht.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"Die Quota wird zum Admission-Zeitpunkt durchgesetzt. Würde ein neuer Pod den Namespace über die Obergrenze bringen, lehnt der API-Server ihn ab. Bereits laufende Pods bleiben unangetastet.
Sobald ein Namespace eine Compute-Quota hat, muss jeder Pod darin die entsprechenden Requests und Limits setzen, sonst wird er abgelehnt. Das klingt streng, ist aber genau der Sinn: Es zwingt jeden Pod, zu deklarieren, was er braucht – und genau das stoppt Noisy Neighbors.
Damit das reibungslos funktioniert, kombinieren Sie die Quota mit einer LimitRange. Eine LimitRange erledigt zwei nützliche Aufgaben in einem Namespace: Sie setzt Default-Requests und -Limits, die in jeden Pod injiziert werden, der sie vergessen hat, und sie definiert ein Minimum und Maximum pro Container, damit kein einzelner Pod ein riesiges Stück beanspruchen kann. Die Quota setzt das Namespace-Budget; die LimitRange verhindert, dass ein Pod alles an sich reißt, und ergänzt sinnvolle Defaults.
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
In einem Namespace mit ResourceQuota zählt jede Erhöhung der Requests eines Workloads gegen das Namespace-Budget – ein Optimierer muss also vermeiden, die Quota zu überschreiten. Die Full-Mode-ResourceQuota-Unterstützung von PerfectScale macht das Right-Sizing quota-aware: Sie hebt Requests und Limits eines Workloads nur so weit an, wie die Quota noch Spielraum lässt. Quota-gesteuerte Namespaces werden so genauso richtig dimensioniert wie alle anderen, statt aus Sicherheitsgründen dauerhaft unterversorgt zu bleiben.
Sie wollen das live auf einem echten Cluster sehen, nicht nur auf dem Papier? Nehmen Sie am 29. September an unserem Multitenancy-Webinar teil. Sichern Sie sich Ihren Platz.
c. Right-Sizing anhand der tatsächlichen Nutzung
Quotas und Limits helfen nur, wenn die Zahlen stimmen. Werte, die einmal gesetzt und dann vergessen werden, sind meist falsch – und zwar in beide Richtungen.
Setzen Sie Requests zu hoch, reservieren Sie Kapazität, die niemand nutzt. Der Scheduler hält den Node für voll, verteilt Pods also auf mehr Nodes als nötig, und Ihre Rechnung steigt. Setzen Sie sie zu niedrig, entsteht das gegenteilige Problem: Bei zu wenig CPU-Request geht der Pod bei ausgelastetem Node leer aus, bei zu wenig Speicher läuft er über seinen Request hinaus – und rückt in der Eviction-Reihenfolge nach vorne, sobald dem Node der Speicher knapp wird. In beiden Fällen sind Sie wieder beim Noisy-Neighbor-Problem.
Right-Sizing bedeutet, Requests und Limits an dem auszurichten, was der Workload tatsächlich nutzt. Genau das tut PerfectScale: Es vergleicht die Requests jedes Workloads mit der tatsächlichen Nutzung und liefert Ihnen den passenden Wert – pro Workload. Aber das einmalige Setzen ist der einfache Teil. Der schwierige Teil ist, die Zahlen aktuell zu halten, während sich der Workload verändert.
d. Automatisieren, denn Workloads ändern sich
Right-Sizing ist keine einmalige Aufgabe. Der Traffic ändert sich, Features werden ausgeliefert, und ein neues Release kann verändern, wie viel Speicher oder CPU ein Service braucht. Die Werte, die Sie letzten Monat feinjustiert haben, können heute falsch sein – und veraltete Requests sind der Weg, auf dem ein Workload unbemerkt wieder zum Noisy Neighbor wird.
Das manuell über hunderte Workloads hinweg zu erledigen, skaliert nicht – und ist so monoton, dass es irgendwann liegen bleibt. Die praktikable Antwort ist Automatisierung, und genau das leistet PerfectScale: Es beobachtet kontinuierlich die tatsächliche Nutzung und hält Requests und Limits jedes Workloads laufend aktuell, statt es einer Tabelle zu überlassen, die jemand einmal im Quartal pflegt. Das ist der Zuverlässigkeitsaspekt: Isolation hält nur, wenn die Zahlen stimmen – und die Zahlen stimmen nur, wenn etwas sie kontinuierlich nachführt.
e. Transparenz darüber schaffen, wer was nutzt
Einen Noisy Neighbor, den Sie nicht sehen, können Sie nicht beheben. Steht ein Node unter Druck oder überschreitet ein Namespace seine Quota, lautet die erste Frage immer: "Welcher Workload, und welches Team?" Ohne aufgeschlüsselte Nutzung pro Namespace und pro Team raten Sie nur.
Transparenz heißt, schnell beantworten zu können: Welche Workloads nutzen mehr als ihre Requests, welche Namespaces sind nahe an ihrer Quota, und wie viel nutzt und kostet jedes Team tatsächlich?
Genau hier hilft Attribute™ by DoiT. Es beobachtet den tatsächlichen Ressourcenverbrauch zur Laufzeit und ordnet ihn dem verursachenden Workload und Team zu – ganz ohne Tagging-Projekt. Statt zu raten, sehen Sie also genau, welcher Workload der Noisy Neighbor ist und was jedes Team tatsächlich nutzt und kostet.
Was Requests und Quotas nicht abdecken
Seien wir ehrlich, was die Grenzen angeht: Requests, Limits, Quotas und LimitRanges decken CPU und Arbeitsspeicher ab. Sie lösen nicht direkt jede Art von Noisy Neighbor.
Disk-I/O und Netzwerkbandbreite werden von diesen Einstellungen nicht vollständig kontrolliert. Ein Pod, der zu viel Festplatten- oder Netzwerkbandbreite nutzt, kann andere Pods auf demselben Node weiterhin ausbremsen. Dafür brauchen Sie andere Werkzeuge, etwa separate Node-Pools für ressourcenintensive Workloads, I/O-Kontrollen auf Storage-Ebene und Traffic-Shaping über Ihr CNI. Die lokale Festplattennutzung lässt sich mit ephemeral-storage-Requests und -Limits zum Teil steuern, aber Geschwindigkeit und Durchsatz der Festplatte kontrollieren sie nicht.
Die Erkenntnis ist nicht, dass diese Werkzeuge schwach sind. Sondern dass "Noisy Neighbor" mehr umfasst als CPU und Speicher – und eine vollständige Antwort auch die übrigen Ressourcen einplant.
Workloads gesund halten mit PerfectScale by DoiT
Das Noisy-Neighbor-Problem läuft darauf hinaus, dass zwei Dinge gleichzeitig gelten müssen: Jeder Workload deklariert, was er braucht, und diese Zahlen bleiben korrekt, während sich die Workloads verändern. Das über einen echten Cluster hinweg manuell zu leisten, lässt sich auf Dauer nicht durchhalten.
PerfectScale by DoiT ist eine Resiliency-First-Plattform für Kubernetes-Optimierung, die Ihre Workloads kontinuierlich auf ressourcenbedingte Risiken überwacht (OOM-Kills, CPU-Throttling und Eviction) und daraus Right-Sizing-Empfehlungen ableitet, die Sie manuell oder autonom anwenden können. Sie hält Requests und Limits an der tatsächlichen Nutzung ausgerichtet, während sich Ihre Workloads verändern – so wächst kein Tenant unbemerkt zum Problem aller anderen heran – und liefert Ihnen die Transparenz pro Namespace und pro Team, um genau zu sehen, wer was nutzt. Teams wie Paramount Pictures und Creditas setzen darauf, um ihre Cluster effizient und zuverlässig zugleich zu betreiben.
Registrieren Sie sich oder buchen Sie eine technische Session, um es auf Ihrem eigenen Cluster zu erleben.
Noch ein Hinweis zum Schluss: Unser Multitenancy-Webinar findet am 29. September statt. Dasselbe Thema wie in diesem Artikel, aber live auf einem echten Cluster – inklusive Antworten auf Ihre Fragen. [Sichern Sie sich Ihren Platz]