


Le problème du voisin bruyant (noisy neighbor) dans Kubernetes survient lorsqu'un workload sur un nœud partagé consomme plus que sa juste part de CPU, de mémoire, de disque ou de réseau, et prive de ressources ou ralentit les autres workloads qui tournent à ses côtés. C'est un effet secondaire de la multi-tenance : dès que vous regroupez de nombreuses applications ou équipes sur le même cluster, elles se mettent à se disputer les mêmes ressources de nœud.
C'est un enjeu important, car Kubernetes regroupe volontairement les pods pour réduire les coûts. Or c'est aussi ce regroupement qui permet à un pod au comportement excessif de pénaliser ceux qui l'entourent. La bonne nouvelle : Kubernetes vous donne les moyens d'y mettre fin. Cet article détaille en quoi consiste réellement le problème, pourquoi il fait plus de dégâts qu'on ne l'imagine, et les réglages et bonnes pratiques qui le corrigent.
Qu'est-ce que le problème du voisin bruyant dans Kubernetes ?
Un nœud Kubernetes dispose d'une quantité fixe de CPU et de mémoire. Chaque pod planifié sur ce nœud puise dans le même pool. Quand un pod consomme bien plus qu'il ne le devrait, il en reste moins pour tous les autres pods du nœud. C'est cela, le problème du voisin bruyant.
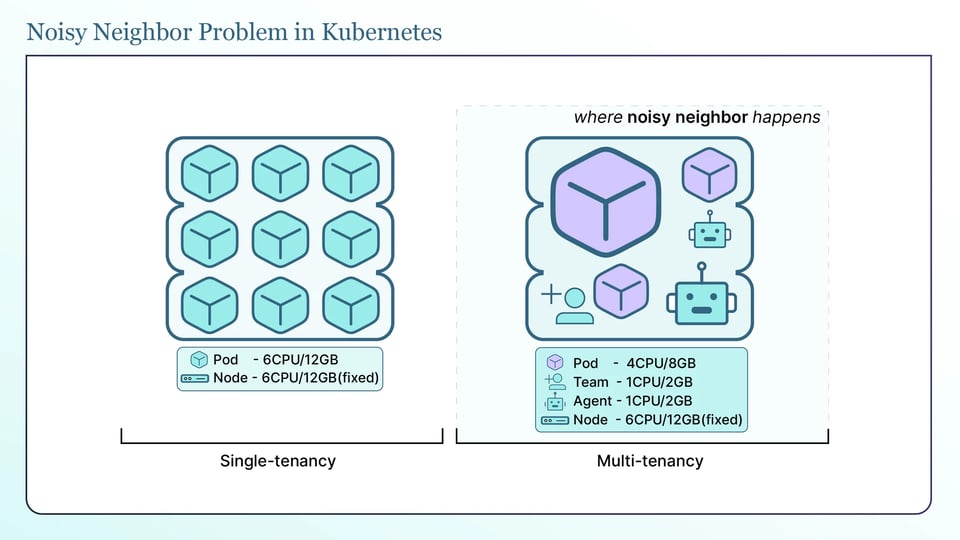
On parle de sous-produit de la multi-tenance, car il n'apparaît que lorsqu'on partage. Quand plusieurs équipes se partagent un cluster avec un nombre fixe de nœuds, l'une d'elles peut finir par consommer plus que sa juste part. Un cluster mono-tenant avec une application par nœud connaît rarement ce problème. Un cluster partagé avec de nombreuses équipes, de nombreux namespaces et un bin-packing serré le connaît en permanence.
Pour comprendre pourquoi un pod peut en pénaliser un autre, il faut savoir comment Kubernetes distribue le CPU et la mémoire. Les deux se comportent très différemment :
Le CPU est compressible. Si un pod veut plus de CPU qu'il n'y en a de disponible, le noyau le fait simplement patienter. Rien ne plante. Quand vous définissez une limite CPU, Kubernetes l'applique par throttling : le noyau plafonne le conteneur à sa limite, qu'il ne peut pas dépasser. Quand le nœud entier est saturé, Kubernetes répartit le temps CPU au prorata de la request CPU de chaque pod. Un pod qui a déclaré une request réaliste continue donc de recevoir sa part, tandis qu'un pod qui n'a rien déclaré peut se retrouver à sec.
La mémoire est incompressible. Impossible de faire patienter un processus pour de la mémoire dont il a déjà besoin. Si un conteneur dépasse sa limite mémoire, le noyau le tue via un OOM (out of memory) kill. Et si c'est le nœud entier qui manque de mémoire, Kubernetes ne demande poliment à personne de ralentir : il commence à supprimer des pods. C'est là que les vrais dégâts se produisent.
Les voisins bruyants sont avant tout un problème de multi-tenance, et il s'aggrave à mesure que les équipes se multiplient sur un même cluster. C'est exactement ce que nous traiterons en direct le 29 septembre, sur un vrai cluster. Réservez votre place.
L'impact réel du problème du voisin bruyant
Le plus surprenant, c'est de voir qui trinque. Ce n'est souvent pas le pod le plus gourmand.
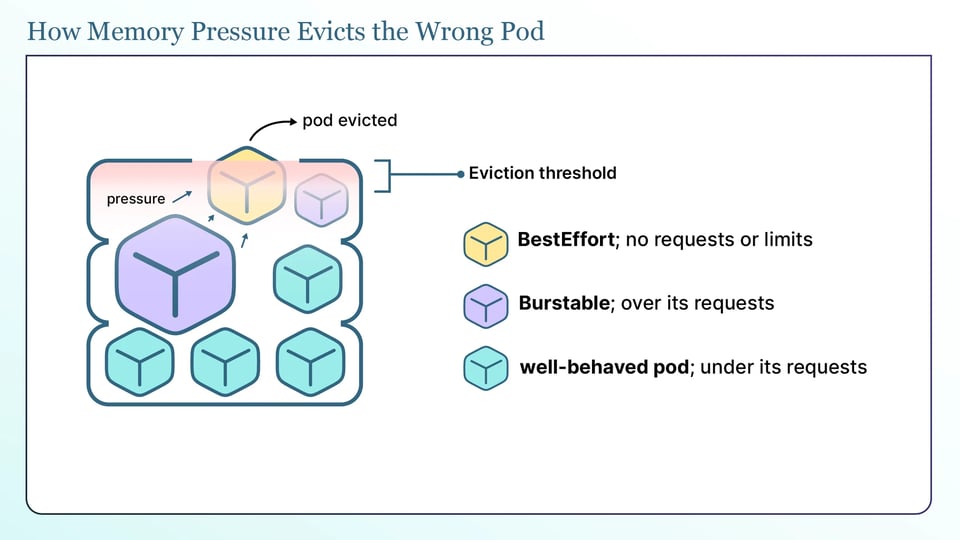
Quand un nœud manque de mémoire, le kubelet intervient et commence à évincer des pods pour libérer de la mémoire. C'est une action au niveau du nœud. Le kubelet surveille un signal du nœud comme memory.available et, dès que le seuil d'éviction est franchi, il choisit les pods à supprimer.
Comment choisit-il ? Pas en cherchant le pod bruyant. Le kubelet classe les pods selon que leur consommation dépasse ou non leurs requests, puis selon leur priorité. Un pod qui reste sous ses requests est évincé en dernier. Un pod qui dépasse ses requests est candidat, même s'il n'est pas à l'origine de la pression.
C'est là que ça tourne mal pour celui qui a défini les requests les plus faibles. Quand le nœud manque de mémoire, le kubelet n'évince pas le pod qui a créé la pression. Il évince d'abord les pods les moins protégés : les pods sans requests ni limits (BestEffort) partent en premier, suivis des pods qui consomment plus que ce qu'ils ont demandé. Les pods qui restent dans leurs requests, ainsi que les pods Guaranteed, sont évincés en dernier. Un petit workload qui n'a défini aucune request, juste pour garder une configuration simple, peut donc être le premier tué dès qu'un autre workload sature le nœud, alors qu'il n'a rien fait de mal. Le pod qui a fait l'impasse sur ses requests paie pour une pression créée par un autre.
Deux autres comportements d'éviction méritent d'être connus :
Les pods Guaranteed sont protégés de l'éviction, mais pas de l'OOM killer : un pod dont chaque conteneur a des requests et limits identiques obtient la classe de qualité de service Guaranteed, et le kubelet l'évince en dernier. Mais si ce même pod atteint sa propre limite mémoire, l'OOM killer du noyau se déclenche quand même et tue le conteneur. Guaranteed vous protège de l'éviction au niveau du nœud, pas de votre propre limite.
Le bruit CPU pénalise surtout les pods sans requests : comme le CPU est partagé au prorata des requests, un pod avec une request CPU correcte conserve sa part même quand le nœud est fortement sollicité. Ceux qui souffrent sont les pods qui n'ont défini aucune request CPU. Ils reçoivent ce qui reste, c'est-à-dire, sous charge, presque rien.
Le coût du problème du voisin bruyant ne se limite donc pas à un pod ralenti. Ce sont des évictions et des OOM kills qui frappent des workloads irréprochables, des pics de latence sur des services qui ont négligé leurs requests, et des redémarrages qui mettent à mal vos SLO. Et c'est difficile à déboguer, car le symptôme apparaît chez la victime, pas chez le coupable.
Comment prévenir le problème du voisin bruyant dans Kubernetes
La solution repose sur plusieurs couches complémentaires : définir des requests et des limits, plafonner les namespaces avec des quotas, ajuster les valeurs au plus juste, automatiser ce right-sizing, et obtenir de la visibilité sur qui consomme quoi.
a. Définir des requests et des limits
C'est le socle. Tout le reste repose dessus.
Une request est ce que le pod réserve. Le scheduler s'en sert pour choisir un nœud, et le kubelet garantit au moins cette quantité au conteneur. Une limit est le plafond que le pod ne peut pas dépasser. Voici ce que fait concrètement chaque réglage :
| Réglage | Ce qu'il contrôle | Ce qui se passe une fois atteint |
|---|---|---|
| Request CPU | Réserve du CPU, détermine la part du pod quand le nœud est saturé | Le pod peut consommer davantage si du CPU est libre |
| Limit CPU | Plafonne le CPU | Throttling à la limite, jamais tué |
| Request mémoire | Réserve de la mémoire, détermine le scheduling et l'ordre d'éviction | Le pod peut consommer davantage si de la mémoire est libre |
| Limit mémoire | Plafonne la mémoire | OOM kill en cas de dépassement |
Deux règles pratiques découlent du comportement du CPU et de la mémoire :
Pour la mémoire, définissez toujours une request, et fixez la limit au même niveau. Ainsi, le pod ne pourra jamais consommer plus que ce qu'il a réservé : il ne sera pas celui qui fait basculer le nœud sous pression, et il sera évincé en dernier. (Fixer des requests égales aux limits en CPU et en mémoire sur chaque conteneur donne au pod entier la classe Guaranteed, la protection la plus forte, mais cela implique aussi de définir des limits CPU, avec le compromis de throttling décrit dans la règle CPU ci-dessous.) Une limit mémoire manquante, c'est précisément ce qui permet à un pod de dévorer le nœud entier.
Pour le CPU, définissez toujours une request pour que le pod conserve sa part sous charge. Soyez prudent avec les limits CPU : le CPU étant compressible, une limit bride surtout le pod qui la porte et protège peu ses voisins (le prorata des requests s'en charge déjà). Beaucoup d'équipes définissent des requests CPU et omettent les limits CPU sur les services sensibles à la latence pour éviter le throttling. Testez cette approche sur vos propres workloads plutôt que d'en faire une règle absolue.
Un piège à connaître : si vous définissez une limit sans request, Kubernetes copie la limit et l'utilise comme request. Ce n'est pas toujours ce que vous voulez ; définissez donc les deux explicitement.
b. Plafonner chaque namespace avec des ResourceQuotas
Les requests et les limits agissent par pod. Un ResourceQuota agit par namespace. Il fixe un plafond strict sur le total de CPU, de mémoire et d'objets qu'un namespace peut consommer, pour qu'une équipe ne puisse pas accaparer tout le cluster.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"Le quota est appliqué au moment de l'admission. Si un nouveau pod devait faire dépasser le plafond du namespace, le serveur d'API le rejette. Les pods déjà en cours d'exécution ne sont pas touchés.
Dès qu'un namespace a un quota de calcul, chaque pod qu'il contient doit définir les requests et limits correspondantes, sous peine d'être rejeté. Cela peut sembler strict, mais c'est justement l'objectif : chaque pod est contraint de déclarer ce dont il a besoin, exactement ce qui stoppe les voisins bruyants.
Pour rendre cela indolore, associez le quota à un LimitRange. Un LimitRange remplit deux rôles utiles dans un namespace : il définit des requests et limits par défaut, injectées dans tout pod qui aurait oublié de les définir, et il fixe un minimum et un maximum par conteneur pour qu'aucun pod ne puisse réclamer une part démesurée. Le quota fixe le budget du namespace ; le LimitRange empêche un pod de tout accaparer et applique des valeurs par défaut raisonnables.
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
Dans un namespace doté d'un ResourceQuota, augmenter les requests d'un workload consomme le budget du namespace : un optimiseur doit donc éviter de dépasser le quota. La prise en charge des ResourceQuotas en mode Full de PerfectScale rend son right-sizing sensible aux quotas : il augmente les requests et limits d'un workload dans la marge que le quota autorise encore, si bien que les namespaces sous quota sont dimensionnés au plus juste comme les autres, au lieu de rester sous-provisionnés par prudence.
Envie de voir tout cela sur un cluster en direct, et pas seulement sur le papier ? Rejoignez notre webinaire sur la multi-tenance le 29 septembre. Réservez votre place.
c. Ajuster les valeurs à l'usage réel
Les quotas et les limits n'aident que si les chiffres sont justes. Des valeurs définies une fois puis oubliées sont généralement fausses, et fausses dans les deux sens.
Des requests trop élevées réservent de la capacité que personne n'utilise. Le scheduler croit le nœud plein, il répartit donc les pods sur plus de nœuds que nécessaire, et votre facture grimpe. Des requests trop basses créent le problème inverse : une request CPU insuffisante et le pod est privé de CPU quand le nœud est saturé ; une request mémoire insuffisante et le pod dépasse sa request, ce qui le rapproche du haut de la file d'éviction quand le nœud manque de mémoire. Dans les deux cas, vous retombez sur le problème du voisin bruyant.
Le right-sizing consiste à aligner les requests et les limits sur ce que le workload consomme réellement. C'est exactement ce que fait PerfectScale : il compare ce que chaque workload demande à ce qu'il utilise réellement, et vous donne la valeur à définir, workload par workload. Mais la définir une fois, c'est la partie facile. Le plus dur, c'est de garder des valeurs justes à mesure que le workload évolue.
d. Automatiser, parce que les workloads évoluent
Le right-sizing n'est pas une tâche ponctuelle. Le trafic évolue, des fonctionnalités sont livrées, et une nouvelle version peut changer les besoins en mémoire ou en CPU d'un service. Les valeurs ajustées le mois dernier peuvent être fausses aujourd'hui, et des requests obsolètes sont le chemin le plus court pour qu'un workload redevienne discrètement un voisin bruyant.
Faire cela à la main sur des centaines de workloads n'est pas tenable, et c'est suffisamment fastidieux pour finir par ne plus être fait. La réponse viable, c'est l'automatisation, et c'est ce que fait PerfectScale : il surveille en continu l'usage réel et maintient les requests et limits de chaque workload au bon niveau à mesure qu'il évolue, au lieu de s'en remettre à un tableur mis à jour une fois par trimestre. C'est tout l'enjeu de la fiabilité : l'isolation ne tient que si les chiffres restent justes, et les chiffres ne restent justes que si un mécanisme s'en charge.
e. Gagner en visibilité sur qui consomme quoi
Impossible de corriger un voisin bruyant qu'on ne voit pas. Quand un nœud est sous pression, ou qu'un namespace dépasse son quota, la première question est toujours la même : quel workload, et quelle équipe ? Sans ventilation de l'usage par namespace et par équipe, vous en êtes réduit à deviner.
La visibilité, c'est pouvoir répondre rapidement à ces questions : quels workloads consomment plus que leurs requests, quels namespaces approchent de leur quota, et combien chaque équipe consomme et coûte réellement.
C'est là qu'Attribute™ by DoiT entre en jeu. Il observe la consommation réelle à l'exécution et la relie au workload et à l'équipe qui l'ont générée, sans le moindre projet de tagging. Fini les suppositions : vous voyez exactement quel workload est le voisin bruyant, et ce que chaque équipe consomme et coûte réellement.
Ce que les requests et les quotas ne couvrent pas
Soyons honnêtes sur les limites de l'exercice : requests, limits, quotas et LimitRanges couvrent le CPU et la mémoire. Ils ne résolvent pas directement tous les types de voisins bruyants.
Les E/S disque et la bande passante réseau ne sont pas entièrement contrôlées par ces réglages. Un pod qui abuse du disque ou du réseau peut toujours ralentir les autres pods du même nœud. Il faut d'autres outils pour y répondre, comme des node pools séparés pour les workloads lourds, des contrôles d'E/S au niveau du stockage et du network shaping via votre CNI. L'usage du disque local peut être encadré dans une certaine mesure avec des requests et limits ephemeral-storage, mais celles-ci ne contrôlent ni la vitesse ni le débit du disque.
La conclusion n'est pas que ces outils sont faibles. C'est que le voisin bruyant dépasse le seul périmètre CPU et mémoire, et qu'une réponse complète anticipe aussi les autres ressources.
Des workloads sains avec PerfectScale by DoiT
Le problème du voisin bruyant se résume à deux conditions à réunir en même temps : chaque workload déclare ce dont il a besoin, et ces valeurs restent justes à mesure que les workloads évoluent. Y parvenir à la main sur un vrai cluster ne tient pas dans la durée.
PerfectScale by DoiT est une plateforme d'optimisation Kubernetes qui place la résilience au premier plan : elle surveille en continu vos workloads pour détecter les risques liés aux ressources (OOM kills, throttling CPU et évictions) et les transforme en recommandations de right-sizing applicables manuellement ou automatiquement. Elle maintient les requests et limits alignées sur l'usage réel à mesure que vos workloads évoluent, pour qu'aucun tenant ne devienne discrètement le problème de tous les autres, et vous donne la visibilité par namespace et par équipe pour savoir exactement qui consomme quoi. Des équipes comme Paramount Pictures et Creditas s'en servent pour garder des clusters à la fois efficaces et fiables.
Créez un compte ou réservez une session technique pour le voir sur votre propre cluster.
Avant de partir : notre webinaire sur la multi-tenance a lieu le 29 septembre. Le même sujet que cet article, mais en direct sur un vrai cluster, avec des réponses à vos questions. [Réservez votre place]