


O problema do vizinho barulhento no Kubernetes acontece quando um workload em um node compartilhado usa mais do que sua fatia justa de CPU, memória, disco ou rede e deixa os outros workloads rodando ao lado sem recursos ou mais lentos. É um efeito colateral da multitenancy: assim que você coloca muitos apps ou times no mesmo cluster, eles começam a competir pelos mesmos recursos do node.
Isso importa porque o Kubernetes agrupa pods de propósito para economizar dinheiro. Esse mesmo agrupamento é o que permite que um pod mal-comportado prejudique os que estão ao redor. A boa notícia é que o Kubernetes oferece os controles para impedir isso. Este artigo explica o que é o problema na prática, por que ele causa mais estrago do que se imagina e as configurações e hábitos que o resolvem.
O que é o problema do vizinho barulhento no Kubernetes?
Um node do Kubernetes tem uma quantidade fixa de CPU e memória. Todo pod agendado nesse node consome do mesmo pool. Quando um pod usa muito mais do que deveria, sobra menos para todos os outros naquele node. Esse é o problema do vizinho barulhento.
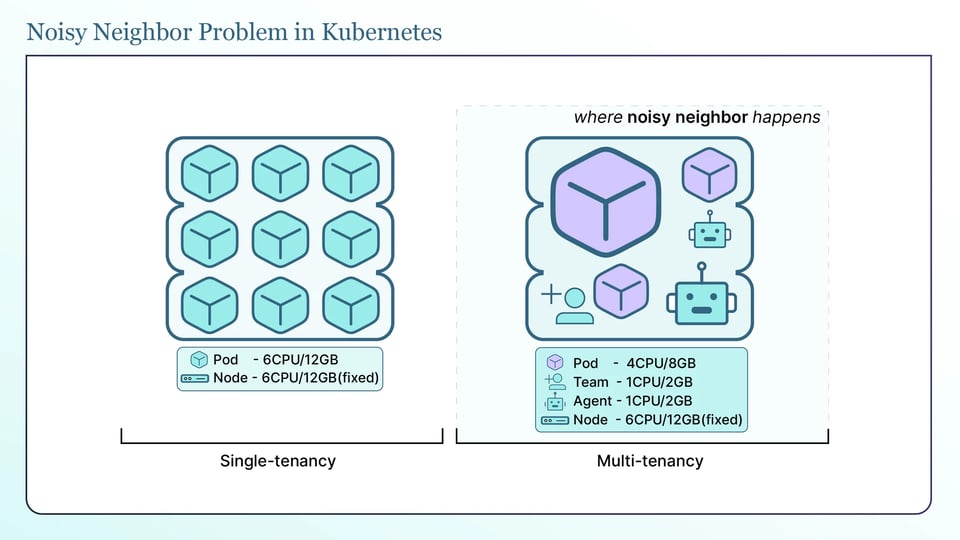
Ele é chamado de subproduto da multitenancy porque só aparece quando há compartilhamento. Quando vários times compartilham um cluster com um número fixo de nodes, um time pode acabar usando mais do que sua fatia justa. Um cluster single-tenant, com um app por node, raramente tem esse problema. Um cluster compartilhado, com muitos times, muitos namespaces e bin-packing agressivo, tem esse problema o tempo todo.
Para entender por que um pod pode prejudicar outro, você precisa saber como o Kubernetes distribui CPU e memória. Os dois se comportam de formas bem diferentes:
CPU é compressível. Se um pod quer mais CPU do que está livre, o kernel simplesmente o faz esperar. Nada quebra. Quando você define um limit de CPU, o Kubernetes o aplica via throttling: o kernel restringe o contêiner ao seu limit, e ele não consegue passar disso. Quando o node inteiro está ocupado, o Kubernetes divide o tempo de CPU proporcionalmente ao request de CPU de cada pod. Assim, um pod que declarou um request real continua recebendo sua fatia, e um pod que não declarou nada pode ficar sem recursos.
Memória é incompressível. Não dá para fazer um processo "esperar" pela memória de que ele já precisa. Se um contêiner ultrapassa seu limit de memória, o kernel o mata com um kill de OOM (out of memory). E se o node inteiro fica com pouca memória, o Kubernetes não pede educadamente para ninguém desacelerar. Ele começa a remover pods. É aí que o estrago de verdade acontece.
Vizinhos barulhentos são, na verdade, um problema de multitenancy — e ele piora quanto mais times compartilham um cluster. É exatamente isso que vamos mostrar ao vivo em 29 de setembro, em um cluster real. Garanta sua vaga.
Por que o problema do vizinho barulhento importa
A parte surpreendente é quem sai prejudicado. Muitas vezes não é o pod guloso.
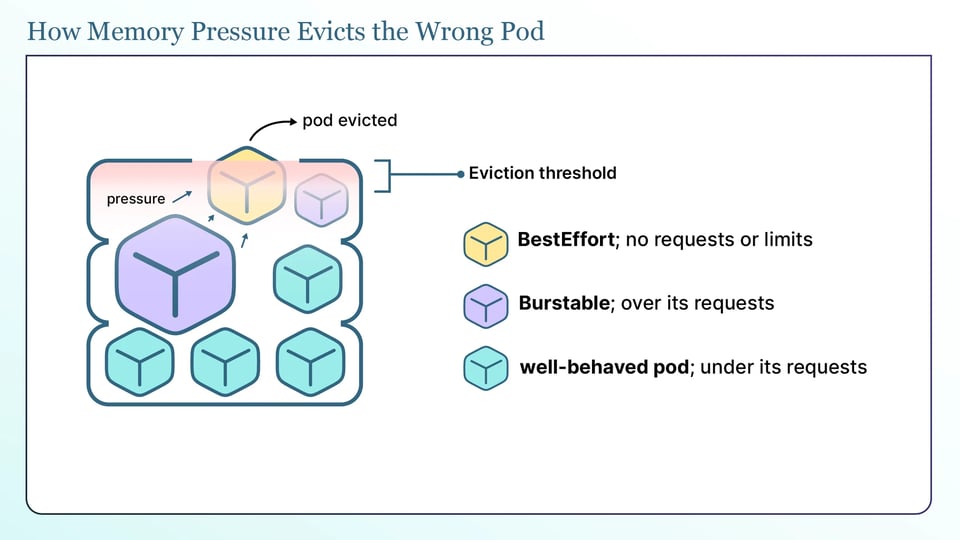
Quando um node fica com pouca memória, o kubelet entra em ação e começa a fazer eviction de pods para liberar memória. Essa é uma ação no nível do node. O kubelet monitora um sinal do node, como memory.available, e quando ele cruza o limiar de eviction, escolhe pods para remover.
Como ele escolhe? Não por "quem é o barulhento". O kubelet classifica os pods primeiro por estarem ou não usando mais do que seus requests, e depois pela prioridade do pod. Um pod que está abaixo dos seus requests é removido por último. Um pod acima dos seus requests é candidato, mesmo que não seja o pod que causou a pressão.
É aqui que as coisas dão errado para quem definiu os requests mais fracos. Quando o node fica com pouca memória, o kubelet não remove o pod que causou a pressão. Ele remove primeiro os pods menos protegidos: pods sem requests ou limits (BestEffort) vão primeiro, depois pods usando mais do que pediram. Pods que ficam dentro dos seus requests, e pods Guaranteed, são removidos por último. Assim, um workload pequeno que não definiu requests, só para manter a configuração simples, pode ser o primeiro a morrer no momento em que qualquer outro workload lota o node, mesmo sem ter feito nada de errado. O pod que pulou os requests paga pela pressão que outro criou.
Há mais dois comportamentos de eviction que vale conhecer:
Pods Guaranteed são protegidos contra eviction, mas não contra o OOM killer: um pod em que todo contêiner tem requests e limits iguais recebe a classe de qualidade de serviço Guaranteed, e o kubelet o remove por último. Mas se esse mesmo pod atingir seu próprio limit de memória, o OOM killer do kernel ainda dispara e mata o contêiner. Guaranteed protege você da eviction no nível do node, não do seu próprio limit.
O barulho de CPU prejudica principalmente pods que pularam os requests: como a CPU é dividida pelo peso do request, um pod com um request de CPU adequado mantém sua fatia mesmo quando o node está sob carga pesada. Quem sofre são os pods que não definiram nenhum request de CPU. Eles ficam com o que sobra, que sob carga pode ser quase nada.
Ou seja, o custo do problema do vizinho barulhento não é só um pod lento. São evictions e OOM kills atingindo workloads que não fizeram nada de errado, picos de latência em serviços que pularam seus requests e reinícios que quebram seus SLOs. E é difícil de depurar, porque o sintoma aparece na vítima, não na causa.
Como prevenir o problema do vizinho barulhento no Kubernetes
A solução é um conjunto de camadas que funcionam juntas: definir requests e limits, limitar namespaces com quotas, ajustar os valores com right-sizing, automatizar o right-sizing e ter visibilidade de quem está usando o quê.
a. Defina requests e limits de recursos
Essa é a base. Todo o resto se apoia nela.
Um request é o que o pod reserva. O scheduler usa o request para escolher um node, e o kubelet garante pelo menos essa quantidade para o contêiner. Um limit é o teto que o pod não pode ultrapassar. Veja o que cada um realmente faz:
| Configuração | O que controla | O que acontece ao ser atingido |
|---|---|---|
| Request de CPU | Reserva CPU e define a fatia do pod quando o node está ocupado | O pod pode usar mais se houver CPU livre |
| Limit de CPU | Limita a CPU | Sofre throttling no limite, nunca é morto |
| Request de memória | Reserva memória, decide o scheduling e o ranking de eviction | O pod pode usar mais se houver memória livre |
| Limit de memória | Limita a memória | Morto por OOM se ultrapassar |
Duas regras práticas decorrem do comportamento de CPU e memória:
Para memória, sempre defina um request, e defina o limit igual a ele. Assim o pod nunca consegue usar mais do que reservou, ou seja, não será o pod que empurra o node para a pressão, e é removido por último. (Definir requests de CPU e memória iguais aos limits em todos os contêineres dá ao pod inteiro a classe Guaranteed, a proteção mais forte, mas isso significa definir limits de CPU também, com o trade-off de throttling da regra de CPU abaixo.) É por não ter limit de memória que um pod acaba devorando o node inteiro.
Para CPU, sempre defina um request para que o pod mantenha sua fatia sob carga. Tenha cuidado com limits de CPU: como a CPU é compressível, um limit basicamente aplica throttling no próprio pod e faz pouco para proteger os vizinhos (o peso do request já faz isso). Muitos times definem requests de CPU e dispensam limits de CPU em serviços sensíveis à latência para evitar throttling. Teste isso com seus próprios workloads em vez de tratar como regra.
Uma pegadinha que vale conhecer: se você define um limit mas nenhum request, o Kubernetes copia o limit e o usa como request. Nem sempre é isso que você quer, então defina os dois de propósito.
b. Limite cada namespace com resource quotas
Requests e limits funcionam por pod. Uma ResourceQuota funciona por namespace. Ela define um teto rígido para o total de CPU, memória e contagem de objetos que um namespace pode usar, para que um único time não tome o cluster inteiro.
apiVersion: v1kind: ResourceQuotametadata: name: team-a-quota namespace: team-aspec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi pods: "50"A quota é aplicada no momento da admissão. Se um novo pod fizer o namespace ultrapassar o teto, o API server o rejeita. Pods que já estão rodando não são afetados.
Depois que um namespace tem uma quota de computação, todo pod nele precisa definir os requests e limits correspondentes, ou o pod é rejeitado. Parece rígido, mas essa é justamente a ideia: força cada pod a declarar o que precisa, que é exatamente o que impede vizinhos barulhentos.
Para facilitar a vida, combine a quota com um LimitRange. Um LimitRange faz dois trabalhos úteis em um namespace: define requests e limits padrão que são injetados em qualquer pod que esqueceu de defini-los, e estabelece um mínimo e um máximo por contêiner, para que nenhum pod sozinho possa pedir uma fatia gigante. A quota define o orçamento do namespace; o LimitRange impede que um único pod pegue tudo e preenche valores padrão sensatos.
apiVersion: v1kind: LimitRangemetadata: name: team-a-limits namespace: team-aspec: limits: - type: Container default: cpu: 500m memory: 512Mi defaultRequest: cpu: 250m memory: 256Mi max: cpu: "2" memory: 2Gi
Em um namespace com uma ResourceQuota, aumentar os requests de um workload consome o orçamento do namespace, então um otimizador precisa evitar estourar a quota. O suporte a ResourceQuota no modo Full do PerfectScale faz o right-sizing levar a quota em conta: ele aumenta os requests e limits de um workload até o espaço que a quota ainda permite, para que namespaces governados por quota recebam right-sizing como qualquer outro, em vez de ficarem subprovisionados só para se manterem com folga abaixo do teto.
Quer ver isso em um cluster ao vivo, e não só no papel? Participe do nosso webinar sobre multitenancy em 29 de setembro. Garanta sua vaga.
c. Faça right-sizing com base no uso real
Quotas e limits só ajudam se os números estiverem certos. Valores definidos uma vez e esquecidos costumam estar errados — e errados nas duas direções.
Defina requests altos demais e você reserva capacidade que ninguém usa. O scheduler acha que o node está cheio, então espalha os pods por mais nodes do que você precisa, e a sua conta sobe. Defina baixos demais e você tem o problema oposto: request de CPU pequeno demais e o pod fica sem CPU quando o node está ocupado; memória de menos e o pod ultrapassa seu request, o que o move para a frente da fila de eviction quando o node fica com pouca memória. De qualquer forma, você volta ao problema do vizinho barulhento.
Right-sizing significa definir requests e limits de acordo com o que o workload realmente usa. O PerfectScale faz exatamente isso: compara o que cada workload pede com o que ele realmente usa e entrega o número a definir, por workload. Mas definir uma vez é a parte fácil. A parte difícil é manter os números certos conforme o workload muda.
d. Automatize, porque os workloads mudam
Right-sizing não é uma tarefa pontual. O tráfego muda, features são lançadas, e uma nova release pode mudar quanta memória ou CPU um serviço precisa. Os valores que você ajustou no mês passado podem estar errados hoje, e requests desatualizados são a forma como um workload volta, discretamente, a virar um vizinho barulhento.
Fazer isso à mão em centenas de workloads não escala, e é entediante o suficiente para deixar de ser feito. A resposta viável é a automação, que é o que o PerfectScale faz: ele continua acompanhando o uso real e mantém os requests e limits de cada workload corretos conforme ele evolui, em vez de deixar isso para uma planilha que alguém atualiza uma vez por trimestre. Esse é o ângulo da confiabilidade: o isolamento só se sustenta se os números continuam certos, e os números só continuam certos se algo os mantém assim.
e. Tenha visibilidade de quem está usando o quê
Não dá para corrigir um vizinho barulhento que você não consegue ver. Quando um node está sob pressão, ou um namespace está acima da quota, a primeira pergunta é sempre "qual workload, e qual time?". Sem o uso detalhado por namespace e por time, você está chutando.
Visibilidade significa conseguir responder rapidamente: quais workloads estão usando mais do que seus requests, quais namespaces estão perto da quota e quanto cada time está de fato usando e custando.
É aqui que o Attribute™ by DoiT ajuda. Ele observa o consumo real em runtime e o mapeia de volta ao workload e ao time que o gerou, sem precisar de nenhum projeto de tagging. Assim, em vez de chutar, você vê exatamente qual workload é o vizinho barulhento e o que cada time está realmente usando e custando.
O que requests e quotas não cobrem
Sejamos honestos sobre os limites: requests, limits, quotas e LimitRanges cobrem CPU e memória. Eles não resolvem diretamente todo tipo de vizinho barulhento.
I/O de disco e largura de banda de rede não são totalmente controlados por essas configurações. Um pod que usa disco ou banda de rede demais ainda pode deixar outros pods do mesmo node mais lentos. Você precisa de outras ferramentas para lidar com isso, como node pools separados para workloads pesados, controles de I/O no nível do storage e shaping de rede via seu CNI. O uso de disco local pode ser gerenciado até certo ponto com requests e limits de ephemeral-storage, mas eles não controlam a velocidade nem o throughput do disco.
A lição não é que essas ferramentas são fracas. É que "vizinho barulhento" vai além de CPU e memória, e uma resposta completa também planeja para os outros recursos.
Mantendo os workloads saudáveis com o PerfectScale by DoiT
O problema do vizinho barulhento se resume a duas coisas que precisam ser verdade ao mesmo tempo: todo workload declara o que precisa, e esses números continuam corretos conforme os workloads mudam. Fazer isso à mão em um cluster real não se sustenta.
O PerfectScale by DoiT é uma plataforma de otimização de Kubernetes com foco em resiliência que monitora continuamente seus workloads em busca de riscos causados por recursos (OOM kills, throttling de CPU e eviction) e os transforma em recomendações de right-sizing que você pode aplicar manualmente ou de forma autônoma. Ele mantém requests e limits alinhados ao uso real conforme seus workloads evoluem, para que um tenant não cresça silenciosamente até virar problema de todo mundo, e dá a você visibilidade por namespace e por time para ver exatamente quem está usando o quê. Times como Paramount Pictures e Creditas usam a plataforma para manter os clusters eficientes e confiáveis ao mesmo tempo.
Cadastre-se ou Agende uma sessão técnica para ver tudo isso no seu próprio cluster.
Antes de ir: nosso webinar sobre multitenancy acontece em 29 de setembro. O mesmo problema deste artigo, mas ao vivo em um cluster real, com suas perguntas respondidas. [Garanta sua vaga]