


Una estrategia de despliegue en Kubernetes es el método que usas para reemplazar la versión en ejecución de una aplicación por una nueva. Define cómo los pods viejos ceden su lugar a los nuevos: todos a la vez, de forma gradual o en paralelo, repartiendo el tráfico entre ambas versiones. La estrategia que elijas determina si los usuarios perciben tiempo de inactividad, qué tan rápido puedes hacer rollback y cuánta capacidad extra necesita la actualización.
En esta guía aprenderás cómo el objeto Deployment controla un rollout, cuáles son las estrategias nativas de Kubernetes, qué patrones requieren herramientas adicionales, cuánto cuesta cada una en capacidad del clúster, cómo interactúan con el autoescalado y cómo elegir la estrategia adecuada para tu workload.
¿Qué es una estrategia de despliegue en Kubernetes?
Una estrategia de despliegue es la forma en que un Deployment pasa de la versión actual de tu app a una nueva. Cuando modificas un Deployment, Kubernetes tiene que reemplazar los pods que ejecutan la versión anterior por pods con la versión nueva, y la estrategia es la regla que define cómo lo hace.
La elección importa porque cada estrategia equilibra tres factores: cuánto tiempo de inactividad ven los usuarios, qué tan rápido puedes revertir un release defectuoso y cuánta capacidad extra necesita el rollout mientras ambas versiones coexisten. Kubernetes trae dos estrategias integradas en el objeto Deployment, y existen varios patrones más avanzados que se construyen encima con herramientas adicionales.
¿Cómo controla un rollout el objeto Deployment de Kubernetes?
Toda estrategia de rollout usa el mismo proceso del Deployment, así que conviene saber qué ocurre cuando actualizas uno. Veámoslo:
Cuando actualizas la plantilla de pods de un Deployment, Kubernetes no edita los pods en ejecución. Crea un nuevo ReplicaSet para la versión nueva y modifica el número de pods de los dos ReplicaSets: el nuevo aumenta sus réplicas mientras el viejo las reduce. Los pods nunca se modifican, se reemplazan, y el Deployment registra cada versión como su propio ReplicaSet para poder hacer rollback más adelante escalando de nuevo uno anterior.
El comportamiento se define en el campo .spec.strategy.type, que acepta uno de dos valores: Recreate o RollingUpdate. Recreate elimina todos los pods viejos antes de crear los nuevos. RollingUpdate, el valor por defecto, reemplaza los pods de forma gradual para que la app se mantenga disponible en todo momento.
En un rolling update, dos campos controlan la velocidad de reemplazo. maxSurge define cuántos pods pueden existir por encima del número deseado durante el rollout; su valor por defecto es 25%, redondeado hacia arriba. maxUnavailable define cuántos pods pueden faltar por debajo del número deseado durante el rollout; su valor por defecto es 25%, redondeado hacia abajo. Juntos determinan cómo se reemplazan los pods durante el rollout. Con maxSurge: 1 y maxUnavailable: 0, se agrega un pod nuevo antes de eliminar uno viejo y se mantiene disponible toda la capacidad deseada.
Hay tres campos más que controlan el comportamiento del rollout. minReadySeconds hace que un pod espere después de estar listo antes de contar como disponible, lo que detecta pods que pasan su probe y luego fallan. progressDeadlineSeconds, con un valor por defecto de 600 (10 minutos), es cuánto espera Kubernetes a que haya progreso antes de marcar el rollout como fallido. Y revisionHistoryLimit, con un valor por defecto de 10, es cuántos ReplicaSets antiguos conserva Kubernetes para hacer rollback.
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, etc.# Recreate: detener todos los pods viejos y luego iniciar los nuevosspec: strategy: type: RecreateNada de esto es seguro sin buenos probes. Un pod nuevo solo recibe tráfico cuando pasa su readiness probe, así que sin un readiness probe vinculado a la salud real, Kubernetes enviará tráfico a un pod que en realidad no está listo, y el rollout parecerá exitoso mientras los usuarios ven errores. Para apps que tardan en arrancar, un startup probe pospone los demás probes hasta que la app termina de iniciar, de modo que un arranque lento no se interprete como una falla.
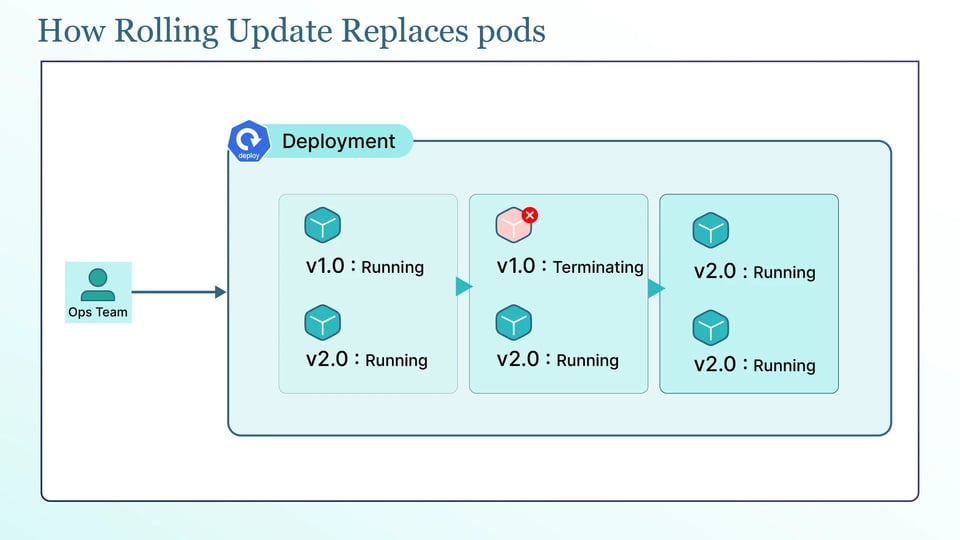
Estrategias de despliegue nativas de Kubernetes
Kubernetes tiene exactamente dos tipos de estrategia nativos, Recreate y RollingUpdate. Los otros nombres que verás, como "ramped" y "best-effort controlled", no son funcionalidades separadas. Son formas específicas de configurar un rolling update. Veámoslas en detalle:
Despliegue Recreate
La estrategia Recreate detiene todos los pods viejos y luego inicia los nuevos. Es simple y garantiza que las dos versiones nunca corran al mismo tiempo, lo que conviene a apps que no toleran dos versiones a la vez o que mantienen un lock exclusivo, como algunas migraciones de bases de datos. El costo es el tiempo de inactividad, porque hay un intervalo entre que los pods viejos se detienen y los nuevos están listos.
Rolling update
La estrategia de rolling update reemplaza los pods de forma gradual y mantiene la app disponible todo el tiempo. Es la opción por defecto y la correcta para la mayoría de los servicios sin estado, y su ritmo se ajusta con los campos maxSurge y maxUnavailable descritos arriba.
Ramped slow rollout
Un ramped slow rollout no es más que un rolling update configurado para avanzar de forma lenta y deliberada, por ejemplo con maxSurge: 1 y maxUnavailable: 0, de modo que los pods se reemplazan de uno en uno. Para ir más allá y pausar entre lotes para observar cada paso, se usa un controlador de rollouts como Argo Rollouts en lugar del Deployment por sí solo. La clave es que "ramped" es una forma de ejecutar un rolling update, no un motor distinto.
Best-effort controlled rollout
Un best-effort controlled rollout también es un rolling update, configurado para priorizar la velocidad. Estableces maxUnavailable en un porcentaje y maxSurge en 0, lo que reemplaza los pods tan rápido como sea posible sin agregar capacidad extra, a costa de operar por debajo de la capacidad total durante la actualización. Se llama best-effort porque avanza tan rápido como lo permite la indisponibilidad tolerada. De nuevo, es una configuración de RollingUpdate, no una estrategia aparte.
Estrategias de despliegue que requieren un service mesh, un ingress controller o un controlador de rollouts
Las estrategias siguientes son patrones, no tipos nativos del Deployment. Kubernetes no las implementa por ti. Las construyes con Services y labels, un ingress controller o un service mesh para el control de tráfico, o un controlador de rollouts como Argo Rollouts o Flagger:
Despliegue blue/green
Ejecutas dos entornos completos al mismo tiempo, la versión actual (blue) y la nueva (green), y cambias todo el tráfico de blue a green de una sola vez redirigiendo el Service. Ofrece rollback instantáneo, porque basta con apuntar de vuelta a blue, pero necesita aproximadamente el doble de capacidad mientras ambos están activos.
Despliegue canary
Envías una pequeña parte del tráfico a la versión nueva, observas sus métricas y aumentas la proporción gradualmente si se mantiene saludable. Limita el radio de impacto de un release defectuoso, pero requiere división de tráfico desde un mesh o un ingress controller, e idealmente automatización basada en métricas para promover o hacer rollback.
Despliegue con A/B testing
Una variante del canary en la que diriges usuarios o requests específicos a una versión según reglas como headers, cookies o geografía, normalmente para comparar comportamiento más que para probar estabilidad. Necesita las mismas herramientas de enrutamiento de tráfico que el canary.
Despliegue shadow con espejado de tráfico
Envías una copia del tráfico real de producción a la versión nueva sin devolver sus respuestas a los usuarios, de modo que puedes probarla bajo carga real sin ningún impacto para ellos. Requiere un service mesh capaz de espejar tráfico, y cuidar que la versión en shadow no escriba en los sistemas de producción.
Dark launch con feature flags
Despliegas el código nuevo en producción pero lo mantienes apagado detrás de un feature flag, y lo activas para usuarios seleccionados cuando estés listo. Esto separa el despliegue del lanzamiento, y lo controla un sistema de feature flags, no el Deployment.
Comparación de estrategias de despliegue
La siguiente tabla compara las principales estrategias de despliegue y sus ventajas y desventajas.
| Estrategia | Tiempo de inactividad | Velocidad de rollback | Control de tráfico | Capacidad extra necesaria |
|---|---|---|---|---|
| Recreate | Sí | Lenta (redesplegar) | Ninguno | Ninguna |
| Rolling update | No | Media | Ninguno | Baja (maxSurge) |
| Blue/green | No | Instantánea | Todo o nada | Alta (~2x) |
| Canary | No | Rápida | Granular | Baja a media |
| A/B testing | No | Rápida | Basado en reglas | Baja a media |
| Shadow | No | N/A (sin tráfico de usuarios) | Espejado | Media (ejecuta una copia completa) |
¿Cuánto cuesta cada estrategia de despliegue en capacidad extra del clúster?
Una estrategia de despliegue no es solo una cuestión de seguridad. También afecta el costo del clúster, porque algunas estrategias necesitan capacidad extra mientras la versión vieja y la nueva corren al mismo tiempo. El ejemplo más claro es blue/green. Durante el cambio ejecutas dos entornos completos, lo que significa aproximadamente el doble de pods y, por lo tanto, cerca del doble de CPU y memoria. Si tu clúster no tiene suficiente capacidad libre, el entorno en espera puede requerir nodos extra que permanecen casi ociosos entre releases, o el clúster puede tener que escalar durante cada release.
Los rolling updates necesitan menos capacidad extra, pero no salen gratis. maxSurge permite pods adicionales por encima del número deseado durante el rollout, y esos pods también necesitan recursos. Si el clúster no tiene espacio para ellos, los pods de surge quedan en estado Pending y el Cluster Autoscaler agrega nodos para ejecutarlos. Esto significa que un rollout puede aumentar temporalmente el número de nodos y el costo.
El factor de fondo en ambas estrategias son los resource requests de los pods. El scheduling de Kubernetes y el Cluster Autoscaler se basan en los resource requests, no en el uso real de CPU y memoria. Si un pod solicita mucho más de lo que normalmente usa, cada pod de surge o pod duplicado de blue/green reserva esa cantidad inflada. Los requests sobredimensionados hacen que, sin que lo notes, cada release cueste más de lo necesario.
Aquí es donde entra PerfectScale. Su plataforma de gobernanza de Kubernetes observa cómo tus workloads usan realmente la CPU y la memoria y lo convierte en recomendaciones de right-sizing accionables y automatizadas, que puedes aplicar de forma manual o autónoma. Con requests que reflejan la realidad, tus pods de surge y de reserva solo reservan lo que necesitan, de modo que los rollouts dejan de provocar escalados innecesarios y cada release cuesta menos. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes, y puedes probarlo o agendar una sesión técnica.
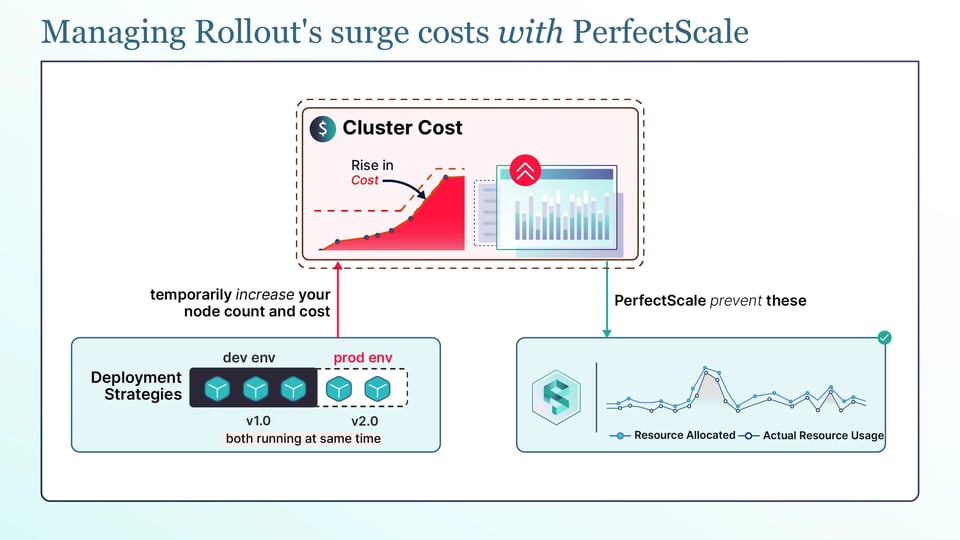
¿Cómo interactúan el autoescalado y los controles de disrupción con los rollouts?
Los rollouts pueden verse afectados por otras funcionalidades de Kubernetes. Saber cómo interactúan te ayuda a evitar sorpresas:
El Horizontal Pod Autoscaler (HPA) sigue ajustando el número de réplicas durante un rolling update, lo cual es esperable. El problema aparece cuando además defines replicas en el manifiesto del Deployment. Cada apply puede restablecer el número de réplicas al valor del manifiesto, y el HPA luego lo vuelve a cambiar. Esto puede provocar escalados inesperados durante el rollout. Para Deployments gestionados por un HPA, omite replicas en el manifiesto.
El Vertical Pod Autoscaler (VPA) funciona distinto. Ajusta los requests de CPU y memoria de cada pod según el uso real. Históricamente, aplicar estos cambios requería recrear los pods, lo que podía causar interrupciones. A partir de Kubernetes 1.35, el redimensionamiento de pods in-place está disponible de forma general, por lo que los recursos de CPU y memoria pueden cambiarse en un pod en ejecución sin recrearlo. El VPA puede aprovecharlo para hacer right-sizing de los pods con mucha menos disrupción.
Los PodDisruptionBudgets (PDB) suelen malinterpretarse durante los rollouts. Un PDB no bloquea el rolling update de un Deployment, porque el Deployment reemplaza los pods directamente en lugar de usar la API de eviction. Lo que un PDB limita son las evictions voluntarias, como los drains de nodos y el scale-down del Cluster Autoscaler. Así que un PDB no ralentizará un rolling update, pero sí puede bloquear un drain de nodo que ocurra al mismo tiempo. Por ejemplo, definir minAvailable igual al número total de réplicas puede impedir por completo las disrupciones voluntarias.
Cómo elegir la estrategia de despliegue según el tipo de workload
La estrategia de despliegue adecuada depende de lo que estés desplegando:
Servicios HTTP y APIs sin estado
El rolling update es la opción por defecto, ya que estos servicios escalan horizontalmente y toleran dos versiones a la vez. Cuando necesites reducir el riesgo en un servicio de alto tráfico, agrega un canary encima con división de tráfico para validar primero la versión nueva con una porción del tráfico.
Aplicaciones con estado y volúmenes persistentes
Estas aplicaciones a menudo no pueden ejecutar dos versiones contra los mismos datos a la vez, así que Recreate, o un StatefulSet con actualizaciones ordenadas y cuidadosas, suele ser más seguro que un rolling update sin precauciones. Acepta la breve inactividad antes que arriesgarte a una corrupción de datos por versiones superpuestas.
Batch jobs, consumidores de colas y CronJobs
No son servicios de larga duración, así que el tiempo de inactividad del rollout importa menos. Un rolling update o incluso un recreate suele bastar, y la preocupación real es drenar limpiamente el trabajo en curso antes de que los pods viejos se detengan.
Workloads de GPU e inferencia de machine learning
Los nodos con GPU son caros y escasos, lo que encarece las estrategias con mucho surge, ya que mantener capacidad de GPU libre para un blue/green o un maxSurge amplio resulta costoso. Prefiere un rolling update con un maxSurge pequeño, o un canary, y dimensiona los requests con cuidado para no reservar GPUs completas que no usas.
Buenas prácticas para estrategias de despliegue en Kubernetes
Las siguientes prácticas pueden hacer que tus despliegues sean más seguros y rentables:
1. Ajusta los resource requests con right-sizing antes de afinar la velocidad del rollout
Como los pods de surge y de reserva reservan los requests, unos requests precisos influyen más en el costo del rollout que cualquier ajuste de estrategia. Dimensiona bien primero y luego afina el rollout.
2. Condiciona cada rollout a readiness probes vinculados a señales de salud reales
Un readiness probe que solo verifica que el proceso está activo pasará aunque la app siga rota. Vincúlalo a un chequeo de salud real para que Kubernetes solo envíe tráfico a pods que de verdad pueden atenderlo.
3. Define un PodDisruptionBudget para cada workload de producción
Un PDB no ralentizará tus rollouts, pero protege tu app durante los drains de nodos y el scale-down del autoescalador al limitar cuántos pods pueden desalojarse a la vez. Todo workload de producción debería tener uno.
4. Automatiza el rollback ante fallas en los chequeos de salud o de SLO
No dependas de alguien mirando un dashboard. Usa un controlador de rollouts como Argo Rollouts o Flagger para promover o revertir automáticamente según métricas, de modo que un release defectuoso se revierta antes de propagarse.
5. Mantén el número de réplicas y los node pools alineados con el margen de maxSurge
Asegúrate de que el clúster tenga espacio para los pods de surge que crea un rollout. Si no lo tiene, conserva algo de margen o asume que el autoescalador agregará nodos en cada release.
6. Revisa el costo y la pérdida de recursos después de cada release
Un release puede cambiar tu huella de recursos sin que lo notes. Compara el uso contra los requests después de los rollouts para que el sobredimensionamiento y la desviación no se acumulen con el tiempo.