


Una strategia di deployment in Kubernetes è il metodo utilizzato per sostituire la versione in esecuzione di un'applicazione con una nuova. Determina come i vecchi pod lasciano il posto ai nuovi: tutti in una volta, gradualmente oppure fianco a fianco, con il traffico spostato tra le due versioni. La strategia scelta stabilisce se gli utenti vedono downtime, quanto rapidamente è possibile eseguire un rollback e quanta capacità di riserva richiede l'aggiornamento.
In questa guida vedremo come l'oggetto Deployment controlla un rollout, quali strategie sono integrate in Kubernetes, quali pattern richiedono tooling aggiuntivo, quanto costa ciascuno in termini di capacità del cluster, come interagiscono con l'autoscaling e come abbinare una strategia al proprio workload.
Che cos'è una strategia di deployment in Kubernetes?
Una strategia di deployment è il modo in cui un Deployment passa dalla versione attuale dell'app a una nuova. Quando si modifica un Deployment, Kubernetes deve sostituire i pod che eseguono la vecchia versione con pod che eseguono la nuova, e la strategia è la regola che stabilisce come farlo.
La scelta è importante perché ogni strategia bilancia tre fattori: quanto downtime vedono gli utenti, quanto rapidamente si può annullare una release difettosa e quanta capacità extra richiede il rollout mentre le due versioni coesistono. Kubernetes integra due strategie nell'oggetto Deployment, oltre a diversi pattern più avanzati che si costruiscono sopra con tooling aggiuntivo.
In che modo l'oggetto Deployment di Kubernetes controlla un rollout?
Ogni strategia di rollout usa lo stesso processo di Deployment, quindi è utile sapere cosa succede quando si aggiorna un Deployment. Vediamolo nel dettaglio:
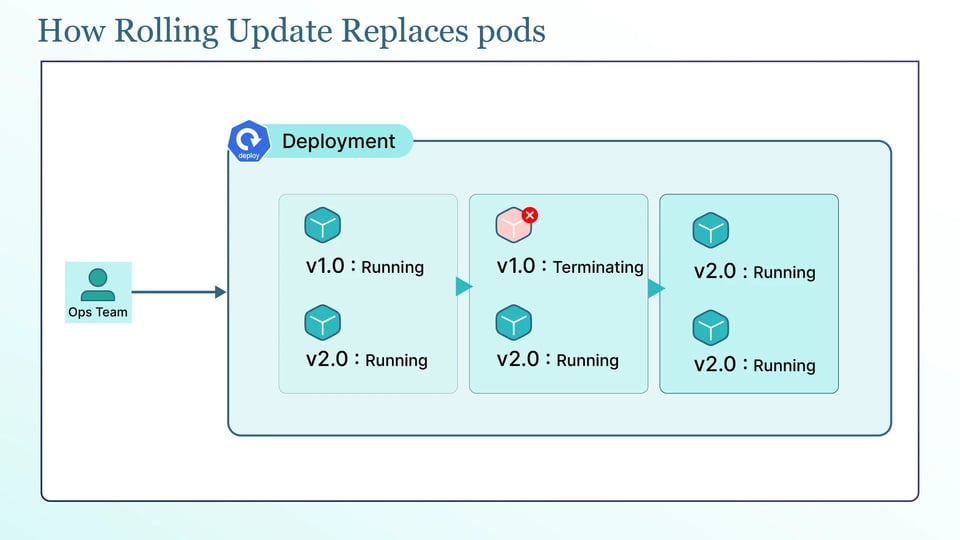
Quando si aggiorna il pod template di un Deployment, Kubernetes non modifica i pod in esecuzione. Crea un nuovo ReplicaSet per la nuova versione e cambia il numero di pod sui due ReplicaSet: il nuovo aumenta le repliche mentre il vecchio le riduce. I pod non vengono mai modificati, vengono sostituiti, e il Deployment tiene traccia di ogni versione come ReplicaSet distinto, così da poter eseguire un rollback in seguito riaumentando le repliche di un ReplicaSet precedente.
Il comportamento è definito dal campo .spec.strategy.type, che accetta uno di due valori: Recreate o RollingUpdate. Recreate rimuove tutti i vecchi pod prima di creare i nuovi. RollingUpdate, il valore predefinito, sostituisce i pod gradualmente, mantenendo l'app disponibile per tutta la durata dell'operazione.
Per un rolling update, due campi controllano la velocità di sostituzione dei pod. maxSurge definisce quanti pod possono esistere oltre il numero desiderato durante il rollout; il valore predefinito è 25%, arrotondato per eccesso. maxUnavailable definisce quanti pod possono mancare rispetto al numero desiderato durante il rollout; il valore predefinito è 25%, arrotondato per difetto. Insieme determinano come i pod vengono sostituiti durante il rollout. maxSurge: 1 con maxUnavailable: 0 aggiunge un nuovo pod prima di rimuoverne uno vecchio e mantiene disponibile l'intera capacità desiderata.
Ci sono altri tre campi che controllano il comportamento del rollout. minReadySeconds fa sì che un pod, dopo essere diventato ready, attenda prima di essere conteggiato come disponibile, intercettando così i pod che superano il probe e poi vanno in crash. progressDeadlineSeconds, con valore predefinito 600 (10 minuti), è il tempo che Kubernetes attende per vedere progressi prima di contrassegnare il rollout come fallito. E revisionHistoryLimit, con valore predefinito 10, è il numero di vecchi ReplicaSet che Kubernetes conserva per il rollback.
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, ecc.# Recreate: ferma tutti i vecchi pod, poi avvia i nuovispec: strategy: type: RecreateNulla di tutto questo è sicuro senza probe adeguati. Un nuovo pod riceve traffico solo quando il suo readiness probe ha esito positivo, quindi senza un readiness probe legato allo stato di salute reale, Kubernetes invierà traffico a un pod che in realtà non è pronto, e il rollout sembrerà riuscito mentre gli utenti vedono errori. Per le app lente ad avviarsi, uno startup probe sospende gli altri probe finché l'app non ha completato l'avvio, così un avvio lento non viene trattato come un errore.
Le strategie di deployment integrate in Kubernetes
Kubernetes prevede esattamente due tipi di strategia nativi, Recreate e RollingUpdate. Gli altri nomi che si incontrano, come "ramped" e "best-effort controlled", non sono funzionalità separate. Sono modi specifici di configurare un rolling update. Approfondiamo:
Deployment Recreate
La strategia Recreate ferma tutti i vecchi pod e poi avvia i nuovi. È semplice e garantisce che le due versioni non girino mai contemporaneamente, il che la rende adatta ad app che non tollerano due versioni in parallelo o che detengono un lock esclusivo, come alcune migrazioni di database. Il compromesso è il downtime, perché c'è un intervallo tra l'arresto dei vecchi pod e la disponibilità dei nuovi.
Rolling update
La strategia rolling update sostituisce i pod gradualmente, mantenendo l'app sempre disponibile. È la scelta predefinita e quella giusta per la maggior parte dei servizi stateless; il suo ritmo è regolato dai campi maxSurge e maxUnavailable descritti sopra.
Ramped slow rollout
Un ramped slow rollout non è altro che un rolling update configurato per procedere lentamente e in modo controllato, per esempio con maxSurge: 1 e maxUnavailable: 0, così i pod vengono sostituiti uno alla volta. Per andare oltre e fare pausa tra i batch in modo da osservare ogni passaggio, si usa un rollout controller come Argo Rollouts, non il Deployment da solo. Il punto è che "ramped" è un modo di eseguire un rolling update, non un motore diverso.
Best-effort controlled rollout
Anche il best-effort controlled rollout è un rolling update, configurato per privilegiare la velocità. Si imposta maxUnavailable su una percentuale e maxSurge su 0, sostituendo i pod il più rapidamente possibile senza aggiungere capacità extra, al costo di operare sotto la piena capacità durante l'aggiornamento. Si chiama best-effort perché procede alla massima velocità consentita dall'indisponibilità ammessa. Anche in questo caso si tratta di una configurazione di RollingUpdate, non di una strategia separata.
Strategie di deployment che richiedono un service mesh, un ingress controller o un rollout controller
Le strategie seguenti sono pattern, non tipi di Deployment integrati. Kubernetes non le implementa automaticamente. Si costruiscono con Service e label, un ingress controller o un service mesh per il controllo del traffico, oppure un rollout controller come Argo Rollouts o Flagger:
Deployment blue/green
Si eseguono due ambienti completi contemporaneamente, la versione attuale (blue) e quella nuova (green), e si sposta tutto il traffico da blue a green in un colpo solo modificando il puntamento di un Service. Offre un rollback istantaneo, basta tornare a puntare su blue, ma richiede circa il doppio della capacità mentre entrambi gli ambienti sono attivi.
Deployment canary
Si invia una piccola quota di traffico alla nuova versione, se ne osservano le metriche e si aumenta gradualmente la quota se resta in salute. Limita il raggio d'impatto di una release difettosa, ma richiede il traffic-splitting di un mesh o di un ingress controller e, idealmente, un'automazione basata su metriche per promuovere la versione o eseguire il rollback.
Deployment per A/B testing
Una variante del canary in cui si instradano utenti o richieste specifici verso una versione in base a regole come header, cookie o area geografica, in genere per confrontare i comportamenti più che per testare la stabilità. Richiede lo stesso tooling di traffic-routing del canary.
Shadow deployment con traffic mirroring
Si invia una copia del traffico di produzione reale alla nuova versione senza restituirne le risposte agli utenti, così da testarla sotto carico reale con zero impatto sugli utenti. Richiede un service mesh in grado di fare mirroring del traffico e attenzione affinché la versione shadow non scriva sui sistemi di produzione.
Dark launch con feature flag
Si distribuisce il nuovo codice in produzione tenendolo però disattivato dietro un feature flag, per poi attivarlo per gli utenti scelti quando si è pronti. Questo separa il deploy dalla release, ed è gestito da un sistema di feature flag, non dal Deployment.
Confronto tra le strategie di deployment
La tabella seguente confronta le principali strategie di deployment e i relativi compromessi.
| Strategia | Downtime | Velocità di rollback | Controllo del traffico | Capacità di riserva necessaria |
|---|---|---|---|---|
| Recreate | Sì | Lenta (redeploy) | Nessuno | Nessuna |
| Rolling update | No | Media | Nessuno | Ridotta (maxSurge) |
| Blue/green | No | Istantanea | Tutto o niente | Elevata (~2x) |
| Canary | No | Rapida | Granulare | Da ridotta a media |
| A/B testing | No | Rapida | Basato su regole | Da ridotta a media |
| Shadow | No | N/D (nessun traffico utente) | In mirroring | Media (esegue una copia completa) |
Quanto costa ogni strategia di deployment in capacità extra del cluster?
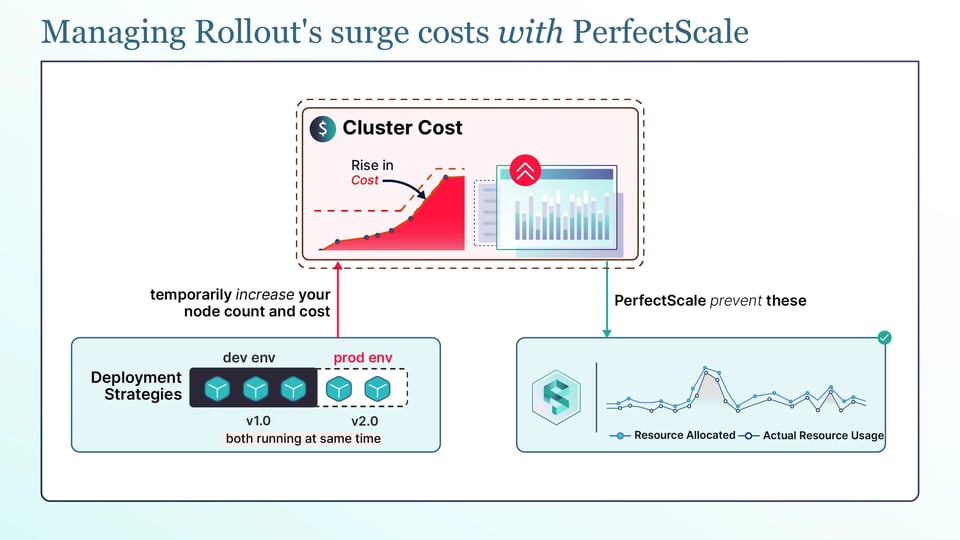
Una strategia di deployment non riguarda solo la sicurezza. Incide anche sui costi del cluster, perché alcune strategie richiedono capacità extra mentre la vecchia e la nuova versione girano contemporaneamente. L'esempio più evidente è il blue/green. Durante lo switch si eseguono due ambienti completi, il che significa circa il doppio dei pod e quindi circa il doppio di CPU e memoria. Se il cluster non dispone di sufficiente capacità di riserva, l'ambiente di standby può richiedere nodi aggiuntivi che restano per lo più inattivi tra una release e l'altra, oppure il cluster deve scalare verso l'alto a ogni release.
I rolling update richiedono meno capacità extra, ma non sono gratis. maxSurge consente pod aggiuntivi oltre il numero desiderato durante il rollout, e quei pod hanno comunque bisogno di risorse. Se il cluster non ha spazio per ospitarli, i pod di surge restano in stato Pending e il Cluster Autoscaler aggiunge nodi per eseguirli. Questo significa che un rollout può aumentare temporaneamente il numero di nodi e i costi.
Il fattore più rilevante dietro entrambe le strategie sono le resource request dei pod. Lo scheduling di Kubernetes e il Cluster Autoscaler usano le resource request, non l'utilizzo effettivo di CPU e memoria. Se un pod richiede molto più di quanto usa normalmente, ogni pod di surge o pod duplicato in un blue/green riserva quella quantità maggiorata. Le request sovradimensionate rendono silenziosamente ogni release più costosa del necessario.
È qui che PerfectScale fa la differenza. La sua piattaforma di governance per Kubernetes osserva come i workloads utilizzano realmente CPU e memoria e lo traduce in raccomandazioni di right-sizing concrete e automatizzate, applicabili manualmente o in modo autonomo. Con request allineate alla realtà, i pod di surge e di standby riservano solo ciò di cui hanno bisogno: i rollout smettono di innescare scale-up inutili e ogni release costa meno. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i loro cluster: può provarlo subito o prenotare una sessione tecnica.
Come autoscaling e controlli di disruption interagiscono con i rollout?
I rollout possono essere influenzati da altre funzionalità di Kubernetes. Sapere come interagiscono aiuta a evitare sorprese:
L'Horizontal Pod Autoscaler (HPA) continua a regolare il numero di repliche durante un rolling update, ed è un comportamento previsto. Il problema nasce quando si imposta anche replicas nel manifest del Deployment. Ogni apply può riportare il numero di repliche al valore del manifest, e l'HPA lo modifica di nuovo. Questo può causare scaling inatteso durante il rollout. Per i Deployment gestiti da un HPA, è meglio omettere replicas dal manifest.
Il Vertical Pod Autoscaler (VPA) funziona diversamente. Regola le request di CPU e memoria di ciascun pod in base all'utilizzo effettivo. Storicamente, applicare queste modifiche richiedeva la ricreazione dei pod, con possibili disservizi. A partire da Kubernetes 1.35, l'in-place pod resize è in general availability, quindi le risorse di CPU e memoria possono essere modificate su un pod in esecuzione senza ricrearlo. Il VPA può sfruttarlo per fare right-sizing dei pod con molte meno interruzioni.
I PodDisruptionBudget (PDB) vengono spesso fraintesi durante i rollout. Un PDB non blocca il rolling update di un Deployment, perché il Deployment sostituisce i pod direttamente senza usare l'API di eviction. Un PDB limita invece le eviction volontarie, come i drain dei nodi e lo scale-down del Cluster Autoscaler. Quindi un PDB non rallenta un rolling update, ma può bloccare il drain di un nodo in corso nello stesso momento. Per esempio, impostare minAvailable pari al numero totale di repliche può impedire del tutto le disruption volontarie.
Abbinare la strategia di deployment al tipo di workload
Le strategie di deployment più adatte dipendono da cosa si sta distribuendo:
Servizi HTTP e API stateless
Il rolling update è la scelta predefinita, perché questi servizi scalano orizzontalmente e tollerano due versioni in parallelo. Quando serve ridurre il rischio su un servizio ad alto traffico, si aggiunge un canary con traffic-splitting per validare prima la nuova versione su una fetta di traffico.
Applicazioni stateful con volumi persistenti
Spesso non possono eseguire due versioni contemporaneamente sugli stessi dati, quindi Recreate, o uno StatefulSet con aggiornamenti ordinati e controllati, è di solito più sicuro di un rolling update applicato senza precauzioni. Meglio accettare il breve downtime che rischiare la corruzione dei dati per la sovrapposizione delle versioni.
Job batch, consumer di code e CronJob
Non sono servizi a lunga esecuzione, quindi il downtime del rollout conta meno. Un rolling update o persino un recreate vanno di solito bene; la vera attenzione va a completare in modo pulito il lavoro in corso prima che i vecchi pod si arrestino.
Workloads GPU e di inferenza machine learning
I nodi GPU sono costosi e scarsi, il che rende onerose le strategie con molto surge: mantenere capacità GPU di riserva per un blue/green o un maxSurge ampio costa caro. Meglio preferire un rolling update con un maxSurge ridotto, o un canary, e dimensionare con cura le request per non riservare intere GPU inutilizzate.
Best practice per le strategie di deployment in Kubernetes
Le pratiche seguenti possono rendere i deployment più sicuri e più efficienti in termini di costi:
1. Fare right-sizing delle resource request prima di ottimizzare la velocità di rollout
Poiché i pod di surge e di standby riservano le request, request accurate incidono sui costi del rollout più di qualsiasi ritocco alla strategia. Prima il dimensionamento corretto, poi la messa a punto del rollout.
2. Vincolare ogni rollout a readiness probe legati a segnali di salute reali
Un readiness probe che verifica solo che il processo sia attivo darà esito positivo anche quando l'app è ancora malfunzionante. Va legato a un controllo di salute reale, così Kubernetes invia traffico solo ai pod effettivamente in grado di servirlo.
3. Impostare un PodDisruptionBudget per ogni workload di produzione
Un PDB non rallenta i rollout, ma protegge l'app durante i drain dei nodi e lo scale-down dell'autoscaler, limitando quanti pod possono essere rimossi contemporaneamente. Ogni workload di produzione dovrebbe averne uno.
4. Automatizzare il rollback in caso di controlli di salute o SLO falliti
Non ci si deve affidare a una persona che osserva una dashboard. Occorre usare un rollout controller come Argo Rollouts o Flagger per promuovere o eseguire il rollback automaticamente in base alle metriche, così una release difettosa viene annullata prima di propagarsi.
5. Mantenere numero di repliche e node pool allineati al margine richiesto da maxSurge
Bisogna assicurarsi che il cluster abbia spazio per i pod di surge creati da un rollout. Se non c'è, occorre mantenere un piccolo margine oppure accettare che l'autoscaler aggiunga nodi a ogni release.
6. Verificare costi e sprechi di risorse dopo ogni release
Una release può modificare silenziosamente il footprint di risorse. Dopo i rollout conviene confrontare l'utilizzo con le request, così sovradimensionamento e drift non si accumulano nel tempo.