


Kubernetesのデプロイ戦略とは、稼働中のアプリケーションを新しいバージョンに置き換える方法のことです。古いPodが新しいPodにどう置き換わるのか——一斉に、段階的に、あるいは並行稼働させてトラフィックを切り替えるのか——を決めます。選んだ戦略によって、ユーザーにダウンタイムが見えるかどうか、どれだけ速くロールバックできるか、そして更新にどれだけの予備キャパシティが必要かが決まります。
本ガイドでは、Deploymentオブジェクトがロールアウトを制御する仕組み、Kubernetesに組み込まれた戦略、追加ツールが必要なパターン、それぞれがクラスタキャパシティに与えるコスト、オートスケーリングとの相互作用、そしてワークロードに合った戦略の選び方を解説します。
Kubernetesのデプロイ戦略とは
デプロイ戦略とは、Deploymentがアプリの現行バージョンから新バージョンへ移行する方法のことです。Deploymentを変更すると、Kubernetesは旧バージョンを実行しているPodを新バージョンのPodに置き換える必要があり、その置き換え方のルールがデプロイ戦略です。
この選択が重要なのは、各戦略が3つの要素のトレードオフだからです。すなわち、ユーザーに見えるダウンタイムの長さ、問題のあるリリースを取り消す速さ、そして両バージョンが並行稼働する間にロールアウトが必要とする追加キャパシティです。KubernetesのDeploymentオブジェクトには2つの戦略が組み込まれており、より高度なパターンは追加ツールを使ってその上に構築します。
Deploymentオブジェクトはロールアウトをどう制御するのか
どのロールアウト戦略も同じDeploymentの仕組みを使うため、Deploymentを更新したときに何が起こるかを知っておくと役立ちます。順に見ていきましょう。
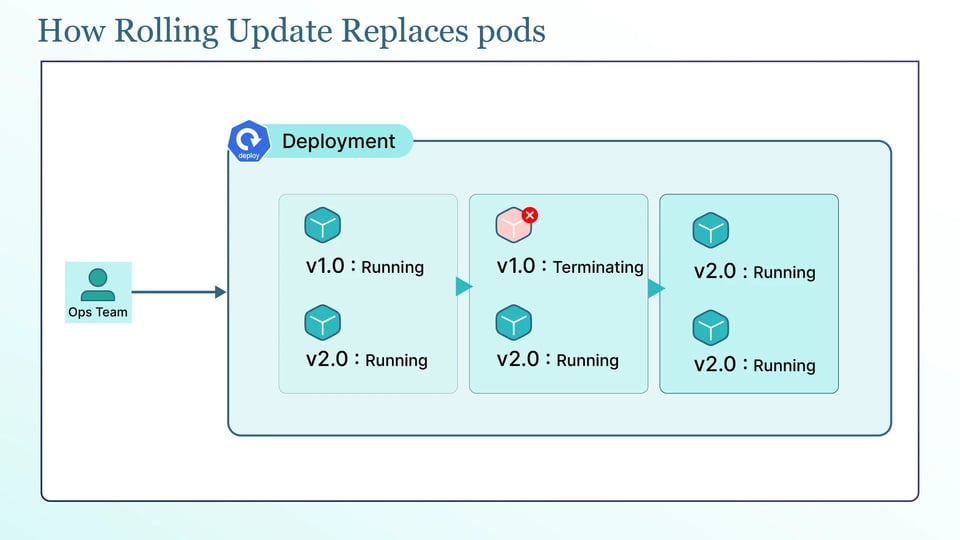
DeploymentのPodテンプレートを更新しても、Kubernetesは稼働中のPodを書き換えません。新バージョン用に新しいReplicaSetを作成し、2つのReplicaSetのPod数を変更します。新しい方をスケールアップし、古い方をスケールダウンするのです。Pod自体は変更されるのではなく置き換えられ、Deploymentは各バージョンを個別のReplicaSetとして管理するため、後で古いReplicaSetを再びスケールアップすることでロールバックできます。
この挙動は .spec.strategy.type フィールドで設定し、Recreate と RollingUpdate のいずれかを指定します。Recreate は古いPodをすべて削除してから新しいPodを作成します。デフォルトの RollingUpdate はPodを段階的に置き換えるため、更新中もアプリは利用可能なままです。
ローリングアップデートでは、Podの置き換え速度を2つのフィールドで制御します。maxSurge はロールアウト中に希望レプリカ数を超えて存在できるPod数を設定し、デフォルトは25%(切り上げ)です。maxUnavailable はロールアウト中に希望レプリカ数を下回って欠けてもよいPod数を設定し、デフォルトは25%(切り捨て)です。この2つの組み合わせで、ロールアウト中のPodの置き換え方が決まります。maxSurge: 1 と maxUnavailable: 0 の組み合わせでは、古いPodを削除する前に新しいPodを1つ追加するため、必要なキャパシティを常にフルで維持できます。
ロールアウトの挙動を制御するフィールドはさらに3つあります。minReadySeconds は、PodがReadyになってから利用可能とみなされるまでの待機時間を設定するもので、プローブに合格した直後にクラッシュするPodを検出できます。progressDeadlineSeconds(デフォルトは600秒=10分)は、ロールアウトを失敗と判定するまでKubernetesが進捗を待つ時間です。そして revisionHistoryLimit(デフォルトは10)は、ロールバック用に保持する古いReplicaSetの数です。
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, etc.# Recreate: stop all old pods, then start new onesspec: strategy: type: Recreateこれらはいずれも、適切なプローブなしには安全に機能しません。新しいPodはReadinessプローブに合格して初めてトラフィックを受け取ります。実際の健全性と結びついたReadinessプローブがなければ、Kubernetesは本当は準備できていないPodにトラフィックを送ってしまい、ユーザーにはエラーが見えているのにロールアウトは成功しているように見えます。起動の遅いアプリでは、起動が完了するまで他のプローブを保留するStartupプローブを使うことで、起動の遅さが障害として扱われるのを防げます。
Kubernetesに組み込まれたデプロイ戦略
Kubernetesにネイティブな戦略タイプは、Recreate と RollingUpdate の2つだけです。「ランプド(ramped)」や「ベストエフォート制御」といった他の名称は、独立した機能ではありません。ローリングアップデートの特定の設定方法にすぎないのです。詳しく見ていきましょう。
Recreateデプロイ
Recreate戦略は、古いPodをすべて停止してから新しいPodを起動します。シンプルで、2つのバージョンが同時に稼働しないことが保証されるため、2バージョンの並行稼働を許容できないアプリや、一部のデータベース移行のように排他ロックを保持するアプリに向いています。トレードオフはダウンタイムです。古いPodの停止から新しいPodの準備完了までの間に空白が生じます。
ローリングアップデート
ローリングアップデート戦略はPodを段階的に置き換え、その間もアプリを利用可能な状態に保ちます。デフォルトの戦略であり、ほとんどのステートレスサービスに適した選択肢です。置き換えのペースは、前述の maxSurge と maxUnavailable で設定します。
ランプドスローロールアウト
ランプドスローロールアウトは、ゆっくり慎重に進むように調整したローリングアップデートにすぎません。たとえば maxSurge: 1 と maxUnavailable: 0 を設定し、Podを1つずつ置き換えます。さらに進めてバッチ間で一時停止し、各ステップを確認したい場合は、Deployment単体ではなく、Argo Rolloutsのようなロールアウトコントローラーを使います。重要なのは、「ランプド」はローリングアップデートの運用方法の一つであり、別個の仕組みではないという点です。
ベストエフォート制御ロールアウト
ベストエフォート制御ロールアウトも、速度を優先するように設定したローリングアップデートです。maxUnavailable をパーセンテージに、maxSurge を0に設定することで、追加キャパシティなしで可能な限り速くPodを置き換えますが、その代償として更新中はフルキャパシティを下回って稼働することになります。許容された停止数の範囲でできるだけ速く進むため、ベストエフォートと呼ばれます。これもRollingUpdateの設定の一つであり、独立した戦略ではありません。
サービスメッシュ、Ingressコントローラー、ロールアウトコントローラーが必要なデプロイ戦略
以下の戦略は組み込みのDeploymentタイプではなく、パターンです。Kubernetesが代わりに実装してくれるわけではありません。Serviceとラベル、トラフィック制御のためのIngressコントローラーやサービスメッシュ、あるいはArgo RolloutsやFlaggerのようなロールアウトコントローラーを組み合わせて構築します。
Blue/Greenデプロイ
現行バージョン(Blue)と新バージョン(Green)の2つの完全な環境を同時に稼働させ、Serviceの向き先を変更することで、全トラフィックを一度にBlueからGreenへ切り替えます。向き先をBlueに戻すだけで済むため即時ロールバックが可能ですが、両環境が稼働している間はおよそ2倍のキャパシティが必要です。
カナリアデプロイ
トラフィックの一部を新バージョンに送り、そのメトリクスを監視しながら、健全性が保たれていれば割合を徐々に増やします。問題のあるリリースの影響範囲を限定できますが、メッシュやIngressコントローラーによるトラフィック分割と、理想的にはメトリクスに基づいて昇格・ロールバックを行う自動化が必要です。
A/Bテストデプロイ
カナリアの一種で、ヘッダー、Cookie、地域などのルールに基づいて、特定のユーザーやリクエストを特定のバージョンにルーティングします。安定性のテストというより、挙動の比較を目的とすることが多い手法です。カナリアと同じトラフィックルーティングのツールが必要です。
トラフィックミラーリングによるシャドウデプロイ
実際の本番トラフィックのコピーを新バージョンに送りつつ、そのレスポンスはユーザーに返さないため、ユーザーへの影響ゼロで実負荷の下でテストできます。トラフィックをミラーリングできるサービスメッシュが必要で、シャドウ側のバージョンが本番システムに書き込まないよう注意が必要です。
フィーチャーフラグによるダークローンチ
新しいコードを本番にデプロイしつつ、フィーチャーフラグの背後で無効のままにしておき、準備ができた時点で選んだユーザーに対して有効化します。デプロイとリリースを分離する手法であり、Deploymentではなくフィーチャーフラグシステムによって制御します。
デプロイ戦略の比較
次の表は、主なデプロイ戦略とそのトレードオフを比較したものです。
| 戦略 | ダウンタイム | ロールバック速度 | トラフィック制御 | 必要な予備キャパシティ |
|---|---|---|---|---|
| Recreate | あり | 遅い(再デプロイ) | なし | 不要 |
| ローリングアップデート | なし | 中程度 | なし | 小(maxSurge) |
| Blue/Green | なし | 即時 | 一括切り替え | 大(約2倍) |
| カナリア | なし | 速い | きめ細かい | 小〜中 |
| A/Bテスト | なし | 速い | ルールベース | 小〜中 |
| シャドウ | なし | 対象外(ユーザートラフィックなし) | ミラーリング | 中(完全なコピーを稼働) |
各デプロイ戦略が追加で必要とするクラスタキャパシティ
デプロイ戦略は安全性だけの問題ではありません。新旧バージョンが同時に稼働する間に追加キャパシティを必要とする戦略があるため、クラスタコストにも影響します。最もわかりやすい例がBlue/Greenです。切り替えの間、2つの完全な環境を稼働させるため、Pod数はおよそ2倍になり、したがってCPUとメモリもおよそ2倍必要になります。クラスタに十分な予備キャパシティがなければ、スタンバイ環境のためにリリースの合間はほぼ遊休状態のノードを追加しておくか、リリースのたびにクラスタをスケールアップする必要が生じます。
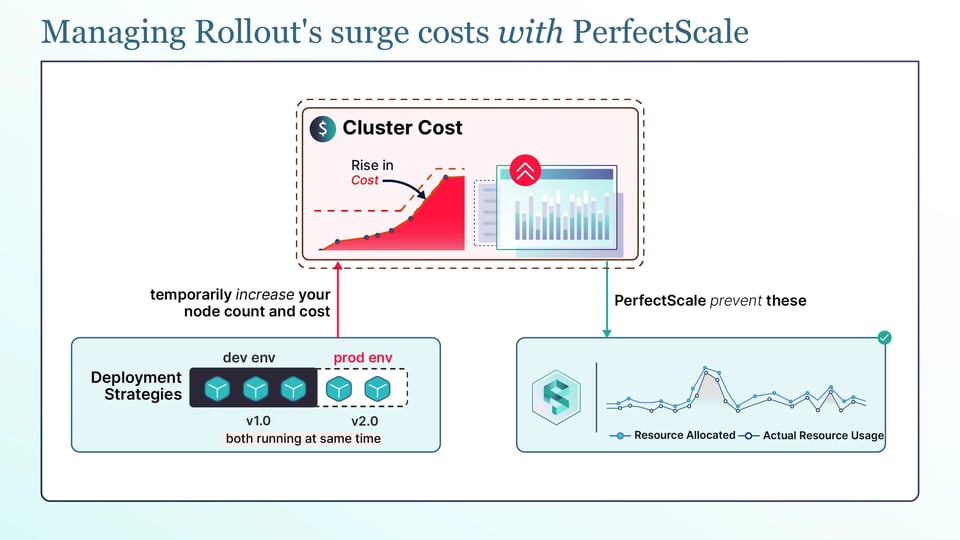
ローリングアップデートに必要な追加キャパシティはそれより少ないものの、コストがかからないわけではありません。maxSurge はロールアウト中に希望レプリカ数を超えるPodを許可しますが、それらのPodにもリソースが必要です。クラスタに空きがなければ、サージPodはPendingのままとなり、Cluster Autoscalerがそれらを稼働させるためにノードを追加します。つまり、ロールアウトによってノード数とコストが一時的に増加する可能性があるのです。
どちらの戦略においても、より大きな要因となるのがPodのリソースrequestsです。KubernetesのスケジューリングとCluster Autoscalerは、実際のCPU・メモリ使用量ではなく、リソースrequestsを基準にします。Podが通常の使用量よりはるかに多くリクエストしていると、すべてのサージPodやBlue/Greenの複製Podがその大きな量を確保してしまいます。過剰にプロビジョニングされたrequestsは、気づかないうちにすべてのリリースを必要以上に高コストにしてしまうのです。
ここで役立つのがPerfectScaleです。PerfectScaleのKubernetesガバナンスプラットフォームは、ワークロードが実際にCPUとメモリをどう使っているかを監視し、すぐに実行できるライトサイジングの推奨事項として提示します。推奨は手動でも自律的にも適用可能です。requestsが実態に合っていれば、サージPodやスタンバイPodは必要な分だけを確保するため、ロールアウトが不要なスケールアップを引き起こさなくなり、すべてのリリースのコストが下がります。Paramount PicturesやCreditasなどのチームがPerfectScaleを使ってクラスタの効率を維持しています。ぜひお試しいただくか、技術セッションをご予約ください。
オートスケーリングとDisruption制御はロールアウトとどう相互作用するか
ロールアウトは、他のKubernetes機能の影響を受けることがあります。これらがどう連携するかを理解しておけば、想定外の事態を避けられます。
Horizontal Pod Autoscaler(HPA)はローリングアップデート中もレプリカ数を調整し続けますが、これは想定どおりの挙動です。問題になるのは、Deploymentマニフェストにも replicas を設定している場合です。applyのたびにレプリカ数がマニフェストの値にリセットされ、その後HPAが再び変更するため、ロールアウト中に予期しないスケーリングが起こることがあります。HPAで管理するDeploymentでは、マニフェストから replicas を外してください。
Vertical Pod Autoscaler(VPA)の動作は異なります。実際の使用量に基づいて、各PodのCPU・メモリrequestsを調整します。従来、この変更を適用するにはPodの再作成が必要で、中断の原因になることがありました。Kubernetes 1.35では、インプレースのPodリサイズが一般提供(GA)となり、稼働中のPodを再作成せずにCPUとメモリのリソースを変更できるようになりました。VPAはこれを利用して、はるかに少ない中断でPodをライトサイジングできます。
PodDisruptionBudget(PDB)はロールアウトの文脈で誤解されがちです。DeploymentはEviction APIを使わずにPodを直接置き換えるため、PDBがDeploymentのローリングアップデートをブロックすることはありません。PDBが制限するのは、ノードのdrainやCluster Autoscalerのスケールダウンといった自発的なEvictionです。つまり、PDBがローリングアップデートを遅くすることはありませんが、同じタイミングで行われるノードのdrainをブロックすることはあります。たとえば minAvailable を総レプリカ数と同じ値に設定すると、自発的な中断を完全に防ぐことができます。
ワークロードの種類に合わせたデプロイ戦略の選び方
適切なデプロイ戦略は、何をデプロイするかによって次のように変わります。
ステートレスなHTTPサービスとAPI
これらは水平方向にスケールし、2バージョンの同時稼働を許容するため、ローリングアップデートがデフォルトの選択肢です。トラフィックの多いサービスでリスクを下げたい場合は、トラフィック分割によるカナリアを組み合わせ、まず一部のトラフィックで新バージョンを検証しましょう。
永続ボリュームを持つステートフルなアプリケーション
これらは同じデータに対して2つのバージョンを同時に実行できないことが多いため、単純なローリングアップデートよりも、Recreate か、順序付き更新を慎重に行うStatefulSetの方が通常は安全です。バージョンの重複によるデータ破損のリスクを冒すより、短いダウンタイムを受け入れましょう。
バッチジョブ、キューコンシューマー、CronJob
これらは長時間稼働するサービスではないため、ロールアウトのダウンタイムはそれほど問題になりません。通常はローリングアップデートでもRecreateでも問題なく、本当に重要なのは、古いPodが停止する前に処理中の作業をきれいにドレインすることです。
GPUおよび機械学習推論のワークロード
GPUノードは高価で希少なため、サージの多い戦略はコストがかさみます。Blue/Greenや大きな maxSurge のために予備のGPUキャパシティを維持するのは高くつくからです。小さな maxSurge を設定したローリングアップデートかカナリアを選び、使わないGPUを丸ごと確保してしまわないよう、requestsを慎重にサイジングしましょう。
Kubernetesデプロイ戦略のベストプラクティス
デプロイをより安全かつコスト効率よくするためのプラクティスは次のとおりです。
1. ロールアウト速度を調整する前にリソースrequestsをライトサイジングする
サージPodやスタンバイPodはrequests分のリソースを確保するため、正確なrequestsは、どんな戦略の微調整よりもロールアウトコストに効きます。まずサイジングを正しくし、それからロールアウトを調整しましょう。
2. 実際の健全性シグナルと結びついたReadinessプローブですべてのロールアウトをゲートする
プロセスの起動だけを確認するReadinessプローブは、アプリが壊れたままでも合格してしまいます。実際のヘルスチェックと結びつけ、Kubernetesが実際にリクエストを処理できるPodにだけトラフィックを送るようにしましょう。
3. すべての本番ワークロードにPodDisruptionBudgetを設定する
PDBはロールアウトを遅くしませんが、一度にEvictされるPod数に上限を設けることで、ノードのdrainやオートスケーラーのスケールダウン中にアプリを守ります。すべての本番ワークロードに設定すべきです。
4. ヘルスチェックやSLOチェックの失敗時にロールバックを自動化する
ダッシュボードを見ている人に頼ってはいけません。Argo RolloutsやFlaggerのようなロールアウトコントローラーを使い、メトリクスに基づいて自動的に昇格・ロールバックを行うことで、問題のあるリリースを影響が広がる前に戻せます。
5. レプリカ数とノードプールをmaxSurge分の余裕に合わせておく
ロールアウトが生成するサージPodのための空きがクラスタにあるか確認しましょう。空きがなければ、多少の余裕を確保しておくか、リリースのたびにオートスケーラーがノードを追加することを受け入れる必要があります。
6. リリースのたびにコストとリソースの無駄を見直す
リリースは気づかないうちにリソースフットプリントを変えることがあります。ロールアウト後に使用量とrequestsを照らし合わせ、過剰プロビジョニングやドリフトが時間とともに蓄積しないようにしましょう。