


Uma estratégia de deployment no Kubernetes é o método que você usa para substituir a versão em execução de uma aplicação por uma nova. Ela define como os pods antigos dão lugar aos novos: todos de uma vez, gradualmente ou lado a lado, com o tráfego sendo alternado entre eles. A estratégia escolhida determina se os usuários percebem downtime, com que rapidez você consegue reverter uma versão ruim e quanta capacidade extra a atualização exige.
Neste guia, você vai entender como o objeto Deployment controla um rollout, quais estratégias são nativas do Kubernetes, quais padrões exigem ferramentas adicionais, quanto cada um custa em capacidade de cluster, como eles interagem com o autoscaling e como escolher a estratégia certa para seu workload.
O que é uma estratégia de deployment no Kubernetes?
Uma estratégia de deployment é a forma como um Deployment migra da versão atual da sua aplicação para uma nova. Quando você altera um Deployment, o Kubernetes precisa substituir os pods que executam a versão antiga pelos pods que executam a nova versão, e a estratégia é a regra que define como isso acontece.
A escolha importa porque cada estratégia equilibra três fatores: quanto downtime os usuários percebem, com que rapidez você consegue desfazer uma release ruim e quanta capacidade extra o rollout precisa enquanto as duas versões coexistem. O Kubernetes tem duas estratégias nativas no objeto Deployment, além de vários padrões mais avançados que você constrói por cima com ferramentas adicionais.
Como o objeto Deployment do Kubernetes controla um rollout?
Toda estratégia de rollout usa o mesmo processo de Deployment, então vale entender o que acontece quando você atualiza um Deployment. Vamos lá:
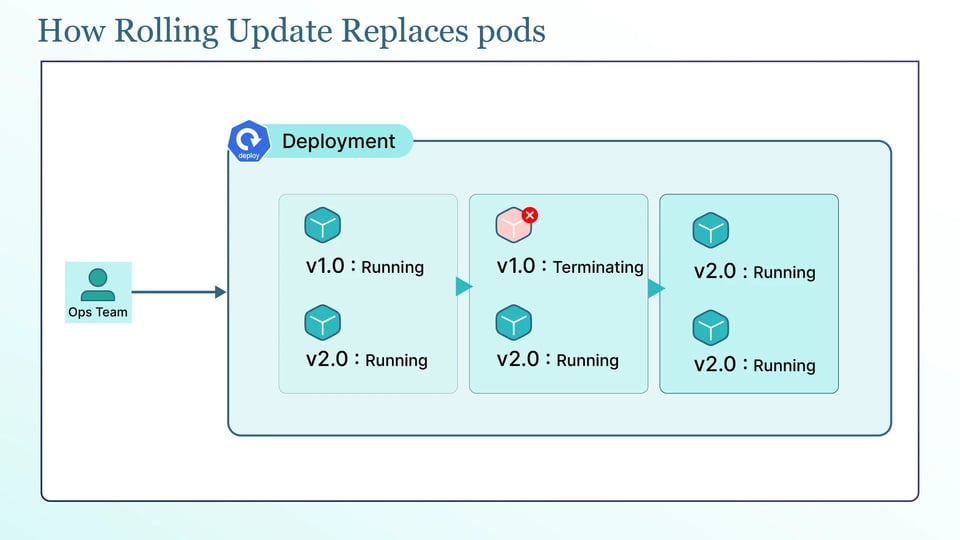
Quando você atualiza o template de pod de um Deployment, o Kubernetes não edita os pods em execução. Ele cria um novo ReplicaSet para a nova versão e altera a contagem de pods nos dois ReplicaSets: a do novo aumenta enquanto a do antigo diminui. Os pods em si nunca são modificados, são substituídos, e o Deployment registra cada versão como um ReplicaSet próprio, para poder fazer rollback depois, bastando aumentar novamente a escala de um ReplicaSet antigo.
O comportamento é definido pelo campo .spec.strategy.type, que aceita um de dois valores: Recreate ou RollingUpdate. Recreate remove todos os pods antigos antes de criar os novos. RollingUpdate, o padrão, substitui os pods gradualmente para que a aplicação permaneça disponível o tempo todo.
Em um rolling update, dois campos controlam a velocidade de substituição dos pods. O maxSurge define quantos pods podem existir acima da contagem desejada durante o rollout, com padrão de 25%, arredondado para cima. O maxUnavailable define quantos pods podem faltar abaixo da contagem desejada durante o rollout, com padrão de 25%, arredondado para baixo. Juntos, eles determinam como os pods são substituídos durante o rollout. maxSurge: 1 com maxUnavailable: 0 adiciona um pod novo antes de remover um antigo e mantém toda a capacidade desejada disponível.
Há mais três campos que controlam o comportamento do rollout. O minReadySeconds faz um pod esperar depois de ficar ready antes de contar como disponível, o que pega um pod que passa no probe e falha em seguida. O progressDeadlineSeconds, com padrão de 600 (10 minutos), é quanto tempo o Kubernetes aguarda por progresso antes de marcar o rollout como falho. E o revisionHistoryLimit, com padrão de 10, é quantos ReplicaSets antigos o Kubernetes mantém para rollback.
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, etc.# Recreate: stop all old pods, then start new onesspec: strategy: type: RecreateNada disso é seguro sem bons probes. Um pod novo só recebe tráfego depois que seu readiness probe passa, então sem um readiness probe atrelado à saúde real da aplicação, o Kubernetes vai enviar tráfego para um pod que não está de fato pronto, e o rollout vai parecer bem-sucedido enquanto os usuários veem erros. Para aplicações que demoram a iniciar, um startup probe segura os demais probes até a aplicação terminar de subir, para que uma inicialização lenta não seja tratada como falha.
Estratégias de deployment nativas do Kubernetes
O Kubernetes tem exatamente dois tipos de estratégia nativos, Recreate e RollingUpdate. Os outros nomes que você vê por aí, como "ramped" e "best-effort controlled", não são recursos separados. São formas específicas de configurar um rolling update. Vamos aos detalhes:
Deployment Recreate
A estratégia Recreate para todos os pods antigos e, em seguida, inicia os novos. Ela é simples e garante que as duas versões nunca rodem ao mesmo tempo, o que é ideal para aplicações que não toleram duas versões simultâneas ou que mantêm um lock exclusivo, como algumas migrações de banco de dados. A contrapartida é o downtime, porque existe um intervalo entre os pods antigos pararem e os novos ficarem prontos.
Rolling update
A estratégia de rolling update substitui os pods gradualmente, mantendo a aplicação disponível o tempo todo. É o padrão e a escolha certa para a maioria dos serviços stateless, e seu ritmo é definido pelos campos maxSurge e maxUnavailable descritos acima.
Ramped slow rollout
Um ramped slow rollout é apenas um rolling update ajustado para avançar de forma lenta e deliberada, por exemplo com maxSurge: 1 e maxUnavailable: 0, de modo que os pods sejam substituídos um por vez. Para ir além e pausar entre lotes para acompanhar cada etapa, você usa um rollout controller como o Argo Rollouts, em vez de só o Deployment. A questão é que "ramped" é uma forma de executar um rolling update, não um mecanismo diferente.
Best-effort controlled rollout
Um best-effort controlled rollout também é um rolling update, configurado para priorizar velocidade. Você define maxUnavailable como uma porcentagem e maxSurge como 0, o que substitui os pods o mais rápido possível sem adicionar capacidade extra, ao custo de operar abaixo da capacidade total durante a atualização. Ele se chama best-effort porque avança tão rápido quanto a indisponibilidade permitida deixar. De novo: é uma configuração de RollingUpdate, não uma estratégia separada.
Estratégias de deployment que exigem service mesh, ingress controller ou rollout controller
As estratégias abaixo são padrões, não tipos nativos de Deployment. O Kubernetes não as implementa para você. Você as constrói com Services e labels, um ingress controller ou service mesh para controle de tráfego, ou um rollout controller como Argo Rollouts ou Flagger:
Deployment blue/green
Você executa dois ambientes completos, a versão atual (blue) e a nova (green), ao mesmo tempo, e muda todo o tráfego de blue para green de uma vez, reapontando um Service. Isso dá rollback instantâneo, já que basta apontar de volta para blue, mas exige aproximadamente o dobro de capacidade enquanto os dois ambientes estão no ar.
Deployment canary
Você envia uma pequena fração do tráfego para a nova versão, monitora as métricas e aumenta a fração gradualmente se tudo continuar saudável. Isso limita o raio de impacto de uma release ruim, mas exige traffic-splitting via mesh ou ingress controller e, idealmente, automação baseada em métricas para promover ou reverter.
Deployment com A/B testing
Uma variação do canary em que você roteia usuários ou requisições específicas para uma versão com base em regras como headers, cookies ou geografia, normalmente para comparar comportamento, e não só testar estabilidade. Exige as mesmas ferramentas de roteamento de tráfego do canary.
Shadow deployment com traffic mirroring
Você envia uma cópia do tráfego real de produção para a nova versão sem retornar as respostas dela aos usuários, podendo testá-la sob carga real com zero impacto no usuário. Exige um service mesh capaz de espelhar tráfego e cuidado para que a versão em shadow não escreva em sistemas de produção.
Dark launch com feature flags
Você implanta o novo código em produção, mas o mantém desligado atrás de uma feature flag, e depois o ativa para usuários selecionados quando estiver pronto. Isso separa o deploy da release e é controlado por um sistema de feature flags, e não pelo Deployment em si.
Comparativo das estratégias de deployment
A tabela a seguir compara as principais estratégias de deployment e seus trade-offs.
| Estratégia | Downtime | Velocidade de rollback | Controle de tráfego | Capacidade extra necessária |
|---|---|---|---|---|
| Recreate | Sim | Lento (redeploy) | Nenhum | Nenhuma |
| Rolling update | Não | Médio | Nenhum | Pequena (maxSurge) |
| Blue/green | Não | Instantâneo | Tudo ou nada | Alta (~2x) |
| Canary | Não | Rápido | Granular | Pequena a média |
| A/B testing | Não | Rápido | Baseado em regras | Pequena a média |
| Shadow | Não | N/A (sem tráfego de usuários) | Espelhado | Média (executa uma cópia completa) |
Quanto cada estratégia de deployment custa em capacidade extra de cluster?
Uma estratégia de deployment não é só uma questão de segurança. Ela também afeta o custo do cluster, porque algumas estratégias exigem capacidade extra enquanto as versões antiga e nova rodam ao mesmo tempo. O exemplo mais claro é o blue/green. Você executa dois ambientes completos durante a troca, o que significa aproximadamente o dobro de pods e, portanto, aproximadamente o dobro de CPU e memória. Se o cluster não tem capacidade ociosa suficiente, o ambiente standby pode exigir nós extras que ficam praticamente parados entre releases, ou o cluster pode precisar escalar a cada release.
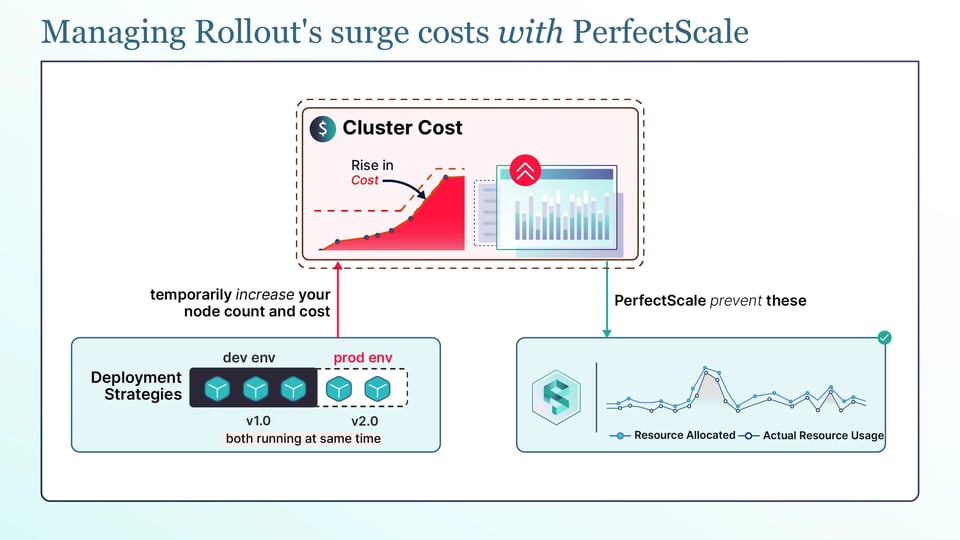
Rolling updates exigem menos capacidade extra, mas não saem de graça. O maxSurge permite pods adicionais acima da contagem desejada durante o rollout, e esses pods também precisam de recursos. Se o cluster não tem espaço para eles, os pods de surge ficam em Pending e o Cluster Autoscaler adiciona nós para executá-los. Ou seja, um rollout pode aumentar temporariamente a contagem de nós e o custo.
O fator mais relevante por trás das duas estratégias são os resource requests dos pods. O scheduling do Kubernetes e o Cluster Autoscaler usam resource requests, não o uso real de CPU e memória. Se um pod solicita muito mais do que normalmente usa, cada pod de surge ou pod duplicado de blue/green reserva esse valor maior. Requests superdimensionados tornam, silenciosamente, cada release mais cara do que precisaria ser.
É aqui que a PerfectScale ajuda. A plataforma de governança de Kubernetes da PerfectScale observa como seus workloads realmente usam CPU e memória e transforma isso em recomendações de right-sizing acionáveis e automatizadas, que você pode aplicar manualmente ou de forma autônoma. Com requests alinhados à realidade, seus pods de surge e standby reservam apenas o necessário, os rollouts param de disparar scale-ups desnecessários e cada release custa menos. Times como Paramount Pictures e Creditas usam a PerfectScale para manter seus clusters eficientes, e você pode experimentar ou agendar uma sessão técnica.
Como autoscaling e controles de disruption interagem com rollouts?
Rollouts podem ser afetados por outros recursos do Kubernetes. Saber como eles interagem ajuda a evitar surpresas:
O Horizontal Pod Autoscaler (HPA) continua ajustando o número de réplicas durante um rolling update, o que é esperado. O problema surge quando você também define replicas no manifesto do Deployment. Cada apply pode resetar a contagem de réplicas para o valor do manifesto, e o HPA então a altera de novo. Isso pode causar scaling inesperado durante o rollout. Para Deployments gerenciados por um HPA, deixe replicas fora do manifesto.
O Vertical Pod Autoscaler (VPA) funciona de outra forma. Ele ajusta os requests de CPU e memória de cada pod com base no uso real. Historicamente, aplicar essas mudanças exigia recriar os pods, o que podia causar disruption. A partir do Kubernetes 1.35, o in-place pod resize está em disponibilidade geral, então os recursos de CPU e memória podem ser alterados em um pod em execução sem recriá-lo. O VPA pode usar isso para fazer right-sizing dos pods com muito menos disruption.
PodDisruptionBudgets (PDBs) costumam ser mal compreendidos durante rollouts. Um PDB não bloqueia o rolling update de um Deployment, porque o Deployment substitui os pods diretamente, em vez de usar a API de eviction. Um PDB limita evictions voluntárias, como node drains e scale-down do Cluster Autoscaler. Ou seja, um PDB não vai deixar um rolling update mais lento, mas pode bloquear um node drain que aconteça ao mesmo tempo. Por exemplo, definir minAvailable igual ao número total de réplicas pode impedir completamente disruptions voluntárias.
Escolhendo a estratégia de deployment certa para cada tipo de workload
A estratégia de deployment certa depende do que você está implantando:
Serviços HTTP e APIs stateless
Um rolling update é a escolha padrão, já que esses serviços escalam horizontalmente e toleram duas versões ao mesmo tempo. Quando precisar reduzir o risco em um serviço de alto tráfego, adicione um canary por cima com traffic-splitting, para validar a nova versão com uma fatia do tráfego primeiro.
Aplicações stateful com volumes persistentes
Essas aplicações muitas vezes não podem rodar duas versões sobre os mesmos dados ao mesmo tempo, então Recreate, ou um StatefulSet com atualizações ordenadas e cuidadosas, costuma ser mais seguro do que um rolling update comum. Aceite o curto downtime em vez de arriscar corrupção de dados por versões sobrepostas.
Batch jobs, consumidores de fila e CronJobs
Não são serviços de longa duração, então o downtime do rollout importa menos. Um rolling update ou até um recreate costuma ser suficiente, e a preocupação real é drenar o trabalho em andamento de forma limpa antes de os pods antigos pararem.
Workloads de GPU e inferência de machine learning
Nós de GPU são caros e escassos, o que torna estratégias com muito surge custosas, já que manter capacidade de GPU ociosa para um blue/green ou um maxSurge alto sai caro. Prefira um rolling update com maxSurge pequeno, ou um canary, e dimensione os requests com cuidado para não reservar GPUs inteiras que você não usa.
Boas práticas de estratégia de deployment no Kubernetes
As práticas a seguir podem tornar os deployments mais seguros e mais eficientes em custo:
1. Faça o right-sizing dos resource requests antes de ajustar a velocidade do rollout
Como pods de surge e standby reservam requests, requests precisos fazem mais pelo custo do rollout do que qualquer ajuste de estratégia. Acerte o dimensionamento primeiro, depois ajuste o rollout.
2. Condicione todo rollout a readiness probes atrelados a sinais reais de saúde
Um readiness probe que só verifica se o processo está no ar vai passar mesmo com a aplicação quebrada. Atrele-o a um health check real, para que o Kubernetes só envie tráfego para pods que realmente conseguem atendê-lo.
3. Defina um PodDisruptionBudget para todo workload de produção
Um PDB não vai deixar seus rollouts mais lentos, mas protege sua aplicação durante node drains e scale-down do autoscaler, limitando quantos pods podem ser removidos de uma vez. Todo workload de produção deve ter um.
4. Automatize o rollback em falhas de health check ou de SLO
Não dependa de uma pessoa olhando um dashboard. Use um rollout controller como Argo Rollouts ou Flagger para promover ou reverter automaticamente com base em métricas, de modo que uma release ruim seja revertida antes de se espalhar.
5. Mantenha contagens de réplicas e node pools alinhados com a folga do maxSurge
Garanta que o cluster tenha espaço para os pods de surge que um rollout cria. Se não tiver, mantenha uma pequena folga ou aceite que o autoscaler vai adicionar nós a cada release.
6. Revise custos e desperdício de recursos após cada release
Uma release pode mudar silenciosamente seu consumo de recursos. Compare o uso com os requests após os rollouts para que over-provisioning e drift não se acumulem com o tempo.