


Eine Kubernetes Deployment-Strategie ist die Methode, mit der Sie die laufende Version einer Anwendung durch eine neue ersetzen. Sie bestimmt, wie die alten Pods den neuen Platz machen: alle auf einmal, schrittweise oder parallel mit Traffic-Umschaltung zwischen beiden. Die gewählte Strategie entscheidet, ob Nutzer Ausfallzeiten bemerken, wie schnell Sie ein Rollback durchführen können und wie viel freie Kapazität das Update benötigt.
In diesem Leitfaden erfahren Sie, wie das Deployment-Objekt einen Rollout steuert, welche Strategien in Kubernetes integriert sind, welche Patterns zusätzliches Tooling erfordern, was jede Variante an Cluster-Kapazität kostet, wie sie mit Autoscaling zusammenspielen und wie Sie die passende Strategie für Ihre Workloads finden.
Was ist eine Kubernetes Deployment-Strategie?
Eine Deployment-Strategie beschreibt, wie ein Deployment von der aktuellen Version Ihrer App zu einer neuen wechselt. Wenn Sie ein Deployment ändern, muss Kubernetes die Pods mit der alten Version durch Pods mit der neuen Version ersetzen – die Strategie ist die Regel dafür, wie das geschieht.
Die Wahl ist entscheidend, weil jede Strategie drei Dinge gegeneinander abwägt: wie viel Ausfallzeit Nutzer sehen, wie schnell Sie ein fehlerhaftes Release rückgängig machen können und wie viel zusätzliche Kapazität der Rollout benötigt, solange beide Versionen parallel laufen. Kubernetes bringt zwei Strategien direkt im Deployment-Objekt mit; weitere, fortgeschrittenere Patterns bauen Sie mit zusätzlichem Tooling darauf auf.
Wie das Kubernetes-Deployment-Objekt einen Rollout steuert
Jede Rollout-Strategie nutzt denselben Deployment-Prozess. Es lohnt sich daher zu verstehen, was passiert, wenn Sie ein Deployment aktualisieren. Schauen wir uns das an:
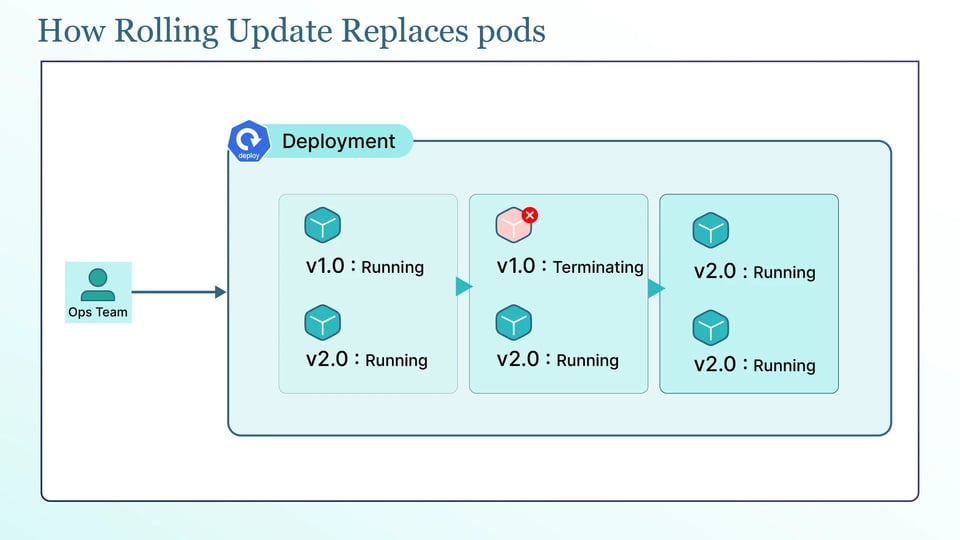
Wenn Sie das Pod-Template eines Deployments aktualisieren, bearbeitet Kubernetes nicht die laufenden Pods. Es erstellt ein neues ReplicaSet für die neue Version und passt die Pod-Anzahl der beiden ReplicaSets an: Das neue wird hochskaliert, während das alte herunterskaliert wird. Die Pods selbst werden nie verändert, sondern ersetzt, und das Deployment führt jede Version als eigenes ReplicaSet, sodass es später per Hochskalieren eines alten ReplicaSets ein Rollback durchführen kann.
Das Verhalten wird über das Feld .spec.strategy.type festgelegt, das einen von zwei Werten annimmt: Recreate oder RollingUpdate. Recreate entfernt alle alten Pods, bevor die neuen erstellt werden. RollingUpdate, der Standard, ersetzt Pods schrittweise, sodass die App durchgehend verfügbar bleibt.
Bei einem Rolling Update steuern zwei Felder, wie schnell Pods ersetzt werden. maxSurge legt fest, wie viele Pods während des Rollouts über der gewünschten Anzahl existieren dürfen; der Standardwert ist 25 %, aufgerundet. maxUnavailable legt fest, wie viele Pods während des Rollouts unter der gewünschten Anzahl fehlen dürfen; der Standardwert ist 25 %, abgerundet. Zusammen bestimmen sie, wie Pods während des Rollouts ersetzt werden. maxSurge: 1 mit maxUnavailable: 0 fügt einen neuen Pod hinzu, bevor ein alter entfernt wird, und hält so die volle gewünschte Kapazität verfügbar.
Drei weitere Felder steuern das Rollout-Verhalten. minReadySeconds lässt einen Pod nach dem Erreichen des Ready-Status noch warten, bevor er als verfügbar zählt – das fängt Pods ab, die ihre Probe bestehen und danach abstürzen. progressDeadlineSeconds, standardmäßig 600 (10 Minuten), legt fest, wie lange Kubernetes auf Fortschritt wartet, bevor der Rollout als fehlgeschlagen markiert wird. Und revisionHistoryLimit, standardmäßig 10, bestimmt, wie viele alte ReplicaSets Kubernetes für Rollbacks aufbewahrt.
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, etc.# Recreate: stop all old pods, then start new onesspec: strategy: type: RecreateOhne gute Probes ist all das nicht sicher. Ein neuer Pod erhält erst Traffic, wenn seine Readiness Probe erfolgreich ist. Ohne eine Readiness Probe, die an echte Health-Signale gekoppelt ist, schickt Kubernetes Traffic an einen Pod, der in Wirklichkeit noch nicht bereit ist – der Rollout sieht erfolgreich aus, während Nutzer Fehler sehen. Für Apps mit langsamem Start hält eine Startup Probe die anderen Probes zurück, bis die App fertig gestartet ist, sodass ein langsamer Start nicht als Fehler gewertet wird.
In Kubernetes integrierte Deployment-Strategien
Kubernetes kennt genau zwei native Strategietypen: Recreate und RollingUpdate. Andere Bezeichnungen wie "ramped" und "best-effort controlled" sind keine eigenständigen Features, sondern bestimmte Konfigurationen eines Rolling Update. Im Detail:
Recreate-Deployment
Die Recreate-Strategie stoppt jeden alten Pod und startet dann die neuen. Sie ist einfach und garantiert, dass die beiden Versionen nie gleichzeitig laufen – ideal für Apps, die zwei parallele Versionen nicht tolerieren oder einen exklusiven Lock halten, etwa bei manchen Datenbankmigrationen. Der Preis dafür ist Ausfallzeit, weil zwischen dem Stoppen der alten Pods und der Bereitschaft der neuen eine Lücke entsteht.
Rolling Update
Die Rolling-Update-Strategie ersetzt Pods schrittweise und hält die App dabei durchgehend verfügbar. Sie ist der Standard und die richtige Wahl für die meisten zustandslosen Services; ihr Tempo wird über die oben beschriebenen Felder maxSurge und maxUnavailable gesteuert.
Ramped Slow Rollout
Ein Ramped Slow Rollout ist schlicht ein Rolling Update, das bewusst langsam konfiguriert ist – zum Beispiel mit maxSurge: 1 und maxUnavailable: 0, sodass Pods einzeln ersetzt werden. Wer weiter gehen und zwischen den Schritten pausieren möchte, um jeden Schritt zu beobachten, nutzt einen Rollout-Controller wie Argo Rollouts statt des Deployments allein. Der Punkt ist: "ramped" ist eine Art, ein Rolling Update auszuführen, kein anderer Mechanismus.
Best-Effort Controlled Rollout
Ein Best-Effort Controlled Rollout ist ebenfalls ein Rolling Update, konfiguriert auf maximale Geschwindigkeit. Sie setzen maxUnavailable auf einen Prozentwert und maxSurge auf 0, wodurch Pods so schnell wie möglich ersetzt werden, ohne zusätzliche Kapazität zu belegen – um den Preis, während des Updates unter voller Kapazität zu laufen. "Best-effort" heißt es, weil der Rollout so schnell voranschreitet, wie es die erlaubte Nichtverfügbarkeit zulässt. Auch hier gilt: eine Konfiguration von RollingUpdate, keine eigene Strategie.
Deployment-Strategien, die ein Service Mesh, einen Ingress-Controller oder einen Rollout-Controller erfordern
Die folgenden Strategien sind Patterns, keine integrierten Deployment-Typen. Kubernetes implementiert sie nicht für Sie. Sie bauen sie mit Services und Labels, einem Ingress-Controller oder Service Mesh für die Traffic-Steuerung oder einem Rollout-Controller wie Argo Rollouts oder Flagger:
Blue/Green-Deployment
Sie betreiben zwei vollständige Umgebungen – die aktuelle Version (Blue) und die neue Version (Green) – gleichzeitig und schalten den gesamten Traffic auf einmal von Blue auf Green um, indem Sie einen Service umleiten. Das ermöglicht ein sofortiges Rollback, da Sie einfach wieder auf Blue zeigen, benötigt aber ungefähr die doppelte Kapazität, solange beide Umgebungen laufen.
Canary-Deployment
Sie leiten einen kleinen Teil des Traffics auf die neue Version, beobachten deren Metriken und erhöhen den Anteil schrittweise, solange sie stabil bleibt. Das begrenzt den Schaden eines fehlerhaften Releases, erfordert aber Traffic-Splitting über ein Mesh oder einen Ingress-Controller – und idealerweise metrikbasierte Automatisierung für Promotion oder Rollback.
A/B-Testing-Deployment
Eine Variante des Canary-Deployments, bei der Sie bestimmte Nutzer oder Requests anhand von Regeln wie Headern, Cookies oder Geografie auf eine Version routen – meist, um Verhalten zu vergleichen, nicht nur um Stabilität zu testen. Es benötigt dasselbe Traffic-Routing-Tooling wie ein Canary-Deployment.
Shadow-Deployment mit Traffic-Mirroring
Sie senden eine Kopie des echten Produktions-Traffics an die neue Version, ohne deren Antworten an die Nutzer zurückzugeben. So testen Sie unter realer Last ohne jede Auswirkung auf Nutzer. Dafür braucht es ein Service Mesh, das Traffic spiegeln kann, und Sorgfalt, damit die Shadow-Version nicht in Produktionssysteme schreibt.
Dark Launch mit Feature Flags
Sie deployen den neuen Code in die Produktion, lassen ihn aber hinter einem Feature Flag ausgeschaltet und aktivieren ihn für ausgewählte Nutzer, wenn Sie bereit sind. Das trennt das Deployen vom Releasen und wird von einem Feature-Flag-System gesteuert – nicht vom Deployment selbst.
Deployment-Strategien im Vergleich
Die folgende Tabelle vergleicht die wichtigsten Deployment-Strategien und ihre Trade-offs.
| Strategie | Ausfallzeit | Rollback-Geschwindigkeit | Traffic-Steuerung | Benötigte Reservekapazität |
|---|---|---|---|---|
| Recreate | Ja | Langsam (erneutes Deployment) | Keine | Keine |
| Rolling Update | Nein | Mittel | Keine | Gering (maxSurge) |
| Blue/Green | Nein | Sofort | Alles oder nichts | Hoch (~2x) |
| Canary | Nein | Schnell | Feingranular | Gering bis mittel |
| A/B-Testing | Nein | Schnell | Regelbasiert | Gering bis mittel |
| Shadow | Nein | Entfällt (kein Nutzer-Traffic) | Gespiegelt | Mittel (vollständige Kopie läuft) |
Was jede Deployment-Strategie an zusätzlicher Cluster-Kapazität kostet
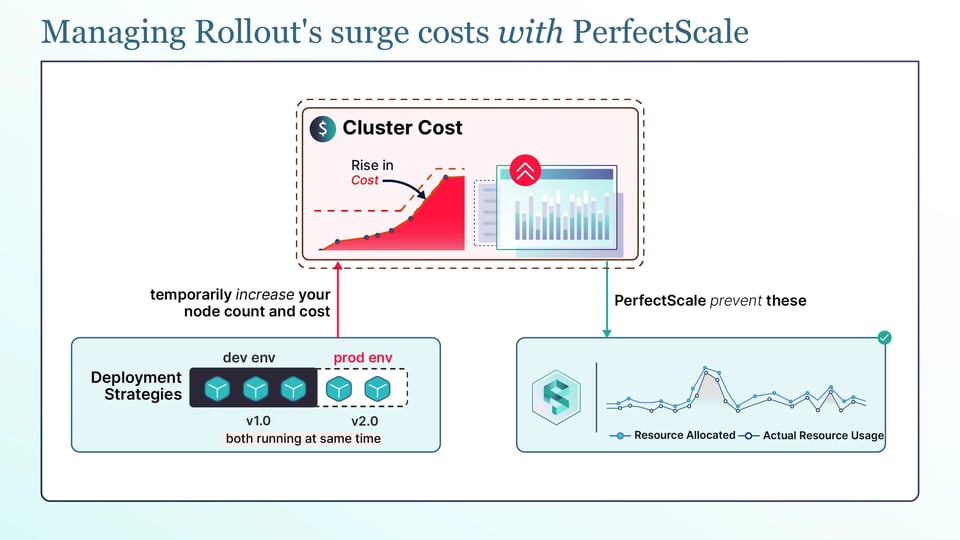
Bei einer Deployment-Strategie geht es nicht nur um Sicherheit. Sie beeinflusst auch die Cluster-Kosten, denn manche Strategien benötigen zusätzliche Kapazität, solange alte und neue Version gleichzeitig laufen. Das deutlichste Beispiel ist Blue/Green: Während der Umschaltung laufen zwei vollständige Umgebungen, also ungefähr doppelt so viele Pods und damit ungefähr doppelt so viel CPU und Arbeitsspeicher. Hat Ihr Cluster nicht genug freie Kapazität, braucht die Standby-Umgebung womöglich zusätzliche Nodes, die zwischen Releases weitgehend ungenutzt bleiben – oder der Cluster muss bei jedem Release hochskalieren.
Rolling Updates benötigen weniger zusätzliche Kapazität, sind aber nicht kostenlos. maxSurge erlaubt zusätzliche Pods über der gewünschten Anzahl während des Rollouts, und diese Pods brauchen trotzdem Ressourcen. Hat der Cluster keinen Platz dafür, bleiben die Surge-Pods im Status Pending, und der Cluster Autoscaler fügt Nodes hinzu, um sie auszuführen. Ein Rollout kann Ihre Node-Anzahl und Kosten also vorübergehend erhöhen.
Der größere Faktor hinter beiden Strategien sind die Resource Requests der Pods. Das Kubernetes-Scheduling und der Cluster Autoscaler arbeiten mit Resource Requests, nicht mit der tatsächlichen CPU- und Speichernutzung. Fordert ein Pod deutlich mehr an, als er üblicherweise nutzt, reserviert jeder Surge-Pod und jeder duplizierte Blue/Green-Pod diese größere Menge. Überdimensionierte Requests machen so unbemerkt jedes Release teurer als nötig.
Genau hier hilft PerfectScale. Die Kubernetes-Governance-Plattform beobachtet, wie Ihre Workloads CPU und Arbeitsspeicher tatsächlich nutzen, und macht daraus umsetzbare, automatisierte Right-Sizing-Empfehlungen, die Sie manuell oder autonom anwenden können. Mit Requests, die der Realität entsprechen, reservieren Ihre Surge- und Standby-Pods nur das, was sie wirklich brauchen – Rollouts lösen keine unnötigen Scale-ups mehr aus, und jedes Release kostet weniger. Teams wie Paramount Pictures und Creditas halten ihre Cluster mit PerfectScale effizient. Probieren Sie es aus oder buchen Sie eine technische Session.
Wie Autoscaling und Disruption-Kontrollen mit Rollouts zusammenspielen
Rollouts können von anderen Kubernetes-Features beeinflusst werden. Wer das Zusammenspiel kennt, vermeidet Überraschungen:
Der Horizontal Pod Autoscaler (HPA) passt die Anzahl der Replicas auch während eines Rolling Update weiter an – das ist beabsichtigt. Problematisch wird es, wenn Sie zusätzlich replicas im Deployment-Manifest setzen. Jedes Apply kann die Replica-Anzahl auf den Wert im Manifest zurücksetzen, den der HPA dann wieder ändert. Das kann zu unerwartetem Skalieren während des Rollouts führen. Lassen Sie bei Deployments, die ein HPA verwaltet, replicas im Manifest weg.
Der Vertical Pod Autoscaler (VPA) funktioniert anders. Er passt die CPU- und Speicher-Requests jedes Pods anhand der tatsächlichen Nutzung an. In der Vergangenheit erforderte das Anwenden dieser Änderungen das Neuerstellen der Pods, was Unterbrechungen verursachen konnte. Seit Kubernetes 1.35 ist In-Place Pod Resize allgemein verfügbar, sodass CPU- und Speicherressourcen an einem laufenden Pod geändert werden können, ohne ihn neu zu erstellen. Der VPA kann das nutzen, um Pods mit deutlich weniger Unterbrechungen per Right-Sizing anzupassen.
PodDisruptionBudgets (PDBs) werden im Kontext von Rollouts oft missverstanden. Ein PDB blockiert das Rolling Update eines Deployments nicht, weil das Deployment Pods direkt ersetzt, statt die Eviction-API zu nutzen. Ein PDB begrenzt stattdessen freiwillige Evictions, etwa Node Drains und das Herunterskalieren durch den Cluster Autoscaler. Ein PDB verlangsamt also kein Rolling Update, kann aber einen gleichzeitig laufenden Node Drain blockieren. Wird minAvailable etwa gleich der Gesamtzahl der Replicas gesetzt, können freiwillige Unterbrechungen vollständig verhindert werden.
Die passende Deployment-Strategie für Ihren Workload-Typ
Welche Deployment-Strategie die richtige ist, hängt davon ab, was Sie deployen:
Zustandslose HTTP-Services und APIs
Ein Rolling Update ist die Standardwahl, da diese horizontal skalieren und zwei parallele Versionen tolerieren. Wenn Sie das Risiko bei einem Service mit hohem Traffic reduzieren möchten, ergänzen Sie ein Canary-Deployment mit Traffic-Splitting, um die neue Version zunächst mit einem Teil des Traffics zu validieren.
Zustandsbehaftete Anwendungen mit Persistent Volumes
Diese können oft nicht mit zwei Versionen gleichzeitig auf denselben Daten laufen. Recreate – oder ein StatefulSet mit sorgfältig geordneten Updates – ist daher meist sicherer als ein naives Rolling Update. Nehmen Sie die kurze Ausfallzeit in Kauf, statt Datenkorruption durch überlappende Versionen zu riskieren.
Batch-Jobs, Queue-Consumer und CronJobs
Das sind keine dauerhaft laufenden Services, Rollout-Ausfallzeiten fallen daher weniger ins Gewicht. Ein Rolling Update oder sogar ein Recreate ist in der Regel in Ordnung; entscheidend ist, laufende Arbeit sauber abzuschließen, bevor alte Pods stoppen.
GPU- und Machine-Learning-Inferenz-Workloads
GPU-Nodes sind teuer und knapp, was Surge-lastige Strategien kostspielig macht: Freie GPU-Kapazität für ein Blue/Green-Deployment oder ein großzügiges maxSurge vorzuhalten ist teuer. Bevorzugen Sie ein Rolling Update mit kleinem maxSurge oder ein Canary-Deployment, und dimensionieren Sie Requests sorgfältig, damit Sie keine ganzen GPUs reservieren, die Sie nicht nutzen.
Best Practices für Kubernetes Deployment-Strategien
Mit den folgenden Praktiken werden Deployments sicherer und kosteneffizienter:
1. Resource Requests per Right-Sizing anpassen, bevor Sie die Rollout-Geschwindigkeit tunen
Da Surge- und Standby-Pods ihre Requests reservieren, bringen akkurate Requests mehr für die Rollout-Kosten als jede Strategie-Feinjustierung. Erst die Dimensionierung in Ordnung bringen, dann den Rollout tunen.
2. Jeden Rollout mit Readiness Probes absichern, die an echte Health-Signale gekoppelt sind
Eine Readiness Probe, die nur prüft, ob der Prozess läuft, meldet Erfolg, obwohl die App noch kaputt ist. Koppeln Sie sie an einen echten Health Check, damit Kubernetes nur Pods Traffic schickt, die ihn tatsächlich bedienen können.
3. Für jeden Produktions-Workload ein PodDisruptionBudget setzen
Ein PDB verlangsamt Ihre Rollouts nicht, schützt Ihre App aber bei Node Drains und beim Herunterskalieren durch den Autoscaler, indem es begrenzt, wie viele Pods gleichzeitig entfernt werden dürfen. Jeder Produktions-Workload sollte eines haben.
4. Rollbacks bei fehlgeschlagenen Health- oder SLO-Checks automatisieren
Verlassen Sie sich nicht darauf, dass jemand ein Dashboard beobachtet. Nutzen Sie einen Rollout-Controller wie Argo Rollouts oder Flagger, der auf Basis von Metriken automatisch promotet oder zurückrollt, damit ein fehlerhaftes Release zurückgenommen wird, bevor es sich ausbreitet.
5. Replica-Anzahl und Node Pools auf den maxSurge-Puffer abstimmen
Stellen Sie sicher, dass der Cluster Platz für die Surge-Pods hat, die ein Rollout erzeugt. Falls nicht, halten Sie entweder etwas Puffer vor oder akzeptieren Sie, dass der Autoscaler bei jedem Release Nodes hinzufügt.
6. Kosten und Ressourcenverschwendung nach jedem Release prüfen
Ein Release kann Ihren Ressourcen-Fußabdruck unbemerkt verändern. Prüfen Sie nach Rollouts die Nutzung gegen die Requests, damit sich Überprovisionierung und Drift nicht mit der Zeit ansammeln.