


Une stratégie de déploiement Kubernetes est la méthode utilisée pour remplacer la version en cours d'exécution d'une application par une nouvelle. Elle détermine comment les anciens pods cèdent la place aux nouveaux : tous d'un coup, progressivement, ou côte à côte avec un basculement du trafic entre les deux. La stratégie choisie conditionne l'interruption perçue par les utilisateurs, la rapidité avec laquelle vous pouvez revenir en arrière et la capacité supplémentaire nécessaire pendant la mise à jour.
Dans ce guide, vous découvrirez comment l'objet Deployment contrôle un rollout, les stratégies intégrées à Kubernetes, les patterns qui nécessitent des outils supplémentaires, le coût de chacune en capacité de cluster, leurs interactions avec l'autoscaling et comment choisir la stratégie adaptée à votre workload.
Qu'est-ce qu'une stratégie de déploiement Kubernetes ?
Une stratégie de déploiement définit la manière dont un Deployment passe de la version actuelle de votre application à une nouvelle. Lorsque vous modifiez un Deployment, Kubernetes doit remplacer les pods exécutant l'ancienne version par des pods exécutant la nouvelle, et la stratégie est la règle qui régit ce remplacement.
Ce choix est important, car chaque stratégie arbitre entre trois éléments : la durée d'interruption perçue par les utilisateurs, la rapidité avec laquelle vous pouvez annuler une mauvaise release et la capacité supplémentaire nécessaire pendant que les deux versions coexistent. Kubernetes propose deux stratégies intégrées à l'objet Deployment, ainsi que plusieurs patterns plus avancés que vous construisez par-dessus avec des outils supplémentaires.
Comment l'objet Deployment de Kubernetes contrôle-t-il un rollout ?
Toutes les stratégies de rollout s'appuient sur le même mécanisme de Deployment, il est donc utile de comprendre ce qui se passe lorsque vous mettez à jour un Deployment. Voyons cela en détail :
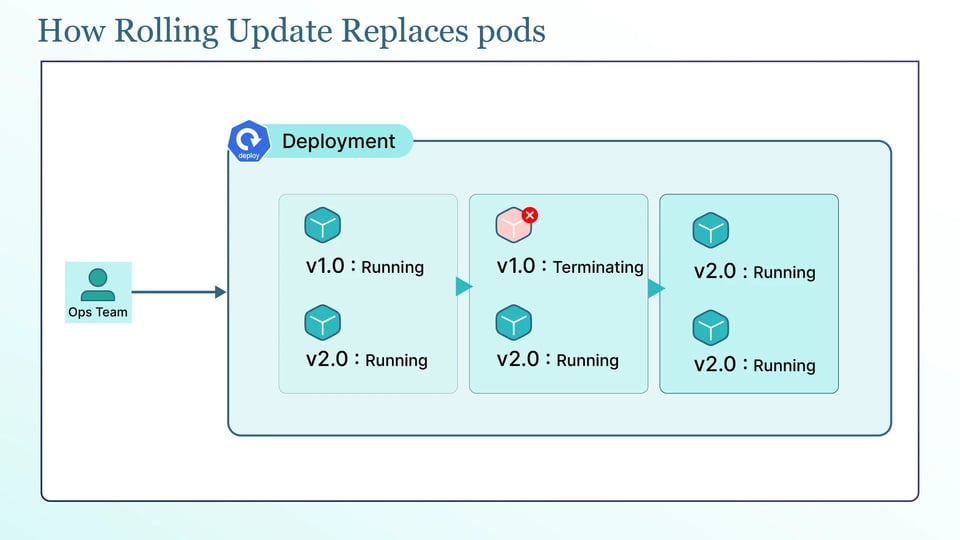
Lorsque vous mettez à jour le template de pod d'un Deployment, Kubernetes ne modifie pas les pods en cours d'exécution. Il crée un nouveau ReplicaSet pour la nouvelle version et ajuste le nombre de pods des deux ReplicaSets : celui du nouveau augmente tandis que celui de l'ancien diminue. Les pods eux-mêmes ne sont jamais modifiés, ils sont remplacés, et le Deployment conserve chaque version dans son propre ReplicaSet afin de pouvoir revenir en arrière plus tard en remontant un ancien ReplicaSet.
Le comportement est défini par le champ .spec.strategy.type, qui accepte deux valeurs : Recreate ou RollingUpdate. Recreate supprime tous les anciens pods avant de créer les nouveaux. RollingUpdate, la valeur par défaut, remplace les pods progressivement afin que l'application reste disponible tout au long du processus.
Pour une mise à jour progressive, deux champs contrôlent la vitesse de remplacement des pods. maxSurge définit le nombre de pods pouvant exister au-delà du nombre souhaité pendant le rollout, avec une valeur par défaut de 25 %, arrondie à l'entier supérieur. maxUnavailable définit le nombre de pods pouvant manquer en dessous du nombre souhaité pendant le rollout, avec une valeur par défaut de 25 %, arrondie à l'entier inférieur. Ensemble, ils déterminent comment les pods sont remplacés pendant le rollout. maxSurge: 1 avec maxUnavailable: 0 ajoute un nouveau pod avant d'en retirer un ancien et maintient la totalité de la capacité souhaitée disponible.
Trois autres champs contrôlent le comportement du rollout. minReadySeconds impose à un pod d'attendre après être devenu prêt avant d'être comptabilisé comme disponible, ce qui permet de détecter un pod qui passe sa probe puis plante. progressDeadlineSeconds, dont la valeur par défaut est 600 (10 minutes), correspond au délai pendant lequel Kubernetes attend une progression avant de marquer le rollout comme échoué. Et revisionHistoryLimit, 10 par défaut, correspond au nombre d'anciens ReplicaSets que Kubernetes conserve pour un éventuel rollback.
apiVersion: apps/v1kind: Deploymentmetadata: name: apispec: strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 minReadySeconds: 10 progressDeadlineSeconds: 600 # selector, template, etc.# Recreate: stop all old pods, then start new onesspec: strategy: type: RecreateRien de tout cela n'est sûr sans de bonnes probes. Un nouveau pod ne reçoit du trafic qu'une fois sa readiness probe validée ; sans une readiness probe liée à l'état de santé réel de l'application, Kubernetes enverra du trafic vers un pod qui n'est pas réellement prêt, et le rollout semblera réussi alors que les utilisateurs rencontrent des erreurs. Pour les applications lentes à démarrer, une startup probe retarde les autres probes jusqu'à la fin du démarrage, afin qu'un démarrage lent ne soit pas interprété comme un échec.
Les stratégies de déploiement intégrées à Kubernetes
Kubernetes propose exactement deux types de stratégies natives, Recreate et RollingUpdate. Les autres appellations que vous rencontrez, comme ramped ou best-effort controlled, ne sont pas des fonctionnalités distinctes. Ce sont des façons spécifiques de configurer une mise à jour progressive. Entrons dans le détail :
Déploiement Recreate
La stratégie Recreate arrête tous les anciens pods, puis démarre les nouveaux. Simple, elle garantit que les deux versions ne s'exécutent jamais en même temps, ce qui convient aux applications ne tolérant pas deux versions simultanées ou détenant un verrou exclusif, comme certaines migrations de bases de données. La contrepartie est une interruption de service, car il existe un laps de temps entre l'arrêt des anciens pods et la disponibilité des nouveaux.
Rolling update (mise à jour progressive)
La stratégie de mise à jour progressive remplace les pods graduellement, en maintenant l'application disponible en permanence. C'est la stratégie par défaut et le bon choix pour la plupart des services stateless ; son rythme est défini par les champs maxSurge et maxUnavailable décrits plus haut.
Ramped slow rollout
Un ramped slow rollout n'est qu'une mise à jour progressive configurée pour avancer lentement et de façon délibérée, par exemple avec maxSurge: 1 et maxUnavailable: 0, afin que les pods soient remplacés un par un. Pour aller plus loin et marquer une pause entre chaque lot afin d'observer chaque étape, utilisez un contrôleur de rollout comme Argo Rollouts plutôt que le Deployment seul. L'essentiel à retenir : ramped est une façon d'exécuter une mise à jour progressive, pas un moteur différent.
Best-effort controlled rollout
Un best-effort controlled rollout est également une mise à jour progressive, configurée pour privilégier la vitesse. Vous définissez maxUnavailable en pourcentage et maxSurge à 0, ce qui remplace les pods aussi vite que possible sans ajouter de capacité supplémentaire, au prix d'un fonctionnement en capacité réduite pendant la mise à jour. On parle de best-effort car le rollout avance aussi vite que l'indisponibilité autorisée le permet. Là encore, il s'agit d'une configuration de RollingUpdate, pas d'une stratégie distincte.
Les stratégies de déploiement nécessitant un service mesh, un ingress controller ou un contrôleur de rollout
Les stratégies ci-dessous sont des patterns, pas des types de Deployment natifs. Kubernetes ne les implémente pas pour vous. Vous les construisez avec des Services et des labels, un ingress controller ou un service mesh pour le contrôle du trafic, ou un contrôleur de rollout comme Argo Rollouts ou Flagger :
Déploiement blue/green
Vous exécutez deux environnements complets en parallèle, la version actuelle (blue) et la nouvelle version (green), puis basculez tout le trafic de blue vers green d'un coup en redirigeant un Service. Le rollback est instantané, puisqu'il suffit de rediriger le trafic vers blue, mais cela nécessite environ le double de capacité tant que les deux environnements tournent.
Déploiement canary
Vous envoyez une petite partie du trafic vers la nouvelle version, surveillez ses métriques et augmentez progressivement cette part si tout reste sain. Cela limite l'impact d'une mauvaise release, mais nécessite une répartition du trafic via un mesh ou un ingress controller, et idéalement une automatisation basée sur les métriques pour promouvoir ou annuler le déploiement.
Déploiement A/B testing
Une variante du canary où vous routez des utilisateurs ou des requêtes spécifiques vers une version selon des règles comme les en-têtes, les cookies ou la géographie, généralement pour comparer des comportements plutôt que pour tester la stabilité. Les outils de routage de trafic requis sont les mêmes que pour un canary.
Déploiement shadow avec mise en miroir du trafic
Vous envoyez une copie du trafic de production réel vers la nouvelle version sans renvoyer ses réponses aux utilisateurs, afin de la tester en conditions de charge réelles sans aucun impact utilisateur. Cela nécessite un service mesh capable de mettre le trafic en miroir, et une vigilance particulière pour que la version shadow n'écrive pas dans les systèmes de production.
Dark launch avec feature flags
Vous déployez le nouveau code en production, mais le laissez désactivé derrière un feature flag, puis l'activez pour des utilisateurs choisis lorsque vous êtes prêt. Cela dissocie le déploiement de la mise en service, et c'est le système de feature flags qui pilote le tout, pas le Deployment.
Comparatif des stratégies de déploiement
Le tableau suivant compare les principales stratégies de déploiement et leurs compromis.
| Stratégie | Interruption | Vitesse de rollback | Contrôle du trafic | Capacité supplémentaire requise |
|---|---|---|---|---|
| Recreate | Oui | Lente (redéploiement) | Aucun | Aucune |
| Rolling update | Non | Moyenne | Aucun | Faible (maxSurge) |
| Blue/green | Non | Instantanée | Tout ou rien | Élevée (~2x) |
| Canary | Non | Rapide | Granulaire | Faible à moyenne |
| A/B testing | Non | Rapide | Basé sur des règles | Faible à moyenne |
| Shadow | Non | N/A (pas de trafic utilisateur) | En miroir | Moyenne (copie complète) |
Combien coûte chaque stratégie de déploiement en capacité de cluster ?
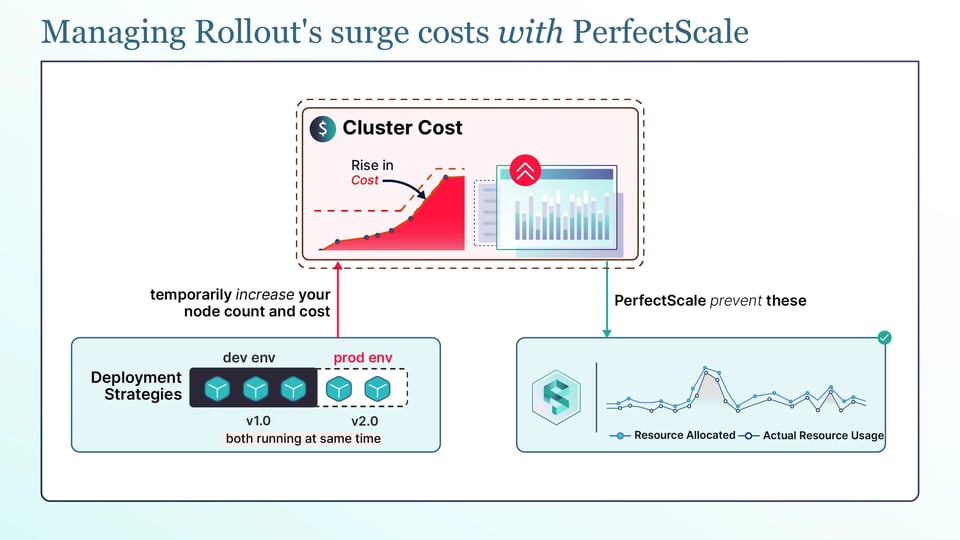
Une stratégie de déploiement n'est pas qu'une question de sécurité. Elle a aussi un impact sur le coût du cluster, car certaines stratégies nécessitent une capacité supplémentaire tant que l'ancienne et la nouvelle version tournent en même temps. L'exemple le plus parlant est le blue/green. Vous exécutez deux environnements complets pendant la bascule, soit environ deux fois plus de pods et donc environ deux fois plus de CPU et de mémoire. Si votre cluster manque de capacité disponible, l'environnement de secours peut nécessiter des nœuds supplémentaires qui restent largement inutilisés entre les releases, ou le cluster peut devoir monter en charge à chaque release.
Les mises à jour progressives demandent moins de capacité supplémentaire, mais elles ne sont pas gratuites. maxSurge autorise des pods supplémentaires au-delà du nombre souhaité pendant le rollout, et ces pods ont eux aussi besoin de ressources. Si le cluster n'a pas de place pour eux, les pods de surge restent en Pending et le Cluster Autoscaler ajoute des nœuds pour les exécuter. Un rollout peut donc augmenter temporairement votre nombre de nœuds et votre coût.
Le facteur déterminant derrière ces deux stratégies, ce sont les resource requests des pods. L'ordonnancement Kubernetes et le Cluster Autoscaler s'appuient sur les resource requests, pas sur l'utilisation réelle de CPU et de mémoire. Si un pod demande bien plus qu'il n'utilise habituellement, chaque pod de surge ou pod blue/green dupliqué réserve ce montant surdimensionné. Des requests surprovisionnées rendent discrètement chaque release plus coûteuse qu'elle ne devrait l'être.
C'est là que PerfectScale fait la différence. Sa plateforme de gouvernance Kubernetes observe la consommation réelle de CPU et de mémoire de vos workloads et la transforme en recommandations de right-sizing actionnables et automatisées, applicables manuellement ou de manière autonome. Avec des requests qui reflètent la réalité, vos pods de surge et de secours ne réservent que le nécessaire : les rollouts ne déclenchent plus de scale-ups inutiles et chaque release coûte moins cher. Des équipes comme Paramount Pictures et Creditas s'appuient sur PerfectScale pour maintenir l'efficacité de leurs clusters, et vous pouvez l'essayer ou réserver une session technique.
Comment l'autoscaling et les contrôles de disruption interagissent-ils avec les rollouts ?
Les rollouts peuvent être affectés par d'autres fonctionnalités de Kubernetes. Comprendre comment elles interagissent vous évite les mauvaises surprises :
Le Horizontal Pod Autoscaler (HPA) continue d'ajuster le nombre de réplicas pendant une mise à jour progressive, ce qui est normal. Le problème survient lorsque vous définissez aussi replicas dans le manifeste du Deployment. Chaque apply peut réinitialiser le nombre de réplicas à la valeur du manifeste, que le HPA modifie ensuite à nouveau. Cela peut provoquer un scaling inattendu pendant le rollout. Pour les Deployments gérés par un HPA, omettez replicas du manifeste.
Le Vertical Pod Autoscaler (VPA) fonctionne différemment. Il ajuste les requests CPU et mémoire de chaque pod en fonction de l'utilisation réelle. Historiquement, l'application de ces changements nécessitait de recréer les pods, ce qui pouvait causer des perturbations. Depuis Kubernetes 1.35, le redimensionnement des pods en place est disponible en version stable : les ressources CPU et mémoire peuvent être modifiées sur un pod en cours d'exécution sans le recréer. Le VPA peut en tirer parti pour appliquer le right-sizing des pods avec beaucoup moins de perturbations.
Les PodDisruptionBudgets (PDB) sont souvent mal compris dans le contexte des rollouts. Un PDB ne bloque pas la mise à jour progressive d'un Deployment, car celui-ci remplace les pods directement au lieu de passer par l'API d'éviction. Un PDB limite en revanche les évictions volontaires, comme les drains de nœuds et le scale-down du Cluster Autoscaler. Un PDB ne ralentira donc pas une mise à jour progressive, mais il peut bloquer un drain de nœud qui se produit au même moment. Par exemple, définir minAvailable égal au nombre total de réplicas peut empêcher complètement les disruptions volontaires.
Adapter la stratégie de déploiement à votre type de workload
Voici les stratégies de déploiement adaptées selon ce que vous déployez :
Services HTTP stateless et API
La mise à jour progressive est le choix par défaut, car ces services évoluent horizontalement et tolèrent deux versions simultanées. Pour réduire le risque sur un service à fort trafic, ajoutez un canary avec répartition du trafic afin de valider d'abord la nouvelle version sur une fraction du trafic.
Applications stateful avec volumes persistants
Ces applications ne peuvent souvent pas exécuter deux versions sur les mêmes données en même temps : Recreate, ou un StatefulSet avec des mises à jour ordonnées et maîtrisées, est généralement plus sûr qu'une mise à jour progressive naïve. Mieux vaut accepter une courte interruption que risquer une corruption de données due au chevauchement des versions.
Jobs batch, consommateurs de files d'attente et CronJobs
Il ne s'agit pas de services de longue durée, l'interruption liée au rollout compte donc moins. Une mise à jour progressive, voire un recreate, convient généralement ; le vrai enjeu est de terminer proprement le travail en cours avant l'arrêt des anciens pods.
Workloads GPU et d'inférence machine learning
Les nœuds GPU sont coûteux et rares, ce qui rend les stratégies gourmandes en surge onéreuses : maintenir de la capacité GPU de réserve pour un blue/green ou un maxSurge élevé coûte cher. Privilégiez une mise à jour progressive avec un maxSurge faible, ou un canary, et dimensionnez soigneusement les requests pour ne pas réserver des GPU entiers que vous n'utilisez pas.
Bonnes pratiques de stratégie de déploiement Kubernetes
Voici les pratiques qui rendent les déploiements plus sûrs et plus économes :
1. Faites le right-sizing des resource requests avant d'ajuster la vitesse de rollout
Puisque les pods de surge et de secours réservent leurs requests, des requests précises ont plus d'impact sur le coût d'un rollout que n'importe quel réglage de stratégie. Dimensionnez correctement d'abord, puis affinez le rollout.
2. Conditionnez chaque rollout à des readiness probes liées à de vrais signaux de santé
Une readiness probe qui vérifie seulement que le processus est lancé passera alors que l'application est encore défaillante. Reliez-la à un vrai contrôle de santé pour que Kubernetes n'envoie du trafic qu'aux pods réellement capables de le servir.
3. Définissez un PodDisruptionBudget pour chaque workload de production
Un PDB ne ralentira pas vos rollouts, mais il protège votre application pendant les drains de nœuds et le scale-down de l'autoscaler en plafonnant le nombre de pods pouvant être évincés en même temps. Chaque workload de production devrait en avoir un.
4. Automatisez le rollback en cas d'échec des contrôles de santé ou des SLO
Ne comptez pas sur une personne qui surveille un dashboard. Utilisez un contrôleur de rollout comme Argo Rollouts ou Flagger pour promouvoir ou annuler automatiquement un déploiement en fonction des métriques, afin qu'une mauvaise release soit annulée avant de se propager.
5. Alignez le nombre de réplicas et les node pools sur la marge requise par maxSurge
Assurez-vous que le cluster dispose de la place nécessaire pour les pods de surge créés par un rollout. Sinon, conservez un peu de marge ou acceptez que l'autoscaler ajoute des nœuds à chaque release.
6. Passez en revue les coûts et le gaspillage de ressources après chaque release
Une release peut modifier discrètement votre empreinte de ressources. Comparez l'utilisation aux requests après chaque rollout pour éviter que le surprovisionnement et la dérive ne s'accumulent au fil du temps.