

Karpenter es el autoscaler nativo de Kubernetes diseñado para gestionar la eficiencia de los recursos en k8s. Aprovisiona nodos de forma dinámica en respuesta a los workloads pendientes, asegurando que las aplicaciones cuenten con los recursos necesarios justo cuando los necesitan. Con este enfoque se busca mejorar la eficiencia operativa y reducir el gasto en la nube.
Sin embargo, lograr eficiencia y ahorro al mismo tiempo con Karpenter no es tarea fácil. Aunque Karpenter ofrece capacidades muy potentes, su configuración por defecto y algunas de las buenas prácticas recomendadas pueden, sin quererlo, aumentar los costos, incluso si mejoran el rendimiento. Por eso es clave no solo seguir las pautas generales, sino también ajustarlas a las necesidades específicas de tus workloads y a tus consideraciones de costos.
En este artículo hablaremos de Karpenter, su arquitectura y las buenas prácticas de costo y eficiencia, y al final compartiremos nuestra experiencia sobre por qué las buenas prácticas deben adaptarse a tu entorno.
¿Qué es Karpenter?
Karpenter es un autoscaler moderno y nativo de Kubernetes, diseñado para responder a las necesidades dinámicas de los workloads en contenedores. A diferencia de las herramientas de autoescalado tradicionales, Karpenter está pensado para aprovisionar nodos de forma automática y rápida según las demandas de tu clúster. Su capacidad de respuesta en tiempo real ayuda a garantizar que tus aplicaciones tengan los recursos necesarios exactamente cuando los necesitan, y así se reducen tanto la latencia como el overhead.
¿Cómo funciona Karpenter?
Karpenter es un autoscaler nativo de Kubernetes diseñado para ajustar dinámicamente el tamaño de tu clúster de Kubernetes según la demanda de los workloads en tiempo real. En esencia, Karpenter monitorea continuamente el estado de tu clúster, incluidas las métricas tanto de pods como de nodos. Este monitoreo le permite tomar decisiones informadas sobre las acciones de escalado. Cuando detecta que los recursos actuales no alcanzan para atender la carga, Karpenter inicia el proceso de escalado: aprovisiona nuevos nodos con los tipos y tamaños de instancia que mejor se ajustan a los requisitos de recursos de los pods pendientes. A la inversa, cuando la carga disminuye y los nodos quedan subutilizados, Karpenter reduce el clúster de forma segura desaprovisionando esos nodos, sin interrumpir los workloads en ejecución.
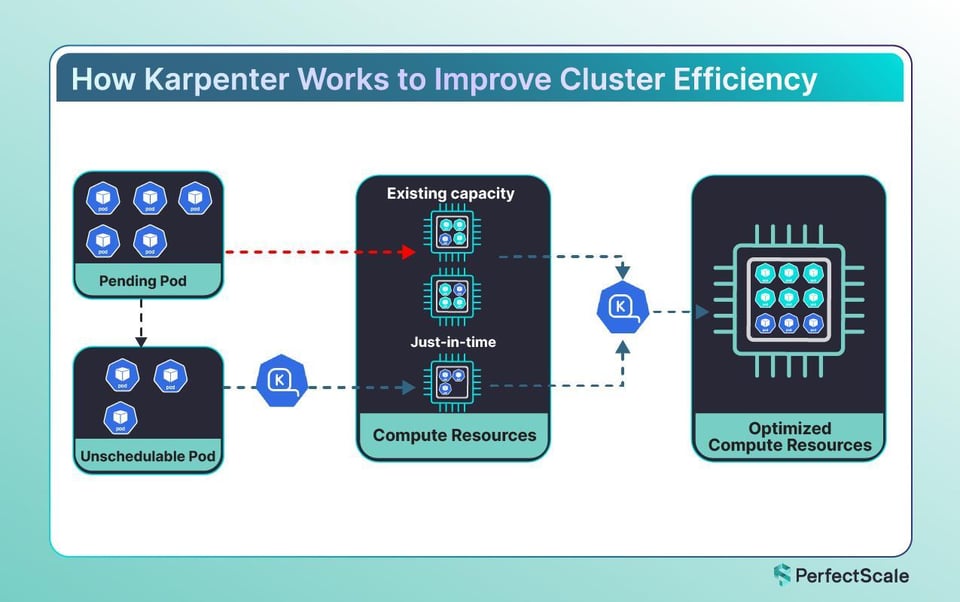
Una de las grandes fortalezas de Karpenter es su capacidad de optimizar la asignación de recursos, lo que ayuda a reducir los costos operativos. Lo logra seleccionando los tipos y tamaños de instancia más rentables y empaquetando los workloads en los nodos de forma eficiente para maximizar el uso de los recursos. Sin embargo, es muy importante tener en cuenta que Karpenter solo puede optimizar la asignación de recursos si los pods tienen el tamaño correcto. Analiza las solicitudes de recursos de los contenedores y las restricciones de scheduling para realizar la selección de nodos. PerfectScale puede ayudarte con el right-sizing de pods, garantizando que Karpenter cuente con información precisa para trabajar. Para más información sobre cómo PerfectScale potencia la efectividad de Karpenter, revisa este [post
](https://www.perfectscale.io/blog/getting-the-most-out-of-karpenter-with-perfectscale)El proceso de toma de decisiones de Karpenter se rige por un conjunto de políticas y configuraciones personalizables. Puedes definir lógica de aprovisionamiento personalizada mediante las Custom Resource Definitions (CRDs) de NodePool, especificando parámetros como tipos de instancia, zonas y límites de recursos. Esto permite un control muy fino sobre cómo se asignan y gestionan los recursos dentro del clúster. Se pueden definir políticas de escalado con cantidades mínimas y máximas de nodos, así como períodos de cooldown para controlar la frecuencia de las acciones de escalado.
Karpenter fue desarrollado originalmente por AWS para mejorar la gestión del ciclo de vida de los nodos en los clústeres de Amazon EKS. Al ver su potencial, Microsoft presentó un provider (NAP) para ejecutar Karpenter en Azure Kubernetes Service (AKS), ofreciendo beneficios similares a los usuarios de AKS.
>> Échale un vistazo a Karpenter: la guía definitiva
Características clave de Karpenter:
Aprovisionamiento rápido de nodos: Una de las funciones más destacadas de Karpenter es su capacidad de levantar nuevos nodos con rapidez. Monitorea el clúster de forma continua e identifica cuándo hay pods esperando ser programados por falta de recursos. Al aprovisionar nodos bajo demanda, minimiza los tiempos de espera y mantiene tus aplicaciones funcionando sin problemas.
Selección de instancias según el workload: Karpenter no solo agrega capacidad de cómputo; agrega el tipo de cómputo correcto. Evalúa dinámicamente los requisitos de recursos de los workloads entrantes (como CPU, memoria e incluso GPU) y selecciona los tipos de instancia más apropiados disponibles en tu entorno de nube. Este enfoque orientado al workload garantiza que no pagues de más por capacidad innecesaria y que obtengas el rendimiento óptimo para tus aplicaciones.
Integración nativa con la nube: Está diseñado desde cero pensando en las infraestructuras de nube modernas y se integra sin fricciones con los principales proveedores de nube. Usa APIs nativas para tomar decisiones inteligentes basadas en los precios actuales, los tipos de instancia disponibles y la capacidad regional.
>> Conoce más sobre los errores comunes con Karpenter
Ciclo de vida de los nodos y procesos de disrupción
Expiración de nodos: Una de las funciones clave de Karpenter es la expiración de nodos, controlada por el parámetro expireAfter. Esta configuración define la vida útil de un nodo, garantizando que los nodos se reciclen periódicamente para incorporar las últimas configuraciones y actualizaciones de seguridad. Por defecto, los nodos expiran a los 30 días (720 horas), pero esta duración se puede personalizar según los requisitos operativos específicos. Al llegar a su expiración, Karpenter inicia un proceso de apagado controlado: aplica un taint al nodo para evitar que se programen nuevos pods, desaloja los pods existentes respetando sus Pod Disruption Budgets (PDBs) y, finalmente, termina el nodo. Este enfoque mantiene la estabilidad del clúster y minimiza las interrupciones del servicio.
Disrupción: Karpenter cuenta con políticas de consolidación para optimizar el uso de recursos y reducir costos. La consolidación identifica oportunidades para eliminar nodos subutilizados, ya sea redistribuyendo sus workloads a otros nodos con capacidad disponible o reemplazándolos por instancias más rentables. Karpenter evalúa los nodos para la consolidación según su utilización y con el objetivo de reducir el gasto total.
El comportamiento de la consolidación se controla con dos configuraciones:
a. consolidationPolicy: Determina cuándo un nodo se considera "consolidable". Puedes elegir entre:
WhenEmpty: los nodos se consolidan solo cuando no tienen pods en ejecución (que no sean daemons).
WhenEmptyOrUnderutilized: esta política de consolidación permite eliminar nodos que están completamente vacíos o con poco uso.
b. consolidateAfter: Establece un tiempo de espera después de un evento de scheduling antes de que Karpenter verifique si es posible consolidar. Ayuda a evitar el churn innecesario de nodos por cambios de corto plazo en los workloads.
Ahora veamos los tres tipos de estrategias de consolidación que usa Karpenter:
1. Consolidación de nodos vacíos
Es el caso más simple. Si un nodo no tiene pods relevantes (solo daemonsets, por ejemplo), se apaga de inmediato. Estos nodos pueden eliminarse en paralelo en todo el clúster.
2. Consolidación multinodo
Es una optimización más compleja en la que Karpenter intenta reemplazar dos o más nodos subutilizados por uno solo más barato. Estima la mejor combinación de nodos a consolidar.
3. Consolidación de un solo nodo
En este caso, cada nodo se evalúa de forma individual. Si los workloads de un nodo pueden moverse a otros nodos existentes o reemplazarse por una instancia más barata, Karpenter ejecutará ese intercambio.
Gestión del drift: El drift ocurre cuando el estado real de un nodo difiere de su configuración deseada debido a cambios en las especificaciones del NodePool o del EC2NodeClass. Karpenter monitorea continuamente estas inconsistencias y las corrige automáticamente actualizando o reemplazando los nodos afectados. Esta capacidad de autorreparación mantiene la consistencia en todo el clúster y garantiza que todos los nodos cumplan con las configuraciones definidas, lo que se traduce en confiabilidad y buen rendimiento.
Para dar un control granular sobre las disrupciones, Karpenter ofrece anotaciones tanto a nivel de pod como a nivel de nodo. Al agregar la anotación karpenter.sh/do-not-disrupt: "true" a un pod o nodo, se evita que Karpenter interrumpa estos recursos durante las actividades de consolidación o de gestión del drift. Resulta útil para workloads que requieren alta disponibilidad o que tienen procesos de larga duración que no deben interrumpirse.

¿Cómo se toman las decisiones tras bambalinas?
Karpenter evalúa distintos factores para determinar cuáles son los nodos más apropiados para consolidar:
a. Nodos con menos pods: Priorizar los nodos que alojan menos pods garantiza que el proceso de consolidación afecte a la menor cantidad de workloads posible, reduciendo así la disrupción potencial.
b. Nodos próximos a expirar: Los nodos que se acercan a su tiempo de expiración predefinido se consideran candidatos ideales para la consolidación, en línea con los cronogramas de mantenimiento y las estrategias de optimización de recursos.
c. Nodos que ejecutan pods de baja prioridad: Al enfocarse en los nodos que ejecutan principalmente pods de menor prioridad, Karpenter garantiza que los workloads críticos no se vean afectados durante el proceso de consolidación.
Si un nodo no se puede eliminar, puedes revisar los logs de Karpenter para ver los eventos detallados que explican las razones.
Buenas prácticas para optimizar Karpenter
Veamos las buenas prácticas para optimizar Karpenter:
1. Configurar la expiración de nodos: Configura el parámetro expireAfter para garantizar que los nodos se reemplacen periódicamente, incorporando los últimos parches de seguridad y mejoras de rendimiento. Este enfoque proactivo reduce el riesgo de drift a largo plazo y de posibles vulnerabilidades. Es esencial definir un tiempo de expiración adecuado según el tipo de workload para equilibrar la seguridad y el ahorro.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Definir el período de gracia de terminación: El parámetro terminationGracePeriod define el tiempo máximo que Karpenter esperará a que un nodo se drene antes de terminarlo de forma forzada. Un período de gracia bien configurado equilibra dar a los pods el tiempo suficiente para salir de forma ordenada y garantizar que los nodos se reciclen a tiempo para ahorrar costos. Si defines un período demasiado corto, puedes provocar terminaciones abruptas y poner en riesgo la estabilidad de los workloads, mientras que un período excesivamente largo puede retrasar el ahorro. Lo recomendable es calcular un período de gracia acorde a tu entorno.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. Usar la anotación karpenter.sh/do-not-disrupt: Aplica esta anotación a los pods críticos para evitar que sean desalojados durante las actividades de consolidación. Aunque protege los workloads esenciales, abusar de esta anotación puede bloquear la eliminación de nodos durante las renovaciones programadas, generando ineficiencias en los recursos. Reserva esta anotación para procesos realmente críticos y de corta duración o para trabajos interactivos, y evita aplicarla a servicios stateful de larga ejecución a menos que sea absolutamente necesario.
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Aplicar Pod Disruption Budgets (PDBs): Los PDBs garantizan la disponibilidad de las aplicaciones durante los eventos de disrupción de nodos al especificar el número mínimo de pods que deben permanecer disponibles durante las disrupciones. Al configurar los PDBs, hay que elegir entre las opciones minAvailable y maxUnavailable según los Service Level Agreements (SLAs) de tu workload. Conviene integrar los PDBs con Karpenter para permitir un drenado ordenado de los nodos y minimizar el downtime. También deberías actualizar los PDBs con regularidad para reflejar la dinámica del autoescalado y mantener su efectividad.
5. Configuración de NodePools y restricciones por capas: Puedes diseñar NodePools adaptados a distintos workloads para mejorar el uso de recursos y la resiliencia. Por ejemplo, NodePools separados para workloads stateful y stateless que permitan una selección optimizada de tipos de instancia, etc. También puedes usar node selectors, affinities y tolerations para refinar aún más el scheduling, asegurando que los workloads se ubiquen en los nodos adecuados sin comprometer la resiliencia.
6. Políticas de consolidación para optimizar costos: La función de consolidación de Karpenter optimiza el uso de recursos identificando nodos subutilizados y consolidando los workloads en menos nodos. Este proceso puede traducirse en ahorros gracias a un bin-packing eficiente y a la agregación de recursos. Sin embargo, es esencial equilibrar las posibles disrupciones durante la consolidación con los beneficios del ahorro y las mejoras de eficiencia operativa.
7. Equilibrar instancias Spot y On-Demand: Puedes usar una combinación de instancias Spot y On-Demand que te permita aprovechar los beneficios de costo mientras garantizas la estabilidad de los componentes críticos. Debes configurar los NodePools con la ponderación y los límites de instancia adecuados para alinearlos con tus commitments de Savings Plans. Esta estrategia te permite optimizar los costos sin comprometer la confiabilidad de los workloads esenciales.

Nuestra historia: cuando las buenas prácticas juegan en contra
- Escrito por [Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
En nuestro caso, seguimos las buenas prácticas recomendadas de Karpenter. Configuramos los nodos con el parámetro expireAfter para garantizar una rotación regular.
Para nuestros workloads críticos, aplicamos la anotación karpenter.sh/do-not-disrupt para prevenir disrupciones durante las actividades de consolidación. En teoría, este enfoque parecía impecable.
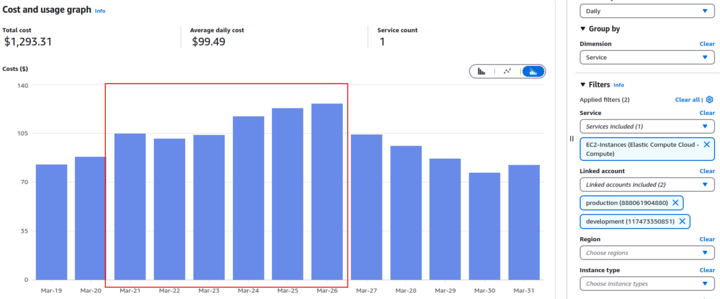
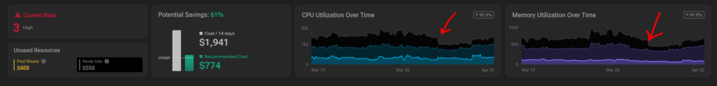
Cuando los nodos llegaron a su expiración, Karpenter inició el aprovisionamiento de nuevos nodos como era de esperar. Pero surgió una complicación: los nodos existentes no podían terminarse porque la anotación do-not-disrupt impedía el desalojo de los pods críticos que alojaban. Esto generó un escenario temporal en el que los nodos antiguos y los nuevos se ejecutaban en paralelo, duplicando de hecho nuestra capacidad y, en consecuencia, nuestros costos.
Para resolverlo, configuramos el parámetro terminationGracePeriod, que define la duración máxima del drenado de un nodo antes de su terminación forzada. Si bien este parámetro garantiza que los nodos finalmente se den de baja, trae sus propios desafíos. Si se terminan varios nodos stateful al mismo tiempo sin Pod Disruption Budgets (PDBs) bien configurados, la estabilidad del clúster podría verse comprometida.
Ante estas complejidades, decidimos deshabilitar la configuración expireAfter para nuestros workloads stateful. En su lugar, optamos por actualizar estos nodos de forma manual durante las ventanas de mantenimiento programadas o junto con las actualizaciones de Kubernetes, aproximadamente cada seis meses. Este enfoque nos permitió mantener el control sobre los eventos del ciclo de vida de los nodos, garantizando tanto la eficiencia de costos como la estabilidad del clúster.
Esta experiencia nos dejó una lección crucial: las buenas prácticas son pautas valiosas, pero no son soluciones universales. Es imprescindible evaluar y adaptar las configuraciones a las demandas particulares de tus workloads y de tu entorno operativo. Al hacerlo, puedes aprovechar todo el potencial de herramientas como Karpenter sin consecuencias inesperadas.
Karpenter vs. Cluster Autoscaler
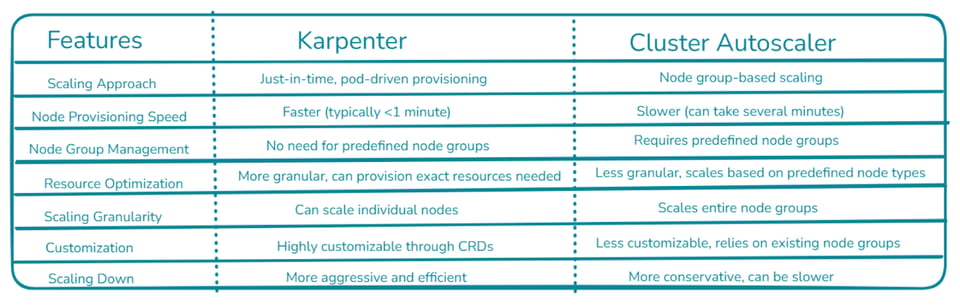
Karpenter representa un enfoque más moderno y flexible para escalar clústeres de Kubernetes, con tiempos de aprovisionamiento más rápidos y un uso más eficiente de los recursos. Es especialmente adecuado para entornos dinámicos con requisitos de workloads variables. Cluster Autoscaler, por su parte, es una solución más consolidada que funciona bien con grupos de nodos predefinidos y ofrece un soporte más amplio de proveedores de nube. Es una opción confiable para entornos más estáticos o cuando se trabaja con múltiples proveedores de nube.
>> Mira aquí cómo sacarle el máximo provecho a Karpenter con un right-sizing inteligente de pods.
Saca el máximo provecho de Karpenter con PerfectScale
Integrar Karpenter con PerfectScale puede mejorar significativamente la eficiencia de tu clúster de Kubernetes. Si bien Karpenter ofrece un aprovisionamiento de nodos inteligente y just-in-time, puede carecer de una visión profunda del uso histórico de recursos y de las necesidades de confiabilidad de tus workloads. PerfectScale cubre esa brecha analizando los patrones de los workloads y proponiendo recomendaciones de optimización. Esta sinergia ha permitido a los clientes lograr una reducción adicional de costos de entre el 30 y el 50% más allá de lo que ofrece Karpenter por sí solo. Por ejemplo, PerfectScale puede identificar escenarios en los que Karpenter podría sobreaprovisionar recursos y sugerir configuraciones para evitar costos innecesarios y posibles impactos en la confiabilidad. Prueba PerfectScale y descubre cómo puede potenciar tu clúster gestionado con Karpenter. Regístrate o agenda una demo para saber más.