

Karpenter ist der Kubernetes-native Autoscaler für effizientes Ressourcenmanagement in K8s. Er stellt Nodes dynamisch als Reaktion auf wartende Workloads bereit und sorgt so dafür, dass Anwendungen genau dann über die nötigen Ressourcen verfügen, wenn sie gebraucht werden. Dieser Ansatz soll die operative Effizienz steigern und die Cloud-Ausgaben senken.
Beides – Effizienz und Kosteneffizienz – mit Karpenter zu erreichen, ist jedoch nicht einfach. Karpenter bietet zwar leistungsstarke Funktionen, doch seine Standardeinstellungen und einige empfohlene Best Practices können unbeabsichtigt zu höheren Kosten führen, selbst wenn sie die Performance verbessern. Deshalb ist es entscheidend, nicht nur allgemeine Richtlinien zu befolgen, sondern diese an Ihre spezifischen Workload-Anforderungen und Kostenüberlegungen anzupassen.
In diesem Artikel besprechen wir Karpenter, seine Architektur und Best Practices für Kosten und Effizienz – und teilen abschließend unsere Erfahrung, dass Best Practices immer auf Ihre Umgebung zugeschnitten werden sollten.
Was ist Karpenter?
Karpenter ist ein moderner, Kubernetes-nativer Autoscaler, der auf die dynamischen Anforderungen containerisierter Workloads zugeschnitten ist. Anders als traditionelle Autoscaling-Tools stellt Karpenter Nodes automatisch und schnell bereit – basierend auf dem tatsächlichen Bedarf Ihres Clusters. Die Reaktion in Echtzeit stellt sicher, dass Ihre Anwendungen genau dann über die benötigten Ressourcen verfügen, wenn sie sie brauchen, was sowohl Latenz als auch Overhead reduziert.
Wie funktioniert Karpenter?
Karpenter ist ein Kubernetes-nativer Autoscaler, der die Größe Ihres Kubernetes-Clusters dynamisch an den tatsächlichen Workload-Bedarf anpasst. Im Kern überwacht Karpenter kontinuierlich den Zustand Ihres Clusters, einschließlich der Metriken von Pods und Nodes. Auf Basis dieses Monitorings trifft Karpenter fundierte Skalierungsentscheidungen. Erkennt es, dass die aktuellen Ressourcen für den Workload nicht ausreichen, startet Karpenter einen Scale-up-Prozess: Es werden neue Nodes mit den Instance-Typen und -Größen bereitgestellt, die am besten zu den Ressourcenanforderungen der wartenden Pods passen. Sinkt der Workload und sind Nodes nicht mehr ausgelastet, skaliert Karpenter den Cluster sicher herunter, indem es diese Nodes wieder abbaut – ohne laufende Workloads zu beeinträchtigen.
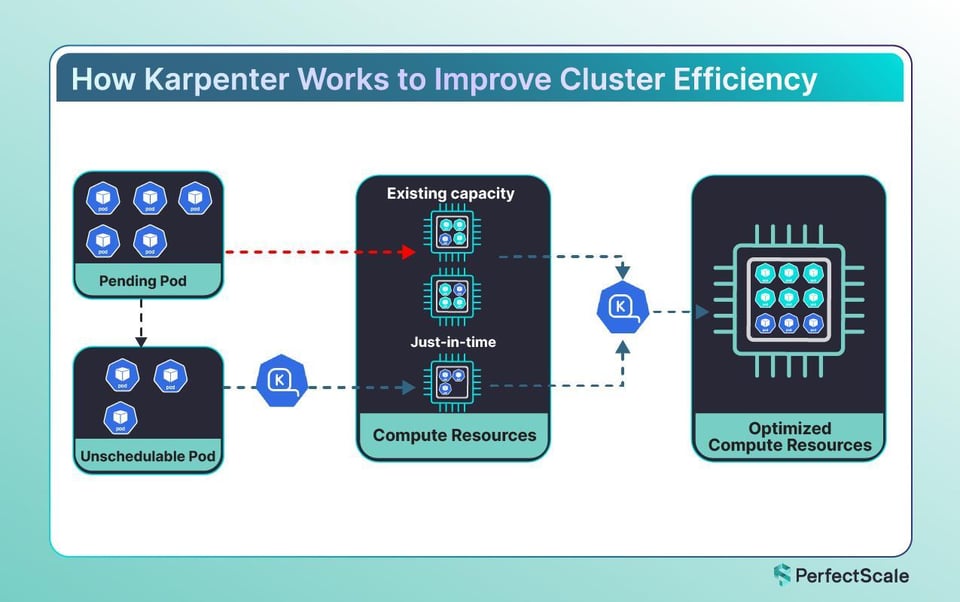
Eine der zentralen Stärken von Karpenter ist die Optimierung der Ressourcenzuweisung, was die Betriebskosten senkt. Dazu wählt es die kosteneffizientesten Instance-Typen und -Größen aus und packt Workloads effizient auf Nodes, um die Ressourcenauslastung zu maximieren. Wichtig zu wissen: Karpenter kann die Ressourcenzuweisung nur dann optimieren, wenn die Pods richtig dimensioniert sind. Für die Node-Auswahl betrachtet es Container-Resource-Requests und Scheduling-Constraints. PerfectScale unterstützt beim Right-Sizing von Pods und stellt sicher, dass Karpenter mit akkuraten Informationen arbeitet. Mehr dazu, wie PerfectScale die Wirksamkeit von Karpenter steigert, finden Sie in diesem [Beitrag
](https://www.perfectscale.io/blog/getting-the-most-out-of-karpenter-with-perfectscale)Karpenters Entscheidungsprozess wird durch anpassbare Policies und Konfigurationen gesteuert. Nutzer können eigene Provisioning-Logik über NodePool Custom Resource Definitions (CRDs) definieren und dabei Parameter wie Instance-Typen, Zonen und Ressourcenlimits festlegen. Das ermöglicht eine feingranulare Kontrolle darüber, wie Ressourcen im Cluster zugewiesen und verwaltet werden. Über Scaling-Policies lassen sich die minimale und maximale Node-Anzahl sowie Cooldown-Zeiträume definieren, um die Frequenz der Skalierungsaktionen zu steuern.
Karpenter wurde ursprünglich von AWS entwickelt, um das Node-Lifecycle-Management in Amazon-EKS-Clustern zu verbessern. Angesichts des Potenzials führte Microsoft anschließend einen Provider (NAP) ein, um Karpenter auf dem Azure Kubernetes Service (AKS) zu betreiben – mit ähnlichen Vorteilen für AKS-Nutzer.
>> Werfen Sie einen Blick auf Karpenter: The Ultimate
Die wichtigsten Funktionen von Karpenter:
Schnelles Node-Provisioning: Eine der herausragenden Funktionen von Karpenter ist die Fähigkeit, neue Nodes schnell hochzufahren. Es überwacht Ihren Cluster kontinuierlich und erkennt, wenn Pods aufgrund fehlender Ressourcen auf ihr Scheduling warten. Durch bedarfsgerechtes Provisioning minimiert es Wartezeiten und hält Ihre Anwendungen zuverlässig am Laufen.
Workload-orientierte Instance-Auswahl: Karpenter fügt nicht einfach nur Rechenkapazität hinzu, sondern die richtige Art von Kapazität. Es bewertet dynamisch die Ressourcenanforderungen eingehender Workloads (etwa CPU, Arbeitsspeicher und sogar GPU-Bedarf) und wählt die passendsten Instance-Typen in Ihrer Cloud-Umgebung aus. Dieser Workload-orientierte Ansatz stellt sicher, dass Sie nicht für unnötige Kapazität bezahlen und für Ihre Anwendungen die optimale Performance erhalten.
Cloud-native Integration: Karpenter wurde von Grund auf für moderne Cloud-Infrastrukturen konzipiert und integriert sich nahtlos mit den großen Cloud-Anbietern. Es nutzt native APIs, um intelligente Entscheidungen auf Basis aktueller Preise, verfügbarer Instance-Typen und regionaler Kapazitäten zu treffen.
>> Erfahren Sie mehr über die Karpenter Pitfalls
Node-Lifecycle und Disruption-Prozesse
Node Expiration: Eine der Kernfunktionen von Karpenter ist die Node Expiration, gesteuert über den Parameter expireAfter. Diese Einstellung bestimmt die Lebensdauer eines Nodes und stellt sicher, dass Nodes regelmäßig ausgetauscht werden, um die neuesten Konfigurationen und Sicherheitsupdates zu übernehmen. Standardmäßig laufen Nodes nach 30 Tagen (720 Stunden) ab, diese Dauer lässt sich aber an spezifische betriebliche Anforderungen anpassen. Erreicht ein Node sein Ablaufdatum, leitet Karpenter einen Graceful Shutdown ein: Der Node erhält einen Taint, damit keine neuen Pods mehr darauf geplant werden, bestehende Pods werden unter Beachtung ihrer Pod Disruption Budgets (PDBs) entfernt, und schließlich wird der Node terminiert. Dieser Ansatz erhält die Cluster-Stabilität und minimiert Serviceunterbrechungen.
Disruption: Karpenter nutzt Consolidation Policies, um die Ressourcenauslastung zu optimieren und Kosten zu senken. Die Consolidation identifiziert Möglichkeiten, unterausgelastete Nodes zu entfernen – entweder durch Umverteilung ihrer Workloads auf andere Nodes mit freien Kapazitäten oder durch den Ersatz durch kostengünstigere Instances. Karpenter bewertet Nodes anhand ihrer Auslastung für die Consolidation, mit dem Ziel, die Gesamtkosten zu senken.
Das Verhalten der Consolidation wird über zwei Konfigurationen gesteuert:
a. consolidationPolicy: Sie bestimmt, wann ein Node als "consolidatable" gilt. Sie können wählen zwischen:
WhenEmpty: Nodes werden nur konsolidiert, wenn keine laufenden (Nicht-Daemon-)Pods darauf laufen.
WhenEmptyOrUnderutilized: Diese Consolidation Policy erlaubt das Entfernen von Nodes, die entweder komplett leer oder nur gering ausgelastet sind.
b. consolidateAfter: Legt eine Verzögerung nach einem Scheduling-Ereignis fest, bevor Karpenter prüft, ob eine Consolidation möglich ist. Das vermeidet unnötigen Node-Churn durch kurzfristige Workload-Schwankungen.
Schauen wir uns nun die drei Consolidation-Strategien von Karpenter an:
1. Empty Node Consolidation
Der einfachste Fall: Hat ein Node keine relevanten Pods (zum Beispiel nur DaemonSets), wird er sofort heruntergefahren. Solche Nodes können clusterweit parallel gelöscht werden.
2. Multi-Node Consolidation
Eine komplexere Optimierung, bei der Karpenter versucht, zwei oder mehr unterausgelastete Nodes durch einen einzelnen, günstigeren zu ersetzen. Dabei ermittelt es die beste Kombination von Nodes für die Consolidation.
3. Single Node Consolidation
Hier wird jeder Node einzeln bewertet. Können die Workloads eines Nodes entweder auf andere bestehende Nodes umziehen oder durch eine günstigere Instance ersetzt werden, stößt Karpenter diesen Austausch an.
Drift Management: Drift entsteht, wenn der Ist-Zustand eines Nodes durch Änderungen an den NodePool- oder EC2NodeClass-Spezifikationen von der gewünschten Konfiguration abweicht. Karpenter überwacht solche Inkonsistenzen kontinuierlich und korrigiert sie automatisch, indem es betroffene Nodes aktualisiert oder ersetzt. Diese Selbstheilungsfähigkeit sorgt für Konsistenz im gesamten Cluster und stellt sicher, dass alle Nodes den definierten Konfigurationen entsprechen – für Zuverlässigkeit und gute Performance.
Für eine granulare Kontrolle über Disruptions bietet Karpenter Annotationen auf Pod- und Node-Ebene. Mit der Annotation karpenter.sh/do-not-disrupt: "true" auf einem Pod oder Node verhindern Sie, dass Karpenter diese Ressourcen bei Consolidation- oder Drift-Management-Aktivitäten unterbricht. Das ist nützlich für Workloads, die hohe Verfügbarkeit erfordern oder langlaufende Prozesse haben, die nicht unterbrochen werden sollten.

Wie fällt die Entscheidung hinter den Kulissen?
Karpenter bewertet verschiedene Faktoren, um die geeignetsten Nodes für die Consolidation zu bestimmen:
a. Nodes mit weniger Pods: Nodes mit weniger Pods werden priorisiert, damit die Consolidation möglichst wenige Workloads betrifft und potenzielle Unterbrechungen reduziert werden.
b. Nodes kurz vor der Expiration: Nodes, die sich ihrem definierten Ablaufzeitpunkt nähern, gelten als bevorzugte Kandidaten für die Consolidation – im Einklang mit Wartungsplänen und Strategien zur Ressourcenoptimierung.
c. Nodes mit Pods niedriger Priorität: Indem Karpenter gezielt Nodes berücksichtigt, auf denen überwiegend Pods mit niedrigerer Priorität laufen, bleiben kritische Workloads während der Consolidation unangetastet.
Kann ein Node nicht entfernt werden, finden Sie in den Karpenter-Logs detaillierte Events, die die Gründe erläutern.
Best Practices zur Optimierung von Karpenter
Sehen wir uns die Best Practices zur Optimierung von Karpenter an:
1. Node Expiration konfigurieren: Setzen Sie den Parameter expireAfter, damit Nodes regelmäßig ersetzt werden und stets die neuesten Sicherheitspatches und Performance-Verbesserungen erhalten. Dieser proaktive Ansatz reduziert das Risiko von langfristigem Drift und potenziellen Schwachstellen. Wichtig ist, eine zu Ihrem Workload-Typ passende Ablaufzeit zu wählen, um Sicherheit und Kosteneffizienz in Balance zu halten.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Termination Grace Period festlegen: Der Parameter terminationGracePeriod definiert die maximale Zeit, die Karpenter auf das Draining eines Nodes wartet, bevor er ihn zwangsweise terminiert. Eine gut konfigurierte Grace Period gibt Pods ausreichend Zeit für ein sauberes Beenden und sorgt zugleich dafür, dass Nodes zügig ausgetauscht werden, um Kosten zu sparen. Ist die Zeitspanne zu kurz, drohen abrupte Terminierungen und instabile Workloads; ist sie zu lang, verzögern sich die Kosteneinsparungen. Es empfiehlt sich, die Grace Period passend zu Ihrer Umgebung zu berechnen.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. Die Annotation karpenter.sh/do-not-disrupt nutzen: Wenden Sie diese Annotation auf kritische Pods an, um deren Eviction während Consolidation-Aktivitäten zu verhindern. Sie schützt zwar essenzielle Workloads, doch ein übermäßiger Einsatz kann das Löschen von Nodes bei geplanten Refreshes blockieren und zu ineffizienter Ressourcennutzung führen. Reservieren Sie diese Annotation für wirklich kritische, kurzlebige Prozesse oder interaktive Jobs und vermeiden Sie sie bei langlaufenden Stateful Services, sofern nicht absolut notwendig.
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Pod Disruption Budgets (PDBs) einsetzen: PDBs sichern die Verfügbarkeit von Anwendungen bei Node-Disruptions, indem sie die Mindestanzahl von Pods festlegen, die während einer Disruption verfügbar bleiben müssen. Bei der Konfiguration von PDBs wählen Sie – abhängig von den Service Level Agreements (SLAs) Ihres Workloads – zwischen minAvailable und maxUnavailable. Integrieren Sie PDBs mit Karpenter, um ein sauberes Node-Draining zu ermöglichen und Ausfallzeiten zu minimieren. Aktualisieren Sie PDBs außerdem regelmäßig, damit sie der Autoscaling-Dynamik entsprechen und wirksam bleiben.
5. NodePool-Konfiguration und mehrstufige Constraints: Gestalten Sie NodePools, die auf unterschiedliche Workloads zugeschnitten sind – das verbessert Ressourcenauslastung und Resilienz. Getrennte NodePools für Stateful- und Stateless-Workloads ermöglichen zum Beispiel eine optimierte Auswahl der Instance-Typen. Zusätzlich können Sie Node-Selektoren, Affinities und Tolerations nutzen, um das Scheduling weiter zu verfeinern und Workloads auf passenden Nodes zu platzieren, ohne die Resilienz zu beeinträchtigen.
6. Consolidation Policies zur Kostenoptimierung: Karpenters Consolidation-Funktion optimiert die Ressourcennutzung, indem sie unterausgelastete Nodes identifiziert und Workloads auf weniger Nodes bündelt. Durch effizientes Bin-Packing und Ressourcenaggregation lassen sich so Kosten sparen. Wichtig ist jedoch, die möglichen Unterbrechungen während der Consolidation gegen die Vorteile aus Kosteneinsparungen und Effizienzgewinnen abzuwägen.
7. Spot- und On-Demand-Instances ausbalancieren: Mit einem Mix aus Spot- und On-Demand-Instances profitieren Sie von Kostenvorteilen und sichern gleichzeitig die Stabilität kritischer Komponenten. Konfigurieren Sie NodePools mit passender Gewichtung und Instance-Limits, abgestimmt auf Ihre Savings-Plans-Commitments. So optimieren Sie die Kosten, ohne die Zuverlässigkeit essenzieller Workloads zu gefährden.

Unsere Geschichte: Wenn Best Practices nach hinten losgehen
- Verfasst von [Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
Wir haben zunächst die von Karpenter empfohlenen Best Practices befolgt. Wir konfigurierten die Nodes mit dem Parameter expireAfter, um eine regelmäßige Rotation sicherzustellen.
Für unsere kritischen Workloads setzten wir die Annotation karpenter.sh/do-not-disrupt ein, um Unterbrechungen während der Consolidation-Aktivitäten zu verhindern. Auf dem Papier wirkte dieser Ansatz makellos.
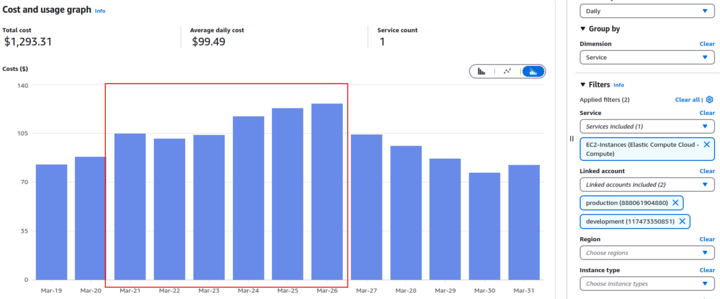
Als die Nodes ihr Ablaufdatum erreichten, startete Karpenter wie erwartet das Provisioning neuer Nodes. Doch es gab eine Komplikation: Die bestehenden Nodes konnten nicht terminiert werden, weil die do-not-disrupt-Annotation die Eviction der darauf laufenden kritischen Pods verhinderte. Das führte vorübergehend dazu, dass alte und neue Nodes gleichzeitig liefen – unsere Kapazität und damit unsere Kosten verdoppelten sich faktisch.
Um das zu beheben, setzten wir den Parameter terminationGracePeriod, der die maximale Dauer für das Node-Draining vor der zwangsweisen Terminierung definiert. Dieser Parameter stellt zwar sicher, dass Nodes irgendwann außer Betrieb genommen werden, bringt aber eigene Herausforderungen mit sich: Werden mehrere Stateful-Nodes gleichzeitig ohne korrekt konfigurierte Pod Disruption Budgets (PDBs) terminiert, kann die Stabilität des Clusters gefährdet sein.
Angesichts dieser Komplexität entschieden wir uns, die expireAfter-Einstellung für unsere Stateful-Workloads zu deaktivieren. Stattdessen aktualisieren wir diese Nodes manuell in geplanten Wartungsfenstern oder zusammen mit Kubernetes-Upgrades – etwa alle sechs Monate. So behielten wir die Kontrolle über die Node-Lifecycle-Events und sicherten sowohl Kosteneffizienz als auch Cluster-Stabilität.
Diese Erfahrung hat uns eine entscheidende Lektion gelehrt: Best Practices sind wertvolle Leitlinien, aber keine Patentlösungen. Es ist unerlässlich, Konfigurationen zu prüfen und auf die individuellen Anforderungen Ihrer Workloads und Ihrer Betriebsumgebung zuzuschneiden. Nur so schöpfen Sie das volle Potenzial von Tools wie Karpenter aus – ohne unerwartete Folgen.
Karpenter vs. Cluster Autoscaler
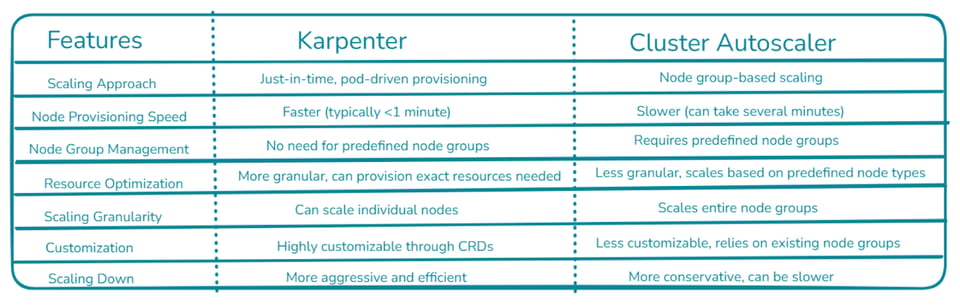
Karpenter steht für einen moderneren, flexibleren Ansatz beim Skalieren von Kubernetes-Clustern – mit schnellerem Provisioning und effizienterer Ressourcennutzung. Es eignet sich besonders für dynamische Umgebungen mit wechselnden Workload-Anforderungen. Der Cluster Autoscaler ist dagegen eine etabliertere Lösung, die gut mit vordefinierten Node-Gruppen funktioniert und eine breitere Unterstützung für Cloud-Anbieter bietet. Er ist eine verlässliche Wahl für eher statische Umgebungen oder den Einsatz mit mehreren Cloud-Anbietern.
>> Sehen Sie hier, wie Sie mit smartem Right-Sizing Ihrer Pods das Maximum aus Karpenter herausholen.
Holen Sie mit PerfectScale das Maximum aus Karpenter heraus
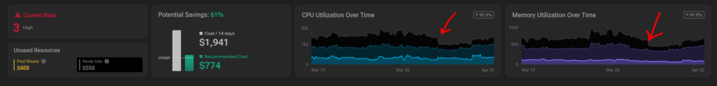
Die Kombination von Karpenter mit PerfectScale kann die Effizienz Ihres Kubernetes-Clusters deutlich steigern. Karpenter bietet intelligentes Just-in-Time-Node-Provisioning, doch es fehlen ihm mitunter tiefe Einblicke in die historische Ressourcennutzung und die Zuverlässigkeitsanforderungen Ihrer Workloads. PerfectScale schließt diese Lücke, indem es Workload-Muster analysiert und Optimierungsempfehlungen liefert. Diese Synergie hat Kunden zusätzliche Kosteneinsparungen von 30 bis 50 % ermöglicht – über das hinaus, was Karpenter allein leistet. PerfectScale kann zum Beispiel Szenarien identifizieren, in denen Karpenter Ressourcen überprovisionieren würde, und Konfigurationen vorschlagen, die unnötige Kosten und potenzielle Zuverlässigkeitsrisiken vermeiden. Testen Sie PerfectScale und erleben Sie, wie es Ihren mit Karpenter verwalteten Cluster verbessert. Registrieren Sie sich oder buchen Sie eine Demo, um mehr zu erfahren.