

O Karpenter é o autoscaler nativo do Kubernetes projetado para gerenciar a eficiência de recursos do k8s. Ele provisiona nós dinamicamente em resposta a workloads pendentes, garantindo que as aplicações tenham os recursos necessários exatamente quando precisam. Essa abordagem busca aumentar a eficiência operacional e reduzir os gastos com nuvem.
No entanto, alcançar eficiência e economia com o Karpenter não é tarefa fácil. Embora o Karpenter ofereça recursos poderosos, suas configurações padrão e algumas boas práticas recomendadas podem, sem querer, gerar custos mais altos, mesmo melhorando o desempenho. Por isso, é fundamental não apenas seguir as diretrizes gerais, mas também ajustá-las às necessidades específicas dos seus workloads e às suas considerações de custo.
Neste artigo, vamos falar sobre o Karpenter, sua arquitetura, boas práticas de custo e eficiência e, por fim, compartilhar nossa experiência mostrando que as boas práticas devem ser adaptadas ao seu ambiente.
O que é o Karpenter?
O Karpenter é um autoscaler moderno e nativo do Kubernetes, projetado para atender às necessidades dinâmicas de workloads em contêineres. Diferentemente das ferramentas tradicionais de autoscaling, o Karpenter foi criado para provisionar nós de forma automática e rápida com base nas demandas do seu cluster. Sua capacidade de resposta em tempo real ajuda a garantir que suas aplicações tenham os recursos necessários exatamente quando precisam, reduzindo tanto a latência quanto a sobrecarga.
Como o Karpenter funciona?
O Karpenter é um autoscaler nativo do Kubernetes projetado para ajustar dinamicamente o tamanho do seu cluster Kubernetes com base na demanda dos workloads em tempo real. Em sua essência, o Karpenter monitora continuamente o estado do cluster, incluindo métricas de pods e nós. Esse monitoramento permite que o Karpenter tome decisões embasadas sobre ações de escalonamento. Quando detecta que os recursos atuais são insuficientes para dar conta da demanda, o Karpenter inicia um processo de scale-up. Isso envolve provisionar novos nós com os tipos e tamanhos de instância mais adequados aos requisitos de recursos dos pods pendentes. Por outro lado, quando a demanda diminui e os nós ficam subutilizados, o Karpenter reduz o cluster com segurança, desprovisionando esses nós sem interromper os workloads em execução.
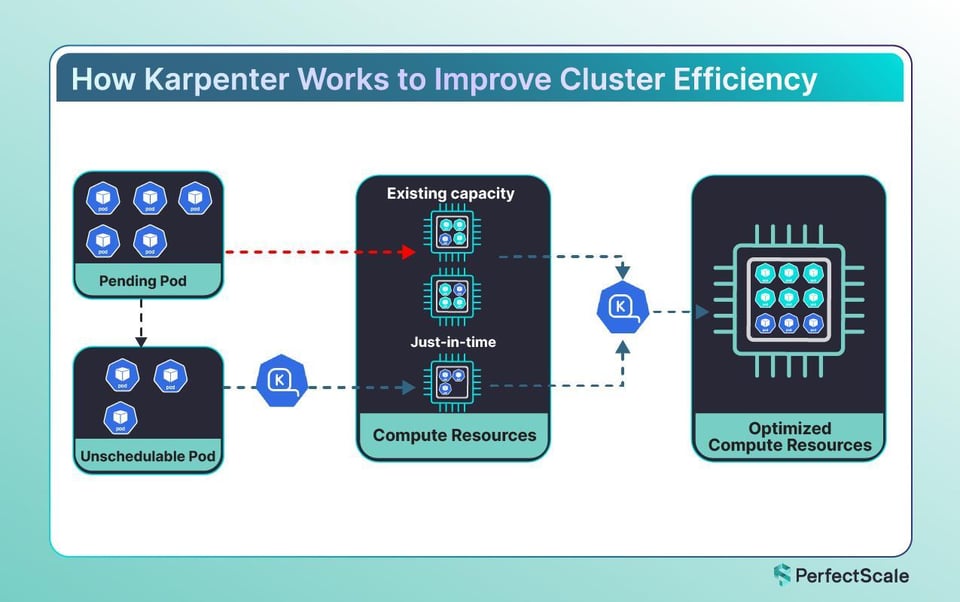
Um dos principais pontos fortes do Karpenter é sua capacidade de otimizar a alocação de recursos, o que ajuda a reduzir custos operacionais. Ele faz isso selecionando os tipos e tamanhos de instância com melhor custo-benefício e empacotando workloads nos nós de forma eficiente para maximizar a utilização dos recursos. No entanto, é muito importante destacar que o Karpenter só consegue otimizar a alocação de recursos se os pods estiverem com o right-sizing adequado. Ele analisa as solicitações de recursos dos contêineres e as restrições de agendamento para realizar a seleção de nós. A PerfectScale pode ajudar com o right-sizing dos pods, garantindo que o Karpenter tenha informações precisas para trabalhar. Para saber mais sobre como a PerfectScale pode aumentar a eficácia do Karpenter, confira este [post
](https://www.perfectscale.io/blog/getting-the-most-out-of-karpenter-with-perfectscale)O processo de decisão do Karpenter é orientado por um conjunto de políticas e configurações personalizáveis. Os usuários podem definir uma lógica de provisionamento customizada usando as Custom Resource Definitions (CRDs) de NodePool, especificando parâmetros como tipos de instância, zonas e limites de recursos. Isso permite um controle refinado sobre como os recursos são alocados e gerenciados no cluster. É possível definir políticas de escalonamento com contagens mínimas e máximas de nós, além de períodos de cooldown para controlar a frequência das ações de escalonamento.
O Karpenter foi originalmente desenvolvido pela AWS para aprimorar o gerenciamento do ciclo de vida dos nós em clusters Amazon EKS. Depois, vendo seu potencial, a Microsoft lançou um provider (NAP) para executar o Karpenter no Azure Kubernetes Service (AKS), oferecendo benefícios semelhantes aos usuários do AKS.
>> Confira o artigo Karpenter: The Ultimate
Principais recursos do Karpenter:
Provisionamento rápido de nós: Um dos grandes destaques do Karpenter é sua capacidade de subir novos nós rapidamente. Ele monitora continuamente o cluster, identificando quando há pods aguardando agendamento por falta de recursos. Ao provisionar nós sob demanda, ele minimiza o tempo de espera e mantém suas aplicações funcionando sem sobressaltos.
Seleção de instâncias com base nos workloads: O Karpenter não adiciona apenas capacidade de computação; ele adiciona o tipo certo de computação. Ele avalia dinamicamente os requisitos de recursos dos workloads que chegam (como CPU, memória e até necessidades de GPU) e seleciona os tipos de instância mais adequados disponíveis no seu ambiente de nuvem. Essa abordagem orientada a workloads garante que você não pague a mais por capacidade desnecessária e obtenha o desempenho ideal para suas aplicações específicas.
Integração nativa da nuvem: Projetado desde o início com as infraestruturas de nuvem modernas em mente, o Karpenter se integra perfeitamente aos principais provedores de nuvem. Ele usa APIs nativas para tomar decisões inteligentes com base nos preços atuais, nos tipos de instância disponíveis e na capacidade regional.
>> Saiba mais sobre os Karpenter Pitfalls
Ciclo de vida dos nós e processos de disrupção
Expiração de nós: Um dos principais recursos do Karpenter é a expiração de nós, controlada pelo parâmetro expireAfter. Essa configuração define o tempo de vida de um nó, garantindo que os nós sejam reciclados periodicamente para incorporar as configurações e atualizações de segurança mais recentes. Por padrão, os nós expiram após 30 dias (720 horas), mas essa duração pode ser personalizada conforme os requisitos operacionais específicos. Ao atingir a expiração, o Karpenter inicia um processo de desligamento controlado: aplica um taint no nó para impedir que novos pods sejam agendados, remove os pods existentes respeitando seus Pod Disruption Budgets (PDBs) e, por fim, encerra o nó. Essa abordagem mantém a estabilidade do cluster e minimiza interrupções de serviço.
Disrupção: O Karpenter possui políticas de consolidação para otimizar a utilização de recursos e reduzir custos. A consolidação identifica oportunidades de remover nós subutilizados, seja redistribuindo seus workloads para outros nós com capacidade disponível, seja substituindo-os por instâncias mais econômicas. O Karpenter avalia os nós para consolidação com base na utilização e para diminuir os gastos gerais.
O comportamento da consolidação é controlado por duas configurações:
a. consolidationPolicy: Determina quando um nó é considerado "consolidável". Você pode escolher entre:
WhenEmpty: Os nós são consolidados apenas quando não têm pods (não daemon) em execução.
WhenEmptyOrUnderutilized: Essa política de consolidação permite a remoção de nós que estão completamente vazios ou apenas levemente utilizados.
b. consolidateAfter: Define um intervalo após um evento de agendamento antes de o Karpenter verificar se a consolidação é possível. Isso ajuda a evitar a rotatividade desnecessária de nós causada por variações de curto prazo nos workloads.
Agora, vamos ver os três tipos de estratégias de consolidação que o Karpenter usa:
1. Consolidação de nós vazios
Este é o caso mais simples. Se um nó não tem pods relevantes em execução (apenas daemonsets, por exemplo), ele é desligado imediatamente. Esses nós podem ser excluídos em paralelo em todo o cluster.
2. Consolidação de múltiplos nós
Esta é uma otimização mais complexa, em que o Karpenter tenta substituir dois ou mais nós subutilizados por um único nó mais barato. Ele estima a melhor combinação de nós a consolidar.
3. Consolidação de nó único
Neste caso, cada nó é avaliado individualmente. Se os workloads de um nó puderem ser movidos para outros nós existentes ou substituídos por uma instância mais barata, o Karpenter aciona essa troca.
Gerenciamento de drift: O drift ocorre quando o estado real de um nó diverge da configuração desejada devido a mudanças nas especificações do NodePool ou do EC2NodeClass. O Karpenter monitora continuamente essas inconsistências e as corrige automaticamente, atualizando ou substituindo os nós afetados. Essa capacidade de autocorreção mantém a consistência em todo o cluster e garante que todos os nós sigam as configurações definidas, resultando em confiabilidade e bom desempenho.
Para oferecer controle granular sobre disrupções, o Karpenter disponibiliza anotações tanto no nível do pod quanto no nível do nó. Ao adicionar a anotação karpenter.sh/do-not-disrupt: "true" a um pod ou nó, os usuários podem impedir que o Karpenter interrompa esses recursos durante atividades de consolidação ou de gerenciamento de drift. Isso é útil para workloads que exigem alta disponibilidade ou têm processos de longa duração que não devem ser interrompidos.

Como a decisão é tomada nos bastidores?
O Karpenter avalia diferentes fatores para determinar os nós mais adequados para consolidação:
a. Nós com menos pods: Priorizar nós que hospedam menos pods garante que o processo de consolidação afete o menor número possível de workloads, reduzindo potenciais disrupções.
b. Nós próximos da expiração: Os nós que estão se aproximando do tempo de expiração predefinido são considerados candidatos ideais para consolidação, em alinhamento com os cronogramas de manutenção e as estratégias de otimização de recursos.
c. Nós executando pods de baixa prioridade: Ao direcionar nós que executam predominantemente pods de menor prioridade, o Karpenter garante que os workloads críticos permaneçam intactos durante o processo de consolidação.
Se um nó não puder ser removido, você pode verificar os logs do Karpenter para ver eventos detalhados explicando os motivos.
Boas práticas para otimizar o Karpenter
Vamos às boas práticas para otimizar o Karpenter:
1. Configuração da expiração de nós: Você deve definir o parâmetro expireAfter para garantir que os nós sejam substituídos periodicamente, incorporando os patches de segurança e as melhorias de desempenho mais recentes. Essa abordagem proativa reduz o risco de drift a longo prazo e de possíveis vulnerabilidades. É essencial definir um tempo de expiração adequado ao tipo do seu workload para equilibrar segurança e economia.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Definição do período de tolerância de encerramento: O parâmetro terminationGracePeriod define a duração máxima que o Karpenter aguardará pelo esvaziamento (drain) de um nó antes de encerrá-lo à força. Um período de tolerância bem configurado equilibra dar aos pods tempo suficiente para sair de forma controlada e garantir que os nós sejam reciclados rapidamente para economizar custos. Se você definir esse período curto demais, podem ocorrer encerramentos abruptos, colocando em risco a estabilidade dos workloads, enquanto um período excessivamente longo pode atrasar a economia. É recomendável calcular o período de tolerância de acordo com o seu ambiente.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. Uso da anotação karpenter.sh/do-not-disrupt: Você deve aplicar essa anotação a pods críticos para impedir que sejam removidos durante atividades de consolidação. Embora proteja workloads essenciais, o uso excessivo dessa anotação pode bloquear a exclusão de nós durante atualizações programadas, gerando ineficiências de recursos. Reserve essa anotação para processos realmente críticos e de curta duração ou jobs interativos, e evite aplicá-la a serviços stateful de longa duração, a menos que seja absolutamente necessário.
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Aplicação de Pod Disruption Budgets (PDBs): Os PDBs garantem a disponibilidade da aplicação durante eventos de disrupção de nós, especificando o número mínimo de pods que devem permanecer disponíveis durante as disrupções. Ao configurar PDBs, é preciso escolher entre as configurações minAvailable e maxUnavailable com base nos Acordos de Nível de Serviço (SLAs) dos seus workloads. Você deve integrar os PDBs ao Karpenter para permitir o esvaziamento controlado dos nós e minimizar o tempo de inatividade. Também é importante atualizar os PDBs regularmente para refletir a dinâmica do autoscaling e manter sua eficácia.
5. Configuração de NodePools e restrições em camadas: Você pode criar NodePools adaptados a diferentes workloads, melhorando a utilização de recursos e a resiliência. Por exemplo, NodePools separados para workloads stateful e stateless permitem seleções otimizadas de tipos de instância, entre outros benefícios. Também é possível utilizar node selectors, affinities e tolerations para refinar ainda mais o agendamento, garantindo que os workloads sejam alocados nos nós adequados sem comprometer a resiliência.
6. Políticas de consolidação para otimização de custos: O recurso de consolidação do Karpenter otimiza o uso de recursos identificando nós subutilizados e consolidando os workloads em menos nós. Esse processo pode gerar economia por meio de bin-packing eficiente e agregação de recursos. No entanto, é essencial equilibrar as possíveis disrupções durante a consolidação com os benefícios de economia e de ganhos de eficiência operacional.
7. Equilíbrio entre instâncias Spot e On-Demand: Você pode usar uma combinação de instâncias Spot e On-Demand para aproveitar os benefícios de custo e, ao mesmo tempo, garantir estabilidade para os componentes críticos. Configure os NodePools com pesos e limites de instância adequados para se alinhar aos seus commitments de Savings Plans. Essa estratégia permite otimizar custos sem comprometer a confiabilidade dos workloads essenciais.

Nossa história: quando as boas práticas saem pela culatra
- Escrito por [Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
Em nossa jornada, seguimos as boas práticas recomendadas do Karpenter. Configuramos os nós com o parâmetro expireAfter para garantir a rotação regular.
Para nossos workloads críticos, aplicamos a anotação karpenter.sh/do-not-disrupt para evitar disrupções durante as atividades de consolidação. No papel, essa abordagem parecia impecável.
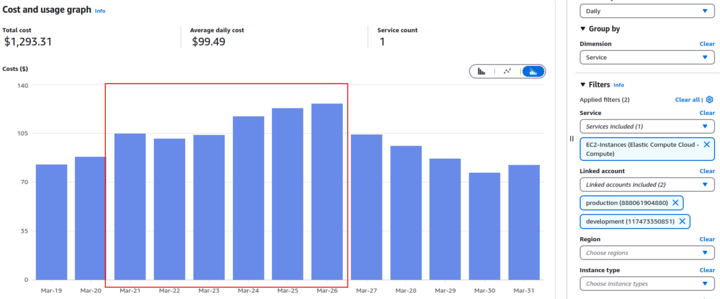
Quando os nós atingiram a expiração, o Karpenter iniciou o provisionamento de novos nós conforme o esperado. Mas surgiu uma complicação: os nós existentes não podiam ser encerrados porque a anotação do-not-disrupt impedia a remoção dos pods críticos que eles hospedavam. Isso resultou em um cenário temporário em que os nós antigos e os novos rodavam simultaneamente, na prática dobrando nossa capacidade e, consequentemente, nossos custos.
Para resolver isso, definimos o parâmetro terminationGracePeriod, que estabelece a duração máxima do esvaziamento do nó antes do encerramento forçado. Embora esse parâmetro garanta que os nós sejam eventualmente desativados, ele traz seus próprios desafios. Se vários nós stateful forem encerrados simultaneamente sem Pod Disruption Budgets (PDBs) configurados corretamente, a estabilidade do cluster pode ser comprometida.
Diante dessas complexidades, decidimos desativar a configuração expireAfter para nossos workloads stateful. Em vez disso, optamos por atualizações manuais desses nós durante janelas de manutenção programadas ou junto com upgrades do Kubernetes, aproximadamente a cada seis meses. Essa abordagem nos permitiu manter o controle sobre os eventos do ciclo de vida dos nós, garantindo tanto a eficiência de custos quanto a estabilidade do cluster.
Essa experiência destacou uma lição crucial: embora as boas práticas sirvam como diretrizes valiosas, elas não são soluções universais. É imprescindível avaliar e adaptar as configurações às demandas únicas dos seus workloads e do seu ambiente operacional. Assim, você pode aproveitar todo o potencial de ferramentas como o Karpenter sem consequências inesperadas.
Karpenter vs. Cluster Autoscaler
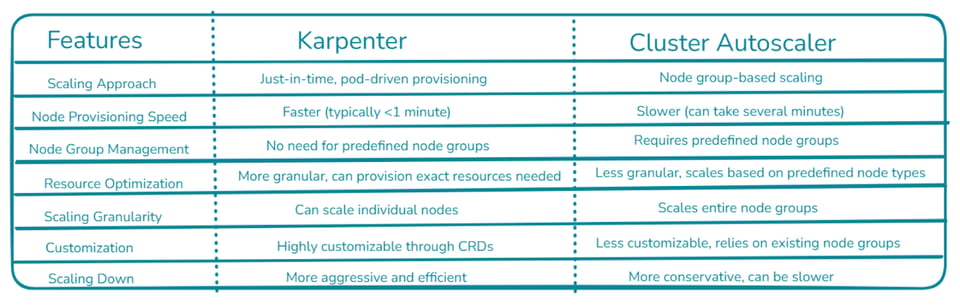
O Karpenter representa uma abordagem mais moderna e flexível para o escalonamento de clusters Kubernetes, oferecendo tempos de provisionamento mais rápidos e utilização de recursos mais eficiente. É especialmente adequado para ambientes dinâmicos com requisitos variáveis de workloads. O Cluster Autoscaler, por outro lado, é uma solução mais consolidada, que funciona bem com grupos de nós predefinidos e oferece suporte mais amplo a provedores de nuvem. É uma escolha confiável para ambientes mais estáticos ou quando se trabalha com múltiplos provedores de nuvem.
>> Veja aqui como aproveitar ao máximo o Karpenter com right-sizing inteligente de pods.
Aproveite ao máximo o Karpenter com a PerfectScale
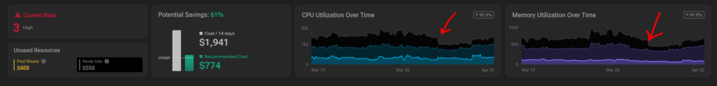
Integrar o Karpenter à PerfectScale pode aumentar significativamente a eficiência do seu cluster Kubernetes. Embora o Karpenter ofereça provisionamento de nós inteligente e just-in-time, ele pode não ter insights aprofundados sobre o histórico de utilização de recursos e as necessidades de confiabilidade dos seus workloads. A PerfectScale preenche essa lacuna analisando os padrões dos workloads e fornecendo recomendações de otimização. Essa sinergia permitiu que clientes alcançassem uma redução adicional de custos de 30% a 50% além do que o Karpenter oferece sozinho. Por exemplo, a PerfectScale pode identificar cenários em que o Karpenter tende a provisionar recursos em excesso e sugerir configurações para evitar custos desnecessários e possíveis impactos na confiabilidade. Experimente a PerfectScale para ver como ela pode aprimorar seu cluster gerenciado pelo Karpenter. Cadastre-se ou agende uma demo para saber mais.