

Karpenter est l'autoscaler Kubernetes-native conçu pour gérer l'efficacité des ressources k8s. Il provisionne dynamiquement des nœuds en réponse aux workloads en attente, garantissant que les applications disposent des ressources nécessaires précisément au moment voulu. Cette approche vise à améliorer l'efficacité opérationnelle et à réduire les dépenses cloud.
Cependant, concilier efficacité et maîtrise des coûts avec Karpenter n'a rien d'évident. Si Karpenter offre des capacités puissantes, ses paramètres par défaut et certaines bonnes pratiques recommandées peuvent involontairement entraîner des coûts plus élevés, même s'ils améliorent les performances. Il est donc essentiel de ne pas se contenter de suivre les recommandations générales, mais de les adapter aux besoins spécifiques de vos workloads et à vos contraintes budgétaires.
Dans cet article, nous aborderons Karpenter, son architecture, les bonnes pratiques en matière de coûts et d'efficacité, puis nous partagerons notre expérience montrant que les bonnes pratiques doivent être adaptées à votre environnement.
Qu'est-ce que Karpenter ?
Karpenter est un autoscaler moderne, Kubernetes-native, conçu pour répondre aux besoins dynamiques des workloads conteneurisés. Contrairement aux outils d'autoscaling traditionnels, Karpenter est pensé pour provisionner automatiquement et rapidement des nœuds en fonction des besoins de votre cluster. Sa réactivité en temps réel garantit que vos applications disposent des ressources requises exactement au moment voulu, réduisant ainsi à la fois la latence et les surcoûts.
Comment fonctionne Karpenter ?
Karpenter est un autoscaler Kubernetes-native conçu pour ajuster dynamiquement la taille de votre cluster Kubernetes en fonction de la demande réelle des workloads. Concrètement, Karpenter surveille en continu l'état de votre cluster, y compris les métriques des pods et des nœuds. Cette surveillance lui permet de prendre des décisions de scaling éclairées. Lorsqu'il détecte que les ressources actuelles sont insuffisantes pour absorber la charge, Karpenter lance un processus de scale-up : il provisionne de nouveaux nœuds avec les types et tailles d'instances les mieux adaptés aux besoins en ressources des pods en attente. À l'inverse, lorsque la charge diminue et que des nœuds deviennent sous-utilisés, Karpenter réduit la taille du cluster en toute sécurité en déprovisionnant ces nœuds, sans perturber les workloads en cours d'exécution.
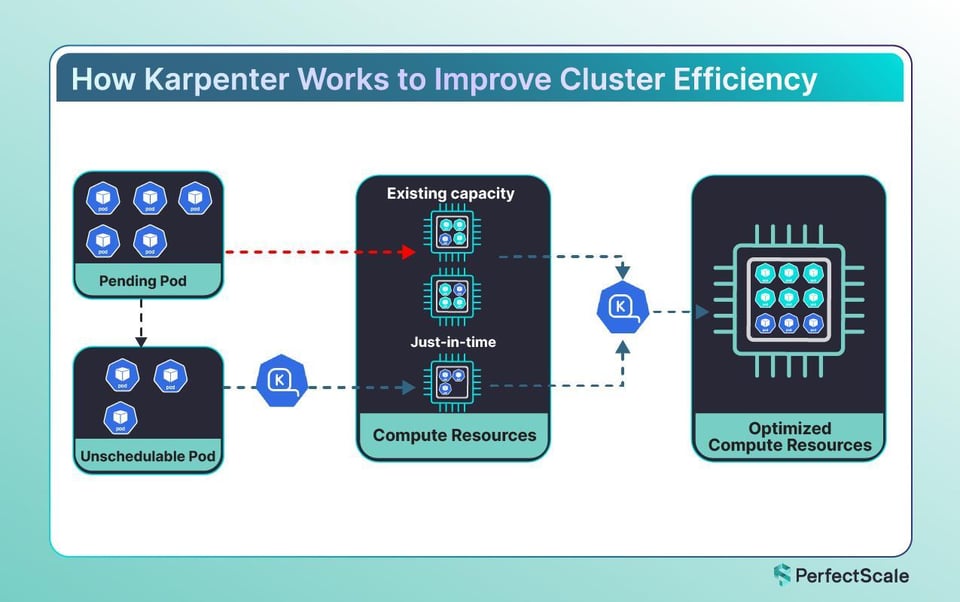
L'une des grandes forces de Karpenter est sa capacité à optimiser l'allocation des ressources, ce qui contribue à réduire les coûts opérationnels. Il y parvient en sélectionnant les types et tailles d'instances les plus économiques et en regroupant efficacement les workloads sur les nœuds pour maximiser l'utilisation des ressources. Il est toutefois très important de noter que Karpenter ne peut optimiser l'allocation des ressources que si les pods sont correctement dimensionnés. Il s'appuie sur les requests de ressources des conteneurs et les contraintes de scheduling pour effectuer la sélection des nœuds. PerfectScale peut vous aider sur le right-sizing des pods, garantissant que Karpenter dispose d'informations fiables pour travailler. Pour en savoir plus sur la manière dont PerfectScale renforce l'efficacité de Karpenter, consultez cet [article
](https://www.perfectscale.io/blog/getting-the-most-out-of-karpenter-with-perfectscale)Le processus décisionnel de Karpenter repose sur un ensemble de politiques et de configurations personnalisables. Les utilisateurs peuvent définir une logique de provisionnement personnalisée à l'aide des Custom Resource Definitions (CRD) NodePool, en spécifiant des paramètres tels que les types d'instances, les zones et les limites de ressources. Cela permet un contrôle fin de l'allocation et de la gestion des ressources au sein du cluster. Des politiques de scaling peuvent être définies pour fixer des nombres minimum et maximum de nœuds, ainsi que des périodes de cooldown pour contrôler la fréquence des actions de scaling.
Karpenter a été initialement développé par AWS pour améliorer la gestion du cycle de vie des nœuds dans les clusters Amazon EKS. Constatant son potentiel, Microsoft a ensuite introduit un provider (NAP) permettant d'exécuter Karpenter sur Azure Kubernetes Service (AKS), offrant des avantages similaires aux utilisateurs d'AKS.
>> Consultez notre guide Karpenter : le guide ultime
Fonctionnalités clés de Karpenter :
Provisionnement rapide des nœuds : l'un des atouts majeurs de Karpenter est sa capacité à démarrer rapidement de nouveaux nœuds. Il surveille en continu votre cluster et identifie les pods en attente de scheduling faute de ressources. En provisionnant des nœuds à la demande, il minimise les temps d'attente et assure le bon fonctionnement de vos applications.
Sélection d'instances adaptée aux workloads : Karpenter n'ajoute pas seulement de la capacité de calcul, il ajoute la bonne capacité. Il évalue dynamiquement les besoins en ressources des workloads entrants (CPU, mémoire, voire GPU) et sélectionne les types d'instances les plus appropriés disponibles dans votre environnement cloud. Cette approche centrée sur les workloads vous évite de payer pour de la capacité superflue tout en garantissant des performances optimales pour vos applications.
Intégration cloud-native : conçu dès le départ pour les infrastructures cloud modernes, Karpenter s'intègre parfaitement aux principaux fournisseurs cloud. Il utilise les API natives pour prendre des décisions intelligentes basées sur les tarifs en vigueur, les types d'instances disponibles et la capacité régionale.
>> En savoir plus sur les pièges de Karpenter
Cycle de vie des nœuds et processus de disruption
Expiration des nœuds : l'une des fonctionnalités clés de Karpenter est l'expiration des nœuds, contrôlée par le paramètre expireAfter. Ce réglage définit la durée de vie d'un nœud, garantissant que les nœuds sont recyclés périodiquement pour intégrer les dernières configurations et mises à jour de sécurité. Par défaut, les nœuds expirent après 30 jours (720 heures), mais cette durée peut être personnalisée selon vos exigences opérationnelles. À l'expiration, Karpenter lance un processus d'arrêt progressif : il applique un taint au nœud pour empêcher le scheduling de nouveaux pods, évince les pods existants en respectant leurs Pod Disruption Budgets (PDB), puis arrête le nœud. Cette approche préserve la stabilité du cluster et minimise les interruptions de service.
Disruption : Karpenter dispose de politiques de consolidation pour optimiser l'utilisation des ressources et réduire les coûts. La consolidation identifie les opportunités de supprimer des nœuds sous-utilisés, soit en redistribuant leurs workloads vers d'autres nœuds disposant de capacité disponible, soit en les remplaçant par des instances plus économiques. Karpenter évalue les nœuds à consolider en fonction de leur taux d'utilisation, afin de réduire les dépenses globales.
Le comportement de la consolidation est contrôlé par deux configurations :
a. consolidationPolicy : détermine quand un nœud est considéré comme consolidable. Vous avez le choix entre :
WhenEmpty : les nœuds ne sont consolidés que lorsqu'ils n'hébergent aucun pod en cours d'exécution (hors daemons).
WhenEmptyOrUnderutilized : cette politique de consolidation autorise la suppression des nœuds complètement vides ou faiblement utilisés.
b. consolidateAfter : définit un délai après un événement de scheduling avant que Karpenter ne vérifie si une consolidation est possible. Cela évite un churn inutile de nœuds dû à des variations de charge de courte durée.
Voyons maintenant les trois types de stratégies de consolidation utilisées par Karpenter :
1. Consolidation des nœuds vides
C'est le cas le plus simple. Si un nœud n'héberge aucun pod significatif (uniquement des daemonsets, par exemple), il est arrêté immédiatement. Ces suppressions peuvent s'effectuer en parallèle sur l'ensemble de votre cluster.
2. Consolidation multi-nœuds
Il s'agit d'une optimisation plus complexe où Karpenter tente de remplacer deux nœuds sous-utilisés ou plus par un seul nœud moins cher. Il estime la meilleure combinaison de nœuds à consolider.
3. Consolidation d'un nœud unique
Dans ce cas, chaque nœud est évalué individuellement. Si les workloads d'un nœud peuvent être déplacés vers d'autres nœuds existants ou remplacés par une instance moins chère, Karpenter déclenche ce remplacement.
Gestion du drift : le drift survient lorsque l'état réel d'un nœud diverge de sa configuration souhaitée à la suite de modifications des spécifications NodePool ou EC2NodeClass. Karpenter surveille en continu ces incohérences et les corrige automatiquement en mettant à jour ou en remplaçant les nœuds concernés. Cette capacité d'auto-réparation maintient la cohérence du cluster et garantit que tous les nœuds respectent les configurations définies, gage de fiabilité et de bonnes performances.
Pour offrir un contrôle granulaire des disruptions, Karpenter propose des annotations au niveau des pods comme des nœuds. En ajoutant l'annotation karpenter.sh/do-not-disrupt: "true" à un pod ou à un nœud, les utilisateurs peuvent empêcher Karpenter de perturber ces ressources lors des activités de consolidation ou de gestion du drift. C'est utile pour les workloads exigeant une haute disponibilité ou exécutant des processus de longue durée qui ne doivent pas être interrompus.

Comment la décision est-elle prise en coulisses ?
Karpenter évalue différents facteurs pour déterminer les nœuds les plus appropriés à consolider :
a. Nœuds hébergeant peu de pods : privilégier les nœuds qui hébergent moins de pods garantit que le processus de consolidation affecte le moins de workloads possible, réduisant ainsi les perturbations potentielles.
b. Nœuds proches de l'expiration : les nœuds qui approchent de leur date d'expiration prédéfinie sont considérés comme des candidats prioritaires à la consolidation, en cohérence avec les calendriers de maintenance et les stratégies d'optimisation des ressources.
c. Nœuds exécutant des pods de faible priorité : en ciblant les nœuds qui exécutent principalement des pods de moindre priorité, Karpenter garantit que les workloads critiques ne sont pas affectés durant le processus de consolidation.
Si un nœud ne peut pas être supprimé, vous pouvez consulter les logs de Karpenter pour obtenir des événements détaillés expliquant les raisons.
Bonnes pratiques pour optimiser Karpenter
Passons en revue les bonnes pratiques pour optimiser Karpenter :
1. Configurer l'expiration des nœuds : définissez le paramètre expireAfter pour garantir le remplacement périodique des nœuds, en intégrant ainsi les derniers correctifs de sécurité et améliorations de performances. Cette approche proactive réduit le risque de drift à long terme et de vulnérabilités potentielles. Il est essentiel de définir une durée d'expiration adaptée à votre type de workload, afin de concilier sécurité et maîtrise des coûts.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Définir le délai de grâce avant terminaison : le paramètre terminationGracePeriod définit la durée maximale pendant laquelle Karpenter attend le drain d'un nœud avant de l'arrêter de force. Un délai de grâce bien configuré offre un équilibre entre laisser aux pods le temps de s'arrêter proprement et recycler les nœuds rapidement pour réduire les coûts. Un délai trop court peut entraîner des arrêts brutaux et fragiliser les workloads, tandis qu'un délai excessivement long retarde les économies. Il est recommandé de calculer un délai de grâce adapté à votre environnement.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. Utiliser l'annotation karpenter.sh/do-not-disrupt : appliquez cette annotation aux pods critiques pour empêcher leur éviction durant les activités de consolidation. Si elle protège les workloads essentiels, son usage excessif peut bloquer la suppression des nœuds lors des renouvellements planifiés, générant des inefficacités. Réservez cette annotation aux processus réellement critiques et de courte durée ou aux jobs interactifs, et évitez de l'appliquer aux services stateful de longue durée, sauf absolue nécessité.
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Appliquer des Pod Disruption Budgets (PDB) : les PDB garantissent la disponibilité des applications lors d'événements de disruption des nœuds en spécifiant le nombre minimum de pods devant rester disponibles pendant les perturbations. La configuration des PDB implique de choisir entre minAvailable et maxUnavailable selon les SLA (Service Level Agreements) de vos workloads. Intégrez les PDB à Karpenter pour permettre un drain progressif des nœuds et minimiser les interruptions. Pensez également à mettre à jour régulièrement vos PDB pour refléter la dynamique de l'autoscaling et préserver leur efficacité.
5. Configuration des NodePools et contraintes en couches : vous pouvez concevoir des NodePools adaptés aux différents workloads, améliorant ainsi l'utilisation des ressources et la résilience. Par exemple, des NodePools distincts pour les workloads stateful et stateless permettent une sélection optimisée des types d'instances, etc. Vous pouvez aussi utiliser les node selectors, les affinités et les tolerations pour affiner le scheduling, en garantissant que les workloads sont placés sur les nœuds appropriés sans compromettre la résilience.
6. Politiques de consolidation pour optimiser les coûts : la fonctionnalité de consolidation de Karpenter optimise l'utilisation des ressources en identifiant les nœuds sous-utilisés et en regroupant les workloads sur un nombre réduit de nœuds. Ce processus peut générer des économies grâce à un bin-packing efficace et à l'agrégation des ressources. Il est cependant essentiel de mettre en balance les perturbations potentielles de la consolidation avec les bénéfices en matière d'économies et d'efficacité opérationnelle.
7. Équilibrer instances Spot et On-Demand : combiner instances Spot et On-Demand vous permet de profiter des avantages tarifaires tout en garantissant la stabilité des composants critiques. Configurez vos NodePools avec des pondérations et des limites d'instances appropriées, en cohérence avec vos commitments Savings Plans. Cette stratégie vous permet d'optimiser les coûts sans compromettre la fiabilité des workloads essentiels.

Notre expérience : quand les bonnes pratiques se retournent contre vous
- Rédigé par [Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
Dans notre cas, nous avons suivi les bonnes pratiques recommandées pour Karpenter. Nous avons configuré les nœuds avec le paramètre expireAfter pour garantir une rotation régulière.
Pour nos workloads critiques, nous avons appliqué l'annotation karpenter.sh/do-not-disrupt afin d'éviter toute perturbation durant les activités de consolidation. Sur le papier, cette approche semblait sans faille.
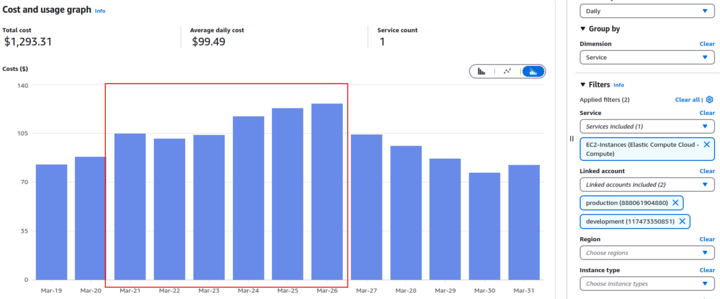
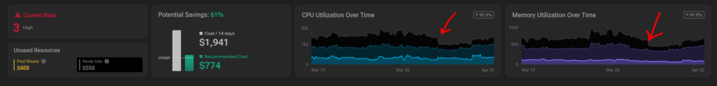
Lorsque les nœuds ont atteint leur expiration, Karpenter a lancé le provisionnement de nouveaux nœuds comme prévu. Mais une complication est apparue : les nœuds existants ne pouvaient pas être arrêtés, car l'annotation do-not-disrupt empêchait l'éviction des pods critiques qu'ils hébergeaient. Résultat : un scénario temporaire où anciens et nouveaux nœuds tournaient simultanément, doublant de fait notre capacité et, par conséquent, nos coûts.
Pour y remédier, nous avons défini le paramètre terminationGracePeriod, qui fixe la durée maximale de drain d'un nœud avant arrêt forcé. Si ce paramètre garantit que les nœuds finissent par être décommissionnés, il apporte son lot de défis. Si plusieurs nœuds stateful sont arrêtés simultanément sans Pod Disruption Budgets (PDB) correctement configurés, la stabilité du cluster peut être compromise.
Face à ces complexités, nous avons décidé de désactiver le paramètre expireAfter pour nos workloads stateful. Nous avons opté à la place pour des mises à jour manuelles de ces nœuds lors de fenêtres de maintenance planifiées ou à l'occasion des mises à niveau Kubernetes, environ tous les six mois. Cette approche nous a permis de garder le contrôle sur les événements du cycle de vie des nœuds, en assurant à la fois maîtrise des coûts et stabilité du cluster.
Cette expérience nous a appris une leçon essentielle : si les bonnes pratiques constituent des repères précieux, elles ne sont pas des solutions universelles. Il est impératif d'évaluer et d'adapter les configurations aux exigences propres à vos workloads et à votre environnement opérationnel. Vous pourrez ainsi exploiter tout le potentiel d'outils comme Karpenter sans mauvaises surprises.
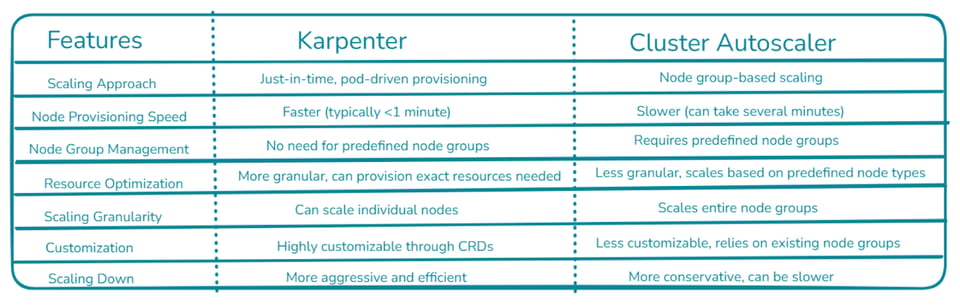
Karpenter vs Cluster Autoscaler
Karpenter incarne une approche plus moderne et flexible du scaling des clusters Kubernetes, avec des temps de provisionnement plus rapides et une utilisation plus efficace des ressources. Il est particulièrement adapté aux environnements dynamiques dont les besoins varient. Cluster Autoscaler, de son côté, est une solution plus établie qui fonctionne bien avec des groupes de nœuds prédéfinis et offre une prise en charge plus large des fournisseurs cloud. C'est un choix fiable pour des environnements plus statiques ou lorsque vous travaillez avec plusieurs fournisseurs cloud.
>> Découvrez ici comment tirer le meilleur de Karpenter grâce au right-sizing intelligent des pods.
Tirez le meilleur de Karpenter avec PerfectScale
Intégrer Karpenter à PerfectScale peut considérablement améliorer l'efficacité de votre cluster Kubernetes. Si Karpenter offre un provisionnement intelligent des nœuds en flux tendu, il peut manquer d'une vision approfondie de l'historique d'utilisation des ressources et des besoins de fiabilité de vos workloads. PerfectScale comble cette lacune en analysant les patterns des workloads et en fournissant des recommandations d'optimisation. Cette synergie a permis à des clients d'obtenir 30 à 50 % de réduction de coûts supplémentaire, au-delà de ce que Karpenter offre à lui seul. Par exemple, PerfectScale peut identifier les scénarios où Karpenter risque de surprovisionner des ressources et suggérer des configurations pour éviter des coûts inutiles et des impacts potentiels sur la fiabilité. Essayez PerfectScale pour voir comment renforcer votre cluster géré par Karpenter. Inscrivez-vous ou réservez une démo pour en savoir plus.