

Karpenter è l'autoscaler Kubernetes-native progettato per gestire l'efficienza delle risorse dei cluster k8s. Effettua il provisioning dinamico dei nodi in risposta ai workloads in attesa, garantendo che le applicazioni dispongano delle risorse necessarie esattamente quando servono. Questo approccio mira a migliorare l'efficienza operativa e a ridurre la spesa cloud.
Tuttavia, ottenere sia efficienza sia convenienza economica con Karpenter non è semplice. Karpenter offre funzionalità potenti, ma le sue impostazioni predefinite e alcune best practice consigliate possono involontariamente far lievitare i costi, pur migliorando le prestazioni. È quindi fondamentale non limitarsi a seguire le linee guida generali, ma adattarle alle esigenze specifiche dei propri workloads e alle proprie considerazioni di costo.
In questo articolo parleremo di Karpenter, della sua architettura e delle best practice per costi ed efficienza; infine condivideremo la nostra esperienza su come le best practice vadano calibrate in base al proprio ambiente.
Cos'è Karpenter?
Karpenter è un autoscaler moderno e Kubernetes-native, progettato per rispondere alle esigenze dinamiche dei workloads containerizzati. A differenza degli strumenti di autoscaling tradizionali, Karpenter è costruito per effettuare il provisioning dei nodi in modo automatico e rapido in base alle richieste del cluster. La sua reattività in tempo reale contribuisce a garantire che le applicazioni dispongano delle risorse necessarie esattamente quando servono, riducendo così sia la latenza sia l'overhead.
Come funziona Karpenter?
Karpenter è un autoscaler Kubernetes-native progettato per adattare dinamicamente le dimensioni del cluster Kubernetes in base alle richieste dei workloads in tempo reale. Alla base del suo funzionamento, Karpenter monitora costantemente lo stato del cluster, incluse le metriche di pod e nodi. Questo monitoraggio gli consente di prendere decisioni informate sulle azioni di scaling. Quando rileva che le risorse attuali non sono sufficienti a gestire il carico, Karpenter avvia un processo di scale-up: effettua il provisioning di nuovi nodi con i tipi e le dimensioni di istanza che meglio corrispondono ai requisiti di risorse dei pod in attesa. Al contrario, quando il carico diminuisce e i nodi risultano sottoutilizzati, Karpenter riduce le dimensioni del cluster in modo sicuro effettuando il de-provisioning di questi nodi, senza interrompere i workloads in esecuzione.
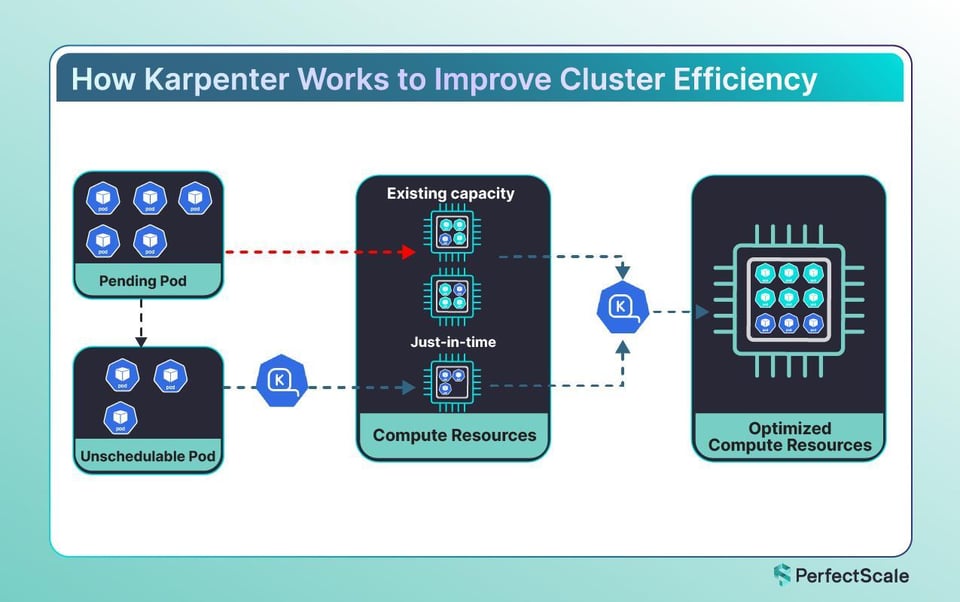
Uno dei principali punti di forza di Karpenter è la capacità di ottimizzare l'allocazione delle risorse, contribuendo così a ridurre i costi operativi. Lo fa selezionando i tipi e le dimensioni di istanza più convenienti e impacchettando in modo efficiente i workloads sui nodi per massimizzarne l'utilizzo. È però molto importante sottolineare che Karpenter può ottimizzare l'allocazione delle risorse solo se i pod sono dimensionati correttamente: per selezionare i nodi analizza le richieste di risorse dei container e i vincoli di scheduling. PerfectScale può aiutare con il right-sizing dei pod, garantendo che Karpenter disponga di informazioni accurate su cui lavorare. Per maggiori informazioni su come PerfectScale può potenziare l'efficacia di Karpenter, consulti questo [post
](https://www.perfectscale.io/blog/getting-the-most-out-of-karpenter-with-perfectscale)Il processo decisionale di Karpenter è guidato da un insieme di policy e configurazioni personalizzabili. Gli utenti possono definire logiche di provisioning personalizzate tramite le Custom Resource Definition (CRD) NodePool, specificando parametri come tipi di istanza, zone e limiti di risorse. Questo consente un controllo granulare su come le risorse vengono allocate e gestite all'interno del cluster. È possibile definire policy di scaling per impostare il numero minimo e massimo di nodi, oltre a periodi di cooldown per controllare la frequenza delle azioni di scaling.
Karpenter è stato originariamente sviluppato da AWS per migliorare la gestione del ciclo di vita dei nodi nei cluster Amazon EKS. Vedendone il potenziale, Microsoft ha poi introdotto un provider (NAP) per eseguire Karpenter su Azure Kubernetes Service (AKS), offrendo vantaggi analoghi agli utenti AKS.
>> Da non perdere: Karpenter: The Ultimate
Le funzionalità chiave di Karpenter:
Provisioning rapido dei nodi: una delle caratteristiche distintive di Karpenter è la capacità di avviare rapidamente nuovi nodi. Monitora costantemente il cluster, individuando i pod in attesa di scheduling per mancanza di risorse. Effettuando il provisioning dei nodi on-demand, riduce al minimo i tempi di attesa e mantiene le applicazioni sempre operative.
Selezione delle istanze in base ai workloads: Karpenter non si limita ad aggiungere capacità di calcolo: aggiunge il tipo giusto di capacità. Valuta dinamicamente i requisiti di risorse dei workloads in arrivo (CPU, memoria e persino GPU) e seleziona i tipi di istanza più adatti disponibili nel proprio ambiente cloud. Questo approccio orientato ai workloads garantisce di non pagare per capacità superflua e di ottenere prestazioni ottimali per le proprie applicazioni.
Integrazione cloud-native: progettato fin dall'inizio pensando alle infrastrutture cloud moderne, Karpenter si integra perfettamente con i principali cloud provider. Utilizza le API native per prendere decisioni intelligenti basate su prezzi correnti, tipi di istanza disponibili e capacità regionale.
>> Per saperne di più: le insidie di Karpenter
Ciclo di vita dei nodi e processi di disruption
Scadenza dei nodi: una delle funzionalità chiave di Karpenter è la scadenza dei nodi, controllata dal parametro expireAfter. Questa impostazione definisce la durata di vita di un nodo, garantendo che i nodi vengano riciclati periodicamente per incorporare le configurazioni e gli aggiornamenti di sicurezza più recenti. Per impostazione predefinita i nodi scadono dopo 30 giorni (720 ore), ma questa durata può essere personalizzata in base a specifiche esigenze operative. Alla scadenza, Karpenter avvia un processo di graceful shutdown: applica un taint al nodo per impedire lo scheduling di nuovi pod, esegue l'eviction dei pod esistenti rispettando i relativi Pod Disruption Budget (PDB) e infine termina il nodo. Questo approccio mantiene la stabilità del cluster e riduce al minimo le interruzioni di servizio.
Disruption: Karpenter dispone di policy di consolidamento per ottimizzare l'utilizzo delle risorse e ridurre i costi. Il consolidamento individua le opportunità di rimuovere i nodi sottoutilizzati, ridistribuendone i workloads su altri nodi con capacità disponibile oppure sostituendoli con istanze più convenienti. Karpenter valuta i nodi da consolidare in base al loro utilizzo e per ridurre la spesa complessiva.
Il comportamento del consolidamento è controllato da due configurazioni:
a. consolidationPolicy: determina quando un nodo è considerato "consolidabile". È possibile scegliere tra:
WhenEmpty: i nodi vengono consolidati solo quando non ospitano pod in esecuzione (esclusi i daemon).
WhenEmptyOrUnderutilized: questa policy di consolidamento consente la rimozione dei nodi completamente vuoti o solo scarsamente utilizzati.
b. consolidateAfter: imposta un ritardo dopo un evento di scheduling prima che Karpenter verifichi la possibilità di consolidamento. Aiuta a evitare un churn inutile dei nodi dovuto a variazioni di carico di breve durata.
Vediamo ora i tre tipi di strategie di consolidamento utilizzate da Karpenter:
1. Consolidamento dei nodi vuoti
È il caso più semplice. Se un nodo non ospita pod significativi (ad esempio solo daemonset), viene spento immediatamente. Questi nodi possono essere eliminati in parallelo in tutto il cluster.
2. Consolidamento multi-nodo
È un'ottimizzazione più complessa in cui Karpenter tenta di sostituire due o più nodi sottoutilizzati con un unico nodo più economico, stimando la combinazione di nodi migliore da consolidare.
3. Consolidamento a nodo singolo
In questo caso, ogni nodo viene valutato singolarmente. Se i workloads di un nodo possono essere spostati su altri nodi esistenti oppure sostituiti da un'istanza più economica, Karpenter attiva quella sostituzione.
Gestione del drift: il drift si verifica quando lo stato effettivo di un nodo diverge dalla configurazione desiderata a causa di modifiche alle specifiche del NodePool o dell'EC2NodeClass. Karpenter monitora costantemente tali incoerenze e le corregge automaticamente aggiornando o sostituendo i nodi interessati. Questa capacità di self-healing mantiene la coerenza del cluster e garantisce che tutti i nodi rispettino le configurazioni definite, con benefici in termini di affidabilità e prestazioni.
Per offrire un controllo granulare sulle disruption, Karpenter mette a disposizione annotazioni sia a livello di pod sia a livello di nodo. Aggiungendo l'annotazione karpenter.sh/do-not-disrupt: "true" a un pod o a un nodo, gli utenti possono impedire a Karpenter di interrompere queste risorse durante le attività di consolidamento o di gestione del drift. È utile per i workloads che richiedono alta disponibilità o che eseguono processi di lunga durata che non devono essere interrotti.

Come viene presa una decisione dietro le quinte?
Karpenter valuta diversi fattori per determinare i nodi più adatti al consolidamento:
a. Nodi con meno pod: dare priorità ai nodi che ospitano meno pod garantisce che il processo di consolidamento coinvolga il minor numero possibile di workloads, riducendo le potenziali interruzioni.
b. Nodi prossimi alla scadenza: i nodi che si avvicinano al termine di scadenza predefinito sono considerati candidati privilegiati per il consolidamento, in linea con i piani di manutenzione e le strategie di ottimizzazione delle risorse.
c. Nodi con pod a bassa priorità: puntando sui nodi che eseguono prevalentemente pod a priorità più bassa, Karpenter garantisce che i workloads critici non vengano toccati durante il processo di consolidamento.
Se un nodo non può essere rimosso, è possibile consultare i log di Karpenter, che riportano eventi dettagliati con le relative motivazioni.
Best practice per ottimizzare Karpenter
Vediamo le best practice per ottimizzare Karpenter:
1. Configurare la scadenza dei nodi: è opportuno impostare il parametro expireAfter per garantire la sostituzione periodica dei nodi, incorporando le patch di sicurezza e i miglioramenti di prestazioni più recenti. Questo approccio proattivo riduce il rischio di drift a lungo termine e di potenziali vulnerabilità. È essenziale definire un tempo di scadenza adeguato al tipo di workload, per bilanciare sicurezza e convenienza economica.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Impostare il Termination Grace Period: il parametro terminationGracePeriod definisce la durata massima per cui Karpenter attende il drain di un nodo prima di terminarlo forzatamente. Un grace period ben configurato bilancia la necessità di dare ai pod il tempo sufficiente per terminare in modo controllato con quella di riciclare i nodi tempestivamente per risparmiare. Un periodo troppo breve può portare a terminazioni brusche, con il rischio di workloads instabili, mentre un periodo eccessivamente lungo può ritardare i risparmi. È consigliabile calcolare il grace period in base al proprio ambiente.
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. Usare l'annotazione karpenter.sh/do-not-disrupt: è opportuno applicare questa annotazione ai pod critici per impedirne l'eviction durante le attività di consolidamento. Sebbene protegga i workloads essenziali, un uso eccessivo di questa annotazione può bloccare l'eliminazione dei nodi durante i refresh pianificati, generando inefficienze nell'uso delle risorse. Andrebbe riservata a processi davvero critici e di breve durata o a job interattivi, evitando di applicarla a servizi stateful di lunga durata se non strettamente necessario.
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Applicare i Pod Disruption Budget (PDB): i PDB garantiscono la disponibilità delle applicazioni durante gli eventi di disruption dei nodi, specificando il numero minimo di pod che devono rimanere disponibili durante le interruzioni. La configurazione dei PDB richiede di scegliere tra le impostazioni minAvailable e maxUnavailable in base agli SLA (Service Level Agreement) dei propri workloads. È consigliabile integrare i PDB con Karpenter per consentire un drain controllato dei nodi e ridurre al minimo i downtime, oltre ad aggiornarli regolarmente per riflettere le dinamiche di autoscaling e mantenerne l'efficacia.
5. Configurazione dei NodePool e vincoli a più livelli: è possibile progettare NodePool su misura per i diversi workloads, migliorando l'utilizzo delle risorse e la resilienza. Ad esempio, NodePool separati per workloads stateful e stateless consentono una selezione ottimizzata dei tipi di istanza, e così via. Si possono inoltre utilizzare node selector, affinity e toleration per affinare ulteriormente lo scheduling, garantendo che i workloads vengano collocati sui nodi appropriati senza compromettere la resilienza.
6. Policy di consolidamento per l'ottimizzazione dei costi: la funzionalità di consolidamento di Karpenter ottimizza l'uso delle risorse individuando i nodi sottoutilizzati e consolidando i workloads su un numero inferiore di nodi. Questo processo può generare risparmi grazie a un bin-packing efficiente e all'aggregazione delle risorse. È tuttavia essenziale bilanciare le potenziali interruzioni durante il consolidamento con i vantaggi in termini di risparmio e di miglioramento dell'efficienza operativa.
7. Bilanciare istanze Spot e On-Demand: utilizzare un mix di istanze Spot e On-Demand permette di sfruttare i vantaggi economici garantendo al contempo la stabilità dei componenti critici. È opportuno configurare i NodePool con pesi e limiti di istanza appropriati, in linea con i commitments dei propri Savings Plans. Questa strategia consente di ottimizzare i costi senza compromettere l'affidabilità dei workloads essenziali.

La nostra storia: quando le best practice si ritorcono contro
- Scritto da [Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
Nel nostro percorso abbiamo seguito le best practice raccomandate per Karpenter. Abbiamo configurato i nodi con il parametro expireAfter per garantirne la rotazione regolare.
Per i nostri workloads critici abbiamo applicato l'annotazione karpenter.sh/do-not-disrupt per evitare interruzioni durante le attività di consolidamento. Sulla carta, questo approccio sembrava impeccabile.
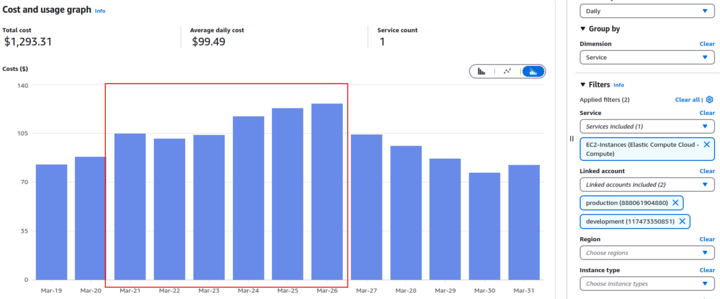
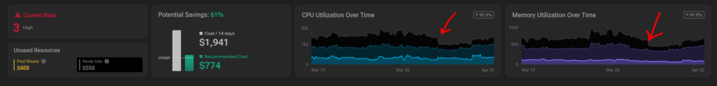
Quando i nodi hanno raggiunto la scadenza, Karpenter ha avviato come previsto il provisioning di nuovi nodi. Ma è sorta una complicazione: i nodi esistenti non potevano essere terminati, perché l'annotazione do-not-disrupt impediva l'eviction dei pod critici che ospitavano. Ne è risultato uno scenario temporaneo in cui i nodi vecchi e quelli nuovi giravano in parallelo, di fatto raddoppiando la nostra capacità e, di conseguenza, i nostri costi.
Per porvi rimedio abbiamo impostato il parametro terminationGracePeriod, che definisce la durata massima del drain di un nodo prima della terminazione forzata. Questo parametro garantisce che i nodi vengano prima o poi dismessi, ma introduce a sua volta alcune criticità: se più nodi stateful vengono terminati contemporaneamente senza Pod Disruption Budget (PDB) configurati correttamente, la stabilità del cluster potrebbe risentirne.
Di fronte a queste complessità, abbiamo deciso di disabilitare l'impostazione expireAfter per i nostri workloads stateful. Abbiamo optato invece per aggiornamenti manuali di questi nodi durante le finestre di manutenzione pianificate o in concomitanza con gli upgrade di Kubernetes, all'incirca ogni sei mesi. Questo approccio ci ha permesso di mantenere il controllo sugli eventi del ciclo di vita dei nodi, garantendo sia l'efficienza dei costi sia la stabilità del cluster.
Questa esperienza ci ha insegnato una lezione fondamentale: le best practice sono linee guida preziose, ma non sono soluzioni universali. È imprescindibile valutare e adattare le configurazioni alle esigenze specifiche dei propri workloads e del proprio ambiente operativo. Solo così è possibile sfruttare appieno il potenziale di strumenti come Karpenter senza conseguenze inattese.
Karpenter vs. Cluster Autoscaler
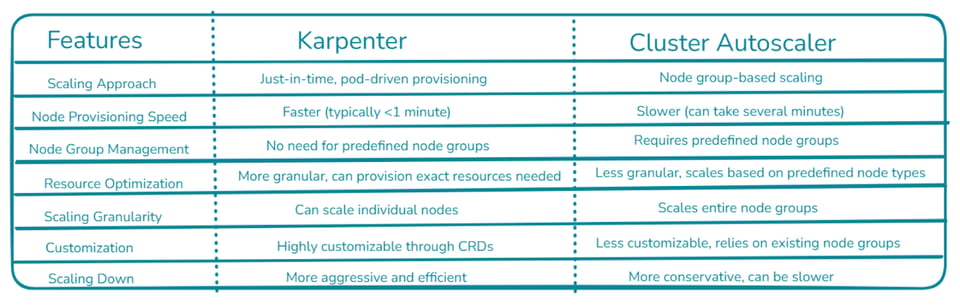
Karpenter rappresenta un approccio più moderno e flessibile allo scaling dei cluster Kubernetes, con tempi di provisioning più rapidi e un utilizzo più efficiente delle risorse. È particolarmente adatto ad ambienti dinamici con requisiti di workloads variabili. Cluster Autoscaler, invece, è una soluzione più consolidata, che funziona bene con node group predefiniti e offre un supporto più ampio dei cloud provider. È una scelta affidabile per ambienti più statici o quando si lavora con più cloud provider.
>> Scopra qui come ottenere il massimo da Karpenter grazie a un right-sizing intelligente dei pod.
Come ottenere il massimo da Karpenter con PerfectScale
Integrare Karpenter con PerfectScale può migliorare in modo significativo l'efficienza del cluster Kubernetes. Karpenter offre un provisioning dei nodi intelligente e just-in-time, ma può mancare di una visione approfondita dell'utilizzo storico delle risorse e delle esigenze di affidabilità dei workloads. PerfectScale colma questa lacuna analizzando i pattern dei workloads e fornendo raccomandazioni di ottimizzazione. Questa sinergia ha permesso ai clienti di ottenere una riduzione dei costi aggiuntiva del 30-50% rispetto a quanto offre Karpenter da solo. Ad esempio, PerfectScale può individuare gli scenari in cui Karpenter rischia di effettuare un overprovisioning delle risorse e suggerire configurazioni che prevengono costi superflui e potenziali impatti sull'affidabilità. Provi PerfectScale per scoprire come può potenziare il cluster gestito con Karpenter. Si registri o prenoti una demo per saperne di più.