

Karpenterは、Kubernetesのリソース効率を管理するために設計されたKubernetesネイティブのオートスケーラーです。保留中のワークロードに応じてノードを動的にプロビジョニングし、アプリケーションが必要とするリソースを、必要なタイミングで確実に利用できるようにします。これにより、運用効率を高め、クラウド支出を削減することを目指します。
しかし、Karpenterで効率とコスト効率を両立させるのは簡単ではありません。Karpenterは強力な機能を備えていますが、デフォルト設定や推奨ベストプラクティスの一部は、パフォーマンスを向上させる一方で、意図せずコストの増加を招くことがあります。そのため、一般的なガイドラインに従うだけでなく、自社のワークロードの要件やコスト面の事情に合わせて調整することが重要です。
本記事では、Karpenterの概要とアーキテクチャ、コストと効率のためのベストプラクティスを解説し、最後に「ベストプラクティスは環境に合わせて調整すべき」という私たち自身の実体験を共有します。
Karpenterとは?
Karpenterは、コンテナ化されたワークロードの動的なニーズに対応するために設計された、モダンなKubernetesネイティブのオートスケーラーです。従来のオートスケーリングツールとは異なり、Karpenterはクラスタの需要に応じてノードを自動的かつ迅速にプロビジョニングするよう設計されています。リアルタイムの応答性により、アプリケーションが必要なリソースを必要なタイミングで確実に利用でき、レイテンシとオーバーヘッドの両方を削減できます。
Karpenterの仕組み
Karpenterは、リアルタイムのワークロード需要に基づいてKubernetesクラスタのサイズを動的に調整するよう設計された、Kubernetesネイティブのオートスケーラーです。その中核として、KarpenterはPodとノード双方のメトリクスを含むクラスタの状態を継続的に監視しています。この監視により、Karpenterはスケーリング操作について的確な判断を下せます。現在のリソースではワークロードを処理しきれないと検知すると、Karpenterはスケールアップのプロセスを開始します。この際、保留中のPodのリソース要件に最も適したインスタンスタイプとサイズの新しいノードがプロビジョニングされます。逆に、ワークロードが減少してノードの使用率が低下すると、Karpenterはそれらのノードをデプロビジョニングしてクラスタを安全にスケールダウンし、実行中のワークロードが中断されないようにします。
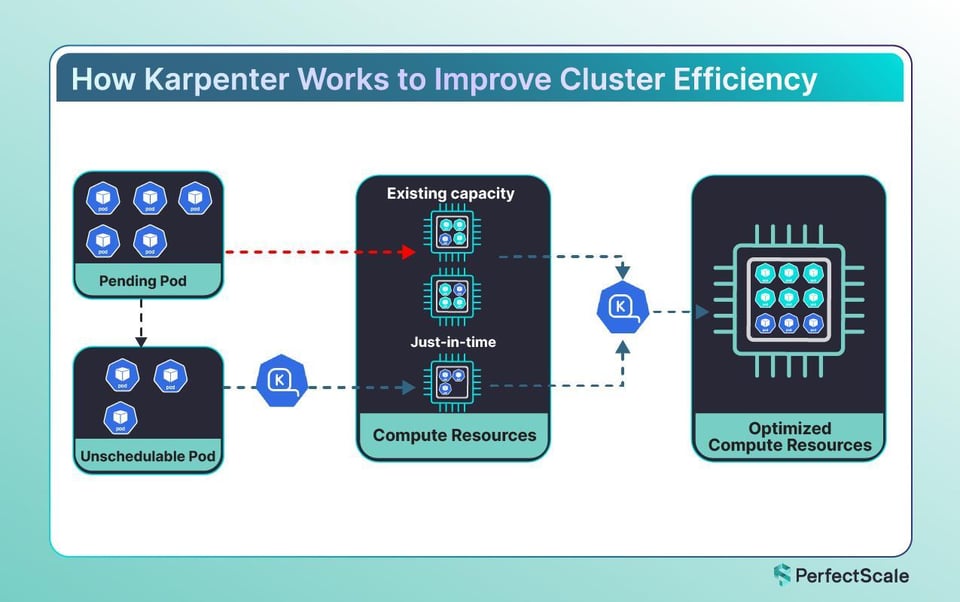
Karpenterの大きな強みの1つは、リソース割り当てを最適化し、運用コストの削減に貢献できることです。最もコスト効率の高いインスタンスタイプとサイズを選択し、ワークロードをノードに効率的に詰め込んでリソース使用率を最大化することで、これを実現します。ただし、Karpenterがリソース割り当てを最適化できるのは、Podが適切にライトサイジングされている場合に限られる点に注意が必要です。Karpenterはノード選択を行う際、コンテナのリソースリクエストとスケジューリング制約を参照します。PerfectScaleはPodのライトサイジングを支援し、Karpenterが正確な情報に基づいて動作できるようにします。PerfectScaleがKarpenterの効果をどのように高めるかについては、こちらの[記事
Karpenterはもともと、Amazon EKSクラスタのノードライフサイクル管理を強化するためにAWSが開発したものです。その可能性に着目したMicrosoftは、Azure Kubernetes Service(AKS)上でKarpenterを実行するためのプロバイダー(NAP)を導入し、AKSユーザーにも同様のメリットを提供しています。
>> Karpenter: The Ultimateもあわせてご覧ください
Karpenterの主な機能
迅速なノードプロビジョニング: Karpenterの際立った特長の1つは、新しいノードを素早く起動できることです。クラスタを継続的に監視し、リソース不足によってPodがスケジューリング待ちになっている状況を検知します。オンデマンドでノードをプロビジョニングすることで、待ち時間を最小限に抑え、アプリケーションのスムーズな稼働を維持します。
ワークロードを考慮したインスタンス選択: Karpenterは単にコンピュートキャパシティを追加するのではなく、「適切な種類の」コンピュートを追加します。新たに投入されるワークロードのリソース要件(CPU、メモリ、さらにはGPUのニーズなど)を動的に評価し、クラウド環境で利用可能な最適なインスタンスタイプを選択します。ワークロードを考慮したこのアプローチにより、不要なキャパシティに余計な費用を払うことなく、アプリケーションに最適なパフォーマンスを得られます。
クラウドネイティブな統合: Karpenterはモダンなクラウドインフラを前提にゼロから設計されており、主要なクラウドプロバイダーとシームレスに統合されます。ネイティブAPIを利用して、現在の価格、利用可能なインスタンスタイプ、リージョンのキャパシティに基づいたインテリジェントな判断を行います。
>> Karpenterの落とし穴について詳しくはこちら
ノードのライフサイクルとDisruption(中断)プロセス
ノードの有効期限(Node Expiration): Karpenterの主要機能の1つがノードの有効期限で、expireAfterパラメータで制御されます。この設定はノードの寿命を定め、ノードが定期的に再作成されることで最新の構成やセキュリティアップデートが確実に反映されるようにします。デフォルトでは30日(720時間)で期限切れになる設定ですが、この期間は運用要件に合わせてカスタマイズできます。有効期限に達すると、Karpenterは_グレースフルシャットダウン_のプロセスを開始します。まずノードにtaintを付与して新しいPodのスケジューリングを防ぎ、Pod Disruption Budget(PDB)を尊重しながら既存のPodを退避させ、最後にノードを終了します。このアプローチにより、クラスタの安定性を維持し、サービスの中断を最小限に抑えます。
Disruption(中断): Karpenterには、リソース使用率を最適化しコストを削減するための_統合(consolidation)ポリシー_があります。統合では、使用率の低いノードのワークロードを空き容量のある他のノードに再配置するか、よりコスト効率の高いインスタンスに置き換えることで、そうしたノードを削除する機会を特定します。Karpenterは使用率に基づいてノードを評価し、全体的なコストを削減します。
統合の動作は、次の2つの設定で制御されます。
a. consolidationPolicy: ノードが「統合可能(consolidatable)」と見なされるタイミングを決定します。選択肢は以下の2つです。
WhenEmpty: 実行中の(デーモン以外の)Podが存在しない場合にのみノードを統合します。
WhenEmptyOrUnderutilized: 完全に空、または使用率が低いノードの削除を許可する統合ポリシーです。
b. consolidateAfter: スケジューリングイベントの後、Karpenterが統合の可否をチェックするまでの遅延時間を設定します。短期的なワークロードの変動による不要なノードの入れ替わりを防ぐのに役立ちます。
続いて、Karpenterが使用する3種類の統合戦略を見ていきましょう。
1. 空ノードの統合(Empty Node Consolidation)
最もシンプルなケースです。ノード上に意味のあるPodがない場合(たとえばデーモンセットのみの場合)、そのノードは即座にシャットダウンされます。これらはクラスタ全体で並行して削除できます。
2. 複数ノードの統合(Multi-Node Consolidation)
より複雑な最適化で、Karpenterは使用率の低い2つ以上のノードを、より安価な1つのノードに置き換えようとします。統合すべきノードの最適な組み合わせを推定します。
3. 単一ノードの統合(Single Node Consolidation)
このケースでは、各ノードが個別に評価されます。あるノード上のワークロードを他の既存ノードに移動できる、またはより安価なインスタンスで置き換えられる場合、Karpenterはその入れ替えを実行します。
ドリフト管理: ドリフトは、NodePoolやEC2NodeClassの仕様変更により、ノードの実際の状態が望ましい構成から乖離した場合に発生します。Karpenterはこうした不整合を継続的に監視し、影響を受けたノードを更新または置き換えることで自動的に修正します。この自己修復機能によりクラスタ全体の一貫性が維持され、すべてのノードが定義された構成に準拠することで、高い信頼性と良好なパフォーマンスが得られます。
中断をきめ細かく制御するために、KarpenterはPodレベルとノードレベルの両方のアノテーションを提供しています。karpenter.sh/do-not-disrupt: "true" アノテーションをPodまたはノードに追加することで、統合やドリフト管理の処理中にこれらのリソースが中断されるのを防げます。高可用性が求められるワークロードや、中断すべきでない長時間実行プロセスを持つワークロードに有用です。

内部ではどのように判断されているのか
Karpenterはさまざまな要素を評価し、統合に最も適したノードを判断します。
a. Podが少ないノード: ホストするPodが少ないノードを優先することで、統合プロセスの影響を受けるワークロードを最小限に抑え、中断の可能性を減らします。
b. 有効期限が近いノード: 事前に定義された有効期限が近づいているノードは、メンテナンススケジュールやリソース最適化戦略と整合するため、統合の有力な候補と見なされます。
c. 優先度の低いPodを実行しているノード: 主に優先度の低いPodを実行しているノードを対象とすることで、統合プロセス中も重要なワークロードが影響を受けないようにします。
ノードを削除できない場合は、Karpenterのログで理由を説明する詳細なイベントを確認できます。
Karpenterを最適化するためのベストプラクティス
Karpenterを最適化するためのベストプラクティスを見ていきましょう。
1. ノード有効期限の設定: expireAfterパラメータを設定して、ノードが定期的に置き換えられ、最新のセキュリティパッチやパフォーマンス改善が反映されるようにしましょう。この予防的なアプローチにより、長期的なドリフトや潜在的な脆弱性のリスクを低減できます。セキュリティとコスト効率のバランスを取るため、ワークロードの種類に応じた適切な有効期限を設定することが重要です。
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: expireAfter: 168h # 7 days2. Termination Grace Periodの設定: terminationGracePeriodパラメータは、Karpenterがノードを強制終了する前にドレインを待つ最大時間を定義します。この猶予期間を適切に設定することで、Podが正常に終了するための十分な時間の確保と、コスト削減のためにノードを速やかに入れ替えることのバランスが取れます。短くしすぎると突然の終了によってワークロードが不安定になるリスクがあり、逆に長すぎるとコスト削減が遅れます。環境に応じて猶予期間を算出することをおすすめします。
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: nodepoolspec: template: spec: terminationGracePeriod: 30m3. karpenter.sh/do-not-disruptアノテーションの活用: 統合処理中に重要なPodが退避されるのを防ぐため、このアノテーションを適用しましょう。重要なワークロードを保護できる一方で、多用すると定期的な更新時にノードの削除がブロックされ、リソースの無駄につながります。このアノテーションは、本当に重要な短時間のプロセスやインタラクティブなジョブに限定し、どうしても必要な場合を除き、長時間稼働するステートフルサービスへの適用は避けるべきです。
apiVersion: v1kind: Nodemetadata: annotations: karpenter.sh/do-not-disrupt: "true" #Node -Level Control4. Pod Disruption Budget(PDB)の適用: PDBは、中断時に維持すべき最小Pod数を指定することで、ノード中断イベント中のアプリケーションの可用性を確保します。PDBを設定する際は、ワークロードのSLA(サービスレベル契約)に基づいてminAvailableとmaxUnavailableのいずれかを選択する必要があります。PDBをKarpenterと組み合わせることで、ノードの正常なドレインを可能にし、ダウンタイムを最小限に抑えられます。また、有効性を維持するため、オートスケーリングの変化を反映してPDBを定期的に更新すべきです。
5. NodePoolの構成とレイヤー化された制約: ワークロードごとに最適化されたNodePoolを設計することで、リソース使用率と耐障害性を高められます。たとえば、ステートフルとステートレスのワークロードでNodePoolを分けることで、インスタンスタイプの選択を最適化できます。また、ノードセレクター、アフィニティ、tolerationを活用してスケジューリングをさらに細かく制御し、耐障害性を損なうことなくワークロードを適切なノードに配置できます。
6. コスト最適化のための統合ポリシー: Karpenterの統合機能は、使用率の低いノードを特定し、ワークロードをより少ないノードに集約することでリソース使用を最適化します。このプロセスは、効率的なビンパッキングとリソース集約によるコスト削減につながります。ただし、統合中に発生しうる中断と、コスト削減や運用効率向上のメリットとのバランスを取ることが重要です。
7. SpotインスタンスとOn-Demandインスタンスのバランス: SpotとOn-Demandインスタンスを組み合わせることで、重要なコンポーネントの安定性を確保しながらコストメリットを活かせます。Savings Plansのcommitmentsに合わせて、適切な重み付けとインスタンス数の上限でNodePoolを設定しましょう。この戦略により、重要なワークロードの信頼性を損なうことなくコストを最適化できます。

私たちの体験談:ベストプラクティスが裏目に出たとき
- 執筆:[Olexandr Veleten](https://www.linkedin.com/in/aleksandr-veleten/)
私たちは、Karpenterが推奨するベストプラクティスに従って運用してきました。ノードにはexpireAfterパラメータを設定し、定期的なローテーションを確保していました。
重要なワークロードには、統合処理中の中断を防ぐためにkarpenter.sh/do-not-disruptアノテーションを適用しました。理屈の上では、このアプローチは完璧に見えました。
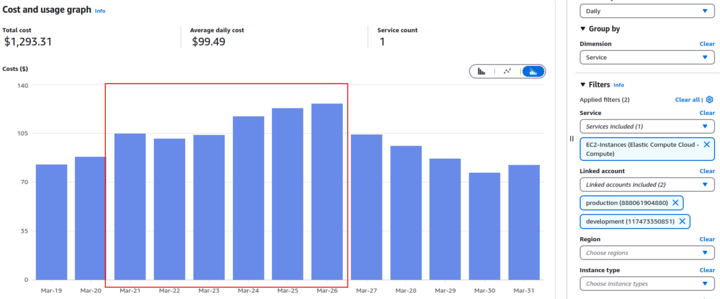
ノードが有効期限に達すると、Karpenterは想定どおり新しいノードのプロビジョニングを開始しました。しかしここで問題が発生しました。do-not-disruptアノテーションによってホストしている重要なPodの退避が妨げられたため、既存のノードを終了できなかったのです。その結果、古いノードと新しいノードが一時的に同時稼働する状態となり、キャパシティが実質的に2倍に、そして必然的にコストも2倍になってしまいました。
これに対処するため、terminationGracePeriodパラメータを設定しました。これは、強制終了までにノードのドレインに許容される最大時間を定義するものです。このパラメータによりノードは最終的に廃止されますが、新たな課題も生じます。Pod Disruption Budget(PDB)が適切に設定されていない状態で複数のステートフルノードが同時に終了されると、クラスタの安定性が損なわれる恐れがあるのです。
こうした複雑さを踏まえ、ステートフルなワークロードについてはexpireAfter設定を無効にすることにしました。代わりに、計画されたメンテナンスウィンドウ中、またはおよそ半年ごとのKubernetesアップグレードに合わせて、これらのノードを手動で更新する方針を選びました。このアプローチにより、ノードのライフサイクルイベントを自分たちでコントロールでき、コスト効率とクラスタの安定性の両方を確保できました。
この経験から得た重要な教訓は、ベストプラクティスは貴重な指針ではあるものの、万能の解決策ではないということです。 ワークロードと運用環境の固有の要件に合わせて構成を評価・調整することが不可欠です。そうすることで、予期せぬ結果を招くことなく、Karpenterのようなツールの潜在能力を最大限に引き出せます。
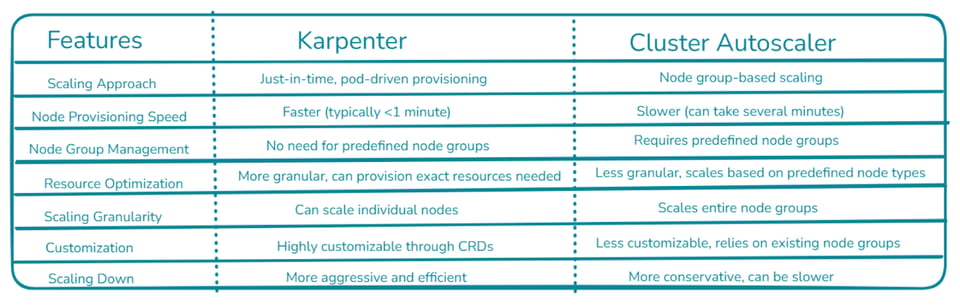
KarpenterとCluster Autoscalerの比較
Karpenterは、Kubernetesクラスタのスケーリングに対するよりモダンで柔軟なアプローチであり、より高速なプロビジョニングと効率的なリソース利用を実現します。ワークロード要件が変動する動的な環境に特に適しています。一方、Cluster Autoscalerはより成熟したソリューションで、事前定義されたノードグループとの相性が良く、幅広いクラウドプロバイダーをサポートしています。より静的な環境や、複数のクラウドプロバイダーを利用する場合には信頼できる選択肢です。
>> スマートなPodのライトサイジングでKarpenterを最大限に活用する方法はこちらをご覧ください。
PerfectScaleでKarpenterを最大限に活用する
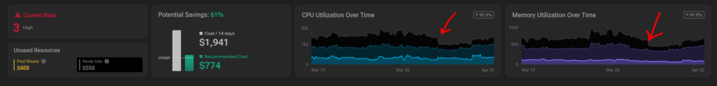
KarpenterとPerfectScaleを組み合わせることで、Kubernetesクラスタの効率を大幅に高められます。Karpenterはインテリジェントなジャストインタイムのノードプロビジョニングを提供しますが、ワークロードの過去のリソース使用状況や信頼性要件に対する深い洞察は不足しがちです。PerfectScaleはワークロードのパターンを分析し、最適化の推奨事項を提供することでこのギャップを埋めます。この相乗効果により、Karpenter単体で得られる効果に加えて、さらに30〜50%のコスト削減を実現したお客様もいます。たとえばPerfectScaleは、Karpenterがリソースを過剰にプロビジョニングする可能性のあるシナリオを特定し、不要なコストや信頼性への影響を防ぐ構成を提案できます。PerfectScaleを試して、Karpenterで管理するクラスタをどのように強化できるかをぜひご確認ください。サインアップまたはデモを予約して詳細をご覧ください。