
PerfectScale
Optimiza todo tu stack de Kubernetes de forma autónoma
PerfectScale ahora ajusta Karpenter, elimina los bloqueos de bin-packing, corrige la configuración del HPA y reacciona más rápido a los eventos OOM, manteniendo Kubernetes eficiente a medida que evoluciona.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.

About Marie Jaksman
Senior Marketing Manager
Part growth marketer, part DevOps translator. Optimizing funnels and clusters with a healthy fear of wasted compute.
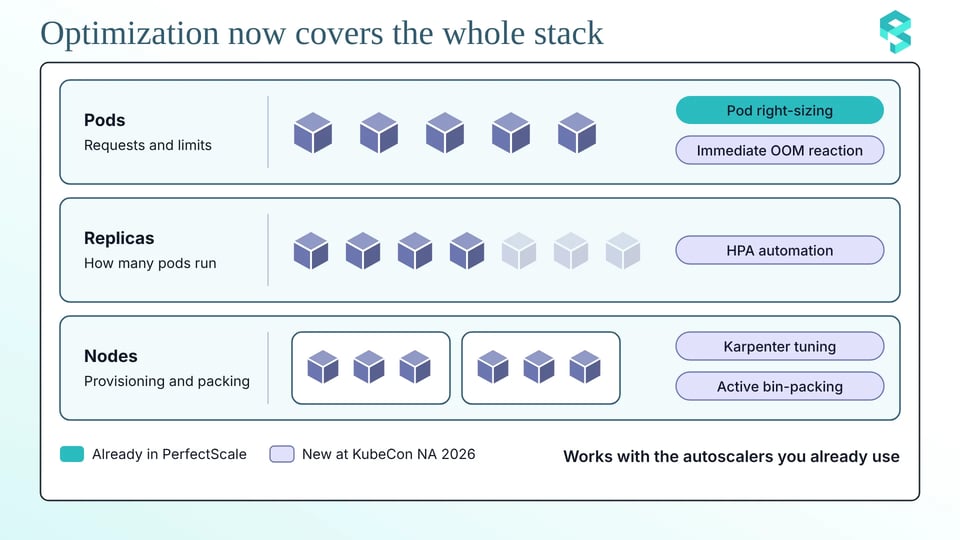
My personal pageEn KubeCon NA 2026 en Salt Lake City, PerfectScale muestra cómo ir más allá del rightsizing de pods y optimizar todo el stack de Kubernetes: desde los workloads y las réplicas hasta los nodos. Las nuevas capacidades incluyen el ajuste autónomo de Karpenter, la mejora activa del bin-packing, la automatización del HPA y reacciones más rápidas a los eventos OOM. Todas estas capacidades funcionan con tus autoescaladores actuales, así que puedes mejorar la eficiencia sin reemplazar las herramientas que ya usas.
Hasta ahora, PerfectScale se ha enfocado en el rightsizing continuo y autónomo de pods, ayudando a los equipos de DevOps, SRE y Platform a reducir los costos de Kubernetes de forma segura y sin comprometer el rendimiento. Pero el rightsizing de pods es solo una parte del panorama. Los requests y limits de los pods definen cuánta memoria y cómputo se reserva para los workloads. La eficiencia general de la infraestructura también depende de cuántas réplicas ejecuta el HPA, de cómo Karpenter aprovisiona y consolida los nodos, y de qué tan bien se empaquetan esos nodos.
Estas capas están estrechamente conectadas. El rightsizing de pods puede generar ahorros significativos, pero quedan más oportunidades cuando el número de réplicas es demasiado alto, los nodos están sobreaprovisionados o la capacidad disponible permanece ociosa. PerfectScale ahora optimiza estas capas en conjunto, ayudando a los equipos a sacar más provecho de su infraestructura de Kubernetes actual a medida que cambia la demanda.
El siguiente paso en la optimización de Kubernetes
La configuración de los autoescaladores suele definirse una vez durante la instalación o ajustarse durante un incidente, y luego queda sin cambios. Pero los workloads evolucionan, los patrones de tráfico cambian y aparecen nuevos tipos de instancias más rentables. Una configuración que tenía sentido hace tres meses hoy puede estar haciéndote perder dinero o poniendo en riesgo la confiabilidad. Por ejemplo: la consolidación de Karpenter es demasiado conservadora y deja capacidad ociosa en ejecución, elevando los costos. O es demasiado agresiva y arriesga la estabilidad.
- Un pod que no se puede desalojar impide que un nodo se elimine, incluso cuando el resto del nodo está vacío.
- La configuración del HPA queda obsoleta: el valor mínimo de réplicas se elevó durante un incidente y nunca volvió a bajarse, o el objetivo de escalado ya no coincide con el comportamiento real del workload.
Nuevos tipos de instancias más rentables quedan sin usar, mientras Karpenter sigue aprovisionando infraestructura que cuesta más de lo necesario. Un pod se queda sin memoria, y la respuesta por defecto es aumentar la memoria de todas las réplicas.
¿Te suena alguna de estas situaciones en tu infraestructura de Kubernetes?
PerfectScale siempre ha mantenido los requests y limits de los pods alineados con las necesidades reales de los workloads. En KubeCon mostramos cómo esa misma optimización continua se extiende ahora a las réplicas, los nodos y la confiabilidad de la memoria. Al alinear estos componentes a medida que cambian los workloads y la infraestructura, PerfectScale ayuda a los equipos a reducir costos y mantener la confiabilidad dentro de las políticas y los límites que ellos mismos definen.
Ajuste autónomo de Karpenter
Karpenter es potente, pero su rendimiento depende por completo de su configuración. La mayoría de los equipos lo configura una vez y espera que se las arregle solo a medida que el entorno evoluciona, mientras ellos vuelven a lanzar features y apagar incendios.
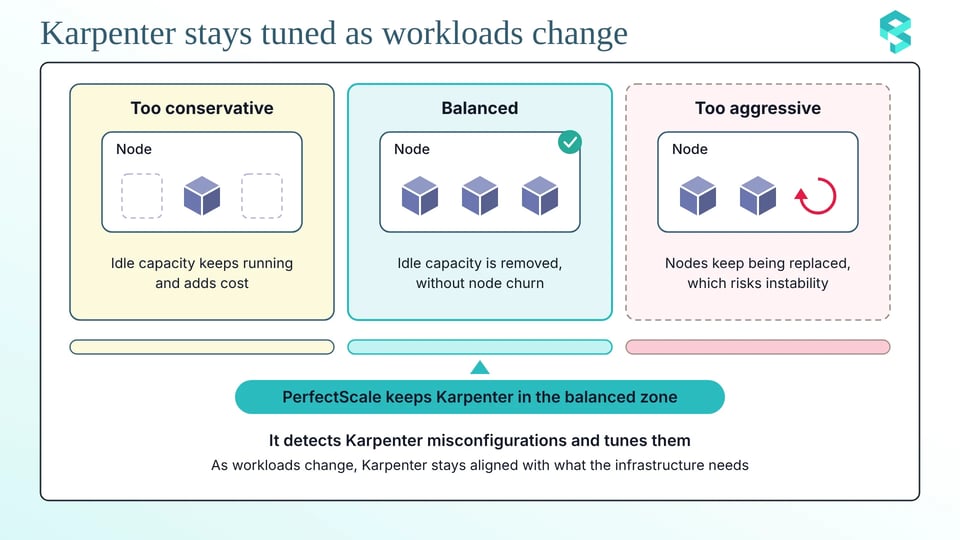
PerfectScale ahora detecta de forma continua las configuraciones erróneas de Karpenter y las ajusta, para que la consolidación elimine la capacidad ociosa sin provocar rotación de nodos. A medida que cambian los workloads, Karpenter se mantiene alineado con las necesidades de tu infraestructura, sin ajustes manuales constantes.
Bin-packing activo
A veces un nodo está casi vacío pero no se puede consolidar porque uno o más pods no pueden desalojarse. Ese único pod mantiene todo el nodo en funcionamiento, inflando tu factura de la nube.
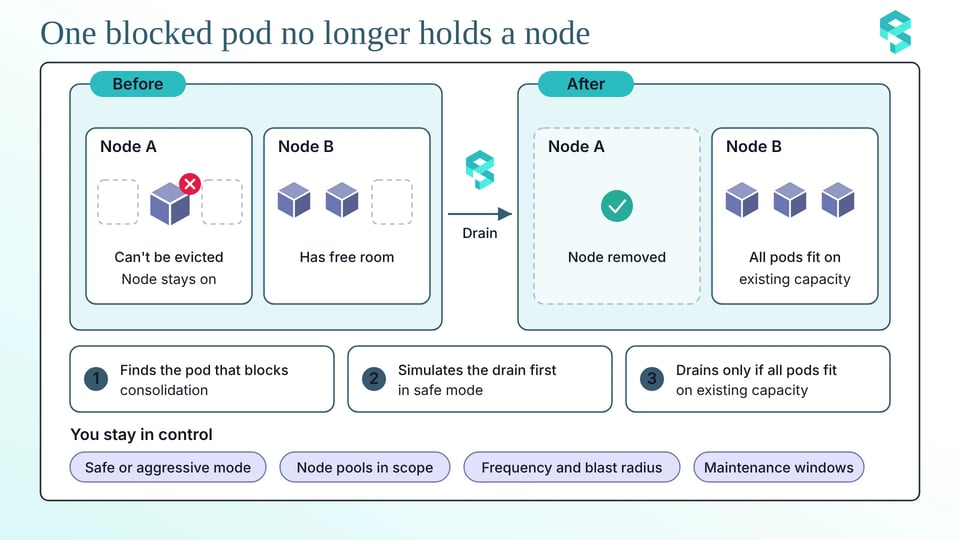
PerfectScale ya muestra qué pods bloquean la consolidación, por qué la bloquean, cómo resolverlo e incluso cuánto te cuesta la capacidad ociosa. Ahora puede resolver esos bloqueos automáticamente. Tú controlas cómo funciona: elige el modo seguro o agresivo, selecciona los node pools incluidos, define la frecuencia de ejecución y el radio de impacto, y establece ventanas de mantenimiento. En modo seguro, PerfectScale simula primero el drain y procede solo si todos los pods desalojados caben en la capacidad existente.
Automatización del HPA
El HPA puede mantener más réplicas de las que un workload necesita, escalar demasiado tarde para evitar presión sobre los recursos o no reflejar la carga real de la aplicación. Estos problemas suelen pasar desapercibidos a medida que cambian los workloads.
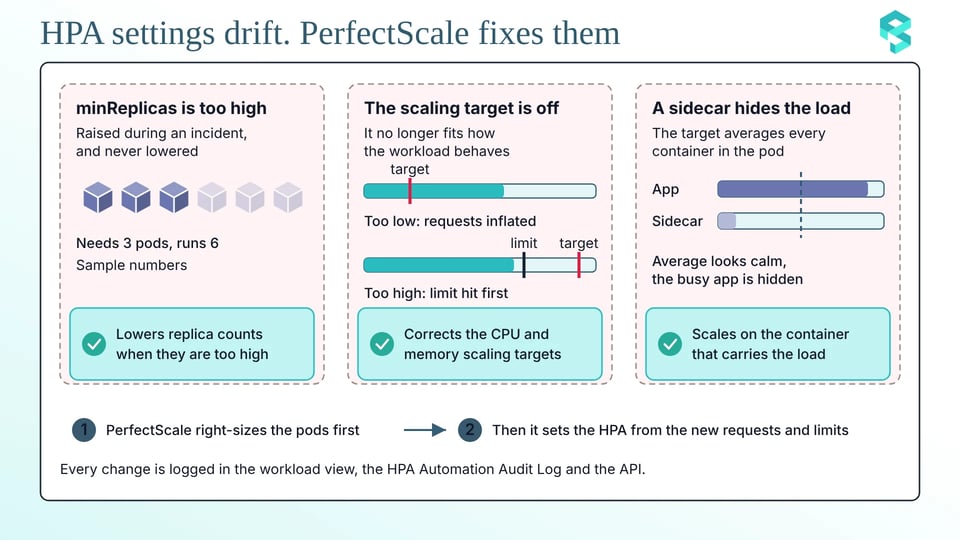
Algunas causas comunes: el número mínimo de réplicas puede ser demasiado alto, por ejemplo, cuando minReplicas se eleva durante un incidente y nunca vuelve a bajarse. El objetivo de escalado puede dejar de ajustarse al workload: si es demasiado bajo, los pods pueden necesitar requests de recursos mayores de los que realmente usan; si es demasiado alto, los contenedores pueden alcanzar los límites de CPU o quedarse sin memoria antes de que el HPA escale horizontalmente. Por último, un sidecar puede enmascarar la carga real de la aplicación, haciendo que un contenedor muy cargado parezca menos ocupado de lo que realmente está.
PerfectScale ahora detecta y corrige estos problemas automáticamente. Reduce el número de réplicas si es demasiado alto, corrige los objetivos de escalado de CPU y memoria, y dirige las decisiones de escalado al contenedor que realmente soporta la carga. Como los objetivos de escalado y los requests de recursos de los pods dependen unos de otros, PerfectScale los ajusta en conjunto con el autoescalado vertical y de nodos, evitando que un cambio anule los beneficios de otro. Cada cambio queda registrado y es visible en la vista del workload y a través de la API.
Reacción inmediata a eventos OOM
La seguridad siempre ha sido un punto central para PerfectScale. Seguimos agregando salvaguardas que ayudan a los equipos a optimizar la infraestructura sin poner en riesgo la confiabilidad de los workloads.
Cuando un workload se queda sin memoria, la solución habitual es aumentar el límite de memoria en todas las réplicas, "por si acaso". Puede evitar otra falla, pero también agrega recursos por los que sigues pagando mucho después del incidente.
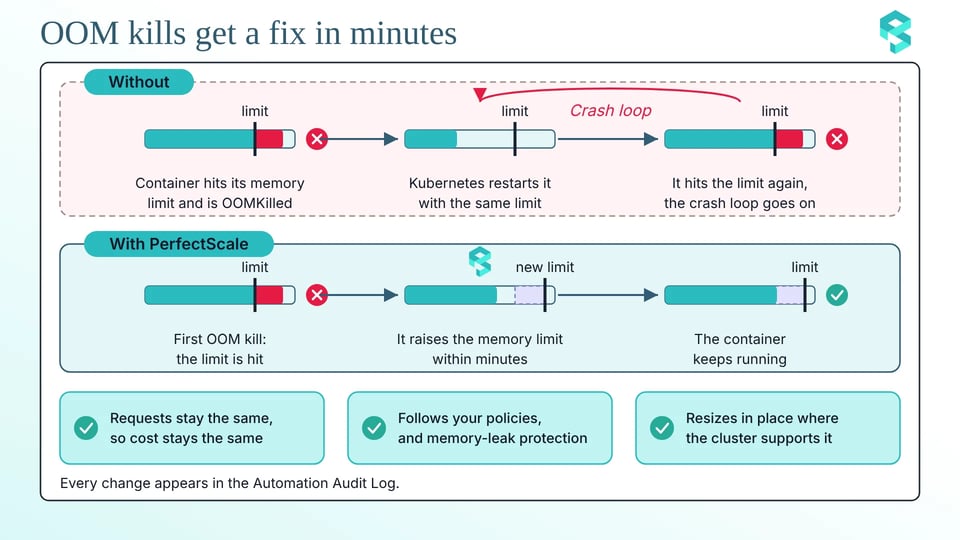
PerfectScale ahora reacciona de inmediato a los eventos OOM, ajustando rápidamente los límites de memoria para reducir el riesgo de fallas repetidas y mantener los workloads funcionando de forma confiable.
En resumen
Junto con el rightsizing de pods, estas capacidades extienden la optimización a todo el stack de Kubernetes: desde los requests de recursos de los workloads y el número de réplicas hasta el aprovisionamiento, la consolidación y la utilización de los nodos. PerfectScale ayuda a mantener estas capas alineadas a medida que tus workloads y tu infraestructura evolucionan, reduciendo costos sin comprometer la confiabilidad. Funciona con las herramientas que ya usas, sin agregar otro componente a tu stack. Estaremos en el stand #131 de KubeCon NA, en Salt Lake City. Pasa a verlo en vivo, hazles preguntas difíciles a nuestros ingenieros y cuéntanos tus desafíos de optimización de Kubernetes. Nos encanta un buen reto de Karpenter o HPA.
📅 ¿Quieres una sesión dedicada con nuestro equipo? ¡Agenda una reunión en el stand!
¿Aún no usas PerfectScale? Empieza gratis y descubre qué está corriendo en tus clústeres antes del evento.