
PerfectScale
Autonome Optimierung für Ihren gesamten Kubernetes-Stack
PerfectScale optimiert jetzt Karpenter, beseitigt Bin-Packing-Blocker, korrigiert HPA-Einstellungen und reagiert schneller auf OOM-Events – damit Ihr Kubernetes auch im Wandel effizient bleibt.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.

About Marie Jaksman
Senior Marketing Manager
Part growth marketer, part DevOps translator. Optimizing funnels and clusters with a healthy fear of wasted compute.
My personal pageAuf der KubeCon NA 2026 in Salt Lake City zeigt PerfectScale, wie Optimierung über Pod-Right-Sizing hinausgehen kann – und den gesamten Kubernetes-Stack umfasst: von Workloads und Replicas bis hin zu den Nodes. Zu den neuen Funktionen gehören autonomes Karpenter-Tuning, aktive Bin-Packing-Verbesserung, HPA-Automatisierung und schnellere Reaktionen auf OOM-Events. Alle Funktionen arbeiten mit Ihren bestehenden Autoscalern zusammen – Sie steigern also die Effizienz, ohne die Tools zu ersetzen, die Sie bereits nutzen.
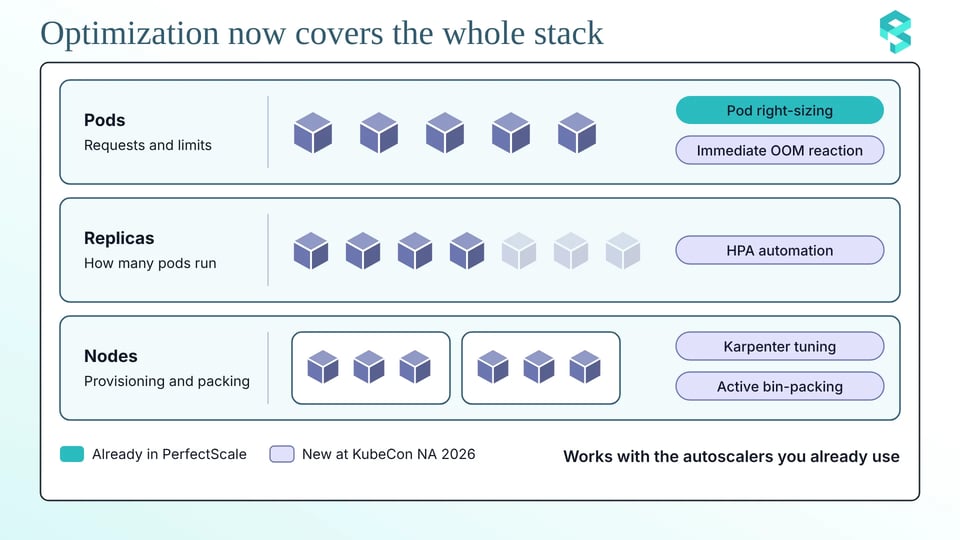
Bisher lag der Fokus von PerfectScale auf kontinuierlichem, autonomem Pod-Right-Sizing – damit DevOps-, SRE- und Platform-Teams ihre Kubernetes-Kosten sicher senken können, ohne die Performance zu beeinträchtigen. Doch Pod-Right-Sizing ist nur ein Teil des Gesamtbilds. Pod-Requests und -Limits legen fest, wie viel Arbeitsspeicher und Rechenleistung für Workloads reserviert wird. Die Gesamteffizienz der Infrastruktur hängt aber auch davon ab, wie viele Replicas der HPA betreibt, wie Karpenter Nodes bereitstellt und konsolidiert und wie effizient diese Nodes ausgelastet sind.
Diese Ebenen sind eng miteinander verbunden. Pod-Right-Sizing kann erhebliche Einsparungen bringen – doch weiteres Potenzial bleibt ungenutzt, wenn Replica-Zahlen zu hoch sind, Nodes überdimensioniert laufen oder verfügbare Kapazität brachliegt. PerfectScale optimiert diese Ebenen jetzt gemeinsam und hilft Teams, mehr aus ihrer bestehenden Kubernetes-Infrastruktur herauszuholen, während sich die Anforderungen ändern.
Der nächste Schritt in der Kubernetes-Optimierung
Autoscaler-Einstellungen werden oft einmal beim Setup konfiguriert oder während eines Incidents angepasst – und danach nie wieder angefasst. Doch Workloads entwickeln sich weiter, Traffic-Muster verschieben sich und neue, kostengünstigere Instanztypen kommen auf den Markt. Eine Konfiguration, die vor drei Monaten sinnvoll war, kann heute Geld verschwenden oder die Zuverlässigkeit gefährden. Ein Beispiel: Die Karpenter-Konsolidierung ist zu konservativ – ungenutzte Kapazität läuft weiter und treibt die Kosten in die Höhe. Oder sie ist zu aggressiv und riskiert Instabilität.
- Ein Pod, der nicht evicted werden kann, verhindert, dass ein Node entfernt wird – selbst wenn der Rest des Nodes leer ist.
- HPA-Einstellungen veralten: Ein Mindestwert für Replicas wurde während eines Incidents erhöht und nie wieder gesenkt, oder das Scaling-Ziel passt nicht mehr zum tatsächlichen Verhalten des Workloads.
Neue, kostengünstigere Instanztypen bleiben ungenutzt, während Karpenter weiterhin Infrastruktur bereitstellt, die mehr kostet als nötig. Einem Pod geht der Arbeitsspeicher aus – und die Standardreaktion ist, den Arbeitsspeicher für jede einzelne Replica zu erhöhen.
Kommt Ihnen das aus Ihrer eigenen Kubernetes-Infrastruktur bekannt vor?
PerfectScale hat Pod-Requests und -Limits schon immer am tatsächlichen Bedarf der Workloads ausgerichtet. Auf der KubeCon zeigen wir, wie dieselbe kontinuierliche Optimierung jetzt auch Replicas, Nodes und Memory-Zuverlässigkeit abdeckt. Indem PerfectScale diese Komponenten aufeinander abstimmt, während sich Workloads und Infrastruktur verändern, senken Teams ihre Kosten und sichern die Zuverlässigkeit – innerhalb der Richtlinien und Leitplanken, die sie selbst definieren.
Autonomes Karpenter-Tuning
Karpenter ist leistungsstark – aber nur so gut wie seine Konfiguration. Die meisten Teams richten es einmal ein und erwarten, dass es sich selbst an die Umgebung anpasst, während sie sich wieder dem Tagesgeschäft widmen – Features ausliefern und Brände löschen.
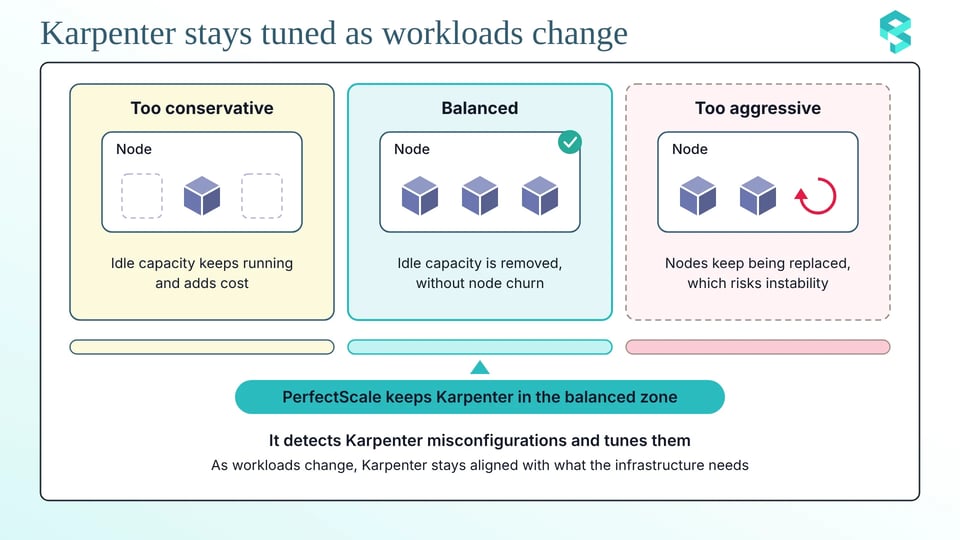
PerfectScale erkennt jetzt kontinuierlich Karpenter-Fehlkonfigurationen und optimiert sie – sodass die Konsolidierung ungenutzte Kapazität entfernt, ohne Node-Churn zu verursachen. Wenn sich Workloads ändern, bleibt Karpenter auf Ihre Infrastrukturanforderungen abgestimmt, ganz ohne ständiges manuelles Nachjustieren.
Aktives Bin-Packing
Manchmal ist ein Node fast leer, kann aber nicht konsolidiert werden, weil ein oder mehrere Pods nicht evicted werden können. Dieser eine Pod hält den gesamten Node am Laufen – und treibt Ihre Cloud-Rechnung in die Höhe.
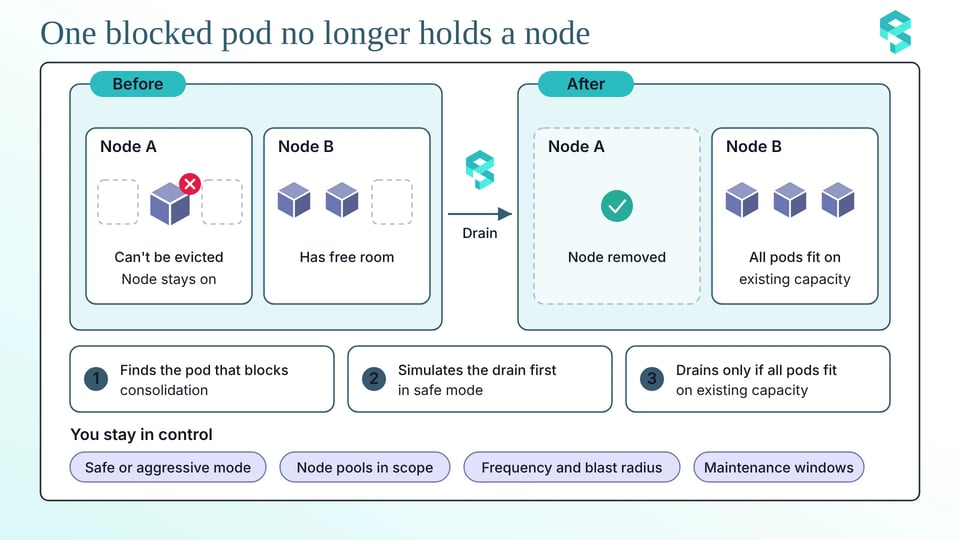
PerfectScale zeigt bereits, welche Pods die Konsolidierung blockieren, warum sie das tun, wie sich das Problem lösen lässt – und sogar, wie viel Sie die ungenutzte Kapazität kostet. Jetzt kann es diese Blocker automatisch beheben. Sie behalten die Kontrolle: Wählen Sie den sicheren oder aggressiven Modus, legen Sie die betroffenen Node-Pools fest, bestimmen Sie Ausführungsfrequenz und Blast Radius und definieren Sie Wartungsfenster. Im sicheren Modus simuliert PerfectScale den Drain zuerst und fährt nur fort, wenn alle evicted Pods auf der vorhandenen Kapazität Platz finden.
HPA-Automatisierung
Der HPA kann mehr Replicas betreiben, als ein Workload benötigt, zu spät skalieren, um Ressourcenengpässe zu verhindern, oder die tatsächliche Last der Anwendung nicht abbilden. Diese Probleme bleiben oft unbemerkt, während sich Workloads verändern.
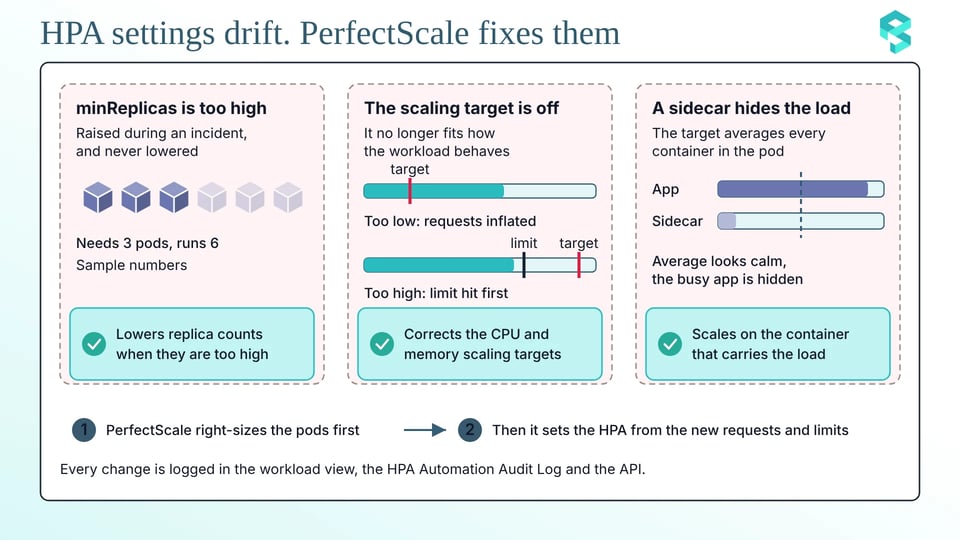
Einige häufige Ursachen: Die Mindestanzahl an Replicas ist zu hoch – etwa wenn minReplicas während eines Incidents erhöht und nie wieder gesenkt wurde. Das Scaling-Ziel passt möglicherweise nicht mehr zum Workload: Ist es zu niedrig angesetzt, benötigen Pods unter Umständen größere Resource-Requests, als sie tatsächlich nutzen; ist es zu hoch, können Container an CPU-Limits stoßen oder ihnen geht der Arbeitsspeicher aus, bevor der HPA hochskaliert. Und schließlich kann ein Sidecar die tatsächliche Last der Anwendung verschleiern – ein stark ausgelasteter Application-Container wirkt dann weniger beschäftigt, als er wirklich ist.
PerfectScale erkennt und behebt diese Probleme jetzt automatisch. Es senkt zu hohe Replica-Zahlen, korrigiert CPU- und Memory-Scaling-Ziele und richtet Skalierungsentscheidungen auf den Container aus, der die Last tatsächlich trägt. Da Scaling-Ziele und Pod-Resource-Requests voneinander abhängen, stimmt PerfectScale sie gemeinsam mit vertikalem und Node-Autoscaling aufeinander ab – so macht keine Änderung die Vorteile einer anderen zunichte. Jede Änderung wird protokolliert und ist in der Workload-Ansicht sowie über die API einsehbar.
Sofortige OOM-Reaktion
Sicherheit stand bei PerfectScale schon immer im Mittelpunkt. Wir ergänzen laufend Schutzmechanismen, mit denen Teams ihre Infrastruktur optimieren können, ohne die Zuverlässigkeit der Workloads zu gefährden.
Wenn einem Workload der Arbeitsspeicher ausgeht, besteht die übliche Lösung darin, das Memory-Limit "sicherheitshalber" für jede Replica zu erhöhen. Das mag einen weiteren Crash verhindern – fügt aber Ressourcen hinzu, für die Sie noch lange nach dem Incident bezahlen.
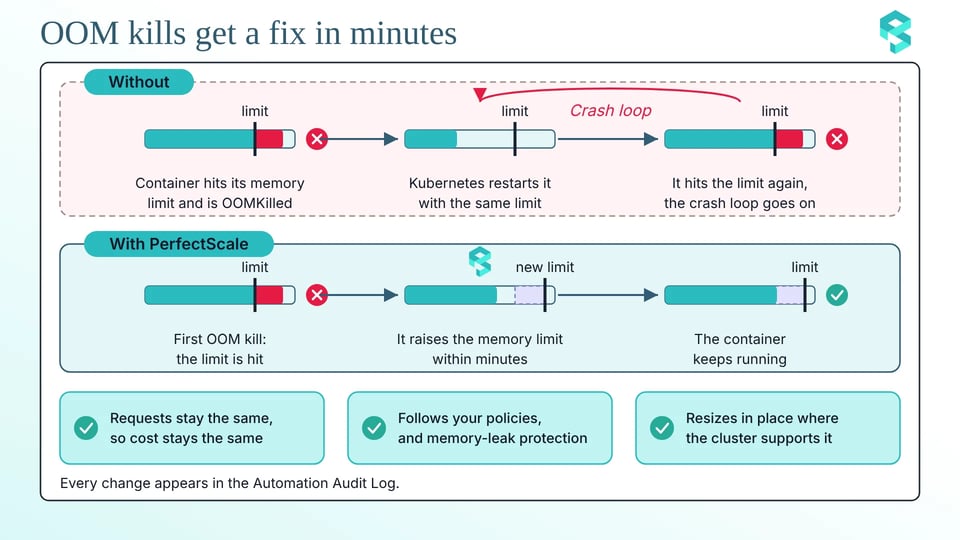
PerfectScale reagiert jetzt sofort auf OOM-Events und passt Memory-Limits umgehend an – das senkt das Risiko wiederholter Crashes und hält Workloads zuverlässig am Laufen.
Fazit
Zusammen mit dem Pod-Right-Sizing erweitern diese Funktionen die Optimierung auf den gesamten Kubernetes-Stack – von Workload-Resource-Requests und Replica-Zahlen bis hin zu Node-Provisionierung, Konsolidierung und Auslastung. PerfectScale hält diese Ebenen aufeinander abgestimmt, während sich Ihre Workloads und Ihre Infrastruktur weiterentwickeln – und senkt so die Kosten, ohne die Zuverlässigkeit zu beeinträchtigen. Es funktioniert mit den Tools, die Sie bereits einsetzen, ohne eine weitere Komponente zu Ihrem Stack hinzuzufügen. Sie finden uns am Stand #131 auf der KubeCon NA in Salt Lake City. Kommen Sie vorbei, erleben Sie alles live, stellen Sie unseren Engineers knifflige Fragen und teilen Sie Ihre Herausforderungen bei der Kubernetes-Optimierung mit uns. Kniffligen Karpenter- oder HPA-Problemen gehen wir gerne auf den Grund.
📅 Sie möchten in Ruhe mit unserem Team sprechen? Buchen Sie ein Meeting am Stand!
Sie nutzen PerfectScale noch nicht? Starten Sie kostenlos und verschaffen Sie sich noch vor der Messe einen Überblick darüber, was in Ihren Clustern läuft.