
PerfectScale
Otimização autônoma de todo o stack Kubernetes
A PerfectScale agora ajusta o Karpenter, remove bloqueios de bin-packing, corrige configurações de HPA e reage mais rápido a eventos OOM, mantendo o Kubernetes eficiente conforme ele evolui.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.

About Marie Jaksman
Senior Marketing Manager
Part growth marketer, part DevOps translator. Optimizing funnels and clusters with a healthy fear of wasted compute.
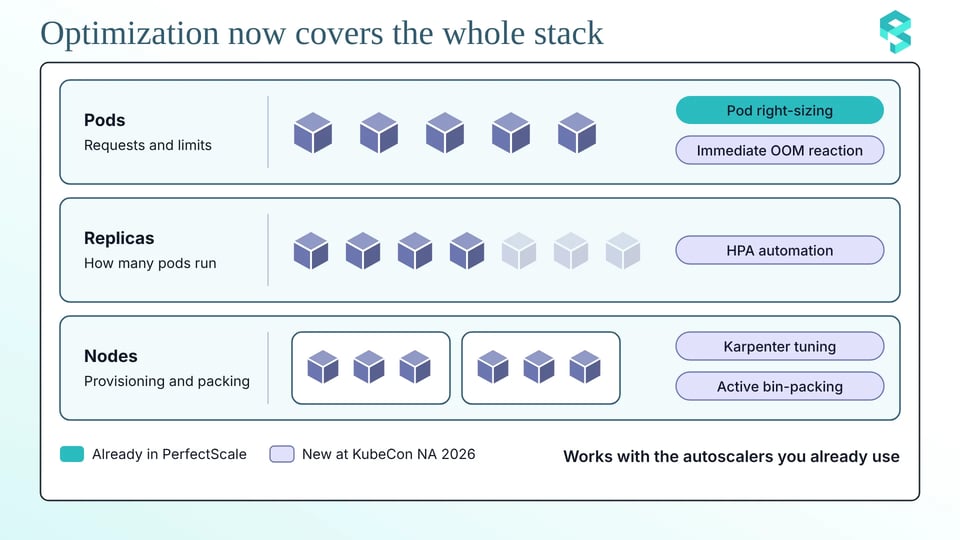
My personal pageNa KubeCon NA 2026, em Salt Lake City, a PerfectScale vai mostrar como ir além do right-sizing de pods e otimizar todo o stack Kubernetes: de workloads e réplicas até os nós. As novas funcionalidades incluem ajuste autônomo do Karpenter, melhoria ativa de bin-packing, automação de HPA e reação mais rápida a eventos OOM. Todas elas funcionam com os autoscalers que você já tem, então dá para melhorar a eficiência sem trocar as ferramentas que você já usa.
Até agora, a PerfectScale se concentrou no right-sizing contínuo e autônomo de pods, ajudando times de DevOps, SRE e Plataforma a reduzir os custos de Kubernetes com segurança, sem comprometer a performance. Mas o right-sizing de pods é só uma parte da história. Os requests e limits dos pods definem quanta memória e capacidade computacional é reservada para os workloads. A eficiência geral da infraestrutura também depende de quantas réplicas o HPA mantém em execução, de como o Karpenter provisiona e consolida os nós e da eficiência com que esses nós são ocupados.
Essas camadas estão fortemente conectadas. O right-sizing de pods pode gerar uma economia significativa, mas ainda há mais oportunidades quando o número de réplicas está alto demais, os nós estão superprovisionados ou a capacidade disponível fica ociosa. A PerfectScale agora otimiza essas camadas em conjunto, ajudando os times a extrair mais da infraestrutura Kubernetes que já têm, conforme a demanda muda.
O próximo passo na otimização de Kubernetes
As configurações do autoscaler costumam ser definidas uma vez durante o setup ou ajustadas durante um incidente — e depois ficam intocadas. Mas os workloads evoluem, os padrões de tráfego mudam e novos tipos de instância mais econômicos ficam disponíveis. Uma configuração que fazia sentido há três meses pode estar desperdiçando dinheiro ou colocando a confiabilidade em risco agora. Por exemplo: a consolidação do Karpenter está conservadora demais, deixando capacidade ociosa em execução e aumentando os custos. Ou está agressiva demais, arriscando instabilidade.
- Um pod que não pode ser removido impede que um nó seja desligado, mesmo quando o resto do nó está vazio.
- As configurações do HPA ficam desatualizadas: o valor mínimo de réplicas foi aumentado durante um incidente e nunca mais reduzido, ou a meta de escalonamento não reflete mais o comportamento real do workload.
Novos tipos de instância mais econômicos ficam sem uso, enquanto o Karpenter continua provisionando uma infraestrutura que custa mais do que o necessário. Um pod fica sem memória, e a resposta padrão é aumentar a memória de todas as réplicas.
Algum desses cenários soa familiar na sua infraestrutura Kubernetes?
A PerfectScale sempre manteve os requests e limits dos pods alinhados às necessidades reais dos workloads. Na KubeCon, vamos mostrar como essa mesma otimização contínua agora se estende a réplicas, nós e confiabilidade de memória. Ao manter esses componentes alinhados conforme workloads e infraestrutura mudam, a PerfectScale ajuda os times a reduzir custos e preservar a confiabilidade dentro das políticas e guardrails que eles mesmos definem.
Ajuste autônomo do Karpenter
O Karpenter é poderoso, mas só funciona tão bem quanto a sua configuração. A maioria dos times configura uma vez e espera que ele se vire conforme o ambiente evolui, enquanto volta a entregar código e apagar incêndios.
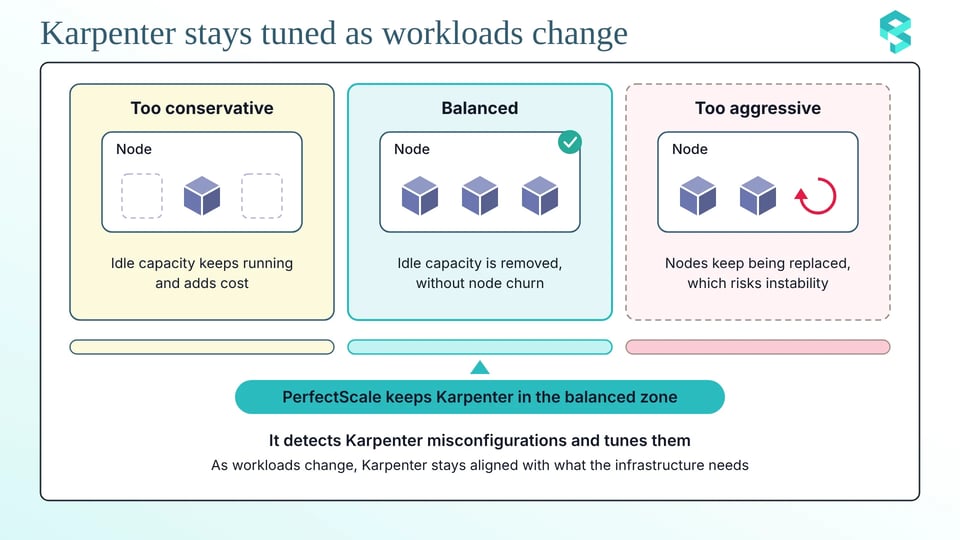
A PerfectScale agora detecta continuamente erros de configuração do Karpenter e os corrige, para que a consolidação elimine capacidade ociosa sem causar churn de nós. Conforme os workloads mudam, o Karpenter permanece alinhado às necessidades da sua infraestrutura, sem ajustes manuais constantes.
Bin-packing ativo
Às vezes, um nó está quase vazio, mas não pode ser consolidado porque um ou mais pods não podem ser removidos. Aquele único pod mantém o nó inteiro rodando, inflando a sua conta de nuvem.
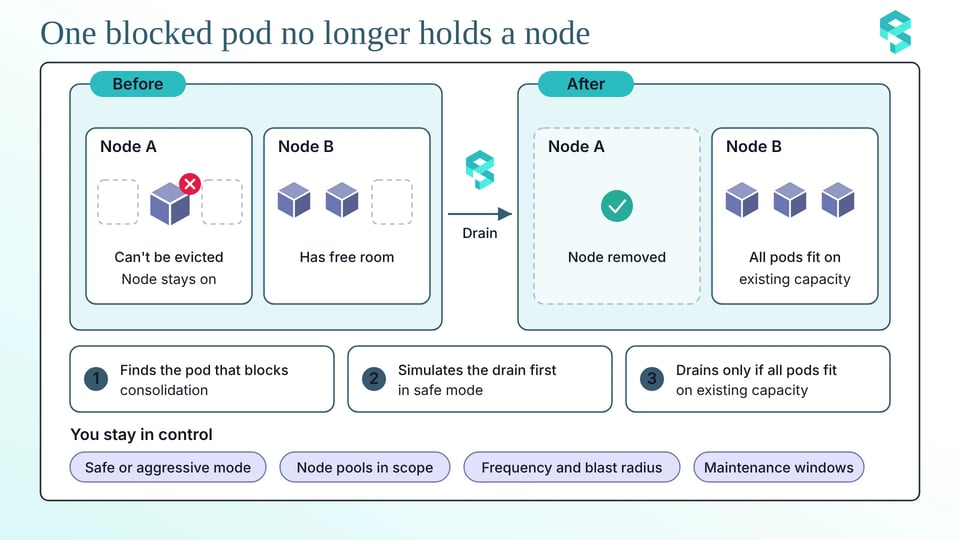
A PerfectScale já mostra quais pods bloqueiam a consolidação, por que estão bloqueando, como resolver e até quanto a capacidade ociosa está custando para você. Agora ela também resolve esses bloqueios automaticamente. Você controla como isso funciona: escolha o modo seguro ou agressivo, selecione os node pools no escopo, defina a frequência de execução e o raio de impacto e estabeleça janelas de manutenção. No modo seguro, a PerfectScale simula o drain primeiro e só prossegue se todos os pods removidos couberem na capacidade existente.
Automação de HPA
O HPA pode manter mais réplicas em execução do que um workload precisa, escalar tarde demais para evitar pressão sobre os recursos ou não refletir a carga real da aplicação. Esses problemas costumam passar despercebidos conforme os workloads mudam.
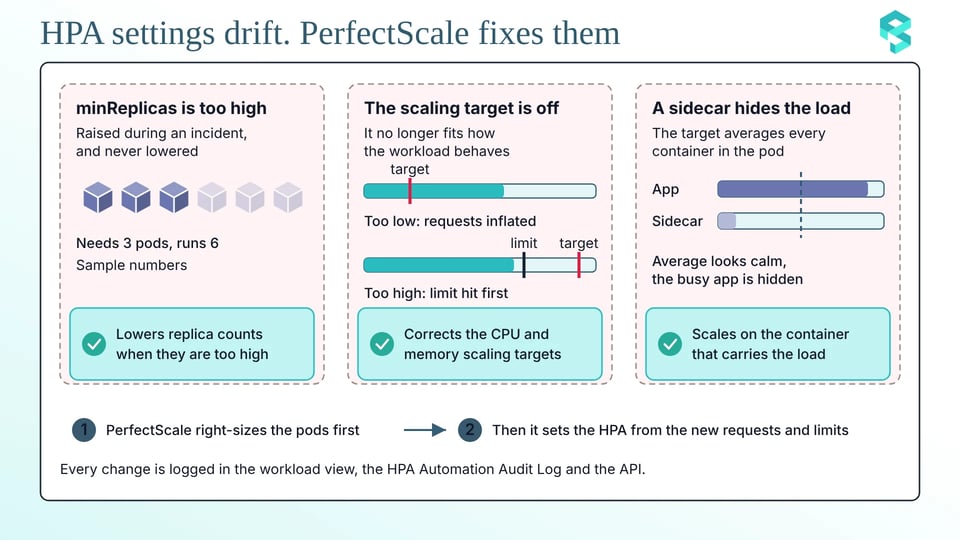
Alguns motivos comuns: o número mínimo de réplicas pode estar alto demais — por exemplo, quando o minReplicas é aumentado durante um incidente e nunca mais reduzido. A meta de escalonamento pode não ser mais adequada ao workload: se for baixa demais, os pods podem precisar de requests de recursos maiores do que realmente usam; se for alta demais, os containers podem atingir os limites de CPU ou ficar sem memória antes de o HPA escalar horizontalmente. Por fim, um sidecar pode mascarar a carga real da aplicação, fazendo um container de aplicação muito sobrecarregado parecer menos ocupado do que realmente está.
A PerfectScale agora detecta e corrige esses problemas automaticamente. Ela reduz o número de réplicas quando está alto demais, corrige as metas de escalonamento de CPU e memória e direciona as decisões de escalonamento para o container que de fato suporta a carga. Como as metas de escalonamento e os requests de recursos dos pods dependem uns dos outros, a PerfectScale os ajusta em conjunto com o autoscaling vertical e de nós, evitando que uma mudança anule os benefícios de outra. Cada mudança é registrada e fica visível na visualização de workloads e pela API.
Reação imediata a OOM
A segurança sempre foi um ponto central para a PerfectScale. Continuamos adicionando salvaguardas que ajudam os times a otimizar a infraestrutura sem colocar a confiabilidade dos workloads em risco.
Quando um workload fica sem memória, a correção comum é aumentar o limite de memória de todas as réplicas "só por garantia". Isso pode evitar outra falha, mas também adiciona recursos pelos quais você continua pagando muito depois do incidente.
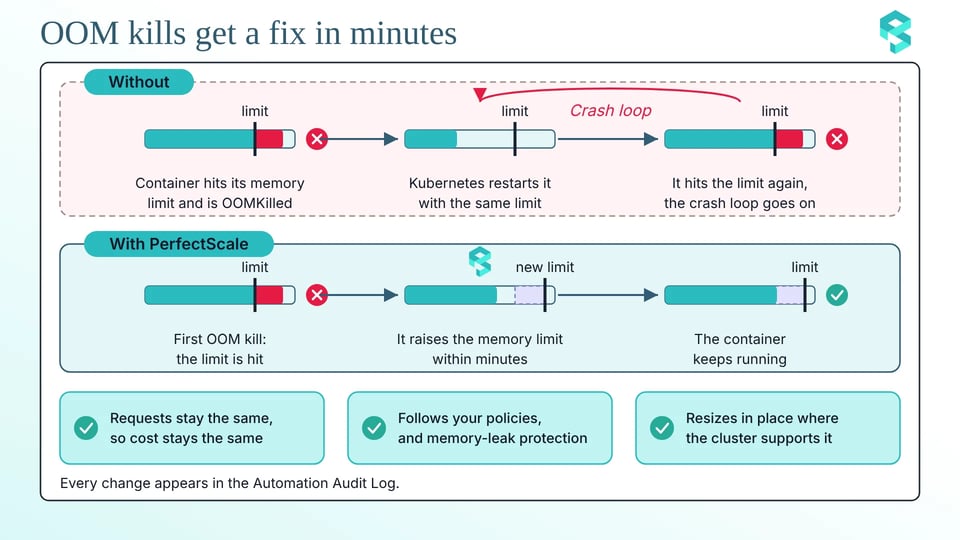
A PerfectScale agora reage imediatamente a eventos OOM, ajustando rapidamente os limites de memória para reduzir o risco de falhas repetidas e manter os workloads rodando com confiabilidade.
Em resumo
Junto com o right-sizing de pods, essas funcionalidades estendem a otimização por todo o stack Kubernetes, dos requests de recursos dos workloads e do número de réplicas até o provisionamento, a consolidação e a utilização de nós. A PerfectScale ajuda a manter essas camadas alinhadas conforme seus workloads e sua infraestrutura evoluem, reduzindo custos sem comprometer a confiabilidade. Ela funciona com as ferramentas que você já usa, sem adicionar mais um componente ao seu stack. Estaremos no estande #131 da KubeCon NA, em Salt Lake City. Passe por lá para ver tudo ao vivo, fazer perguntas difíceis aos nossos engenheiros e compartilhar seus desafios de otimização de Kubernetes. Adoramos um bom desafio de Karpenter ou HPA.
📅 Quer um horário exclusivo com o nosso time? Agende uma reunião no estande!
Ainda não usa a PerfectScale? Comece grátis e veja o que está rodando nos seus clusters antes do evento.