
PerfectScale
Toute votre stack Kubernetes, optimisée en toute autonomie
PerfectScale ajuste désormais Karpenter, lève les blocages de bin-packing, corrige les réglages HPA et réagit plus vite aux événements OOM, pour un Kubernetes qui reste efficace à mesure qu'il évolue.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.

About Marie Jaksman
Senior Marketing Manager
Part growth marketer, part DevOps translator. Optimizing funnels and clusters with a healthy fear of wasted compute.
My personal pageÀ l'occasion de la KubeCon NA 2026 à Salt Lake City, PerfectScale montre comment aller au-delà du rightsizing des pods et optimiser l'ensemble de la stack Kubernetes : des workloads et réplicas jusqu'aux nœuds. Parmi les nouveautés : l'ajustement autonome de Karpenter, l'amélioration active du bin-packing, l'automatisation du HPA et des réactions plus rapides aux événements OOM. Toutes ces fonctionnalités s'intègrent à vos autoscalers existants : vous gagnez en efficacité sans remplacer les outils que vous utilisez déjà.
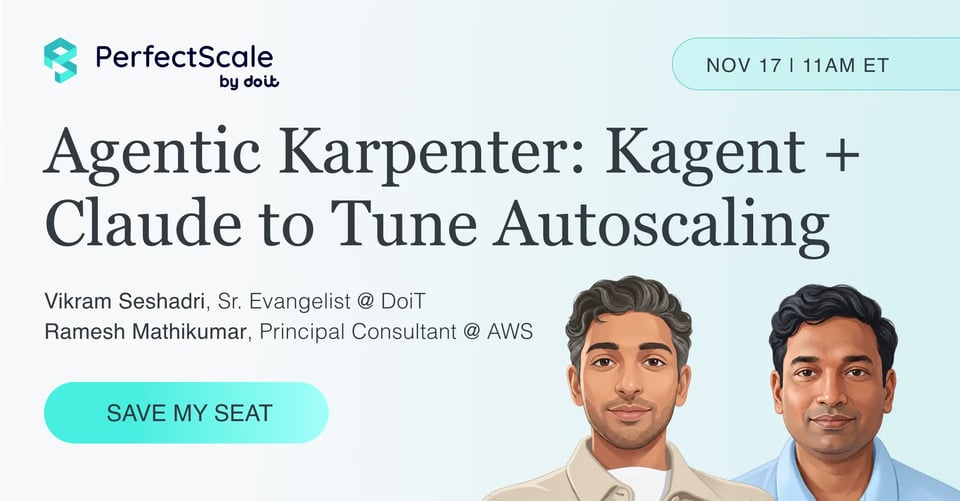
Jusqu'ici, PerfectScale s'est concentré sur le rightsizing continu et autonome des pods, aidant les équipes DevOps, SRE et Platform à réduire leurs coûts Kubernetes en toute sécurité, sans compromettre les performances. Mais le rightsizing des pods n'est qu'une partie de l'équation. Les requests et limits des pods définissent la quantité de mémoire et de calcul réservée aux workloads. L'efficacité globale de l'infrastructure dépend aussi du nombre de réplicas gérés par le HPA, de la façon dont Karpenter provisionne et consolide les nœuds, et de l'efficacité avec laquelle ces nœuds sont remplis.
Ces couches sont étroitement liées. Le rightsizing des pods peut générer des économies significatives, mais d'autres opportunités subsistent lorsque le nombre de réplicas est trop élevé, que les nœuds sont surprovisionnés ou que de la capacité disponible reste inutilisée. PerfectScale optimise désormais ces couches ensemble, pour aider les équipes à tirer davantage parti de leur infrastructure Kubernetes existante à mesure que la demande évolue.
La prochaine étape de l'optimisation Kubernetes
Les réglages des autoscalers sont souvent définis une fois lors de la mise en place, ou ajustés pendant un incident, puis laissés tels quels. Mais les workloads évoluent, les profils de trafic changent et de nouveaux types d'instances plus économiques apparaissent. Une configuration pertinente il y a trois mois peut aujourd'hui gaspiller de l'argent ou mettre la fiabilité en péril. Par exemple : la consolidation de Karpenter est trop prudente et laisse tourner de la capacité inutilisée, ce qui fait grimper les coûts. Ou elle est trop agressive, au risque de créer de l'instabilité.
- Un pod non évincable empêche la suppression d'un nœud, même lorsque le reste du nœud est vide.
- Les réglages du HPA deviennent obsolètes : une valeur minimale de réplicas a été augmentée pendant un incident et jamais réduite, ou la cible de scaling ne correspond plus au comportement réel du workload.
De nouveaux types d'instances plus économiques restent inexploités, tandis que Karpenter continue de provisionner une infrastructure plus coûteuse que nécessaire. Un pod manque de mémoire, et la réponse par défaut consiste à augmenter la mémoire de chaque réplica.
Ces situations vous rappellent quelque chose dans votre infrastructure Kubernetes ?
PerfectScale a toujours maintenu les requests et limits des pods alignés sur les besoins réels des workloads. À la KubeCon, nous montrons comment cette même optimisation continue s'étend désormais aux réplicas, aux nœuds et à la fiabilité mémoire. En alignant ces composants au fil des évolutions des workloads et de l'infrastructure, PerfectScale aide les équipes à réduire leurs coûts et à préserver la fiabilité, dans le respect des politiques et garde-fous qu'elles définissent.
Ajustement autonome de Karpenter
Karpenter est puissant, mais sa valeur dépend de sa configuration. La plupart des équipes le configurent une fois et attendent qu'il s'adapte tout seul à l'évolution de l'environnement, pendant qu'elles se remettent à livrer et à éteindre des incendies.
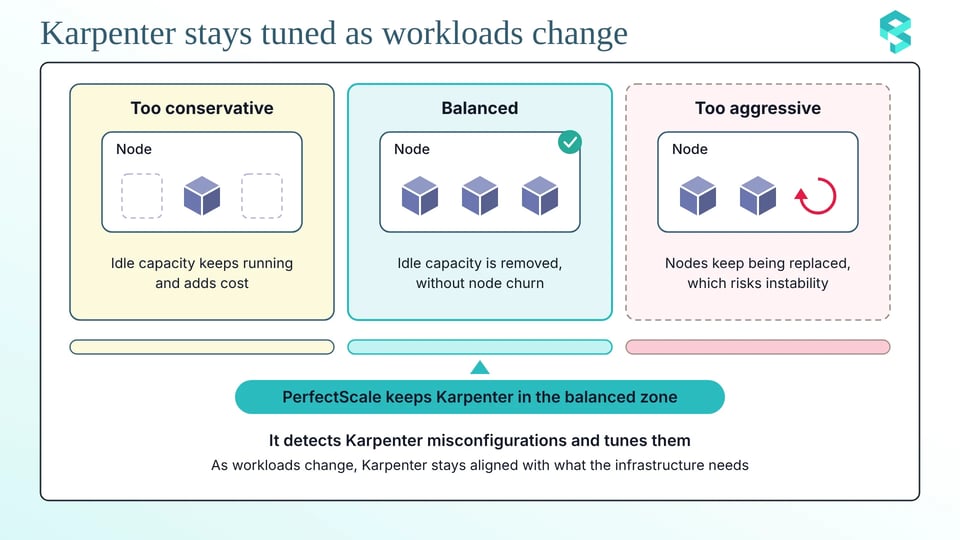
PerfectScale détecte désormais en continu les erreurs de configuration de Karpenter et les corrige, afin que la consolidation élimine la capacité inutilisée sans provoquer de churn de nœuds. À mesure que les workloads évoluent, Karpenter reste aligné sur les besoins de votre infrastructure, sans ajustements manuels permanents.
Bin-packing actif
Il arrive qu'un nœud soit presque vide mais ne puisse pas être consolidé parce qu'un ou plusieurs pods ne peuvent pas être évincés. Ce seul pod maintient tout le nœud en fonctionnement — et alimente votre facture cloud.
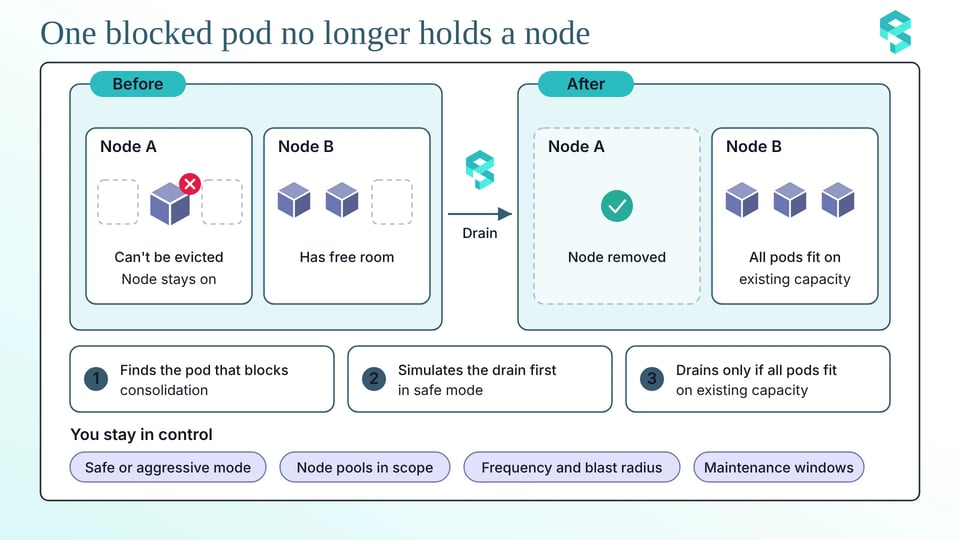
PerfectScale indique déjà quels pods bloquent la consolidation, pourquoi ils la bloquent, comment y remédier, et même combien vous coûte cette capacité inutilisée. Il peut désormais lever ces blocages automatiquement. Vous gardez le contrôle : choisissez le mode safe ou agressif, sélectionnez les node pools concernés, définissez la fréquence d'exécution, le périmètre d'impact et les fenêtres de maintenance. En mode safe, PerfectScale simule d'abord le drain et ne procède que si tous les pods évincés peuvent tenir sur la capacité existante.
Automatisation du HPA
Le HPA peut maintenir plus de réplicas que le workload n'en a besoin, scaler trop tard pour éviter une pression sur les ressources, ou ne pas refléter la charge réelle de l'application. Ces problèmes passent souvent inaperçus à mesure que les workloads évoluent.
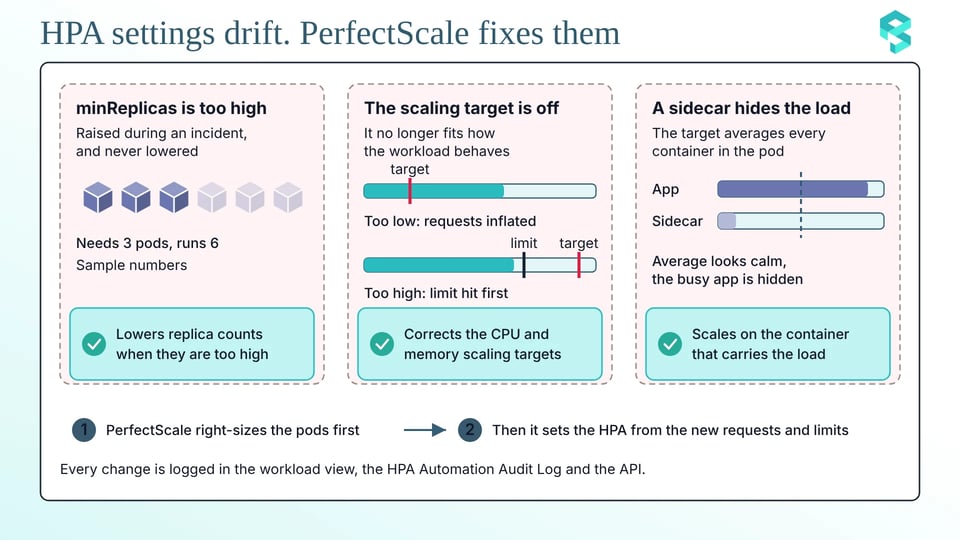
Quelques causes fréquentes : le nombre minimal de réplicas peut être trop élevé, par exemple lorsque minReplicas a été augmenté pendant un incident et jamais redescendu. La cible de scaling peut ne plus convenir au workload : réglée trop bas, les pods peuvent nécessiter des requests de ressources supérieures à leur usage réel ; réglée trop haut, les conteneurs risquent d'atteindre leurs limites CPU ou de manquer de mémoire avant que le HPA ne déclenche le scaling. Enfin, un sidecar peut masquer la charge réelle de l'application, donnant l'impression qu'un conteneur applicatif fortement sollicité est moins chargé qu'il ne l'est réellement.
PerfectScale détecte et corrige désormais ces problèmes automatiquement. Il réduit le nombre de réplicas s'il est trop élevé, corrige les cibles de scaling CPU et mémoire, et oriente les décisions de scaling vers le conteneur qui porte réellement la charge. Comme les cibles de scaling et les requests des pods dépendent les unes des autres, PerfectScale les ajuste conjointement avec l'autoscaling vertical et celui des nœuds, pour éviter qu'un changement n'annule les bénéfices d'un autre. Chaque modification est journalisée et visible dans la vue workload ainsi que via l'API.
Réaction immédiate aux OOM
La sécurité a toujours été au cœur de PerfectScale. Nous continuons d'ajouter des garde-fous qui permettent aux équipes d'optimiser leur infrastructure sans mettre en péril la fiabilité des workloads.
Lorsqu'un workload manque de mémoire, le réflexe habituel consiste à augmenter la limite mémoire de chaque réplica, par précaution. Cela peut éviter un nouveau crash, mais cela ajoute aussi des ressources que vous continuez de payer longtemps après l'incident.
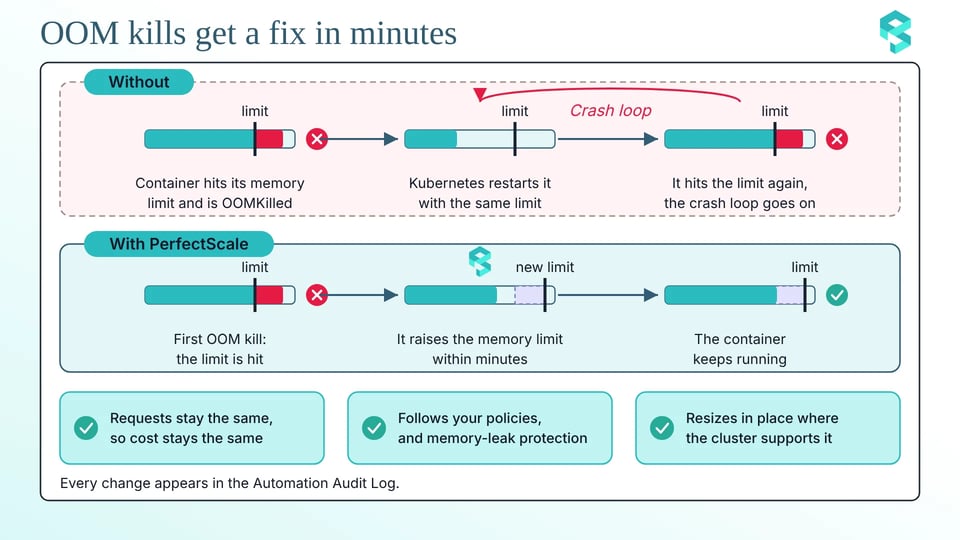
PerfectScale réagit désormais immédiatement aux événements OOM, en ajustant rapidement les limites mémoire pour réduire le risque de crashs répétés et préserver la fiabilité des workloads.
En résumé
Combinées au rightsizing des pods, ces fonctionnalités étendent l'optimisation à l'ensemble de la stack Kubernetes : des requests de ressources et du nombre de réplicas jusqu'au provisionnement, à la consolidation et à l'utilisation des nœuds. PerfectScale maintient ces couches alignées à mesure que vos workloads et votre infrastructure évoluent, et réduit les coûts sans compromettre la fiabilité. Il fonctionne avec les outils que vous utilisez déjà, sans ajouter un composant de plus à votre stack. Retrouvez-nous au stand #131 de la KubeCon NA, à Salt Lake City. Passez nous voir pour une démo en direct, posez vos questions les plus pointues à nos ingénieurs et partagez vos défis d'optimisation Kubernetes. Nous adorons les casse-têtes Karpenter ou HPA.
📅 Envie d'un échange dédié avec notre équipe ? Réservez un rendez-vous sur le stand !
Vous n'utilisez pas encore PerfectScale ? Commencez gratuitement et découvrez ce qui tourne dans vos clusters avant l'événement.