
PerfectScale
L'intero stack Kubernetes, ottimizzato in autonomia
PerfectScale ora ottimizza Karpenter, elimina i blocchi al bin-packing, corregge le impostazioni dell'HPA e reagisce più rapidamente agli eventi OOM, mantenendo Kubernetes efficiente mentre evolve.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.

About Marie Jaksman
Senior Marketing Manager
Part growth marketer, part DevOps translator. Optimizing funnels and clusters with a healthy fear of wasted compute.
My personal pageAlla KubeCon NA 2026 di Salt Lake City, PerfectScale mostra come andare oltre il rightsizing dei pod e ottimizzare l'intero stack Kubernetes: dai workloads e dalle repliche fino ai nodi. Le nuove funzionalità includono il tuning autonomo di Karpenter, il miglioramento attivo del bin-packing, l'automazione dell'HPA e reazioni più rapide agli eventi OOM. Tutte le funzionalità operano con gli autoscaler già in uso, così è possibile migliorare l'efficienza senza sostituire gli strumenti esistenti.
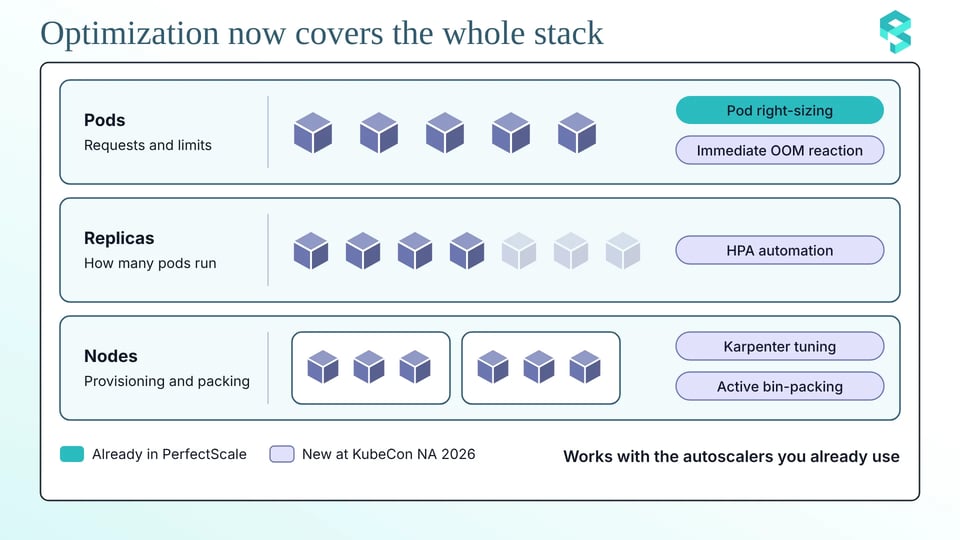
Finora PerfectScale si è concentrata sul rightsizing continuo e autonomo dei pod, aiutando i team DevOps, SRE e Platform a ridurre in sicurezza i costi di Kubernetes senza compromettere le prestazioni. Ma il rightsizing dei pod è solo una parte del quadro. Le request e i limit dei pod definiscono quanta memoria e capacità di calcolo viene riservata ai workloads. L'efficienza complessiva dell'infrastruttura dipende anche da quante repliche esegue l'HPA, da come Karpenter effettua il provisioning e il consolidamento dei nodi e dall'efficienza con cui questi nodi vengono riempiti.
Questi livelli sono strettamente collegati. Il rightsizing dei pod può generare risparmi significativi, ma restano ulteriori opportunità quando il numero di repliche è troppo alto, i nodi sono sovradimensionati o la capacità disponibile rimane inutilizzata. PerfectScale ora ottimizza questi livelli in modo congiunto, aiutando i team a ottenere di più dall'infrastruttura Kubernetes esistente al variare della domanda.
Il prossimo passo nell'ottimizzazione di Kubernetes
Le impostazioni degli autoscaler vengono spesso configurate una sola volta in fase di setup o modificate durante un incidente, per poi restare invariate. Ma i workloads evolvono, i pattern di traffico cambiano e diventano disponibili nuovi tipi di istanza più convenienti. Una configurazione che aveva senso tre mesi fa oggi può sprecare denaro o mettere a rischio l'affidabilità. Per esempio: il consolidamento di Karpenter è troppo conservativo, lascia in esecuzione capacità inattiva e fa aumentare i costi. Oppure è troppo aggressivo e rischia di causare instabilità.
- Un pod che non può essere sottoposto a eviction impedisce la rimozione di un nodo, anche quando il resto del nodo è vuoto.
- Le impostazioni dell'HPA diventano obsolete: un valore minimo di repliche è stato alzato durante un incidente e mai più abbassato, oppure il target di scaling non corrisponde più al comportamento reale del workload.
Nuovi tipi di istanza più convenienti restano inutilizzati, mentre Karpenter continua a effettuare il provisioning di infrastruttura più costosa del necessario. Un pod esaurisce la memoria e la risposta standard è aumentare la memoria di ogni replica.
Qualcuna di queste situazioni Le risulta familiare nella Sua infrastruttura Kubernetes?
PerfectScale ha sempre mantenuto le request e i limit dei pod allineati alle esigenze reali dei workloads. Alla KubeCon mostriamo come questa stessa ottimizzazione continua si estenda ora a repliche, nodi e affidabilità della memoria. Allineando questi componenti man mano che workloads e infrastruttura cambiano, PerfectScale aiuta i team a ridurre i costi e a mantenere l'affidabilità, entro le policy e i guardrail che i team stessi definiscono.
Tuning autonomo di Karpenter
Karpenter è potente, ma vale quanto la sua configurazione. La maggior parte dei team lo configura una volta e si aspetta che se la cavi da solo mentre l'ambiente evolve, per tornare a rilasciare codice e gestire emergenze.
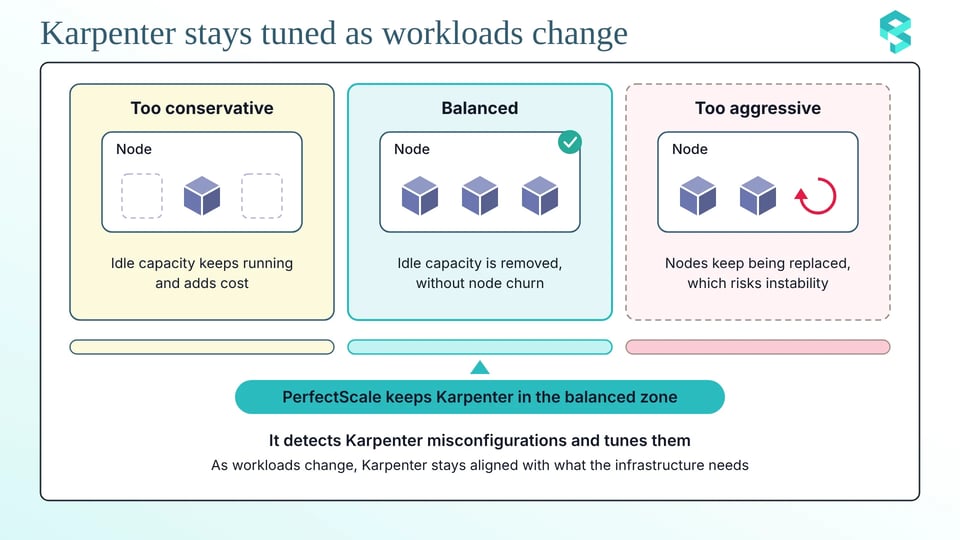
PerfectScale ora rileva in modo continuo le configurazioni errate di Karpenter e le ottimizza, così il consolidamento elimina la capacità inattiva senza causare churn dei nodi. Al variare dei workloads, Karpenter resta allineato alle esigenze della Sua infrastruttura, senza continui interventi manuali.
Bin-packing attivo
A volte un nodo è quasi vuoto ma non può essere consolidato perché uno o più pod non possono essere rimossi. Quel singolo pod tiene in esecuzione l'intero nodo, gonfiando la bolletta cloud.
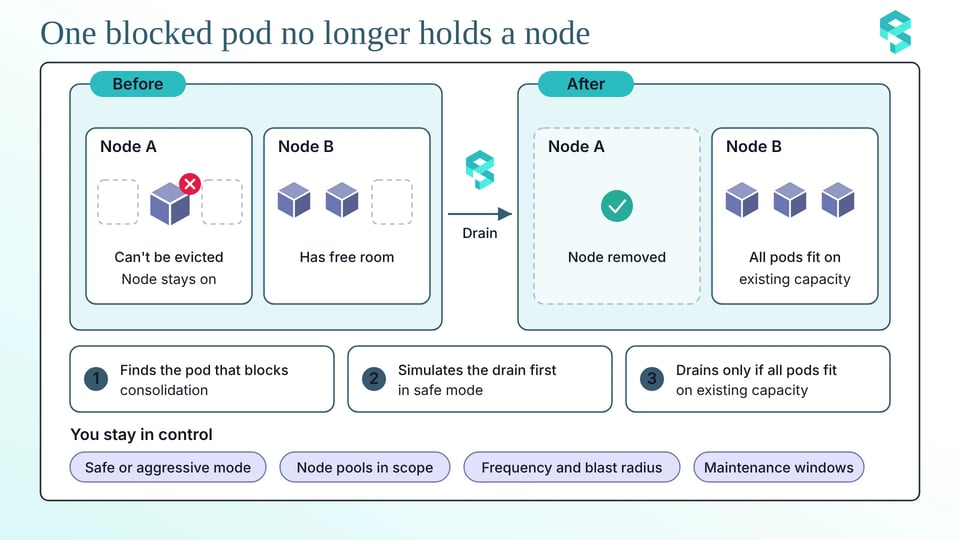
PerfectScale mostra già quali pod bloccano il consolidamento, perché lo bloccano, come risolvere il problema e persino quanto costa la capacità inattiva. Ora può rimuovere questi blocchi automaticamente. È Lei a decidere come: può scegliere la modalità safe o aggressive, selezionare i node pool interessati, impostare la frequenza di esecuzione e il blast radius e definire le finestre di manutenzione. In modalità safe, PerfectScale simula prima il drain e procede solo se tutti i pod rimossi trovano posto sulla capacità esistente.
Automazione dell'HPA
L'HPA può mantenere in esecuzione più repliche di quante ne servano a un workload, scalare troppo tardi per prevenire la pressione sulle risorse o non riflettere il carico reale dell'applicazione. Questi problemi passano spesso inosservati al variare dei workloads.
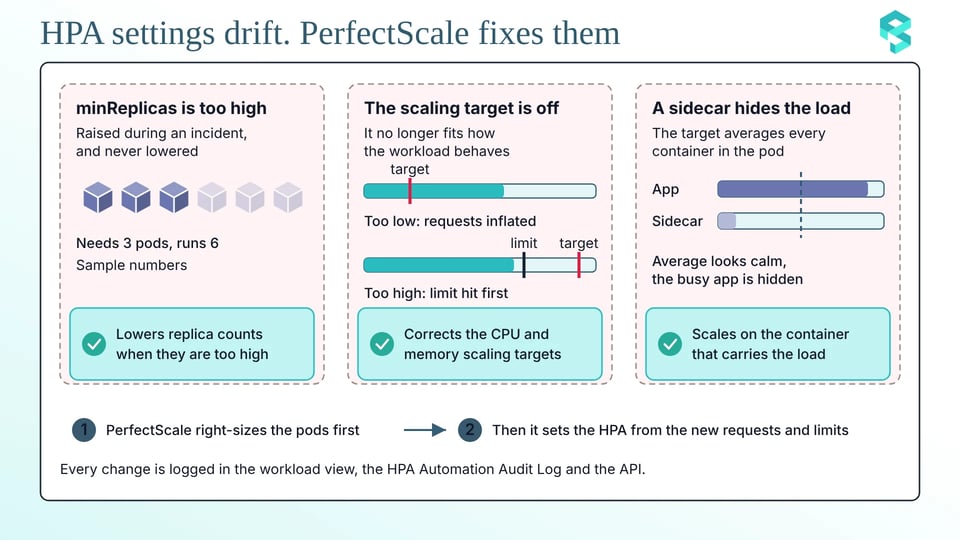
Alcune cause frequenti: il numero minimo di repliche può essere troppo alto, per esempio quando minReplicas viene aumentato durante un incidente e mai più ridotto. Il target di scaling può non essere più adatto al workload: se è troppo basso, i pod possono richiedere resource request superiori a quanto effettivamente utilizzano; se è troppo alto, i container possono raggiungere i limiti di CPU o esaurire la memoria prima che l'HPA scali orizzontalmente. Infine, un sidecar può mascherare il carico reale dell'applicazione, facendo apparire un container applicativo molto sollecitato meno occupato di quanto sia in realtà.
PerfectScale ora rileva e corregge automaticamente questi problemi. Riduce il numero di repliche se è troppo alto, corregge i target di scaling di CPU e memoria e indirizza le decisioni di scaling verso il container che sostiene effettivamente il carico. Poiché i target di scaling e le resource request dei pod sono interdipendenti, PerfectScale li ottimizza insieme all'autoscaling verticale e dei nodi, evitando che una modifica annulli i benefici di un'altra. Ogni modifica viene registrata ed è visibile nella vista workload e tramite API.
Reazione immediata agli eventi OOM
La sicurezza è sempre stata un punto centrale per PerfectScale. Continuiamo ad aggiungere protezioni che aiutano i team a ottimizzare l'infrastruttura senza mettere a rischio l'affidabilità dei workloads.
Quando un workload esaurisce la memoria, la soluzione più comune è aumentare il limite di memoria di ogni replica "per stare tranquilli". Può evitare un nuovo crash, ma aggiunge anche risorse che si continuano a pagare molto tempo dopo l'incidente.
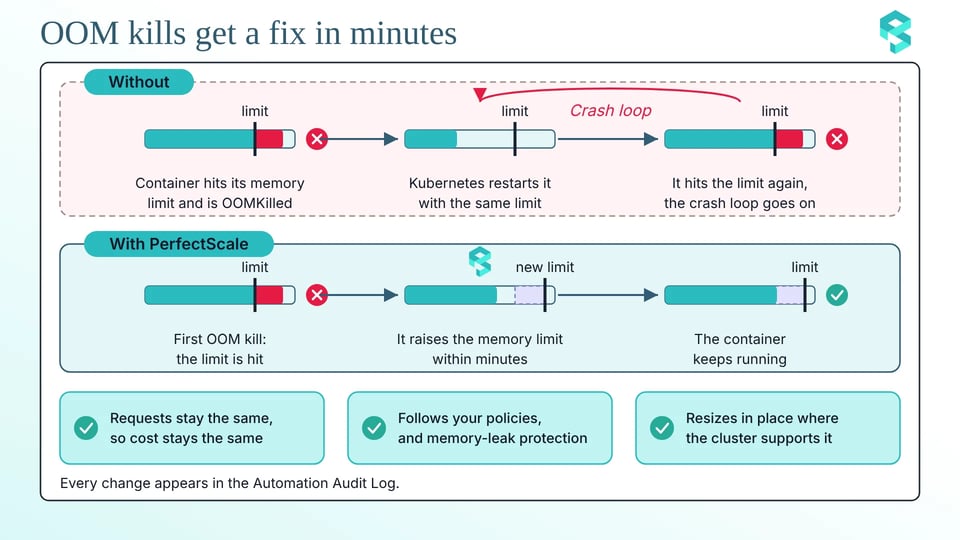
PerfectScale ora reagisce immediatamente agli eventi OOM, adattando rapidamente i limiti di memoria per ridurre il rischio di crash ripetuti e mantenere i workloads in esecuzione in modo affidabile.
In sintesi
Insieme al rightsizing dei pod, queste funzionalità estendono l'ottimizzazione all'intero stack Kubernetes: dalle resource request dei workloads e dal numero di repliche fino al provisioning, al consolidamento e all'utilizzo dei nodi. PerfectScale aiuta a mantenere questi livelli allineati mentre i workloads e l'infrastruttura evolvono, riducendo i costi senza compromettere l'affidabilità. Funziona con gli strumenti già in uso, senza aggiungere un ulteriore componente allo stack. Saremo allo stand #131 della KubeCon NA, a Salt Lake City. Passi a trovarci per vedere tutto dal vivo, mettere alla prova i nostri engineer con le domande più difficili e condividere le Sue sfide di ottimizzazione su Kubernetes. Adoriamo un bel rompicapo su Karpenter o sull'HPA.
📅 Desidera un momento dedicato con il nostro team? Prenoti un incontro allo stand!
Non usa ancora PerfectScale? Inizi gratuitamente e scopra cosa è in esecuzione nei Suoi cluster prima dell'evento.