
PerfectScale
O bloqueio está no seu NodePool ou nos seus workloads?
Saiba identificar se um node travado do Karpenter é causado por um limite de NodePool ou por um bloqueio de workload — e descubra quem é responsável pela correção com uma árvore de decisão de 4 perguntas.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.

Um node que continua rodando depois que a demanda cai tem um bloqueio. Esse bloqueio está no seu NodePool ou nos seus workloads, e a resposta define quem corrige.
Um limite de NodePool é uma configuração que diz ao Karpenter para não consolidar. Exemplos são a política, o tempo de espera e um orçamento de interrupção. O time de plataforma é dono do NodePool. Um bloqueio de workload é um pod que não pode sair do seu node. Exemplos são um PodDisruptionBudget (PDB), uma anotação do-not-disrupt e uma regra de posicionamento. O time de aplicação é dono desses objetos.
Se você escolher o dono errado, a mudança vai para o time errado e o node continua lá. Este artigo traz uma árvore de decisão com quatro perguntas. Responda na ordem. O primeiro sim identifica a classe do bloqueio, o dono e o próximo passo.
Dois tipos de bloqueios
O Karpenter remove um node apenas quando duas condições são verdadeiras: o NodePool permite a mudança e todos os pods no node podem sair. Cada condição tem seu próprio dono:
- Limite de NodePool: uma configuração no NodePool impede o Karpenter de agir. A correção é uma mudança no NodePool, e o time de plataforma é o responsável.
- Bloqueio de workload: um pod não pode sair do node, ou não tem outro lugar para rodar. A correção é uma mudança no workload, e o time de aplicação é o responsável.
O Karpenter age apenas sobre nodes que ele mesmo criou. Um node criado por outra ferramenta é um terceiro caso, e nenhuma configuração do Karpenter resolve isso. Um node também pode ter mais de um bloqueio, então corrija um e verifique o node de novo.
A árvore de decisão
Comece com um node que permanece depois que a demanda cai. Responda às quatro perguntas na ordem. Pare no primeiro sim, porque essa resposta identifica a classe do bloqueio e o dono da correção.
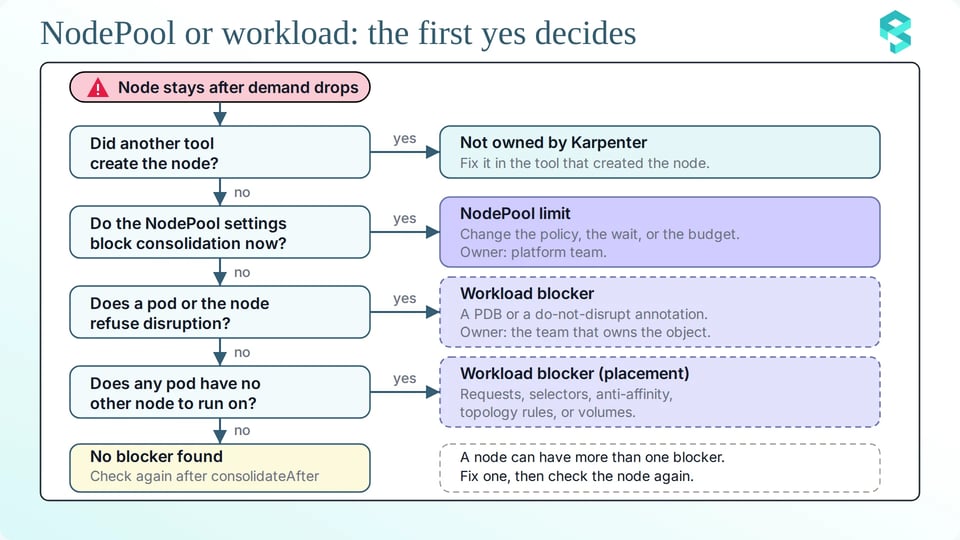
Cada pergunta tem uma verificação rápida que comprova a resposta. Execute a verificação antes de pedir a alguém que mude qualquer coisa.
Pergunta 1: Outra ferramenta criou o node?
O Karpenter age apenas sobre nodes que ele criou, então verifique o dono primeiro. Um node sem NodeClaim nunca é candidato à consolidação. O label karpenter.sh/nodepool mostra qual NodePool criou o node. Substitua $NODE pelo nome do node:
kubectl get node $NODE -L karpenter.sh/nodepoolUma coluna NODEPOOL vazia significa que o Karpenter não criou o node, então ele nunca o consolida. Corrija na ferramenta que criou o node, por exemplo, um managed node group.
Pergunta 2: As configurações do NodePool bloqueiam a consolidação agora?
Quatro configurações do NodePool podem impedir a consolidação. Leia primeiro o bloco disruption. Ele mostra a política, o tempo de espera e os orçamentos em uma única saída. Substitua $NODEPOOL pelo nome do NodePool:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Verifique estas quatro configurações:
- consolidationPolicy: o valor WhenEmpty considera apenas nodes vazios, então um node com pods permanece. Os valores Balanced e WhenEmptyOrUnderutilized também consideram nodes que contêm pods. Balanced ignora movimentações em que a interrupção não compensa a economia.
- consolidateAfter: é o tempo de espera. O Karpenter reinicia o cronômetro quando um pod é adicionado ao node ou removido dele, então um valor longo faz com que um node movimentado nunca seja considerado. O valor Never desativa a consolidação para o NodePool.
- budgets: um orçamento com nodes: '0' bloqueia toda interrupção voluntária. Um orçamento com um schedule e uma duração bloqueia dentro dessa janela. Os schedules sempre usam UTC.
- requirements e limits: um node substituto precisa caber nos requirements e nos limits do NodePool. Quando nenhum node mais barato cabe, o Karpenter não consegue substituir o node.
Este comando imprime os limits e os requirements:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.limits}{"\n"}{.spec.template.spec.requirements}{"\n"}'Use os eventos para ver qual configuração se aplica. Estes comandos leem os eventos do NodePool e do cluster inteiro:
kubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampCada configuração deixa sua própria marca:
| Configuração | O que você vê | Mudança mínima |
|---|---|---|
consolidationPolicy é WhenEmpty |
NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty | Defina a política como WhenEmptyOrUnderutilized |
consolidateAfter é Never |
NodePool "<name>" has consolidation disabled | Defina uma duração, por exemplo 15m |
consolidateAfter é longo |
Nenhum evento. A condição Consolidatable do NodeClaim é False |
Reduza a duração |
budgets |
No allowed disruptions for disruption reason Underutilized due to blocking budget, on the NodePool | Substitua nodes: '0' por um percentual, ou limite o orçamento zero a uma janela |
| Requirements e limits | Can't replace with a cheaper node | Permita mais opções de instância, ou aumente o limite |
Um tempo de espera longo não deixa evento. Para ler a condição Consolidatable, substitua $NODECLAIM pelo nome do NodeClaim:
kubectl get nodeclaim $NODECLAIM -o jsonpath='{.status.conditions[?(@.type=="Consolidatable")].status}{"\n"}'O valor False significa que o node ainda não é candidato à consolidação.
Cada correção é uma mudança em um único campo. O primeiro diff permite que o Karpenter considere nodes que contêm pods:
spec: disruption:- consolidationPolicy: WhenEmpty+ consolidationPolicy: WhenEmptyOrUnderutilizedO próximo diff encurta o tempo de espera:
spec: disruption: consolidateAfter: 15m # antes era 2hO último diff remove um orçamento zero. Pergunte ao time de plataforma primeiro, porque um orçamento zero costuma proteger um release:
spec: disruption: budgets:- - nodes: "0"+ - nodes: "10%"O time de plataforma faz essas mudanças, porque é ele quem é dono do NodePool.
Pergunta 3: Um pod ou o node recusa a interrupção?
Antes de interromper um node, o Karpenter verifica todos os pods que estão nele. Um pod recusa de duas formas: um PDB não tem folga, ou o pod carrega a anotação karpenter.sh/do-not-disrupt. O node também pode carregar a anotação. Os eventos apontam a causa:
| Mensagem | Significado | Dono |
|---|---|---|
| Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) | Um PDB não tem folga para um pod no node. | Time de aplicação |
| MultiplePodDisruptionBudgets | Dois PDBs selecionam o mesmo pod. Versões recentes do Kubernetes gravam esse evento no pod, e o Karpenter pode não mostrar evento algum. | Time de aplicação |
| Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) | Um pod no node carrega a anotação. | Time de aplicação |
| Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation | O próprio node carrega a anotação. | Time de plataforma |
Para confirmar um PDB, liste todos os PDBs com suas interrupções permitidas:
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Um valor ALLOWED igual a 0 significa que nenhum pod protegido por esse PDB pode sair agora. Um pod deve ter apenas um PDB. Se dois PDBs selecionam o mesmo pod, o Kubernetes recusa o despejo mesmo quando ambos os PDBs têm folga.
Para confirmar uma anotação, liste os pods e os nodes que a carregam. Estes comandos usam jq:
# Encontre pods com a anotação karpenter.sh/do-not-disruptkubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
# Encontre nodes com a anotação karpenter.sh/do-not-disruptkubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
A anotação funciona como um PDB para um único pod. O valor "true" protege o pod permanentemente. Uma duração como "30m" o protege por esse tempo depois que ele começa a rodar.
Cada correção é uma mudança pequena. Para um Deployment com 3 réplicas, use maxUnavailable: 1 em vez de minAvailable: 3, porque maxUnavailable acompanha o número de réplicas:
spec: minAvailable: 3 maxUnavailable: 1Se o time de aplicação concordar que um pod pode se mover depois de 30 minutos, troque a anotação permanente por uma duração:
template: metadata: annotations: karpenter.sh/do-not-disrupt: "30m"Às vezes, um pod em crash loop bloqueia o despejo. Mantenha o PDB e defina unhealthyPodEvictionPolicy: AlwaysAllow nele. Esse campo é estável desde o Kubernetes v1.31.
Quando o Karpenter drena um node, ele não despeja pods estáticos, pods que toleram o taint karpenter.sh/disrupted:NoSchedule nem pods que já foram concluídos ou falharam.
O time de aplicação faz a maioria dessas mudanças, porque é dono do PDB e do pod. O time de plataforma é dono de uma anotação em um node.
Pergunta 4: Algum pod não tem outro node onde rodar?
O Karpenter simula onde os pods podem rodar antes de remover um node. Se todos os pods couberem na capacidade livre de outros nodes, ele exclui o node. Se couberem na capacidade livre mais um node de preço menor, ele substitui o node. Se um pod não couber em lugar nenhum, o node permanece. Os eventos nem sempre apontam esse pod, então você o encontra nas specs dos pods.
Para ver o que prende cada pod do node ao seu lugar, liste os detalhes de todos os pods nele:
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Procure estas causas:
- Um request maior que a capacidade livre dos outros nodes.
- Um nodeSelector que corresponde apenas a esse grupo de nodes.
- Uma regra obrigatória de anti-affinity.
- Uma regra de topology spread que os outros nodes não conseguem atender.
- Um volume vinculado a uma única zona.
- Um taint nos outros nodes que o pod não tolera.
Regras preferenciais de anti-affinity e de topology spread também podem reduzir a eficácia da consolidação, porque o Karpenter tenta atendê-las quando remove um node.
Comece pela primeira causa. O Karpenter posiciona os pods pelos requests, não pelo uso real. Esta query compara o uso real de CPU com os requests de CPU de cada namespace. Ela usa as métricas do kubelet e do kube-state-metrics:
query: sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m])) / sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Uma razão bem abaixo de 1 significa que os requests estão grandes demais. Cada node então comporta menos pods do que poderia, e você paga pelo espaço ocioso.
Se as evidências mostrarem um request superdimensionado, reduza-o à necessidade real. Mude apenas o valor que a evidência apontar:
resources: requests: cpu: "4" cpu: "2"Verifique também se há pods sem controller. Eles não bloqueiam o Karpenter, mas nada os reinicia depois de um despejo.
Se nenhuma resposta for sim
O Karpenter também pula um node por motivos normais e passageiros. O cronômetro do consolidateAfter ainda não terminou, o node ainda está iniciando, o node já está sendo excluído, ou o Karpenter acabou de escolher o node para um pod pendente. Verifique o node de novo depois de alguns minutos.
Quem corrige
Cada classe tem um dono e uma mudança mínima, para que o time certo receba o pedido certo.
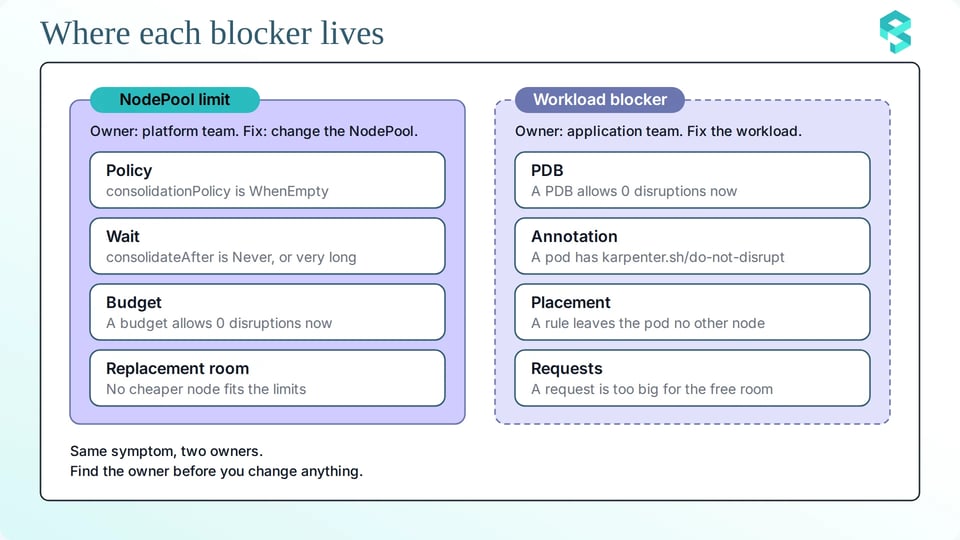
Esta tabela reúne a evidência, o dono e a mudança:
| Classe | Evidência | Dono | Mudança mínima |
|---|---|---|---|
| Não criado pelo Karpenter | Uma coluna NODEPOOL vazia | O dono da outra ferramenta | Uma mudança no node naquela ferramenta |
| Limite de NodePool | Uma configuração no bloco disruption e um evento no NodePool ou no node | Time de plataforma | Um campo do NodePool |
| Bloqueio de workload: PDB ou anotação | Um evento DisruptionBlocked, o valor ALLOWED ou o filtro de anotação | Time de aplicação, ou time de plataforma no caso de anotação em node | Um campo do PDB ou um valor de anotação |
| Bloqueio de workload: posicionamento | Um evento Unconsolidatable ou nenhum evento, e o filtro de posicionamento de pods | Time de aplicação | Um request ou uma regra |
Envie ao dono um diff e cite a evidência no pedido. Assim, o dono revisa um campo em vez de um relatório longo.
Como o PerfectScale pode ajudar
O PerfectScale by DoiT não substitui a árvore de decisão. Ele ajuda seu time a encontrar o dono e a correção com menos trabalho manual.
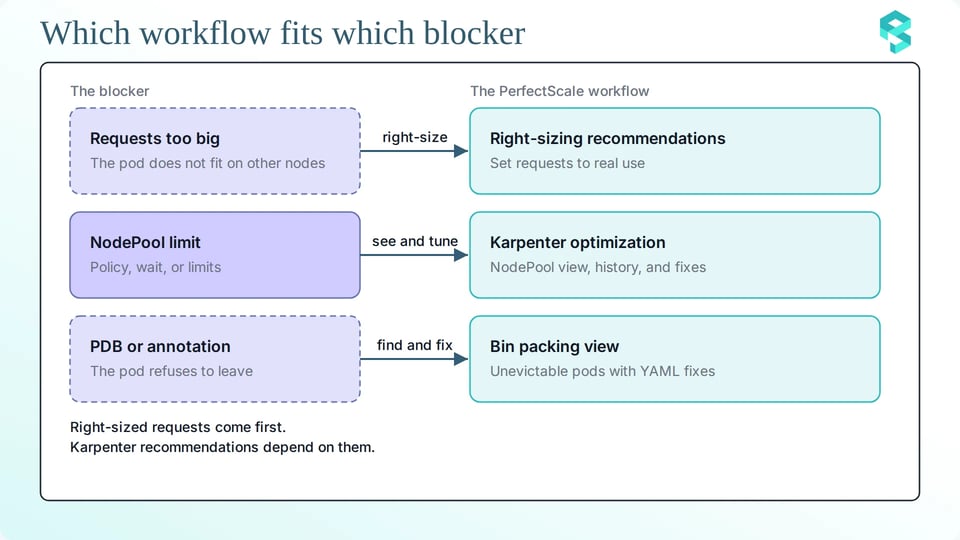
Veja como o PerfectScale pode ajudar você:
1. Faça o right-sizing dos requests primeiro: requests superdimensionados impedem que os pods caibam em outros nodes, e as recomendações do Karpenter dependem dos requests dos workloads em execução. O PerfectScale recomenda fazer o right-sizing dos workloads primeiro. Você pode aplicar as recomendações por conta própria ou ativar a automação.
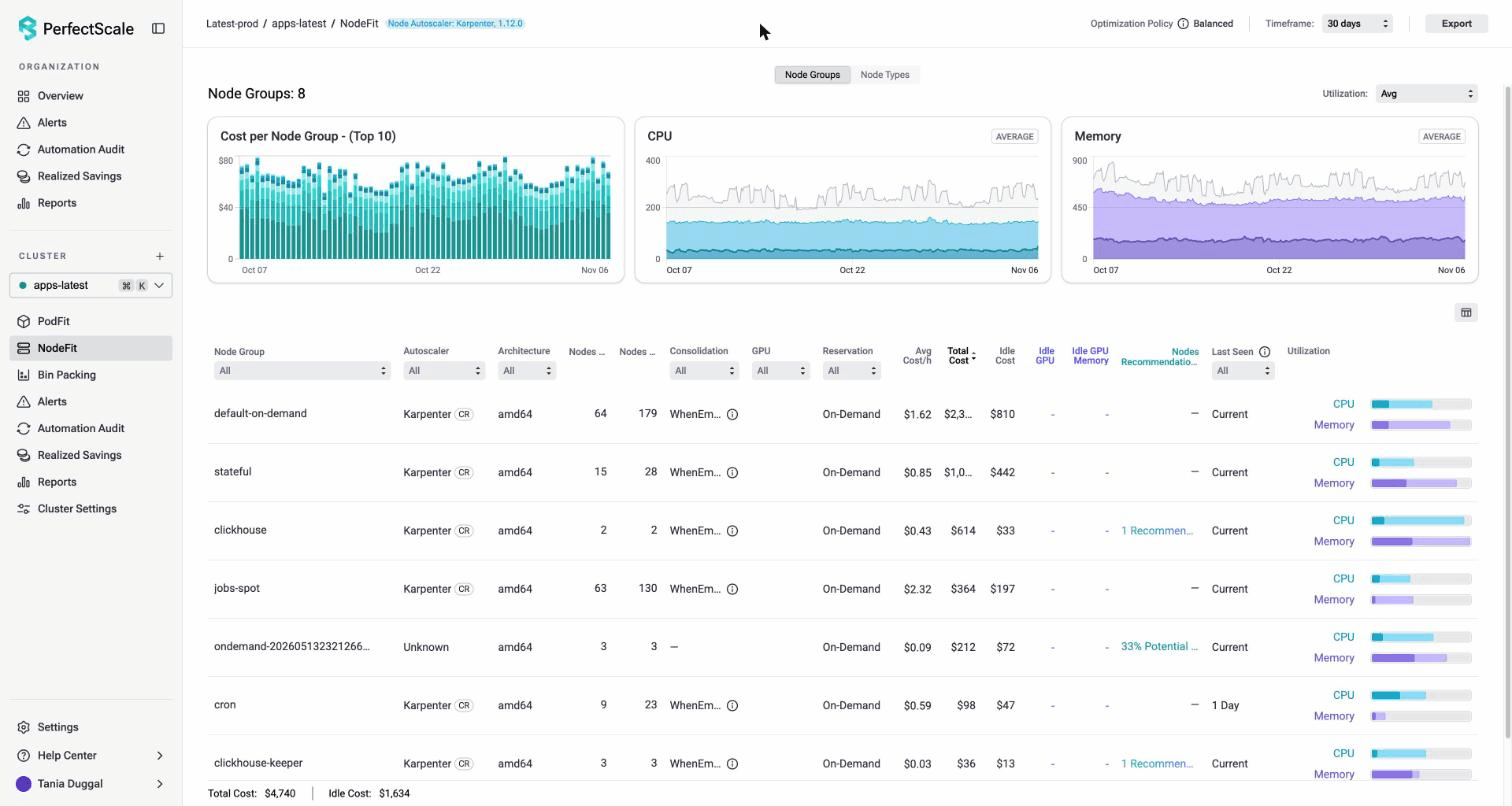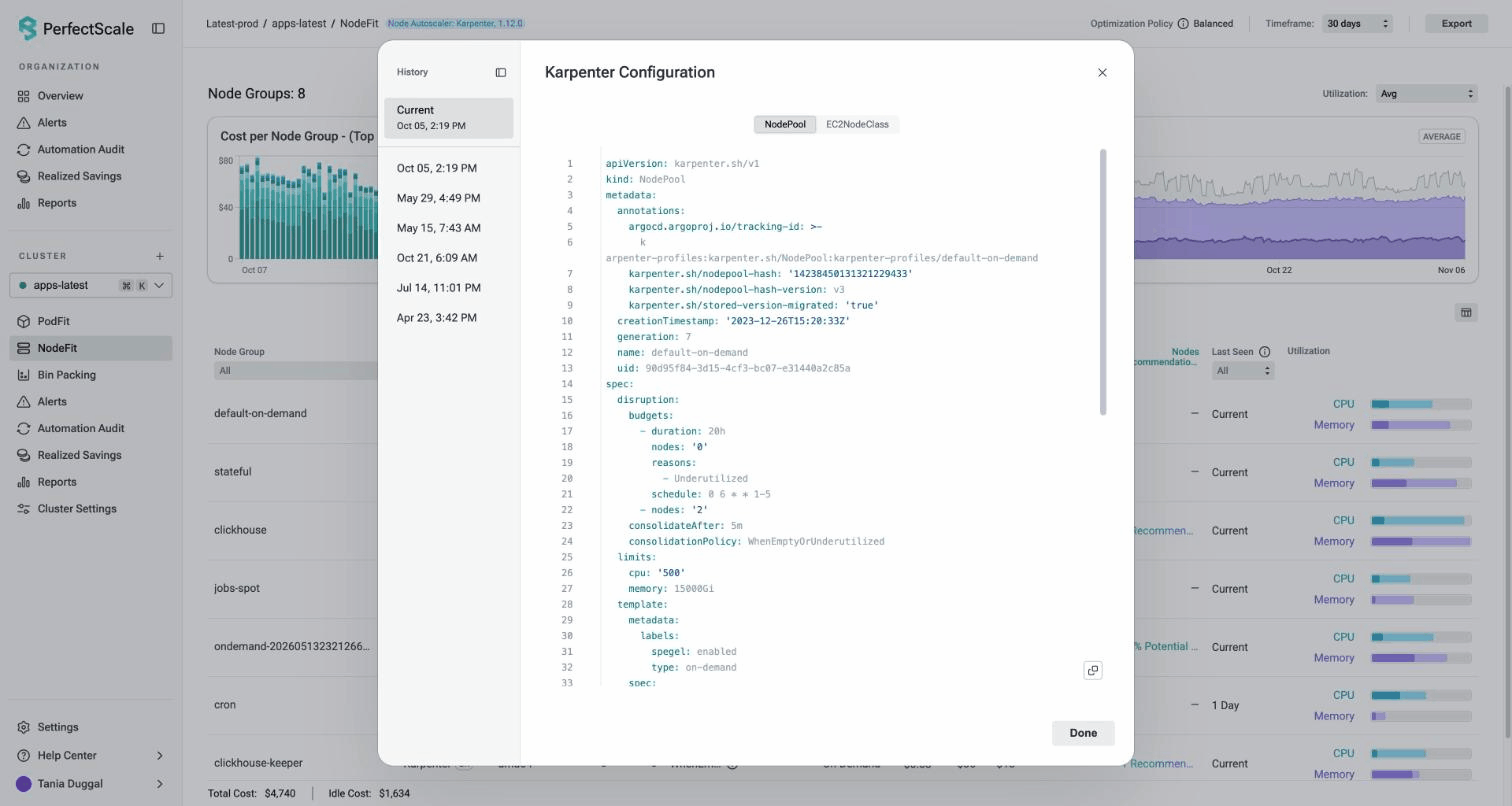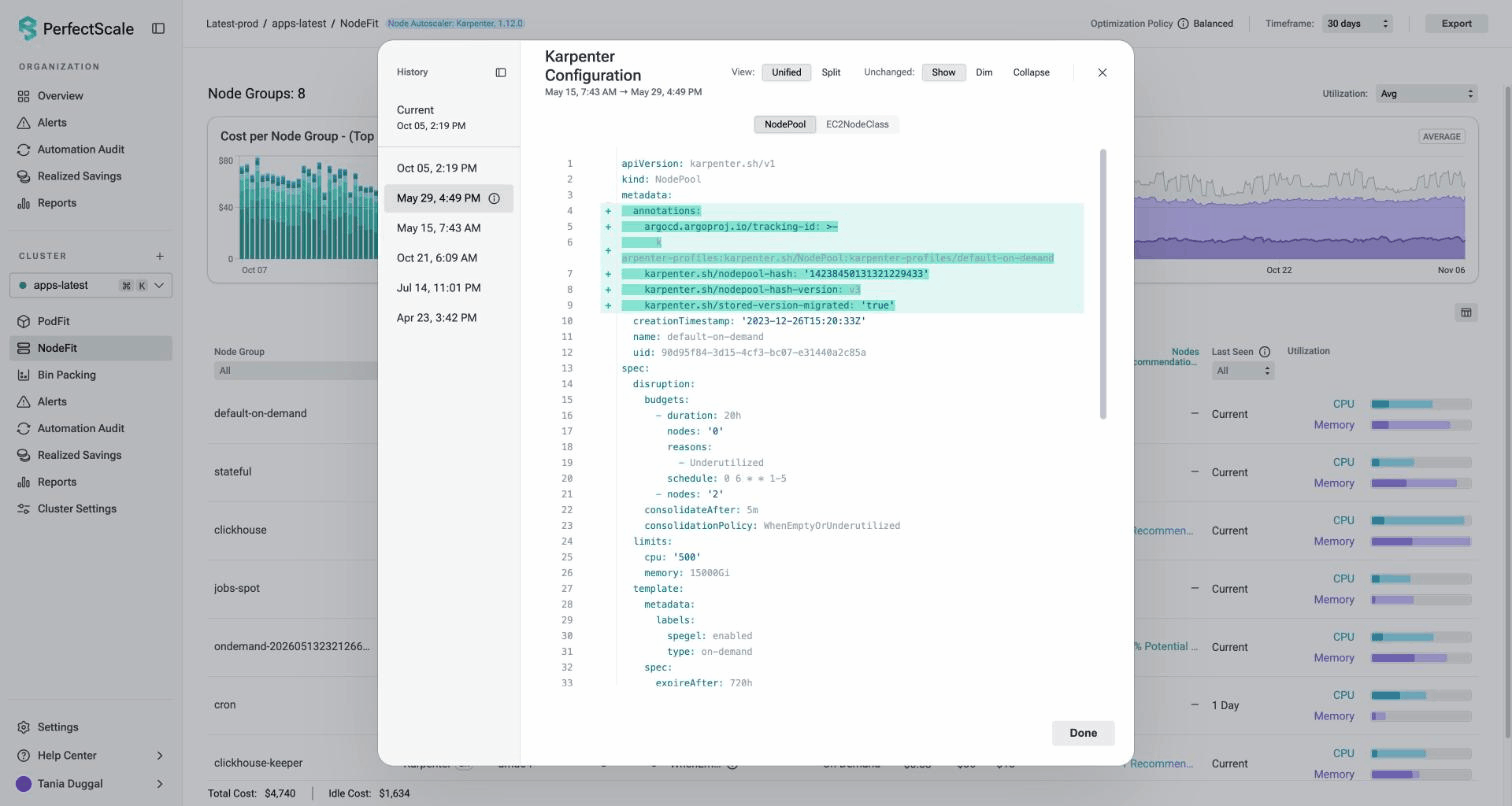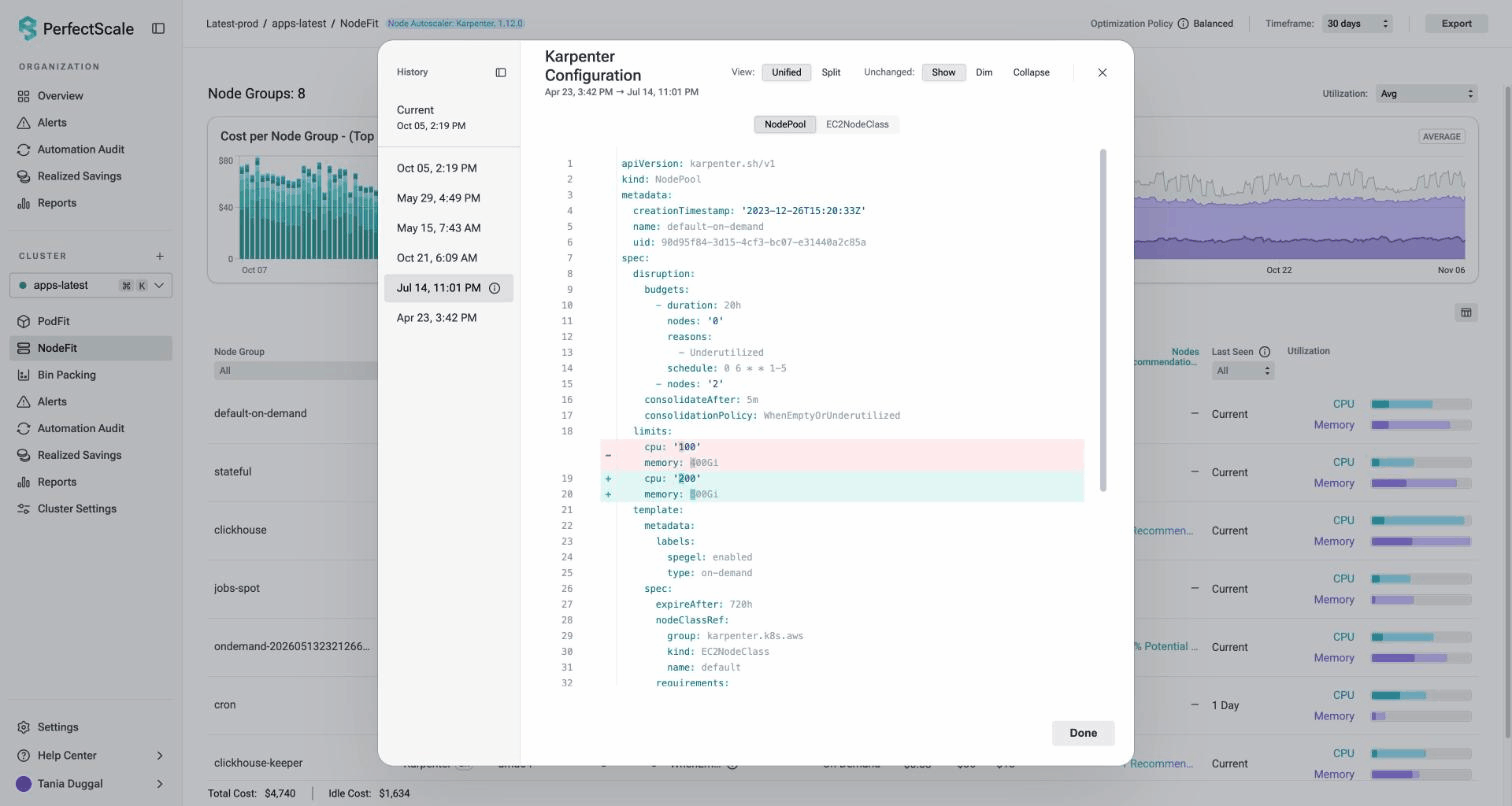
2. Veja o NodePool e cada mudança feita nele: as configurações do Karpenter mudam com o tempo, então ajuda ver o que mudou e quando. O PerfectScale detecta o Karpenter no cluster e mostra a configuração do NodePool e da node class, com um histórico de mudanças. Você pode conferir a política, o tempo de espera e os orçamentos em um só lugar.
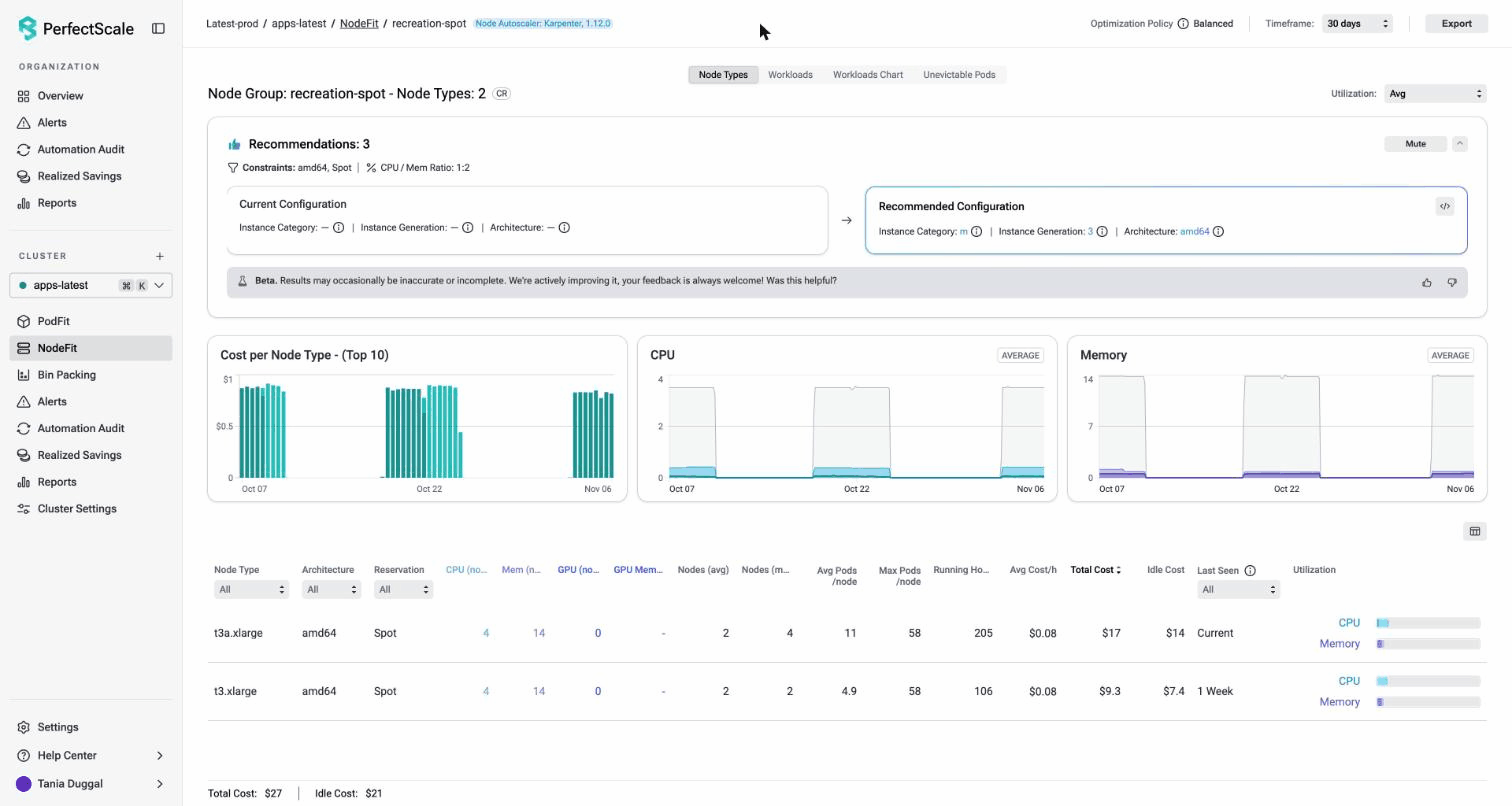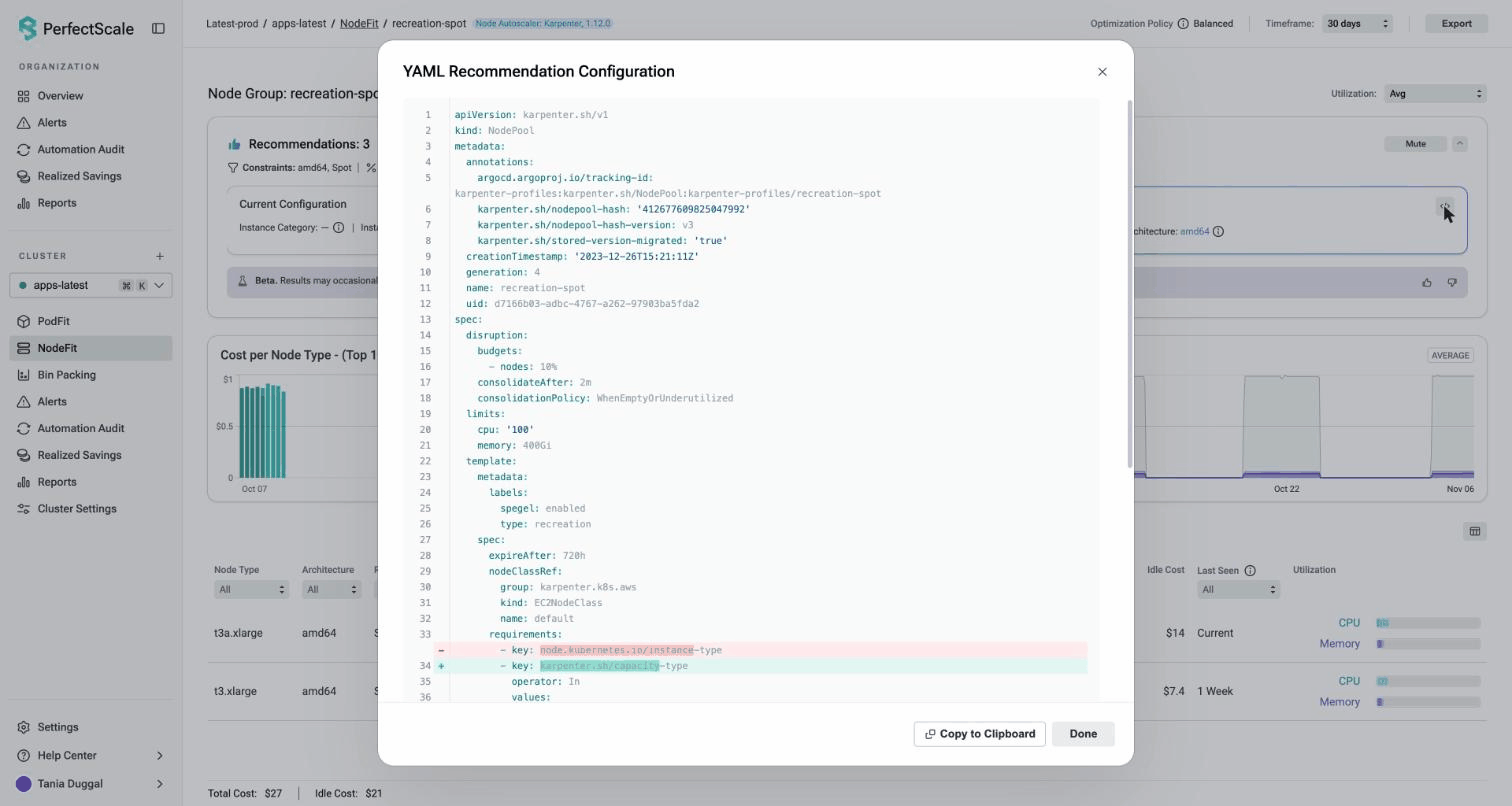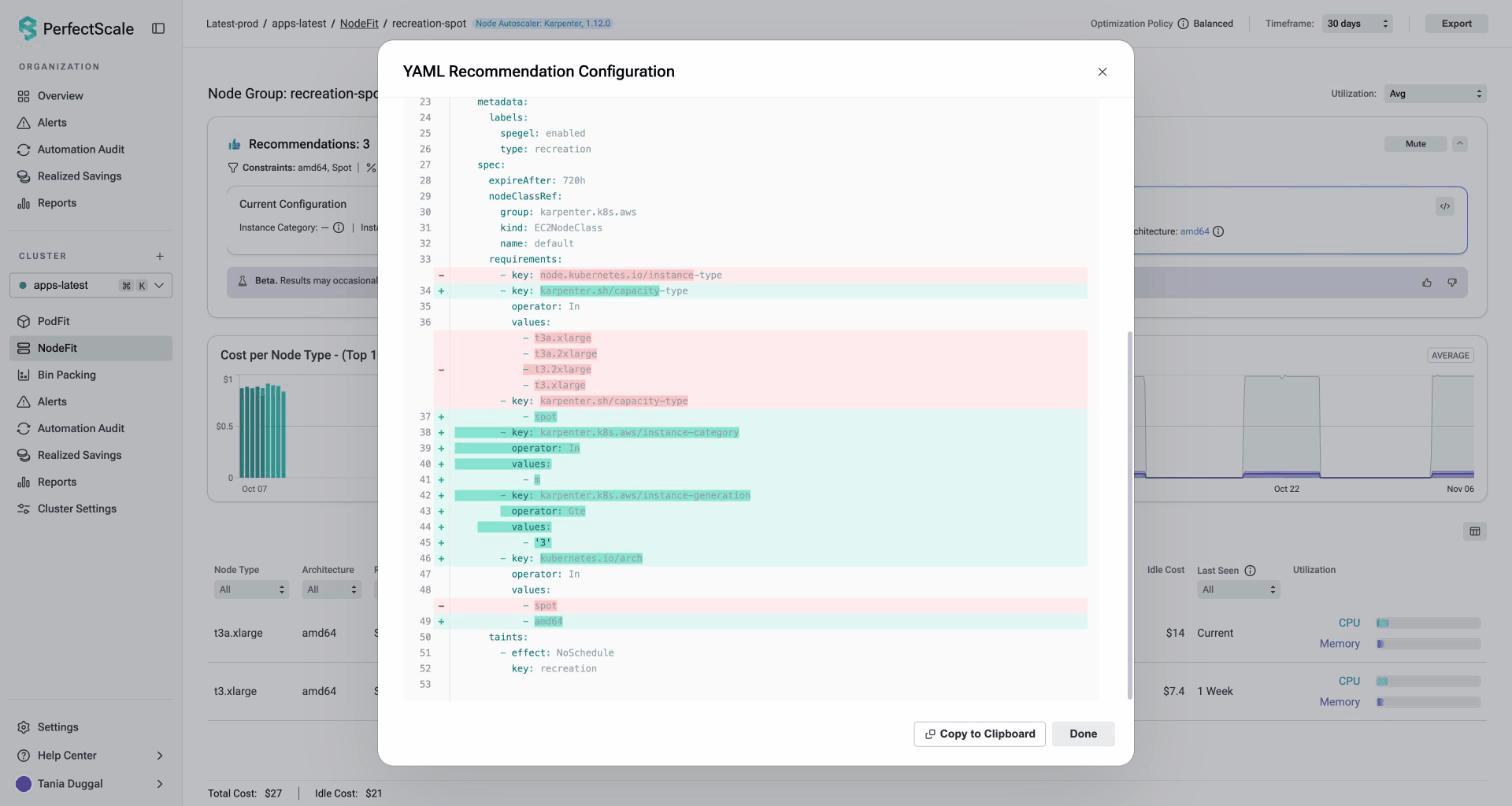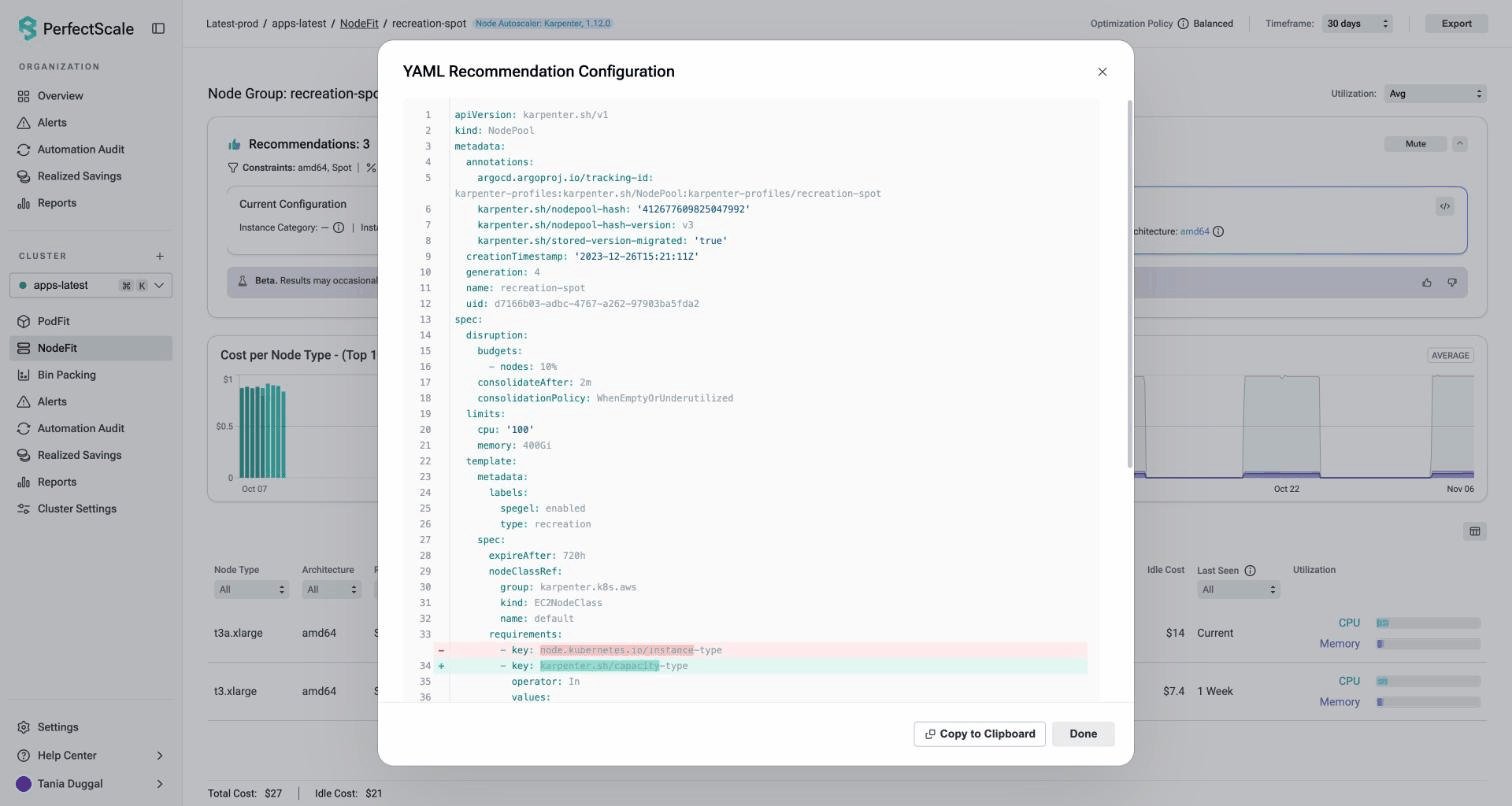
3. Receba recomendações para as configurações do NodePool: o PerfectScale oferece recomendações de otimização do Karpenter para as configurações que determinam a rapidez com que o Karpenter remove nodes. As recomendações ajudam você a:
- Revisar a política de consolidação e o tempo de espera.
- Dar ao Karpenter mais opções de instância ao provisionar novos nodes.
- Encontrar limites de NodePool que deixam pouco espaço para nova capacidade.
Uma visualização em YAML mostra a configuração atual e a recomendada, e você pode copiar o resultado.
4. Encontre os pods que impedem a remoção de nodes: a visualização de bin packing mostra quais pods impedem a remoção de nodes. Para cada um, o PerfectScale explica por que o pod não pode ser despejado e como corrigir. Ele traz recomendações de diff em YAML classificadas por impacto de custo, e cada uma tem um nível de confiança e um nível de risco. Você pode silenciar um apontamento que for intencional.
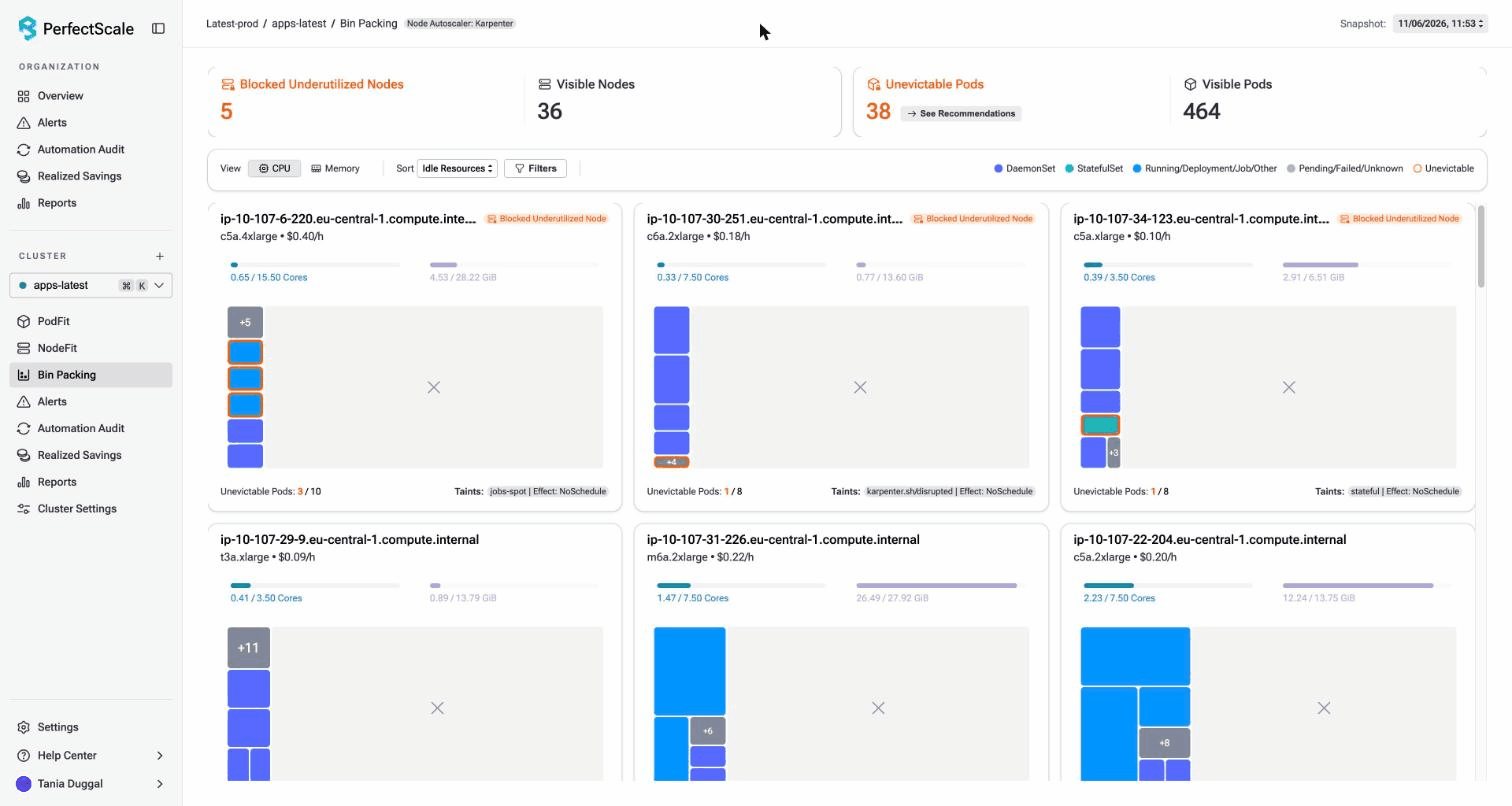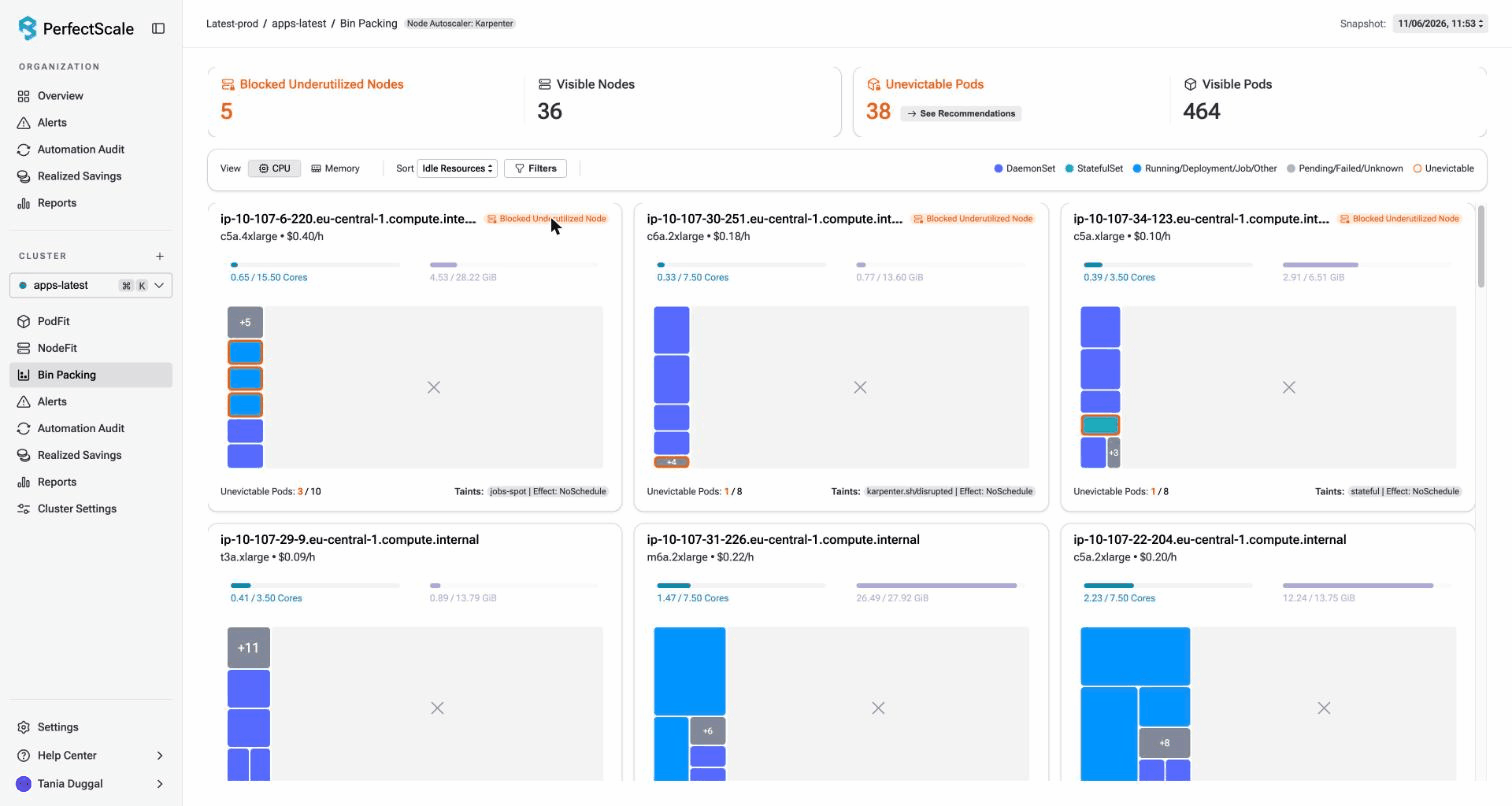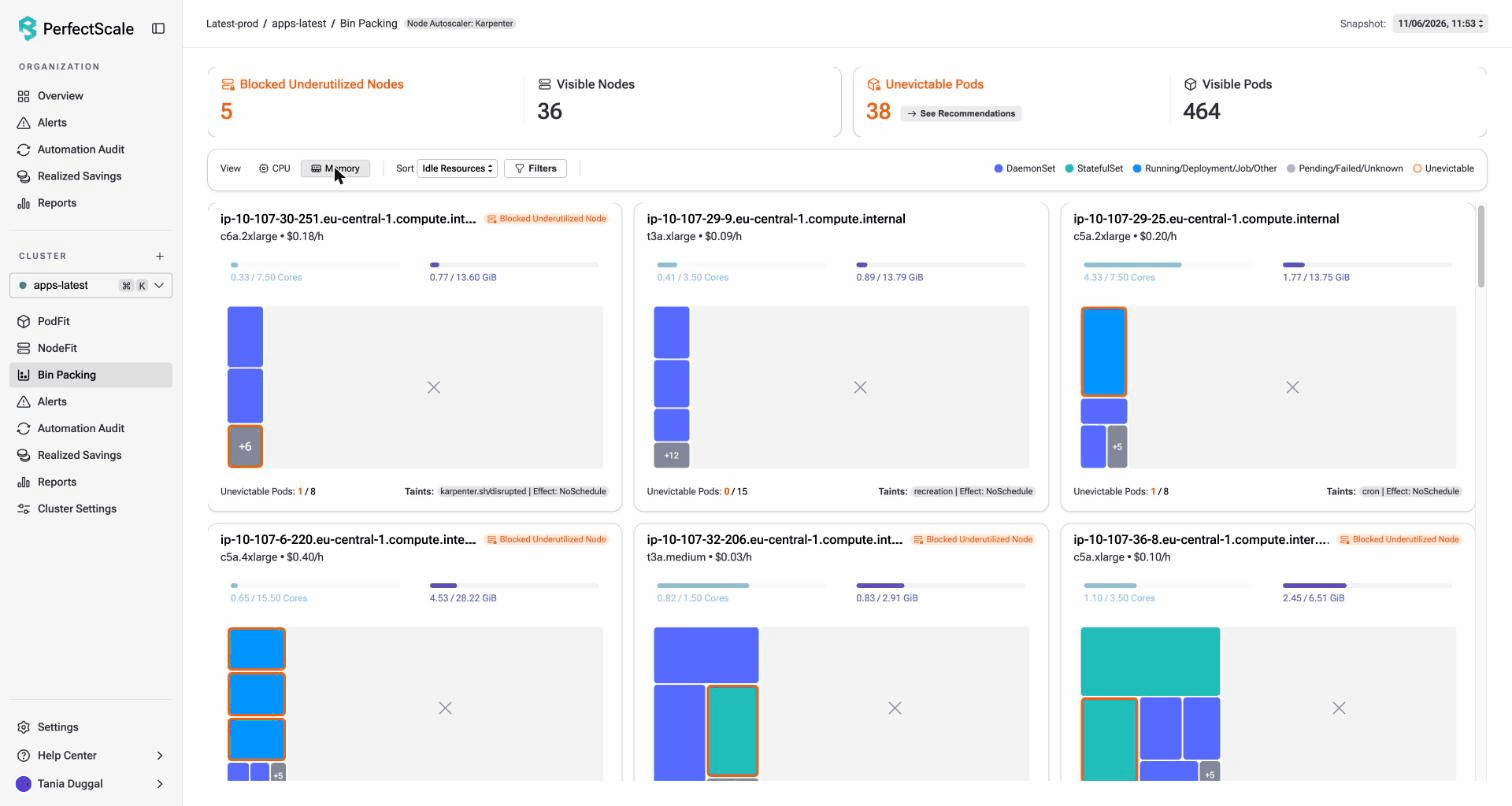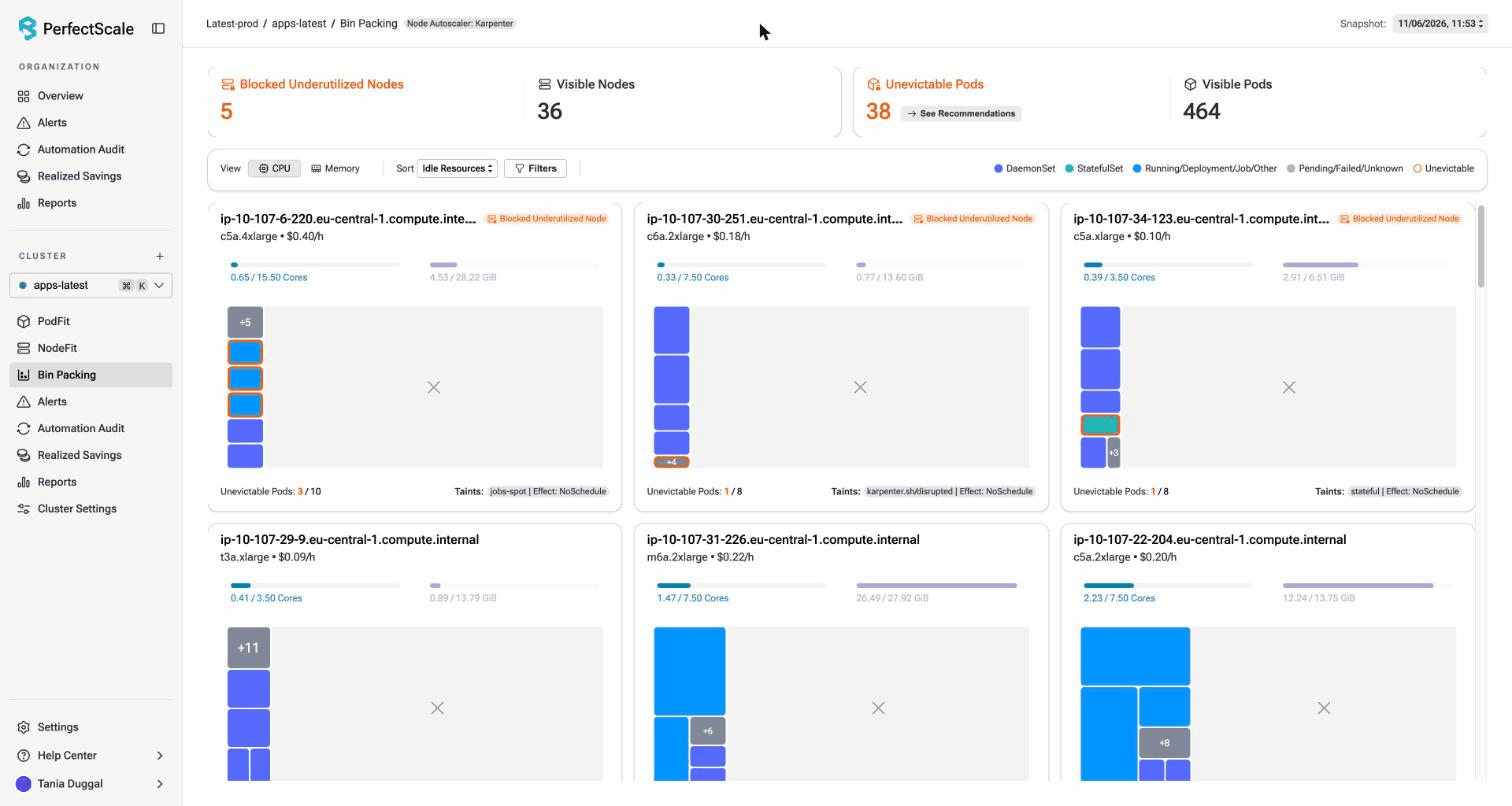
Cada time recebe sua própria lista. O time de plataforma trabalha a partir da visualização do NodePool, e o time de aplicação, a partir dos pods.
Um agente como o Claude também pode consultar os dados do PerfectScale com a skill de agente de IA do PerfectScale. Depois de cada mudança, use o histórico de alterações na sua revisão para ver o que mudou e o que automatizar em seguida.
Checklist para levar com você
Use estas listas em cada mudança e copie-as para o pull request. Uma mudança tem três etapas, e cada uma tem suas próprias verificações:
Antes da mudança
Todas estas condições precisam ser verdadeiras antes de alguém aplicar a mudança:
- O Karpenter criou o node.
- A classe do bloqueio está identificada: limite de NodePool ou bloqueio de workload.
- Um evento, campo ou anotação comprova o bloqueio.
- A mudança altera um único campo ou um único objeto.
- O dono desse objeto aprovou a mudança.
- Um orçamento ou uma janela de tempo limita quantos nodes podem se mover ao mesmo tempo.
- A mudança rodou primeiro em um cluster de teste ou em um NodePool sandbox.
- O passo de reversão e o motivo para reverter estão documentados.
Durante a mudança
Execute estes comandos de watch em terminais separados até a mudança terminar:
kubectl get nodeclaims -wkubectl get events -A --field-selector reason=DisruptionBlocked -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=Succeeded -wEstas verificações ficam ativas até a mudança terminar:
- Os eventos do Karpenter não mostram nenhum bloqueio novo.
- Os pods saem do node no ritmo que os PDBs permitem.
- Os dashboards dos serviços continuam dentro do objetivo de nível de serviço (SLO).
Depois da mudança
Estas verificações encerram a mudança:
- A contagem de nodes corresponde ao resultado esperado.
- Nenhum pod fica esperando ou reiniciando sem causa conhecida.
- O valor ALLOWED de cada PDB está acima de 0 para os serviços que precisam se mover.
- O registro da mudança está completo.
Veja a árvore rodar com um agente no workshop
Na próxima vez que um node permanecer, comece pela primeira pergunta. Um agente pode ajudar nas primeiras verificações, porque ele lê eventos, configurações e métricas muito mais rápido que você. Ele também pode dar uma resposta diferente a cada vez que você perguntar. É por isso que uma pessoa revisa cada mudança, e por isso regras fixas, e não um agente, devem aplicá-la em produção.
O workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling acontece em 17/11/2026, às 11h (horário do leste dos EUA). Vikram Seshadri e Ramesh Mathikumar mostram como um agente lê eventos como esses e esboça o diff, e onde regras fixas assumem o controle. Inscreva-se no workshop.
Lidando com nodes que não param de rodar? Nosso time pode ajudar você a encontrar o bloqueio, revisar a mudança e recuperar capacidade sem comprometer a confiabilidade. Fale com nossos especialistas ou cadastre-se gratuitamente e experimente você mesmo.