

需要が減った後もノードが稼働し続けている場合、そこにはブロッカーが存在します。ブロッカーはNodePoolかワークロードのどちらかにあり、その答えによって誰が修正するかが決まります。
NodePoolの制限とは、Karpenterに統合(consolidation)を行わせない設定のことです。例としては、ポリシー、待機時間、disruption budgetがあります。NodePoolはプラットフォームチームが所有します。ワークロードのブロッカーとは、ノードから離れられないPodのことです。例としては、PodDisruptionBudget(PDB)、do-not-disruptアノテーション、配置ルールがあります。これらのオブジェクトはアプリケーションチームが所有します。
担当者を間違えると、変更依頼が誤ったチームに届き、ノードは残り続けます。本記事では、4つの質問で構成されるデシジョンツリーを紹介します。順番に答えてください。最初に「はい」となった質問が、ブロッカーの種類、担当者、次のステップを示します。
2種類のブロッカー
Karpenterは、2つの条件がともに満たされる場合にのみノードを削除します。NodePoolがその操作を許可していること、そしてノード上のすべてのPodが退避できることです。それぞれの条件には担当者がいます。
- NodePoolの制限: NodePoolの設定がKarpenterの動作を止めています。修正はNodePoolの変更で、プラットフォームチームが担当します。
- ワークロードのブロッカー: Podがノードから離れられない、または他に動かせる場所がありません。修正はワークロードの変更で、アプリケーションチームが担当します。
Karpenterは自身が作成したノードに対してのみ動作します。別のツールが作成したノードは第3のケースであり、Karpenterの設定では解決できません。また、1つのノードに複数のブロッカーが存在することもあるため、1つ修正したら再度ノードを確認してください。
デシジョンツリー
需要が減った後も残っているノードから始めます。4つの質問に順番に答えてください。最初に「はい」となった質問で止めてください。その答えがブロッカーの種類と修正の担当者を示すからです。
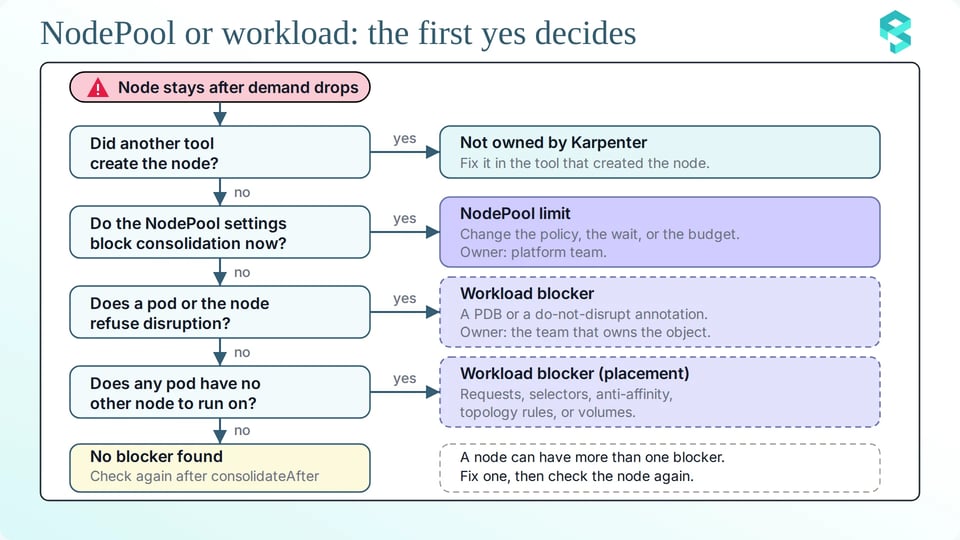
各質問には、答えを裏付ける簡単な確認方法があります。誰かに変更を依頼する前に、必ず確認を実行してください。
質問1:別のツールがノードを作成しましたか?
Karpenterは自身が作成したノードに対してのみ動作するため、まず所有者を確認します。NodeClaimを持たないノードは、統合の候補になることはありません。karpenter.sh/nodepoolラベルを見れば、どのNodePoolがノードを作成したかが分かります。$NODEをノード名に置き換えてください。
kubectl get node $NODE -L karpenter.sh/nodepoolNODEPOOL列が空の場合、そのノードはKarpenterが作成したものではないため、Karpenterが統合することはありません。マネージドノードグループなど、ノードを作成したツール側で修正してください。
質問2:NodePoolの設定が現在統合をブロックしていますか?
4つのNodePool設定が統合を止める可能性があります。まずdisruptionブロックを確認してください。ポリシー、待機時間、budgetsを1回の出力でまとめて確認できます。$NODEPOOLをNodePool名に置き換えてください。
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'次の4つの設定を確認します。
- consolidationPolicy: WhenEmptyの場合、空のノードのみが対象となるため、Podを載せているノードは残ります。BalancedとWhenEmptyOrUnderutilizedは、Podを載せているノードも対象にします。Balancedは、節約効果が中断に見合わない移動をスキップします。
- consolidateAfter: これは待機時間です。KarpenterはPodがノードに追加または削除されるたびにタイマーをリセットするため、値が長いとPodの出入りが多いノードはいつまでも対象になりません。Neverを設定すると、そのNodePoolでは統合が無効になります。
- budgets: nodes: '0' のbudgetは、すべての自発的な中断をブロックします。scheduleとdurationを持つbudgetは、その時間帯の中断をブロックします。scheduleは常にUTCです。
- requirementsとlimits: 置き換え先のノードは、NodePoolのrequirementsとlimitsに適合しなければなりません。より安価なノードが適合しない場合、Karpenterはノードを置き換えられません。
次のコマンドでlimitsとrequirementsを表示できます。
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.limits}{"\n"}{.spec.template.spec.requirements}{"\n"}'どの設定が該当するかはイベントで確認します。次のコマンドで、NodePoolとクラスタ全体のイベントを確認できます。
kubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestamp各設定は固有の痕跡を残します。
| 設定 | 表示される内容 | 最小限の変更 |
|---|---|---|
consolidationPolicy が WhenEmpty |
NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty | ポリシーを WhenEmptyOrUnderutilized に設定する |
consolidateAfter が Never |
NodePool "<name>" has consolidation disabled | 15m などの期間を設定する |
consolidateAfter が長い |
イベントなし。NodeClaimの Consolidatable 条件が False |
期間を短くする |
budgets |
No allowed disruptions for disruption reason Underutilized due to blocking budget, on the NodePool | nodes: '0' をパーセンテージに置き換えるか、ゼロのbudgetを特定の時間帯に限定する |
| requirementsとlimits | Can't replace with a cheaper node | インスタンスの選択肢を増やすか、limitを引き上げる |
待機時間が長い場合、イベントは残りません。Consolidatable条件を確認するには、$NODECLAIMをNodeClaim名に置き換えてください。
kubectl get nodeclaim $NODECLAIM -o jsonpath='{.status.conditions[?(@.type=="Consolidatable")].status}{"\n"}'値がFalseの場合、そのノードはまだ統合の候補ではありません。
各修正は1つのフィールドの変更で済みます。最初のdiffは、Podを載せているノードもKarpenterの統合対象にします。
spec: disruption:- consolidationPolicy: WhenEmpty+ consolidationPolicy: WhenEmptyOrUnderutilized次のdiffは待機時間を短縮します。
spec: disruption: consolidateAfter: 15m # previously 2h最後のdiffはゼロのbudgetを削除します。ゼロのbudgetはリリースを保護していることが多いため、まずプラットフォームチームに確認してください。
spec: disruption: budgets:- - nodes: "0"+ - nodes: "10%"NodePoolはプラットフォームチームが所有しているため、これらの変更はプラットフォームチームが行います。
質問3:Podまたはノードが中断を拒否していますか?
Karpenterはノードを中断する前に、その上のすべてのPodを確認します。Podが中断を拒否する方法は2つあります。PDBに余裕がない場合と、Podがkarpenter.sh/do-not-disruptアノテーションを持っている場合です。ノード自体がこのアノテーションを持つこともあります。原因はイベントに示されます。
| メッセージ | 意味 | 担当者 |
|---|---|---|
| Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) | PDBに余裕がなく、ノード上のPodを退避できません。 | アプリケーションチーム |
| MultiplePodDisruptionBudgets | 2つのPDBが同じPodを選択しています。最近のKubernetesバージョンでは、このイベントはPodに記録され、Karpenterにはイベントが表示されないことがあります。 | アプリケーションチーム |
| Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) | ノード上のPodがアノテーションを持っています。 | アプリケーションチーム |
| Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation | ノード自体がアノテーションを持っています。 | プラットフォームチーム |
PDBを確認するには、すべてのPDBを許可されているdisruption数とあわせて一覧表示します。
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'ALLOWEDの値が0の場合、そのPDBの対象となるPodは今すぐには退避できません。Podに紐付くPDBは1つだけでなければなりません。2つのPDBが同じPodを選択していると、両方のPDBに余裕があってもKubernetesは退避を拒否します。
アノテーションを確認するには、アノテーションを持つPodとノードを一覧表示します。これらのコマンドはjqを使用します。
# Find pods with the karpenter.sh/do-not-disrupt annotationkubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
# Find nodes with the karpenter.sh/do-not-disrupt annotationkubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
このアノテーションは、1つのPodに対するPDBのように機能します。値が "true" の場合、Podは永続的に保護されます。"30m" のような期間を指定すると、起動後その時間だけ保護されます。
各修正は小さな変更です。レプリカ数3のDeploymentでは、minAvailable: 3 の代わりに maxUnavailable: 1 を使用してください。maxUnavailableはレプリカ数に追従するためです。
spec: minAvailable: 3 maxUnavailable: 1アプリケーションチームが「Podは30分後に移動してよい」と合意した場合は、永続的なアノテーションを期間指定に変更します。
template: metadata: annotations: karpenter.sh/do-not-disrupt: "30m"クラッシュループしているPodが退避をブロックすることもあります。その場合はPDBを維持したまま、unhealthyPodEvictionPolicy: AlwaysAllow を設定してください。このフィールドはKubernetes v1.31から安定版です。
Karpenterはノードをドレインする際、static Pod、karpenter.sh/disrupted:NoScheduleのtaintを許容するPod、完了または失敗したPodは退避させません。
これらの変更の多くはアプリケーションチームが行います。PDBとPodを所有しているのはアプリケーションチームだからです。ノード上のアノテーションはプラットフォームチームが所有します。
質問4:他に動かせるノードがないPodはありますか?
Karpenterはノードを削除する前に、Podがどこで動けるかをシミュレートします。すべてのPodが他のノードの空き容量に収まるなら、ノードを削除します。空き容量に加えて、より安価なノード1台で収まるなら、ノードを置き換えます。1つでもどこにも収まらないPodがあれば、ノードは残ります。イベントがそのPodを特定するとは限らないため、Podのspecから探します。
ノード上の各Podを現在の場所に縛っている要素を確認するには、ノード上のすべてのPodの詳細を一覧表示します。
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'次の原因がないか確認してください。
- 他のノードの空き容量より大きなリクエスト。
- このノードグループにのみ一致するnodeSelector。
- 必須のanti-affinityルール。
- 他のノードが満たせないtopology spreadルール。
- 1つのゾーンに紐付いたボリューム。
- Podが許容しない、他のノード上のtaint。
preferred指定のanti-affinityやtopology spreadルールも、統合の効果を下げる可能性があります。Karpenterはノードを削除する際、これらを満たそうとするためです。
最初の原因から確認します。KarpenterはPodを実際の使用量ではなく、リクエストに基づいて配置します。次のクエリは、各namespaceの実際のCPU使用量とCPUリクエストを比較します。kubeletとkube-state-metricsのメトリクスを使用します。
query: sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m])) / sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})比率が1を大きく下回る場合、リクエストが大きすぎます。その結果、各ノードに載せられるPodが本来より少なくなり、空きスペースの分まで料金を支払うことになります。
リクエストが過大であることが根拠から明らかな場合は、実際の必要量まで下げてください。根拠が示す1つの値だけを変更します。
resources: requests: cpu: "4" cpu: "2"また、コントローラーを持たないPodも確認してください。Karpenterをブロックすることはありませんが、退避後に再起動する仕組みがありません。
どの質問にも「はい」がない場合
Karpenterは、短期的で正常な理由でもノードをスキップします。consolidateAfterのタイマーがまだ終わっていない、ノードがまだ起動中である、ノードがすでに削除中である、またはKarpenterが保留中のPodのためにそのノードを選んだばかり、といったケースです。数分後にもう一度ノードを確認してください。
誰が修正するか
各分類には担当者と最小限の変更が1つずつ定まっているため、正しいチームに正しい依頼が届きます。
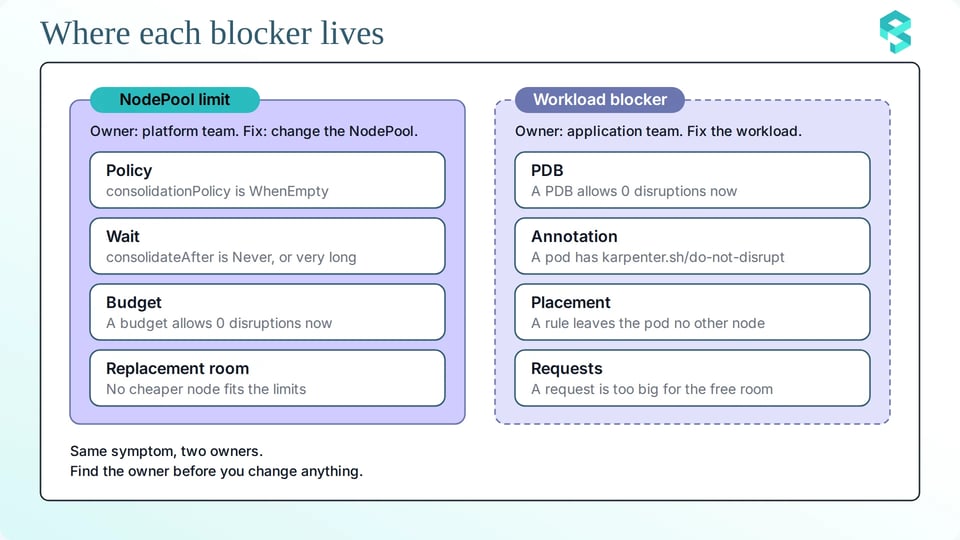
次の表に、根拠、担当者、変更をまとめています。
| 分類 | 根拠 | 担当者 | 最小限の変更 |
|---|---|---|---|
| Karpenterが作成していない | NODEPOOL列が空 | 他のツールの所有者 | そのツール側でのノードの変更 |
| NodePoolの制限 | disruptionブロック内の設定と、NodePoolまたはノード上のイベント | プラットフォームチーム | NodePoolの1フィールド |
| ワークロードのブロッカー: PDBまたはアノテーション | DisruptionBlockedイベント、ALLOWEDの値、またはアノテーションのフィルタ | アプリケーションチーム(ノードのアノテーションはプラットフォームチーム) | PDBの1フィールドまたはアノテーションの1つの値 |
| ワークロードのブロッカー: 配置 | Unconsolidatableイベントまたはイベントなし、およびPod配置のフィルタ | アプリケーションチーム | 1つのリクエストまたは1つのルール |
担当者にdiffを送り、依頼の中で根拠を明記してください。担当者は長いレポートではなく、1つのフィールドをレビューするだけで済みます。
PerfectScaleができること
PerfectScale by DoiT は、デシジョンツリーの代わりになるものではありません。担当者と修正方法を、より少ない手作業で見つける手助けをします。
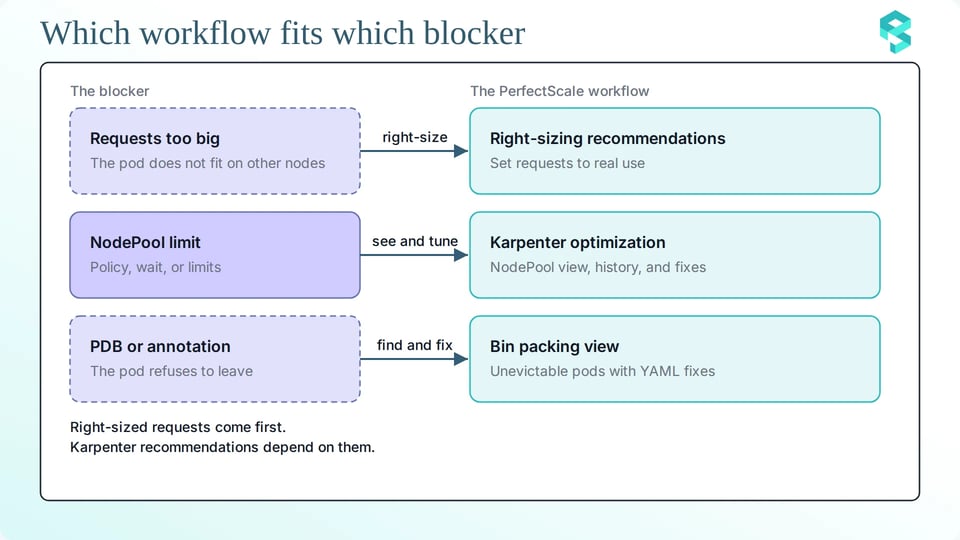
PerfectScaleでできることは次のとおりです。
1. まずリクエストをライトサイジングする: 過大なリクエストはPodが他のノードに収まるのを妨げ、Karpenterの推奨は稼働中のワークロードのリクエストに依存します。PerfectScaleは、まずワークロードのライトサイジングを推奨します。推奨内容を自分で適用することも、自動化を有効にすることもできます。
2. NodePoolとそのすべての変更を確認する: Karpenterの設定は時間とともに変わるため、何がいつ変わったかを把握できると便利です。PerfectScaleはクラスタ内のKarpenterを検出し、NodePoolとnode classの設定を変更履歴とともに表示します。ポリシー、待機時間、budgetsを1か所で確認できます。
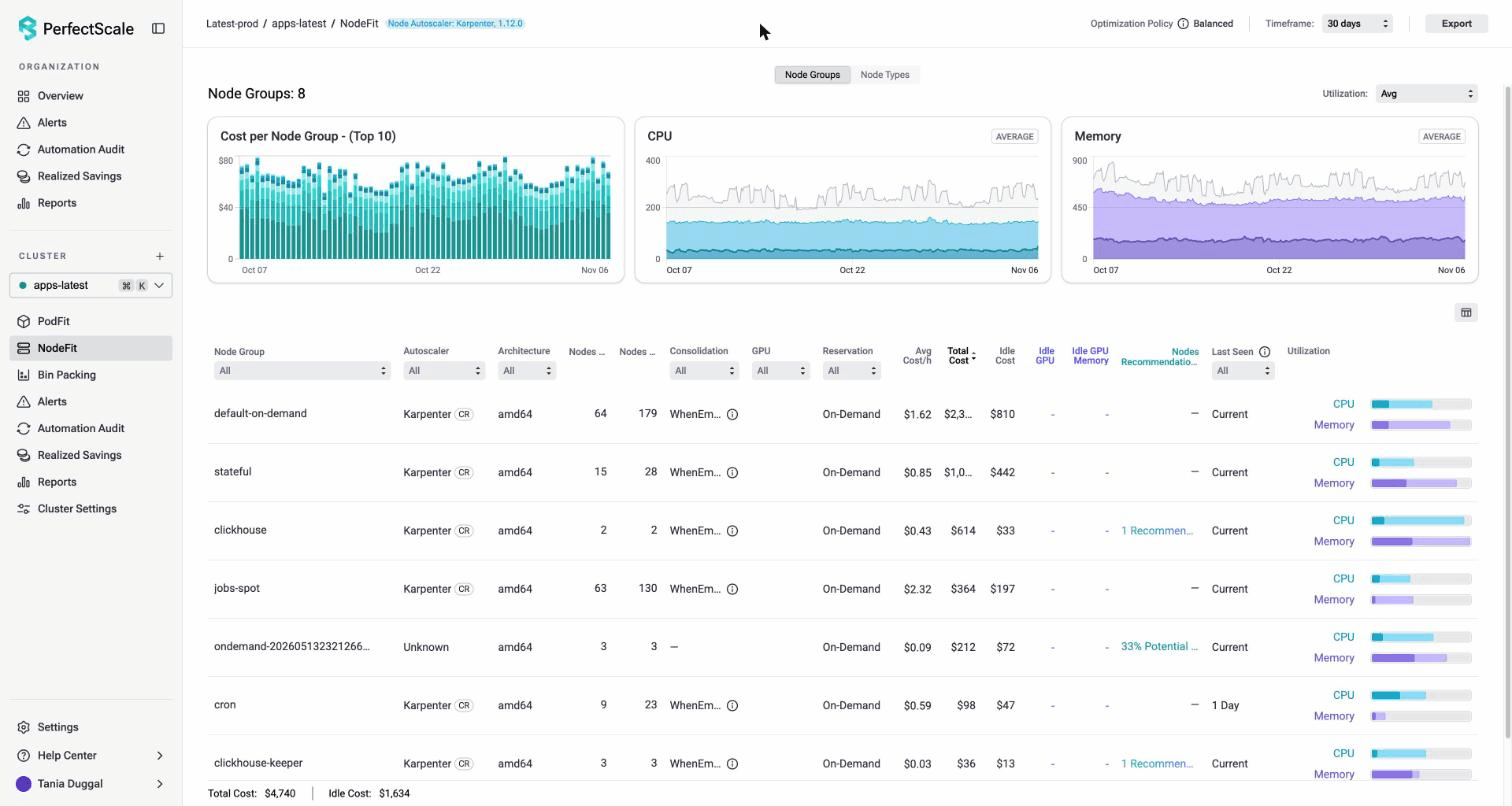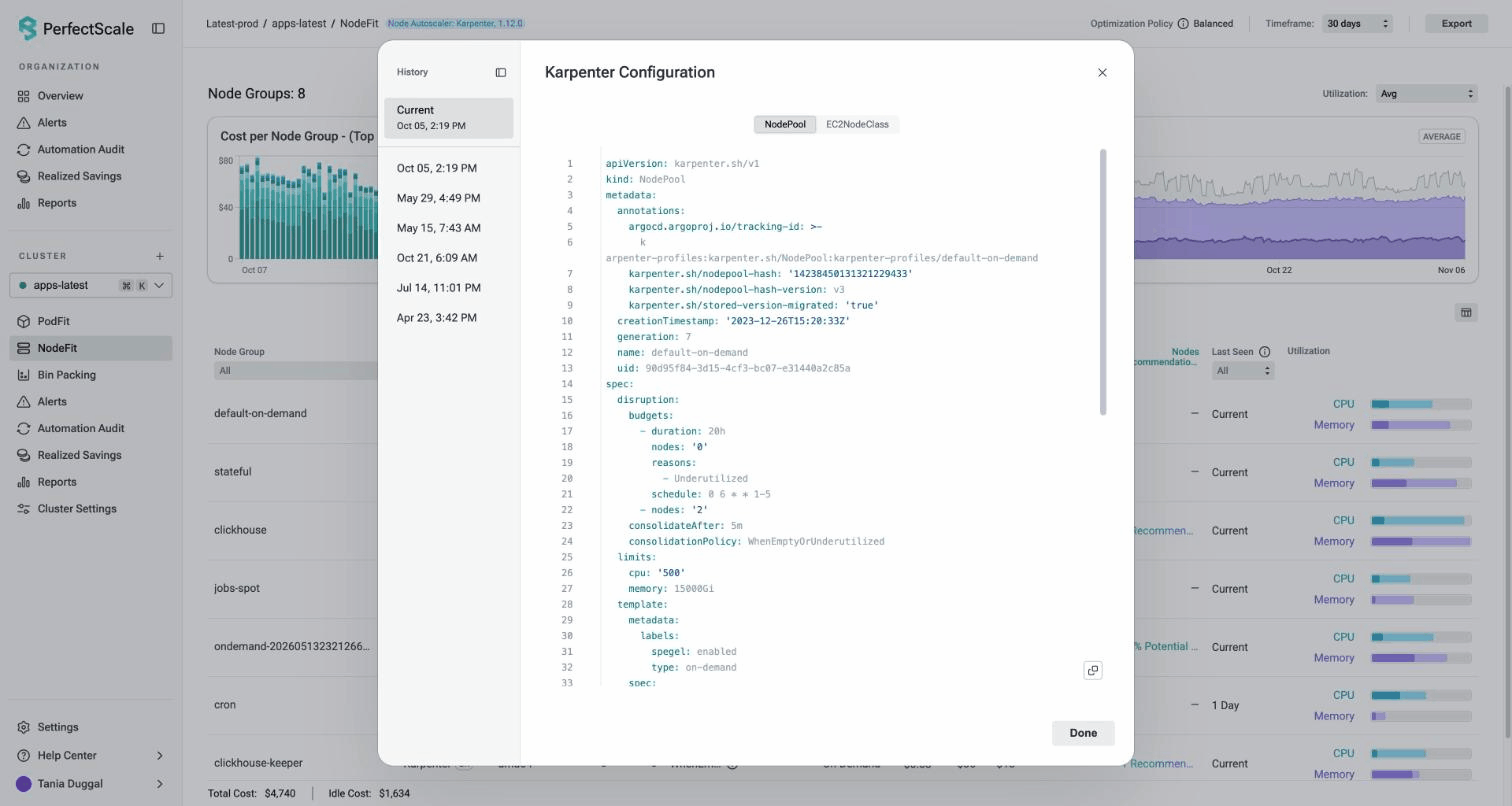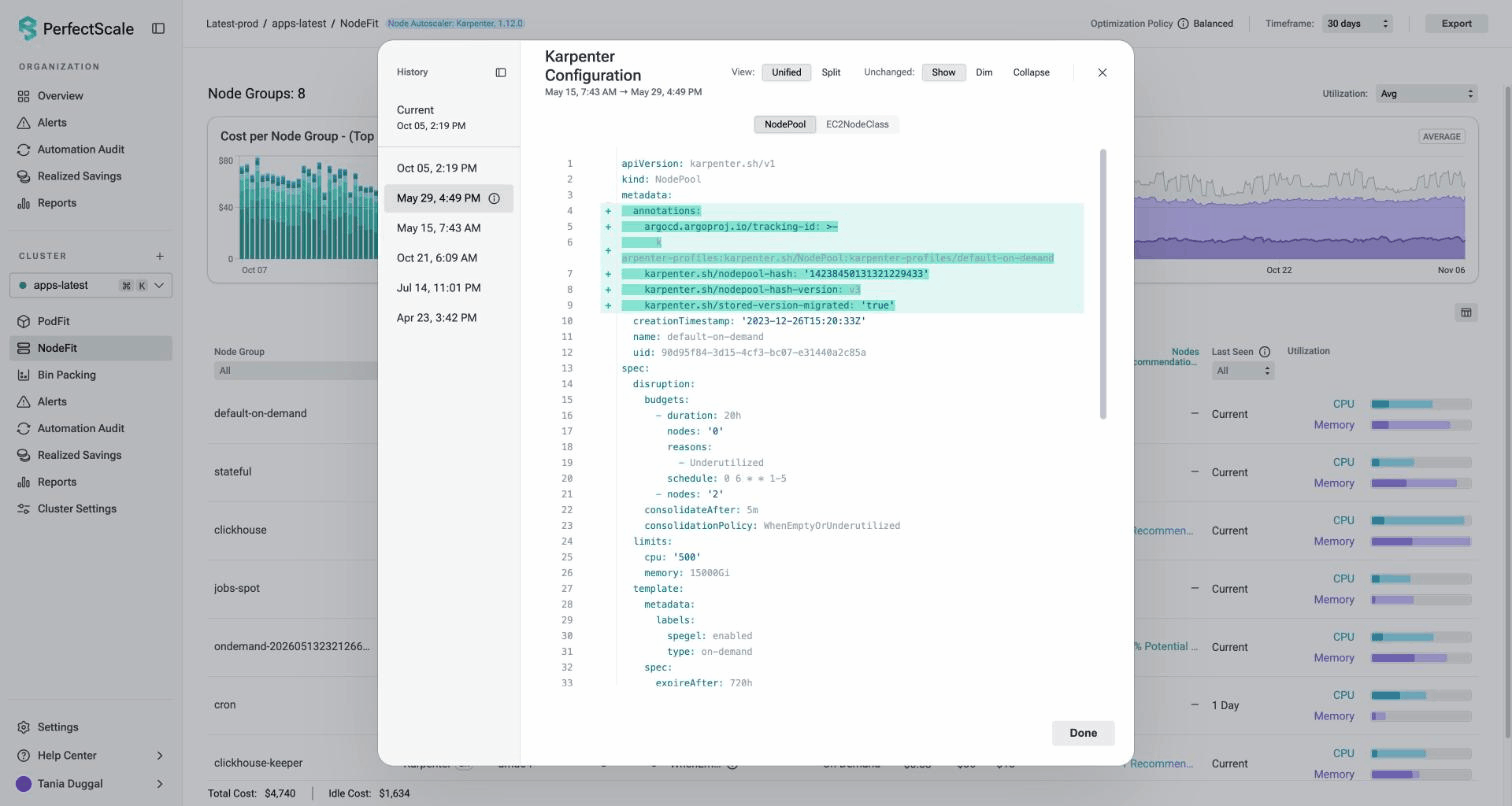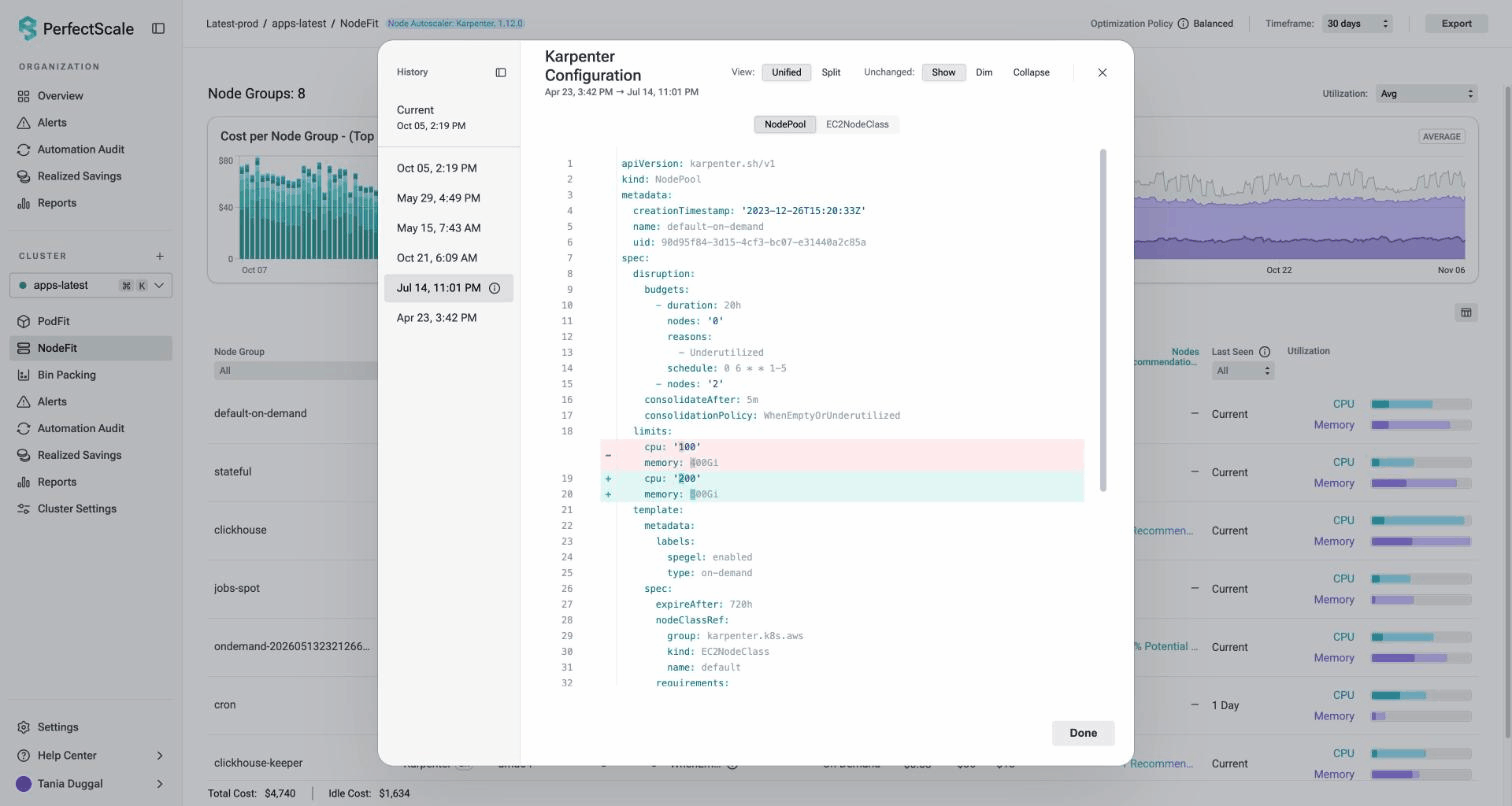
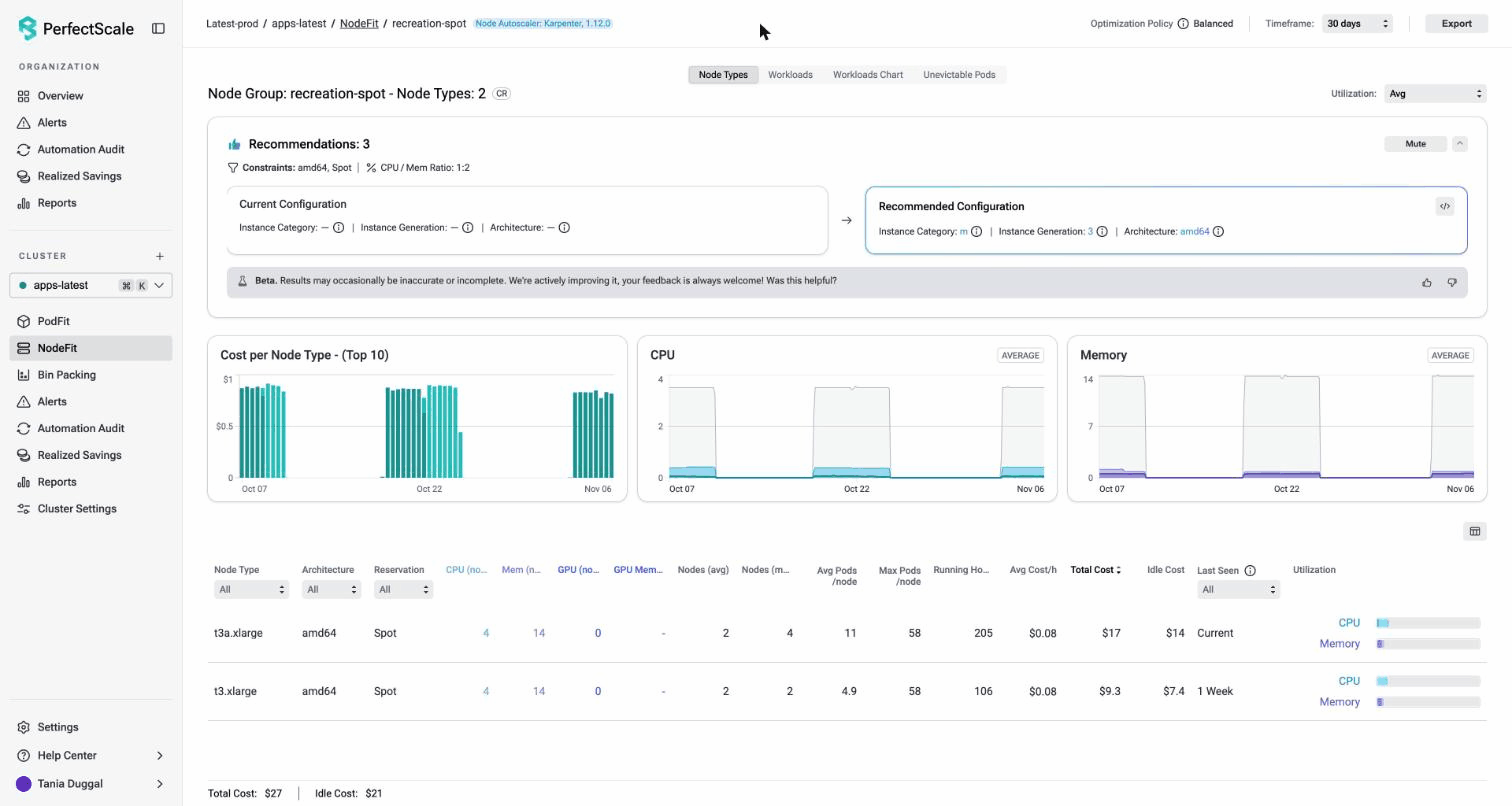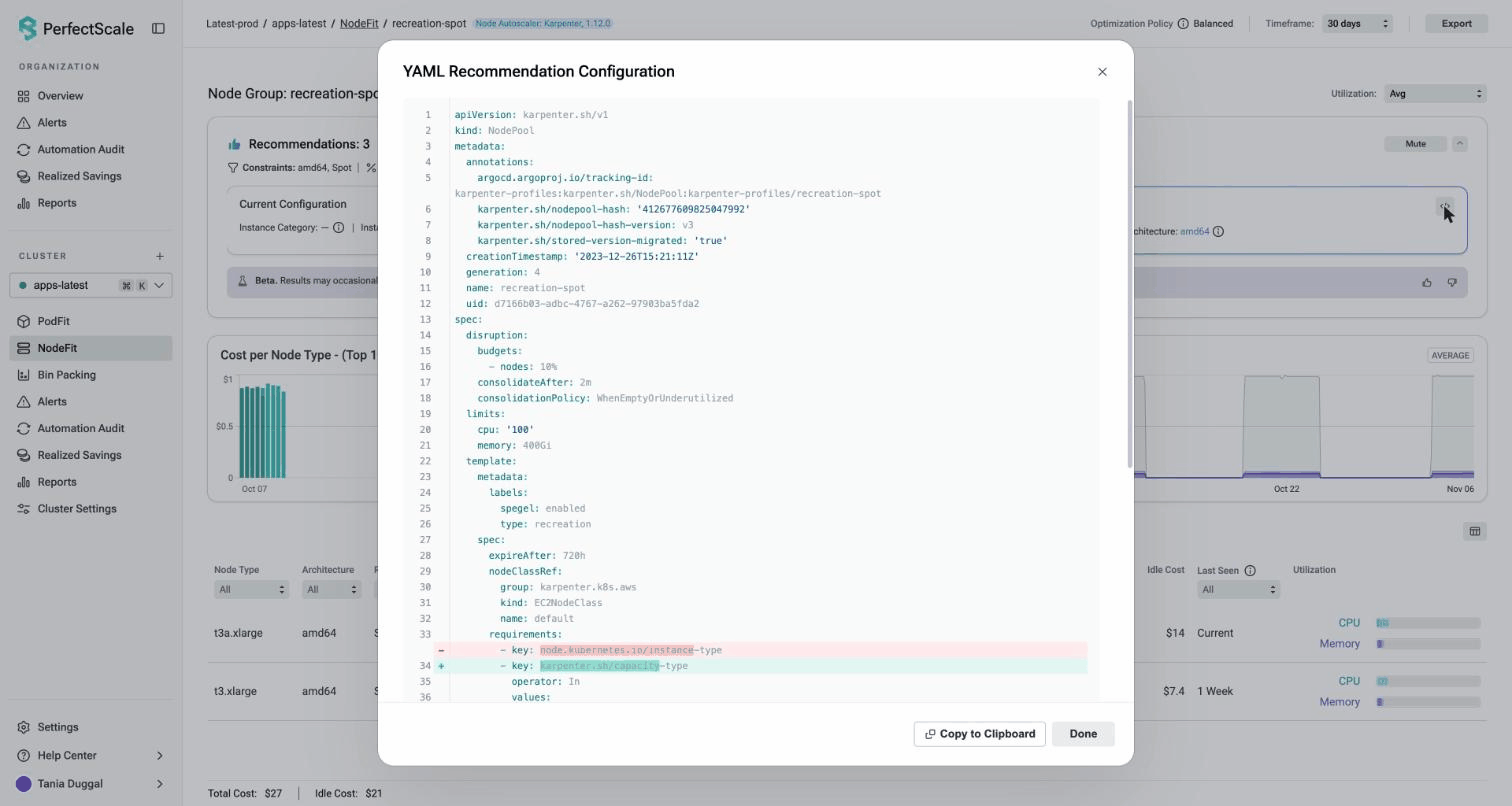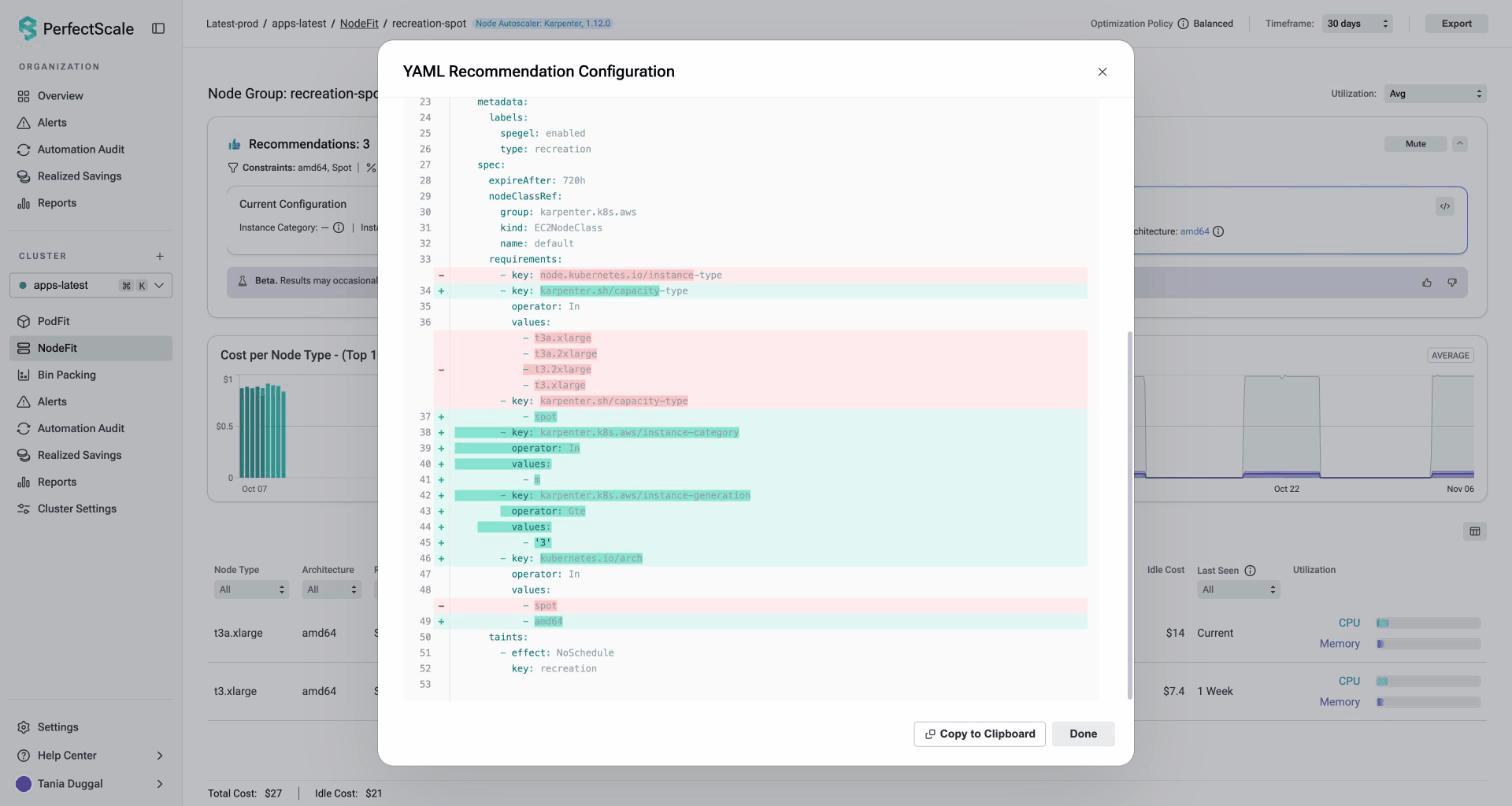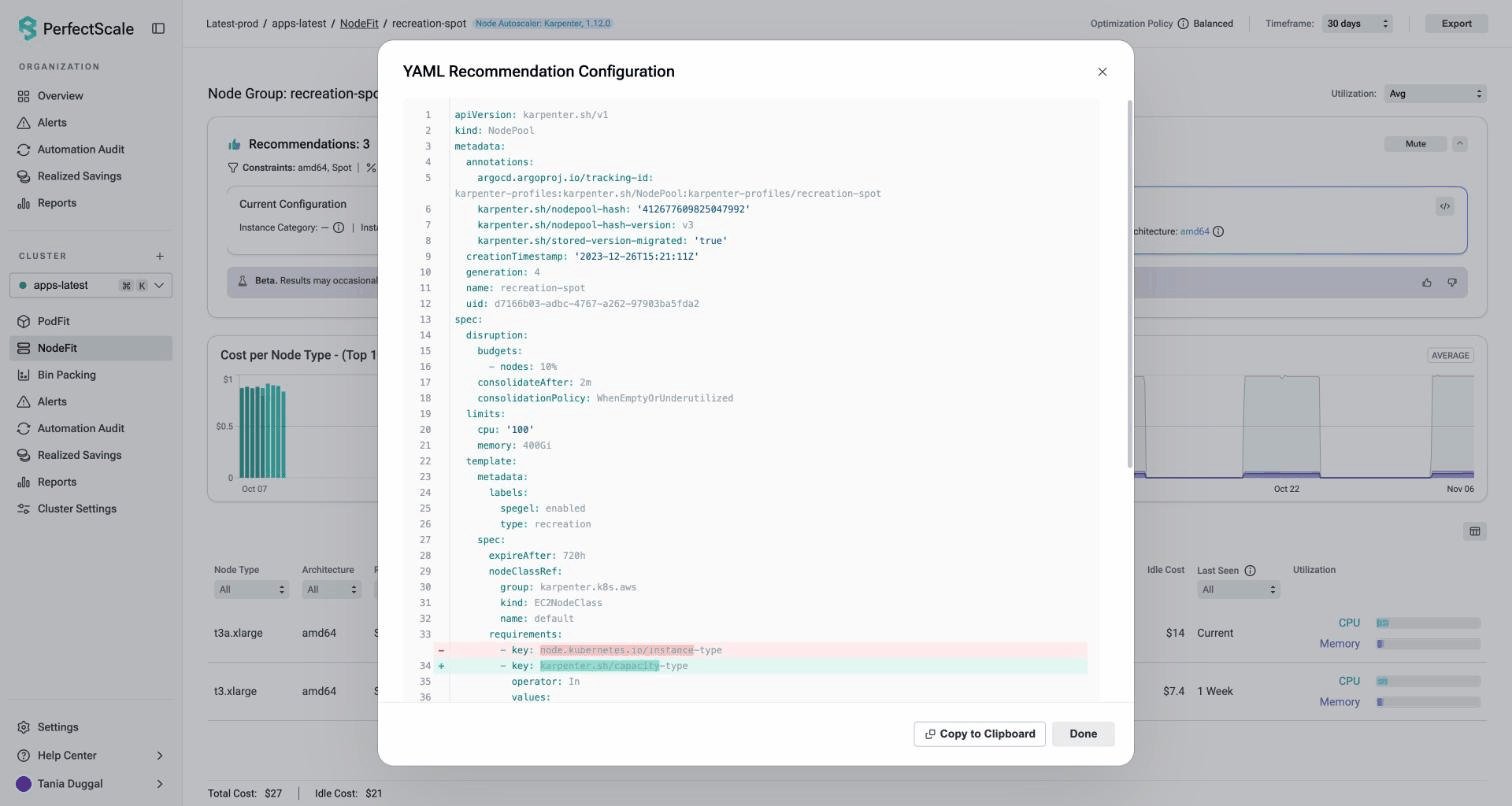
3. NodePool設定の推奨を受け取る: PerfectScaleは、Karpenterがノードを削除する速さを左右する設定について、Karpenter最適化の推奨を提供します。推奨によって次のことができます。
- 統合ポリシーと待機時間をレビューする。
- 新しいノードをプロビジョニングする際に、Karpenterにより多くのインスタンスの選択肢を与える。
- 新しいキャパシティの余地を狭めすぎているNodePoolのlimitsを見つける。
YAMLビューで現在の設定と推奨設定を確認でき、結果をコピーできます。
4. ノードの削除を妨げているPodを見つける: ビンパッキングビューは、どのPodがノードの削除を妨げているかを表示します。各Podについて、PerfectScaleは退避できない理由と修正方法を説明します。コスト影響順にランク付けされたYAML diffの推奨を提示し、それぞれに信頼度とリスクレベルが付いています。意図的なものについては、検出結果をミュートできます。
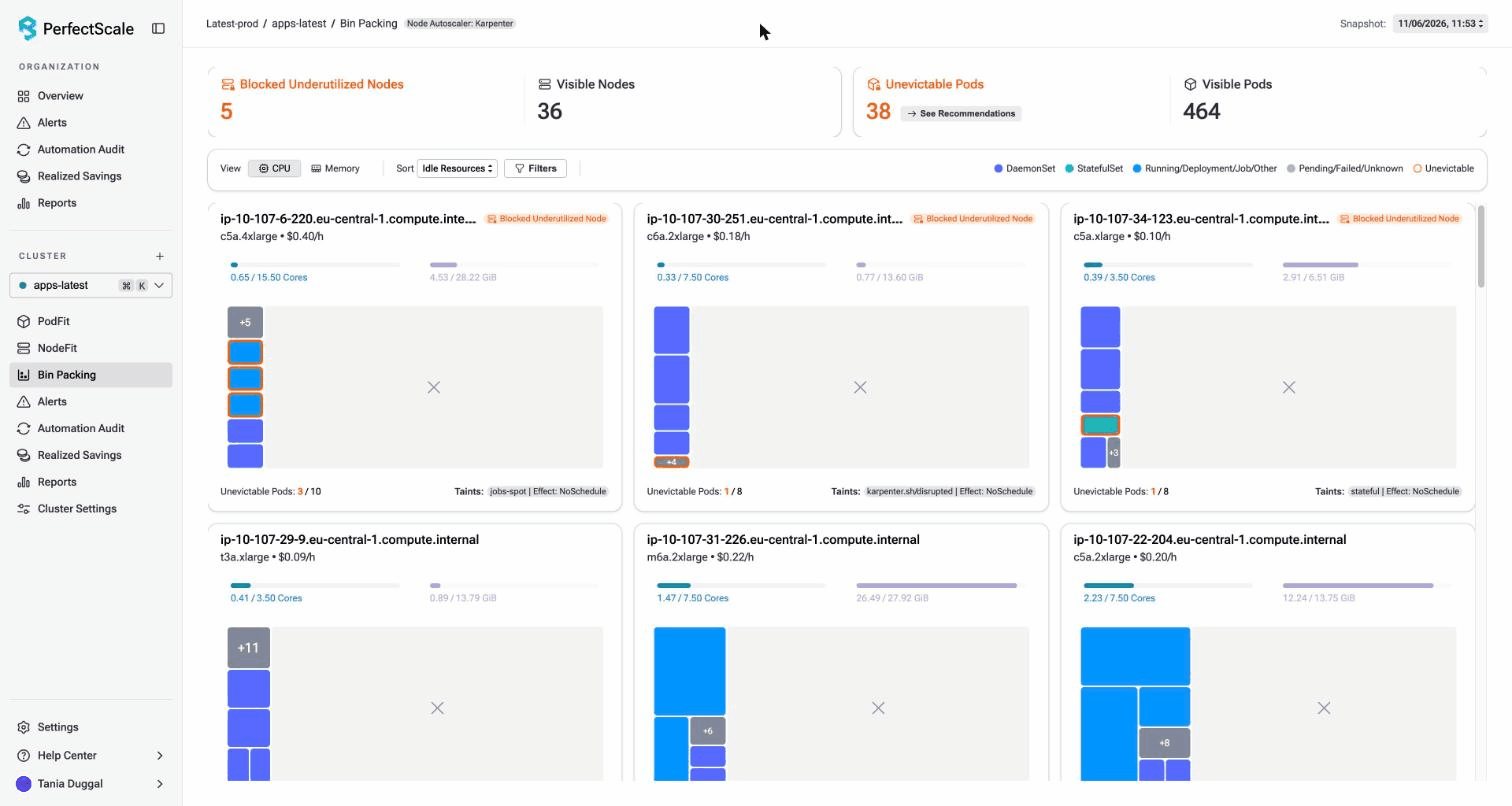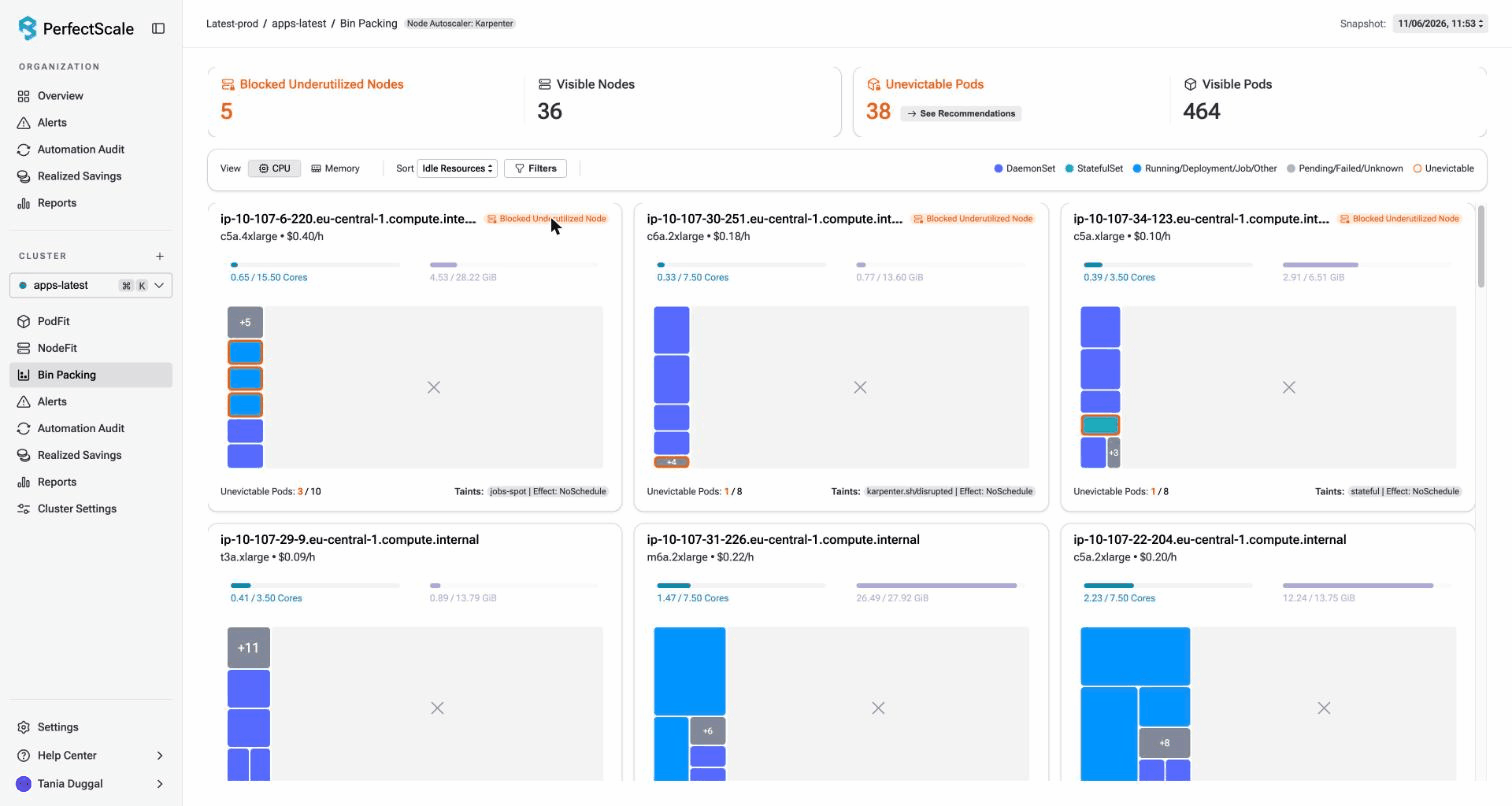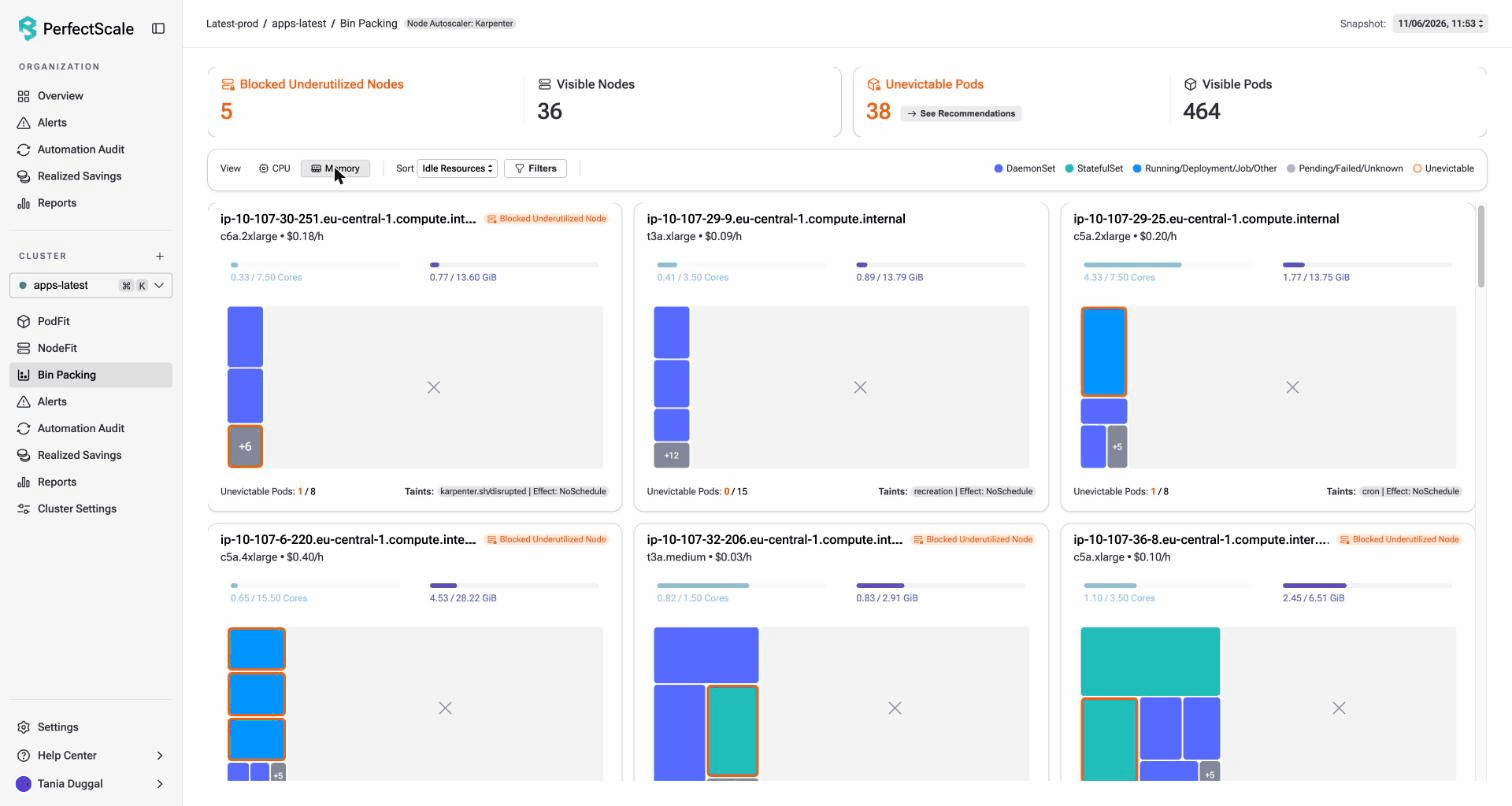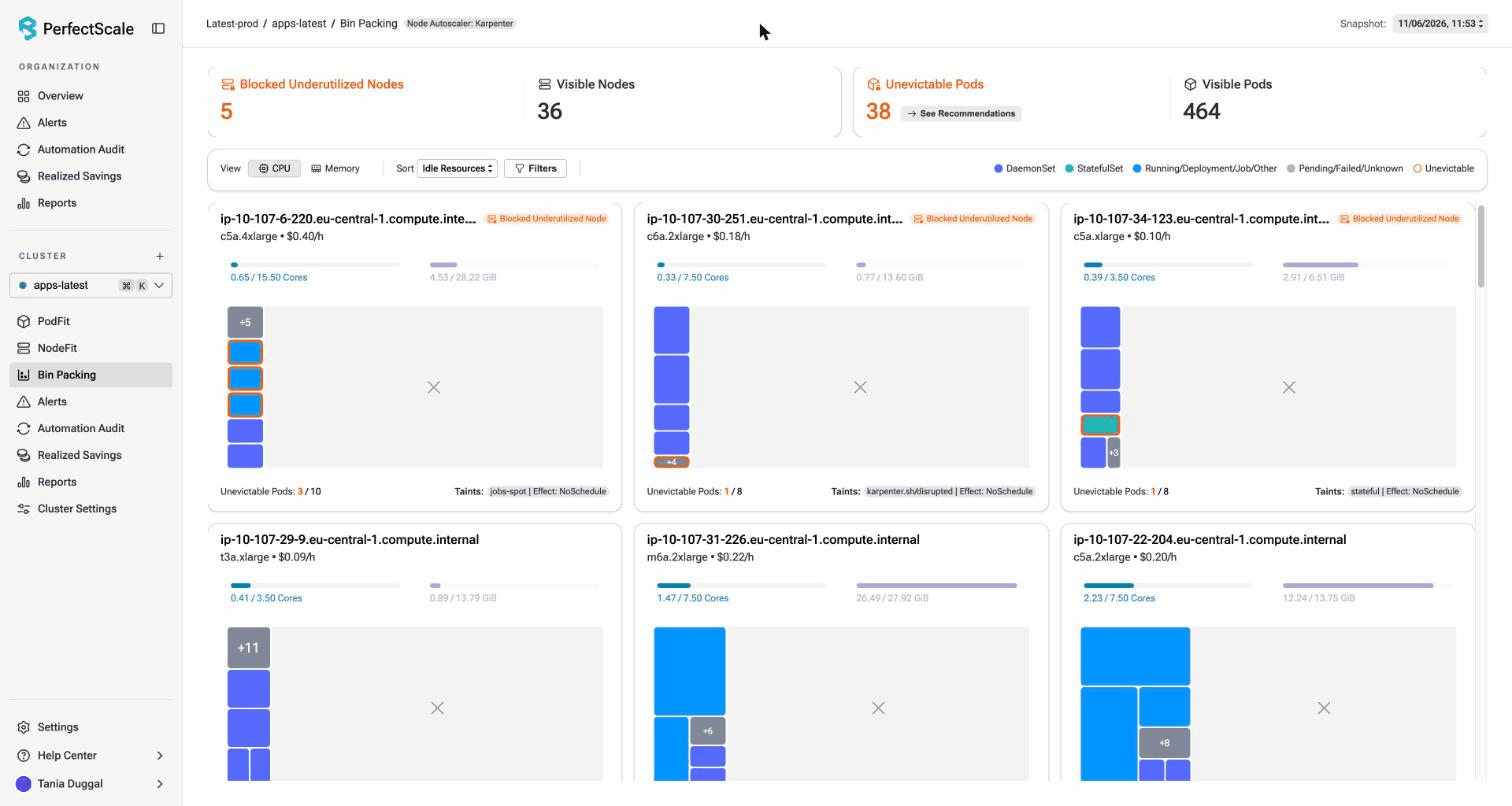
各チームはそれぞれ専用のリストを使えます。プラットフォームチームはNodePoolビューから、アプリケーションチームはPodから作業します。
Claudeのようなエージェントは、PerfectScale AIエージェントスキルを使ってPerfectScaleのデータをクエリすることもできます。変更のたびに、レビューで変更履歴を活用し、何が変わったか、次に何を自動化すべきかを確認してください。
実践チェックリスト
すべての変更でこれらのリストを使い、プルリクエストにコピーしてください。変更には3つの段階があり、それぞれに固有のチェックがあります。
変更前
変更を適用する前に、次のすべてが満たされている必要があります。
- Karpenterがそのノードを作成した。
- ブロッカーの種類が特定されている: NodePoolの制限またはワークロードのブロッカー。
- 1つのイベント、フィールド、またはアノテーションがブロッカーを裏付けている。
- 変更が触れるのは1つのフィールドまたは1つのオブジェクトのみである。
- そのオブジェクトの所有者が変更を承認した。
- budgetまたは時間枠によって、一度に移動できるノード数が制限されている。
- 変更をテストクラスタまたはサンドボックスのNodePoolで先に実行した。
- 取り消し手順と取り消す基準が文書化されている。
変更中
変更が終わるまで、別々のターミナルで次のwatchコマンドを実行します。
kubectl get nodeclaims -wkubectl get events -A --field-selector reason=DisruptionBlocked -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=Succeeded -w次のチェックは変更が終わるまで継続します。
- Karpenterのイベントに新しいブロッカーが表示されない。
- PodがPDBの許容するペースでノードから退避している。
- サービスのダッシュボードがサービスレベル目標(SLO)の範囲内に収まっている。
変更後
次のチェックで変更を完了します。
- ノード数が想定どおりである。
- 原因不明の待機や再起動をしているPodがない。
- 移動が必要なサービスについて、すべてのPDBのALLOWED値が0より大きい。
- 変更の記録が完全である。
エージェントがツリーを実行する様子をワークショップで
次にノードが残ったときは、最初の質問から始めてください。エージェントは最初のチェックを手伝ってくれます。イベント、設定、メトリクスを人間よりはるかに速く読めるからです。一方で、尋ねるたびに異なる答えを返すこともあります。だからこそ、すべての変更は人間がレビューし、本番環境での適用はエージェントではなく固定のルールが行うべきなのです。
ワークショップ Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling は、2026年11月17日 午前11時(米国東部時間)に開催されます。Vikram SeshadriとRamesh Mathikumarが、エージェントがこうしたイベントを読み取ってdiffの草案を作成する仕組みと、固定ルールが引き継ぐべきポイントを紹介します。ワークショップに申し込む。
稼働し続けるノードにお困りですか?私たちのチームが、ブロッカーの特定、変更のレビュー、そして信頼性を損なわないキャパシティの回収をお手伝いします。専門家に相談するか、無料で登録してご自身でお試しください。