
PerfectScale
Init Spike Handling: pods JVM con el tamaño justo en cada fase
Init Spike Handling asigna a los pods JVM recursos de arranque al iniciar y los redimensiona in-place para el estado estable. Menos pérdida, sin reinicios.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


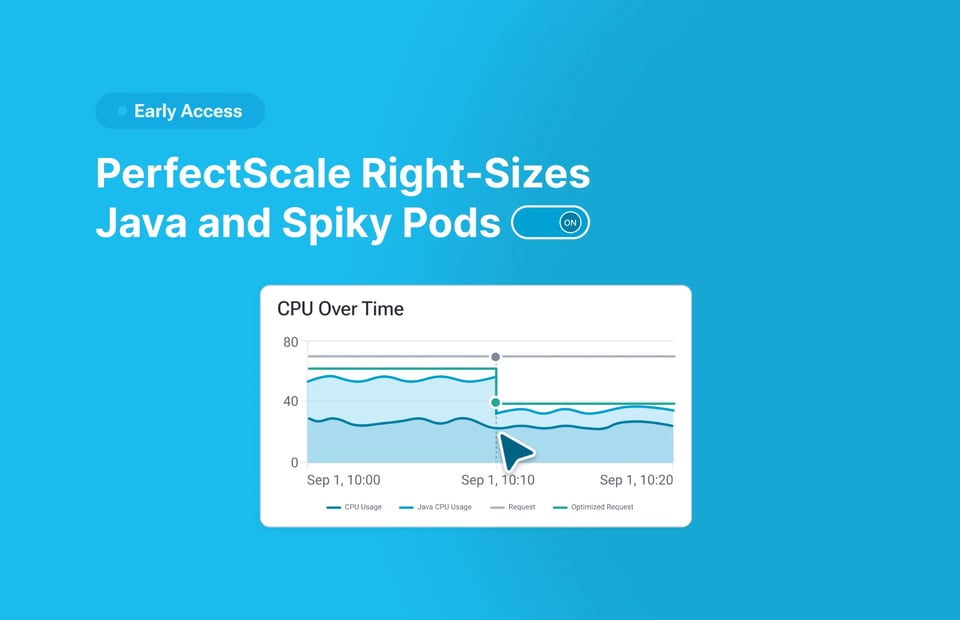
La mayoría de los pods JVM se dimensionan para los primeros dos minutos de su vida y luego funcionan sobredimensionados durante los dos meses siguientes. Si ejecutas Java en Kubernetes, conoces el dilema. La carga de clases, la compilación JIT y el calentamiento de cachés consumen mucho CPU y memoria durante el arranque. Una vez que el servicio está en marcha, la demanda cae y se mantiene baja. Eso significa que pagas los recursos del arranque en cada réplica, todo el tiempo. Si en cambio dimensionas para la demanda en estado estable, te arriesgas a throttling de CPU, OOM kills y los problemas que vienen con ellos.
PerfectScale ahora lo hace de otra manera. ¡Descubre cómo!
Una recomendación, dos perfiles de recursos
Una recomendación basada en el uso a largo plazo promedia el pico de arranque con todo lo que viene después. ¿El resultado? Resource requests demasiado altos para el estado estable, pero que aun así no cubren del todo las necesidades del arranque.
Los equipos suelen terminar eligiendo una de tres opciones:
- Sobreaprovisionar para el arranque: El enfoque más común. Evita problemas al arrancar, pero pagas esa capacidad extra en cada réplica, todo el tiempo.
- Ajustar los recursos a mano: Configurar por separado los recursos de arranque y de ejecución, y repetir el proceso cada vez que un release cambia el perfil del workload. Disponible con in-place resize, GA en Kubernetes v1.35+.
- Dimensionar para el estado estable y cruzar los dedos: Hasta que el throttling de CPU, los OOM kills o los arranques fallidos demuestren lo contrario. Ojalá sean los menos.
El problema no es el dimensionamiento en sí. El workload tiene dos perfiles de recursos distintos, mientras que la recomendación contempla solo uno.
Optimización autónoma de los recursos de arranque y de ejecución
PerfectScale identifica de forma continua los workloads con necesidades distintas de arranque y de ejecución, y propone recomendaciones de recursos separadas para cada fase:
- Fase de arranque (init). Se aplica al crear el pod, mediante el mutation hook que PerfectScale ya utiliza para inyectar los recursos recomendados. La recomendación de arranque se dimensiona según la más alta de las dos fases, para que el pod no se programe en un nodo que no pueda cubrir su arranque.
- Fase de estado estable (runtime). Una vez completada la fase de arranque, PerfectScale aplica la recomendación de runtime mediante in-place resize. Los recursos se ajustan en el Pod en ejecución, sin reinicios ni cambios manuales en los manifiestos.
PerfectScale se apoya en capacidades nativas de Kubernetes y usa la In-Place Pod Resize API (GA en v1.35) para aplicar las recomendaciones de recursos de runtime sin reiniciar los Pods. PerfectScale suma la inteligencia y la automatización para que la optimización de arranque y de ejecución funcione sin fricciones. Hace seguimiento del ciclo de vida de cada Pod y cambia automáticamente de los recursos de arranque a los de runtime cuando la fase de arranque termina. Si un Pod no puede redimensionarse de forma segura, PerfectScale recurre a una única recomendación de recursos para no afectar el workload.
Qué significa esto para ti
| Antes | Después |
|---|---|
| Pagas el pico de recursos del arranque durante toda la ejecución | El arranque recibe el pico y luego el pod se redimensiona a lo que necesita el estado estable |
| Dimensionar para el estado estable implica riesgo de throttling, OOM kills o arranques fallidos | La fase de arranque se dimensiona según la más alta de las dos fases |
| Ajuste manual de recursos de arranque vs. ejecución, que se rehace cada vez que cambian los workloads | Transición automática de init a runtime, sin reinicios ni pasos manuales |
| Riesgo de que un cambio automatizado rompa una JVM | Salvaguardas adaptadas a tu framework |
| Cambios automatizados en los que cuesta confiar | Cada cambio se registra por revisión del workload, con su impacto en uso, pérdida y ahorro |
Impacto:
- Tus workloads reciben los recursos que necesitan en cada etapa, así dejas de pagar la capacidad del arranque mucho después de que el arranque terminó.
- Es difícil confiar en una automatización que no se puede inspeccionar. PerfectScale registra los cambios de recursos entre revisiones del workload y muestra por separado los recursos de arranque y de estado estable en Podfit y Zoom-in.
- Los cálculos de costo, pérdida y ahorro reflejan las necesidades de recursos de cada fase, no un promedio único.
No es solo para Java
Cualquier workload con necesidades de recursos distintas entre el arranque y la ejecución puede beneficiarse de este enfoque. Algunos ejemplos comunes:
- JavaScript y TypeScript: durante el warmup del JIT de V8.
- Ruby on Rails y Django: mientras cargan frameworks y el estado de la aplicación.
- Tareas de init: migraciones de bases de datos, calentamiento de cachés y otras operaciones de arranque.
- Pruebas de estrés y de carga: cuando los workloads necesitan temporalmente más recursos durante la inicialización o el ramp-up de las pruebas.
PerfectScale detecta estos patrones y ajusta los recursos entre fases, con salvaguardas adicionales para frameworks como Java.
¿Quieres aprender a manejar Java y otros workloads con picos de forma más eficaz? Súmate a nuestro webinar para explorar los desafíos y ver cómo los aborda PerfectScale. Consulta los detalles y regístrate en el webinar aquí.