


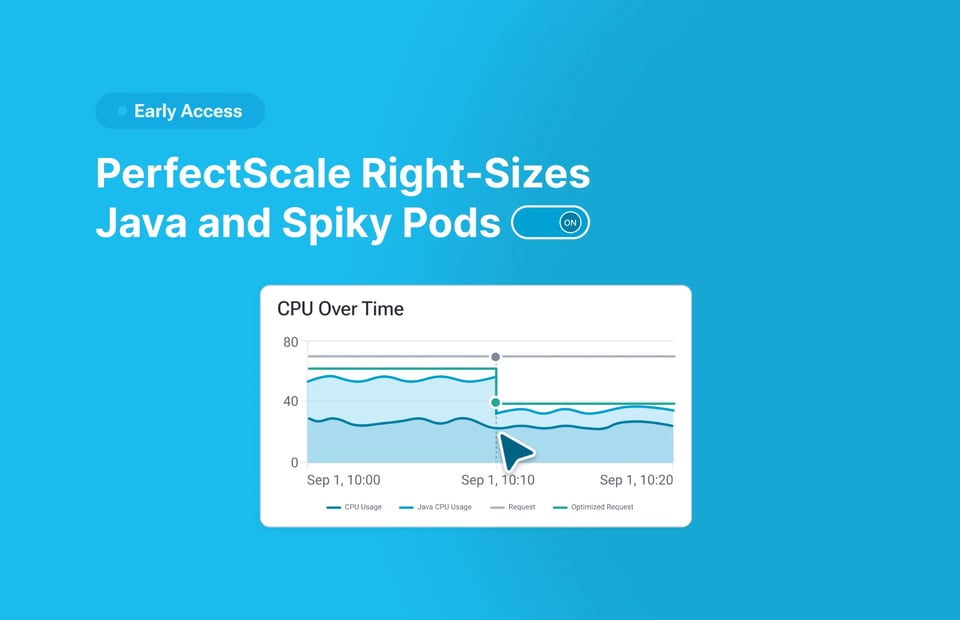
ほとんどのJVM Podは、起動直後の2分間に合わせてサイズ設定され、その後の2か月間は過剰なサイズのまま稼働し続けています。KubernetesでJavaを運用している方なら、このトレードオフをよくご存じでしょう。クラスのロード、JITコンパイル、キャッシュのウォームアップには、起動時に大量のCPUとメモリが必要です。サービスが立ち上がると需要は下がり、低い水準で推移します。つまり、すべてのレプリカで常に、起動時レベルのリソース分の料金を支払い続けることになります。かといって定常状態の需要に合わせてサイズ設定すれば、CPUスロットリングやOOM Kill、それに伴う問題のリスクを抱えることになります。
PerfectScaleは、この課題を新しいアプローチで解決します。その仕組みをご紹介します。
推奨値は1つ、リソースプロファイルは2つ
長期的な使用状況に基づく推奨値は、起動時のスパイクとその後のすべてを平均化してしまいます。その結果、定常状態には過剰なのに、起動時のニーズは十分にカバーできないリソースリクエストが出来上がります。
チームは通常、次の3つの選択肢のいずれかを選ぶことになります。
- 起動に合わせてオーバープロビジョニングする: 最も一般的なアプローチです。起動時の問題は回避できますが、その余剰キャパシティ分の料金をすべてのレプリカで常に支払うことになります。
- リソースを手動でチューニングする: 起動用とランタイム用のリソースを個別に調整し、リリースでワークロードのプロファイルが変わるたびに同じ作業を繰り返します。インプレースリサイズ(Kubernetes v1.35以降でGA)で利用可能です。
- 定常状態に合わせてサイズ設定し、あとは祈る: CPUスロットリング、OOM Kill、起動失敗が現実になるまでは。こうしたチームが少数派であることを願いたいところです。
問題はサイズ設定そのものではありません。ワークロードには2つの異なるリソースプロファイルがあるのに、推奨値は1つ分しか考慮していないことです。
起動時と実行時のリソースを自律的にライトサイジング
PerfectScaleは、起動時と実行時でニーズが異なるワークロードを継続的に特定し、フェーズごとに個別のリソース推奨値を提供します。
- 起動(init)フェーズ。Pod作成時に、PerfectScaleが推奨リソースの注入にすでに使用しているミューテーションフックを通じて適用されます。起動時の推奨値は2つのフェーズのうち高い方に合わせてサイズ設定されるため、起動時の需要をまかなえないノードにPodがスケジュールされることはありません。
- 定常状態(ランタイム)フェーズ。起動フェーズが完了すると、PerfectScaleはインプレースリサイズを使ってランタイムの推奨値を適用します。再起動や手動でのマニフェスト変更なしに、稼働中のPodのリソースが調整されます。
PerfectScaleはKubernetesのネイティブ機能を基盤とし、In-Place Pod Resize API(v1.35でGA)を利用して、Podを再起動せずにランタイムのリソース推奨値を適用します。PerfectScaleはそこにインテリジェンスと自動化を加え、起動時と実行時の最適化をシームレスに機能させます。各Podのライフサイクルを追跡し、起動フェーズの完了時に起動用リソースからランタイム用リソースへ自動的に切り替えます。Podを安全にリサイズできない場合は、ワークロードへの影響を避けるため、単一のリソース推奨値にフォールバックします。
これがもたらすメリット
| 導入前 | 導入後 |
|---|---|
| 起動時のピークリソース分を稼働時間全体にわたって支払い | 起動時にはピーク分を確保し、その後Podを定常状態に必要なサイズまで縮小 |
| 定常状態に合わせたサイズ設定では、スロットリング、OOM Kill、起動失敗のリスクあり | 起動フェーズは2つのフェーズのうち高い方に合わせてサイズ設定 |
| 起動用とランタイム用のリソースを手動でチューニングし、ワークロードが変わるたびにやり直し | initからランタイムへ自動で移行。再起動も手作業も不要 |
| 自動変更がJVMを壊すリスク | フレームワークに応じた安全ガードレール |
| 中身を検証できない自動変更は信頼しにくい | すべての変更をワークロードのリビジョンごとに追跡し、使用量・無駄・削減額への影響を可視化 |
導入効果:
- ワークロードは各段階で必要なリソースを確保できるため、起動完了後も起動時レベルのキャパシティに支払い続ける必要がなくなります。
- 中身を確認できない自動化は信頼しにくいものです。PerfectScaleはワークロードのリビジョンをまたいでリソース変更を追跡し、PodfitとZoom-inで起動時と定常状態のリソースを分けて表示します。
- コスト、無駄、削減額の計算には、単一の平均値ではなく、各フェーズのリソースニーズが反映されます。
Javaだけではありません
起動時と実行時でリソースニーズが異なるワークロードであれば、どれでもこのアプローチの恩恵を受けられます。代表的な例は次のとおりです。
- JavaScript・TypeScript: V8のJITウォームアップ中。
- Ruby on Rails・Django: フレームワークとアプリケーション状態のロード中。
- 初期化タスク: データベースマイグレーション、キャッシュのウォームアップ、その他の起動時処理。
- ストレステスト・負荷テスト: テストの初期化やランプアップ時に一時的に多くのリソースが必要になる場合。
PerfectScaleはこうしたパターンを検出し、フェーズ間でリソースを調整します。Javaなどのフレームワークには追加のセーフガードも適用されます。
Javaをはじめとするスパイクの大きいワークロードをより効果的に扱う方法を知りたい方は、ぜひウェビナーにご参加ください。課題を掘り下げながら、PerfectScaleのアプローチをご紹介します。詳細の確認と**ウェビナーへの登録**はこちらから。