
PerfectScale
Init Spike Handling: le risorse giuste per i pod JVM, dall'avvio al runtime
Init Spike Handling assegna ai pod JVM le risorse per l'avvio, poi le ridimensiona in-place per il regime. Meno sprechi al boot, senza riavvii.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


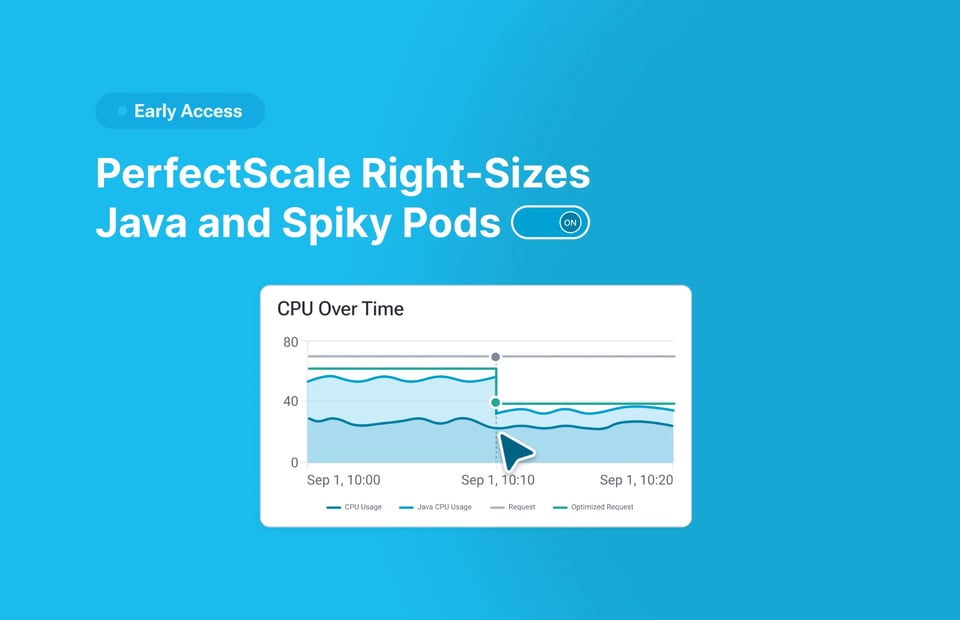
La maggior parte dei pod JVM viene dimensionata per i primi due minuti di vita e poi resta sovradimensionata per i due mesi successivi. Chi esegue Java su Kubernetes conosce bene il compromesso: il caricamento delle classi, la compilazione JIT e il cache warming richiedono molta CPU e memoria al boot. Una volta che il servizio è attivo, la domanda cala e rimane bassa. Risultato: si pagano risorse da avvio su ogni replica, sempre. Se invece si dimensiona per la domanda a regime, si rischiano throttling della CPU, OOM kill e tutti i problemi che ne derivano.
Con PerfectScale ora funziona diversamente. Scopra come!
Una raccomandazione, due profili di risorse
Una raccomandazione basata sull'utilizzo di lungo periodo fa la media tra il picco di avvio e tutto ciò che viene dopo. Il risultato? Resource request troppo alte per il regime, ma comunque insufficienti a coprire del tutto le esigenze dell'avvio.
Di solito i team finiscono per scegliere una di queste tre opzioni:
- Sovradimensionare per l'avvio: l'approccio più diffuso. Evita i problemi al boot, ma quella capacità extra si paga su ogni replica, sempre.
- Regolare le risorse manualmente: configurare separatamente le risorse di avvio e di runtime, e ripetere il processo ogni volta che una release cambia il profilo del workload. Possibile con l'in-place resize, GA in Kubernetes v1.35+.
- Dimensionare per il regime e sperare in bene: finché throttling della CPU, OOM kill o avvii falliti non dimostrano il contrario. Speriamo siano in pochi.
Il problema non è il dimensionamento in sé. Il workload ha due profili di risorse distinti, mentre la raccomandazione ne considera uno solo.
Right-sizing autonomo delle risorse di avvio e di runtime
PerfectScale identifica in modo continuo i workloads con esigenze diverse tra avvio e runtime e fornisce raccomandazioni di risorse separate per ciascuna fase:
- Fase di avvio (init). Applicata alla creazione del pod, tramite il mutation hook che PerfectScale usa già per iniettare le risorse raccomandate. La raccomandazione di avvio è dimensionata sulla più esigente delle due fasi, così il pod non viene schedulato su un nodo che non è in grado di coprirne il boot.
- Fase a regime (runtime). Completata la fase di avvio, PerfectScale applica la raccomandazione di runtime tramite in-place resize. Le risorse vengono adattate sul Pod in esecuzione, senza riavvii né modifiche manuali ai manifest.
PerfectScale si basa su funzionalità native di Kubernetes e usa la In-Place Pod Resize API (GA nella v1.35) per applicare le raccomandazioni di runtime senza riavviare i Pod. PerfectScale aggiunge l'intelligenza e l'automazione necessarie a far funzionare senza attriti l'ottimizzazione di avvio e runtime: traccia il ciclo di vita di ogni Pod e passa automaticamente dalle risorse di avvio a quelle di runtime quando la fase di avvio è completa. Se un Pod non può essere ridimensionato in sicurezza, PerfectScale ripiega su un'unica raccomandazione di risorse per non compromettere il workload.
Cosa cambia in pratica
| Prima | Dopo |
|---|---|
| Risorse di picco per l'avvio pagate per l'intero runtime | L'avvio riceve il picco, poi il pod viene ridimensionato su ciò che serve a regime |
| Il dimensionamento a regime rischia throttling, OOM kill o avvii falliti | La fase di avvio è dimensionata sulla più esigente delle due fasi |
| Regolazione manuale delle risorse di avvio e di runtime, da rifare quando i workloads cambiano | Transizione automatica da init a runtime, senza riavvii e senza passaggi manuali |
| Rischio che una modifica automatica comprometta una JVM | Guardrail di sicurezza basati sul framework in uso |
| Modifiche automatiche difficili da verificare | Ogni modifica è tracciata per revisione del workload, con il suo impatto su utilizzo, sprechi e risparmi |
Impatto:
- I workloads ricevono le risorse di cui hanno bisogno in ogni fase, così si smette di pagare capacità da avvio ben oltre la fase di boot.
- È difficile fidarsi di un'automazione che non si può ispezionare. PerfectScale traccia le modifiche alle risorse tra le revisioni del workload e mostra separatamente le risorse di avvio e a regime in Podfit e Zoom-in.
- I calcoli di costi, sprechi e risparmi riflettono le esigenze di risorse di ciascuna fase, non una singola media.
Non solo Java
Qualsiasi workload con esigenze di risorse diverse tra avvio e runtime può trarre vantaggio da questo approccio. Alcuni esempi comuni:
- JavaScript e TypeScript: durante il warmup del JIT di V8.
- Ruby on Rails e Django: durante il caricamento di framework e stato applicativo.
- Task di init: migrazioni di database, cache warming e altre operazioni di avvio.
- Stress test e load test: quando i workloads hanno temporaneamente bisogno di più risorse durante l'inizializzazione o il ramp-up dei test.
PerfectScale rileva questi pattern e adatta le risorse tra le fasi, con protezioni aggiuntive per framework come Java.
Vuole scoprire come gestire in modo più efficace Java e altri workloads con picchi? Partecipi al nostro webinar per approfondire le sfide e vedere come le affronta PerfectScale. Trova qui tutti i dettagli: si iscriva al webinar.