
PerfectScale
Init Spike Handling : des pods JVM bien dimensionnés, du démarrage au régime stable
Init Spike Handling alloue aux pods JVM des ressources de démarrage au boot, puis les redimensionne à chaud pour le régime stable. Réduisez le gaspillage lié au démarrage, sans aucun redémarrage.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


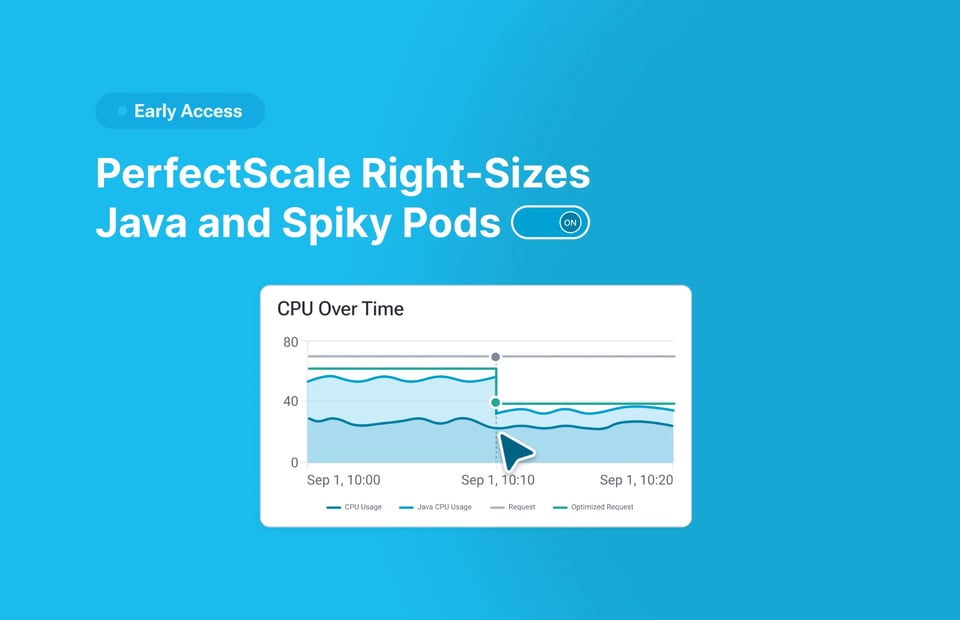
La plupart des pods JVM sont dimensionnés pour les deux premières minutes de leur vie, puis tournent surdimensionnés pendant les deux mois suivants. Si vous exécutez Java sur Kubernetes, vous connaissez le dilemme. Le chargement des classes, la compilation JIT et le préchauffage du cache exigent beaucoup de CPU et de mémoire au boot. Une fois le service lancé, la demande chute et reste basse. Résultat : vous payez des ressources de niveau démarrage sur chaque réplica, en permanence. Dimensionnez plutôt pour le régime stable, et vous vous exposez au throttling CPU, aux OOM kills et à tous les problèmes qui vont avec.
PerfectScale change désormais la donne. Découvrez comment !
Une recommandation, deux profils de ressources
Une recommandation basée sur des moyennes d'utilisation à long terme mélange le pic de démarrage avec tout ce qui suit. Résultat ? Des resource requests trop élevées pour le régime stable, mais qui ne couvrent toujours pas entièrement les besoins au démarrage.
Les équipes finissent généralement par choisir l'une de ces trois options :
- Surprovisionner pour le démarrage : l'approche la plus courante. Elle évite les problèmes au boot, mais vous payez cette capacité supplémentaire sur chaque réplica, en permanence.
- Ajuster les ressources manuellement : régler séparément les ressources de démarrage et d'exécution, puis recommencer à chaque release qui modifie le profil du workload. Possible avec le redimensionnement in-place, GA à partir de Kubernetes v1.35.
- Dimensionner pour le régime stable en croisant les doigts : jusqu'à ce que le throttling CPU, les OOM kills ou les échecs de démarrage prouvent le contraire. En espérant que cela reste rare.
Le problème ne vient pas du dimensionnement en lui-même. Le workload a deux profils de ressources distincts, alors que la recommandation n'en prend qu'un seul en compte.
Un right-sizing autonome des ressources de démarrage et d'exécution
PerfectScale identifie en continu les workloads dont les besoins diffèrent entre démarrage et exécution, et fournit des recommandations de ressources distinctes pour chaque phase :
- Phase de démarrage (init). Appliquée à la création du pod, via le mutation hook que PerfectScale utilise déjà pour injecter les ressources recommandées. La recommandation de démarrage est calée sur la plus gourmande des deux phases, afin que le pod ne soit pas planifié sur un nœud incapable de couvrir son boot.
- Phase d'exécution (régime stable). Une fois la phase de démarrage terminée, PerfectScale applique la recommandation d'exécution via le redimensionnement in-place. Les ressources sont ajustées sur le pod en cours d'exécution, sans redémarrage ni modification manuelle des manifestes.
PerfectScale s'appuie sur des capacités natives de Kubernetes, en utilisant l'API In-Place Pod Resize (GA en v1.35) pour appliquer les recommandations de ressources d'exécution sans redémarrer les pods. PerfectScale y ajoute l'intelligence et l'automatisation nécessaires pour que l'optimisation du démarrage et de l'exécution fonctionne en toute transparence. Il suit le cycle de vie de chaque pod et bascule automatiquement des ressources de démarrage vers les ressources d'exécution une fois la phase de démarrage terminée. Si un pod ne peut pas être redimensionné en toute sécurité, PerfectScale revient à une recommandation de ressources unique pour ne pas perturber le workload.
Ce que cela change pour vous
| Avant | Après |
|---|---|
| Des ressources de pic de démarrage payées pendant toute la durée d'exécution | Le démarrage reçoit le pic, puis le pod est redimensionné à la baisse selon les besoins du régime stable |
| Un dimensionnement au régime stable qui expose au throttling, aux OOM kills ou aux échecs de démarrage | La phase de démarrage est calée sur la plus gourmande des deux phases |
| Un réglage manuel des ressources de démarrage et d'exécution, à refaire à chaque évolution des workloads | Une transition automatique de l'init à l'exécution, sans redémarrage ni étape manuelle |
| Le risque qu'un changement automatisé casse une JVM | Des garde-fous adaptés à votre framework |
| Des changements automatisés difficiles à vérifier | Chaque changement est tracé par révision de workload, avec son impact sur l'utilisation, le gaspillage et les économies |
Impact :
- Vos workloads reçoivent les ressources dont ils ont besoin à chaque étape : vous ne payez plus une capacité de niveau démarrage longtemps après le boot.
- Une automatisation impossible à inspecter inspire difficilement confiance. PerfectScale trace les changements de ressources d'une révision de workload à l'autre et affiche séparément les ressources de démarrage et de régime stable dans Podfit et Zoom-in.
- Les calculs de coûts, de gaspillage et d'économies reflètent les besoins en ressources de chaque phase, et non une moyenne unique.
Pas seulement pour Java
Tout workload dont les besoins en ressources diffèrent entre démarrage et exécution peut bénéficier de cette approche. Exemples courants :
- JavaScript et TypeScript : pendant le warmup JIT de V8.
- Ruby on Rails et Django : lors du chargement des frameworks et de l'état applicatif.
- Tâches d'init : migrations de base de données, préchauffage du cache et autres opérations de démarrage.
- Tests de stress et de charge : quand les workloads ont temporairement besoin de plus de ressources pendant l'initialisation des tests ou la montée en charge.
PerfectScale détecte ces patterns et ajuste les ressources entre les phases, avec des garde-fous supplémentaires pour des frameworks comme Java.
Envie de gérer plus efficacement Java et les autres workloads sujets aux pics ? Participez à notre webinar pour explorer ces défis et découvrir l'approche de PerfectScale. Consultez les détails et inscrivez-vous au webinar ici.