
PerfectScale
Init Spike Handling: JVM-Pods richtig dimensionieren – beim Start und im Betrieb
Init Spike Handling gibt JVM-Pods beim Start mehr Ressourcen und passt sie danach ohne Neustart an den Steady State an. Weniger Waste durch Boot-Spitzen.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


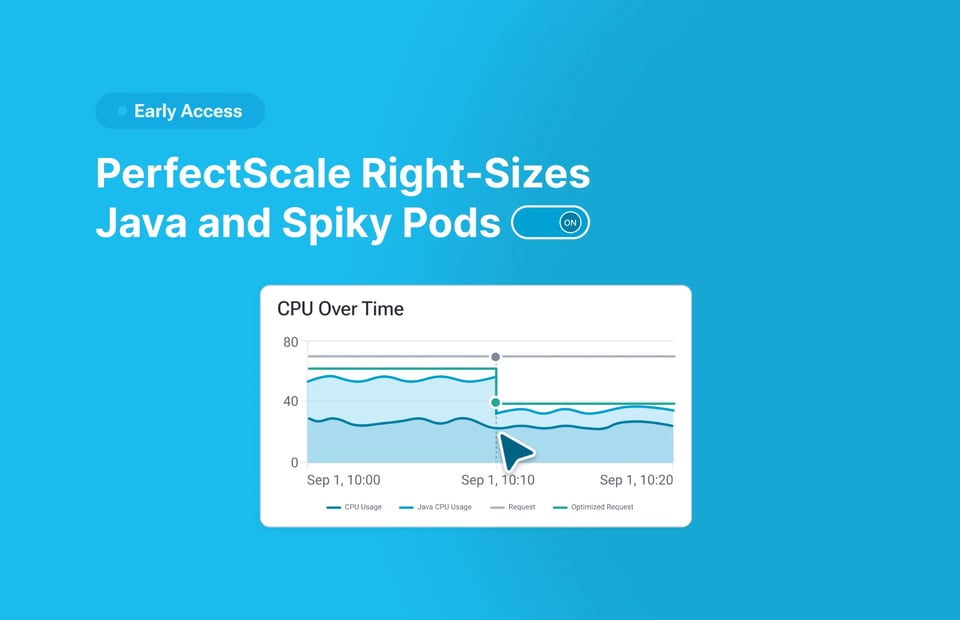
Die meisten JVM-Pods sind für die ersten zwei Minuten ihres Lebens dimensioniert – und laufen danach zwei Monate lang überdimensioniert weiter. Wenn Sie Java auf Kubernetes betreiben, kennen Sie den Zielkonflikt. Class Loading, JIT-Kompilierung und Cache-Warming benötigen beim Start viel CPU und Speicher. Sobald der Service läuft, sinkt der Bedarf und bleibt niedrig. Das heißt: Sie zahlen auf jedem Replikat dauerhaft für Ressourcen auf Start-Niveau. Dimensionieren Sie stattdessen für den Steady State, riskieren Sie CPU-Throttling, OOM-Kills und alle Probleme, die damit einhergehen.
PerfectScale geht jetzt anders vor. So funktioniert es!
Eine Empfehlung, zwei Ressourcenprofile
Eine Empfehlung auf Basis langfristiger Nutzungsdaten mittelt die Startspitze mit allem, was danach kommt. Das Ergebnis? Resource Requests, die für den Steady State zu hoch sind und den Startbedarf trotzdem nicht vollständig abdecken.
Teams entscheiden sich in der Regel für eine von drei Optionen:
- Für den Start überdimensionieren: Der häufigste Ansatz. Er vermeidet Startprobleme, aber Sie zahlen für die zusätzliche Kapazität auf jedem Replikat – rund um die Uhr.
- Ressourcen manuell tunen: Start- und Laufzeitressourcen separat anpassen und den Prozess bei jedem Release wiederholen, das das Workload-Profil verändert. Möglich mit In-Place Resize, GA ab Kubernetes v1.35.
- Für den Steady State dimensionieren und auf das Beste hoffen: Bis CPU-Throttling, OOM-Kills oder fehlgeschlagene Starts das Gegenteil beweisen. Hoffentlich bleibt das die Ausnahme.
Das Problem ist nicht die Dimensionierung an sich. Der Workload hat zwei unterschiedliche Ressourcenprofile – die Empfehlung berücksichtigt aber nur eines.
Autonomes Right-Sizing für Start- und Laufzeitressourcen
PerfectScale identifiziert kontinuierlich Workloads mit unterschiedlichem Start- und Laufzeitbedarf und liefert für jede Phase eine eigene Ressourcenempfehlung:
- Startphase (Init). Wird beim Erstellen des Pods angewendet – über den Mutation Hook, den PerfectScale bereits zum Injizieren empfohlener Ressourcen nutzt. Die Startempfehlung orientiert sich an der höheren der beiden Phasen, damit der Pod nicht auf einem Node landet, der den Boot nicht abdecken kann.
- Steady-State-Phase (Laufzeit). Sobald die Startphase abgeschlossen ist, wendet PerfectScale die Laufzeitempfehlung per In-Place Resize an. Die Ressourcen werden am laufenden Pod angepasst – ohne Neustart und ohne manuelle Änderungen am Manifest.
PerfectScale setzt auf native Kubernetes-Funktionen und nutzt die In-Place Pod Resize API (GA in v1.35), um Laufzeitempfehlungen ohne Pod-Neustart anzuwenden. PerfectScale steuert die Intelligenz und Automatisierung bei, damit Start- und Laufzeitoptimierung nahtlos zusammenspielen. Die Lösung verfolgt den Lebenszyklus jedes Pods und wechselt automatisch von Start- zu Laufzeitressourcen, sobald die Startphase abgeschlossen ist. Kann ein Pod nicht sicher angepasst werden, greift PerfectScale auf eine einzelne Ressourcenempfehlung zurück, um den Workload nicht zu beeinträchtigen.
Was das für Sie bedeutet
| Vorher | Nachher |
|---|---|
| Ressourcen auf Startspitzen-Niveau werden über die gesamte Laufzeit bezahlt | Der Start bekommt die Spitze, danach wird der Pod auf den Steady-State-Bedarf angepasst |
| Dimensionierung für den Steady State riskiert Throttling, OOM-Kills oder fehlgeschlagene Starts | Die Startphase ist auf die höhere der beiden Phasen dimensioniert |
| Manuelles Tuning von Start- vs. Laufzeitressourcen, bei jeder Workload-Änderung aufs Neue | Automatischer Übergang von Init zu Laufzeit – ohne Neustart und ohne manuellen Schritt |
| Risiko, dass eine automatisierte Änderung eine JVM lahmlegt | Sicherheitsmechanismen passend zu Ihrem Framework |
| Automatisierte Änderungen, denen man schwer vertrauen kann | Jede Änderung wird pro Workload-Revision nachverfolgt – inklusive ihrer Auswirkungen auf Nutzung, Waste und Einsparungen |
Das Ergebnis:
- Ihre Workloads erhalten in jeder Phase genau die Ressourcen, die sie brauchen – Sie zahlen nicht länger für Kapazität auf Start-Niveau, die nach dem Boot niemand mehr nutzt.
- Automatisierung, die sich nicht nachvollziehen lässt, schafft kein Vertrauen. PerfectScale verfolgt Ressourcenänderungen über Workload-Revisionen hinweg und zeigt Start- und Steady-State-Ressourcen getrennt in Podfit und Zoom-in an.
- Kosten-, Waste- und Einsparungsberechnungen spiegeln den Ressourcenbedarf jeder Phase wider – nicht einen einzelnen Durchschnittswert.
Nicht nur für Java
Jeder Workload mit unterschiedlichem Start- und Laufzeitbedarf kann von diesem Ansatz profitieren. Typische Beispiele:
- JavaScript und TypeScript: während des V8-JIT-Warmups.
- Ruby on Rails und Django: beim Laden von Frameworks und Anwendungszustand.
- Init-Tasks: Datenbankmigrationen, Cache-Warming und andere Startoperationen.
- Stresstests und Lasttests: wenn Workloads während der Testinitialisierung oder der Ramp-up-Phase vorübergehend mehr Ressourcen benötigen.
PerfectScale erkennt diese Muster und passt die Ressourcen zwischen den Phasen an – mit zusätzlichen Schutzmechanismen für Frameworks wie Java.
Sie möchten erfahren, wie Sie Java und andere Workloads mit Lastspitzen effizienter in den Griff bekommen? In unserem Webinar beleuchten wir die Herausforderungen und zeigen, wie PerfectScale sie löst. Alle Details finden Sie hier – jetzt zum Webinar anmelden.