


Cos'è Karpenter?
Karpenter è un cluster autoscaler Kubernetes open source, flessibile e ad alte prestazioni sviluppato da AWS. Migliora la disponibilità delle applicazioni e l'efficienza del cluster avviando rapidamente risorse di compute right-sized in risposta alle variazioni di domanda dei workloads.
A differenza degli autoscaler tradizionali, che si basano su gruppi di nodi predefiniti o su una pianificazione statica della capacità, Karpenter avvia e termina i nodi in modo dinamico in base alle esigenze in tempo reale dei workloads. Questo approccio consente ai cluster di scalare rapidamente quando la domanda aumenta e di ridursi con la stessa efficienza quando le risorse non servono più.
Vantaggi principali:
- Scaling rapido: esegue il provisioning dei nodi di compute in pochi secondi anziché in minuti, riducendo drasticamente la latenza di scheduling dei pod.
- Ottimizzazione dei costi: analizza automaticamente i prezzi delle diverse famiglie di istanze e sceglie tra capacità On-Demand e Spot per ridurre i costi di compute. I Savings Plans e le Reserved Instances si applicano automaticamente a livello di fatturazione AWS, indipendentemente dalle istanze di cui Karpenter esegue il provisioning.
- Niente gruppi di nodi: elimina l'onere operativo di gestire Auto Scaling Group (ASG) o Managed Node Group rigidi e predefiniti.
- Flessibilità dinamica delle istanze: prende in considerazione in modo trasparente centinaia di tipi di istanza AWS diversi per individuare il footprint di compute più efficiente per il cluster.
Perché usare Karpenter su AWS?
Scaling rapido
Karpenter consente ai cluster Kubernetes di rispondere alle variazioni della domanda più velocemente degli autoscaler tradizionali. Quando vengono schedulati nuovi pod e i nodi esistenti non dispongono delle risorse per ospitarli, Karpenter esegue il provisioning di nuove istanze EC2 su misura per i requisiti del workload. Questo riduce i tempi di attesa dei pod in pending e abbassa la latenza delle applicazioni. La velocità di scaling è preziosa per workloads con pattern di traffico imprevedibili o variabili, dove uno scaling lento può portare a un degrado del servizio.
Come ci riesce: Il vantaggio in termini di velocità deriva dall'interazione diretta di Karpenter con le API AWS e dalla sua capacità di aggirare i limiti dei gruppi di nodi. Invece di attendere policy di scaling o aggiustamenti incrementali, Karpenter avvia ciò che serve nel momento in cui serve.
Ottimizzazione dei costi
Karpenter migliora l'efficienza dei costi prendendo decisioni sui tipi e sulle dimensioni delle istanze di cui esegue il provisioning. Invece di utilizzare un insieme limitato di tipi di nodo predefiniti, valuta le opzioni di istanze EC2 disponibili, incluse le istanze Spot e On-Demand, per trovare la combinazione più conveniente per il workload. Questa selezione dinamica riduce l'overprovisioning e aiuta i team a evitare di pagare per capacità inutilizzata.
Come ci riesce: Karpenter può sfruttare i modelli di prezzo di AWS. Grazie al supporto delle istanze Spot, consente ai cluster di beneficiare di costi di compute ridotti quando i workloads tollerano le interruzioni.
Niente gruppi di nodi
Karpenter elimina la necessità di gestire gruppi di nodi, requisito indispensabile per gli autoscaler Kubernetes tradizionali. I gruppi di nodi richiedono configurazione e manutenzione manuali, inclusi limiti di scaling, tipi di istanza e strategie di aggiornamento. Con Karpenter si definiscono requisiti di alto livello, ed è Karpenter stesso ad avviare e terminare i nodi in risposta alle esigenze dei workloads. Questo riduce l'onere operativo, soprattutto in ambienti grandi o complessi.
Perché è utile: Senza i vincoli dei gruppi di nodi, Karpenter consente uno scaling più granulare. Può combinare tipi e dimensioni di istanza secondo necessità, supportando una gamma più ampia di workloads e ottimizzando prestazioni e costi.
Flessibilità dinamica delle istanze
Karpenter può scegliere tra l'intera gamma di tipi di istanza EC2 al momento dell'avvio, senza essere limitato a quelli specificati nei gruppi di nodi. Si adatta ai cambiamenti di disponibilità e prezzi su AWS e all'evoluzione dei requisiti dei workloads. Se determinati tipi di istanza diventano non disponibili o meno convenienti, Karpenter sceglie un'altra opzione.
Perché è utile: Questa flessibilità avvantaggia i workloads con requisiti di risorse eterogenei o mutevoli. Ad esempio, i job di elaborazione dati possono richiedere nodi ad alta memoria un giorno e nodi ad alta CPU il giorno successivo. Karpenter può eseguire il provisioning del tipo di istanza appropriato per ogni scenario, riducendo gli sprechi e migliorando le prestazioni del cluster.
Come funziona Karpenter con Amazon EKS
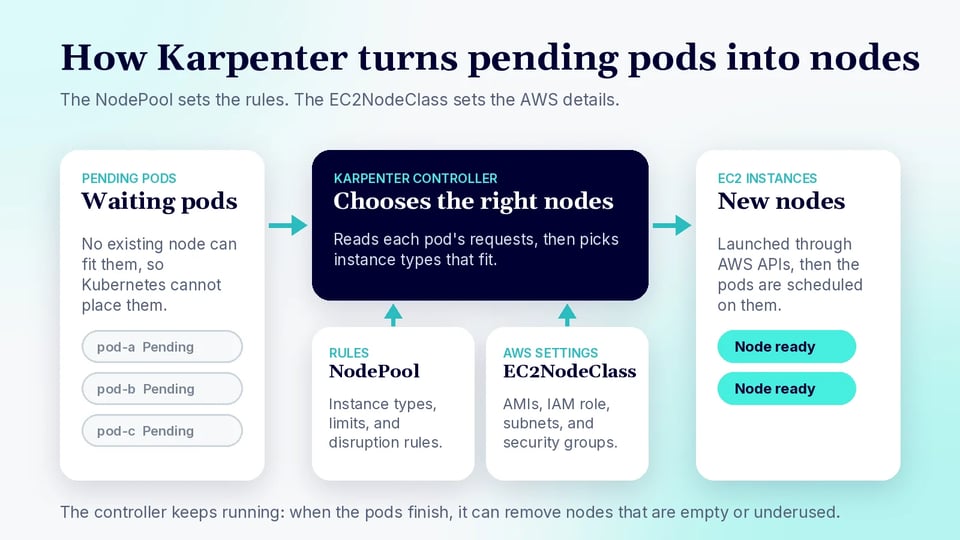
Karpenter si integra con Amazon Elastic Kubernetes Service (EKS) per fornire il provisioning dei nodi per i workloads Kubernetes su AWS:
- Viene eseguito come controller all'interno del cluster EKS e monitora i pod non schedulabili. Quando Kubernetes non riesce a collocare un pod per mancanza di capacità di compute, Karpenter valuta le richieste di risorse del pod e avvia istanze EC2 che soddisfano tali requisiti.
- L'integrazione con EKS opera in parallelo allo scheduler di Kubernetes. Kubernetes tenta prima di schedulare i pod sui nodi esistenti. Se non esiste capacità adeguata, Karpenter rileva i pod in pending ed esegue il provisioning di nuovi worker node.
- Una volta che le nuove istanze sono pronte e registrate nel cluster, i pod vengono schedulati e avviati.
- Karpenter utilizza le API AWS per individuare e avviare istanze EC2. Invece di affidarsi a gruppi di autoscaling fissi, seleziona tra i tipi di istanza disponibili in base ai vincoli definiti dagli amministratori. Questi vincoli possono includere architettura CPU, famiglia di istanze, availability zone, tipo di capacità o preferenze di prezzo.
Negli ambienti Amazon EKS, Karpenter lavora con due risorse personalizzate: NodePool ed EC2NodeClass:
- Un NodePool definisce i requisiti di scheduling e scaling, come tipi di istanza, taint, limiti e policy di disruption.
- Una EC2NodeClass definisce le impostazioni infrastrutturali specifiche di AWS, tra cui AMI, ruoli IAM, subnet e security group.
Insieme, queste risorse separano il comportamento di scheduling di Kubernetes dalla configurazione dell'infrastruttura AWS.
Grazie all'integrazione con AWS, Karpenter può utilizzare istanze Spot, più availability zone e tipi di istanza basati su Graviton. Questo consente ai cluster EKS di sfruttare un mix di risorse di compute più ampio ed economicamente più efficiente.
Casi d'uso comuni di Karpenter su AWS
1. Autoscaling dei microservizi su EKS
Karpenter è adatto all'autoscaling dei microservizi distribuiti su Amazon EKS. I microservizi presentano spesso pattern di carico variabili e richiedono scaling rapido. Karpenter esegue il provisioning di istanze EC2 per accogliere i nuovi pod quando la domanda aumenta e termina i nodi superflui quando il traffico diminuisce. In questo modo i microservizi ricevono le risorse di cui hanno bisogno senza aggiustamenti manuali né overprovisioning.
2. Workloads batch e basati su code
I workloads batch e basati su code richiedono spesso picchi di compute per brevi periodi, seguiti da fasi di inattività. Lo scaling rapido di Karpenter supporta questi scenari. Quando una coda di job si riempie o viene attivata un'elaborazione batch, Karpenter esegue il provisioning dei nodi di compute necessari a gestire il carico. Al completamento dei job, riduce le dimensioni del cluster e rilascia le risorse inutilizzate.
3. Workloads di elaborazione dati
I workloads di elaborazione dati, come pipeline di analytics, ETL o machine learning, traggono vantaggio dalla capacità di Karpenter di eseguire il provisioning di risorse di compute on demand. Questi workloads hanno spesso requisiti specifici di CPU, memoria o GPU che variano in base al job. Karpenter valuta queste esigenze e avvia i tipi di istanza EC2 appropriati. Al completamento dei job, Karpenter dismette i nodi inutilizzati, prevenendo gli sprechi di risorse.
4. Ottimizzazione dei costi per cluster EKS multi-tenant
I cluster EKS multi-tenant devono spesso bilanciare efficienza delle risorse e isolamento dei tenant. Karpenter alloca le risorse di compute in base ai pattern di utilizzo. Quando i tenant richiedono più capacità, esegue il provisioning di istanze aggiuntive; quando la domanda cala, rilascia le risorse. Karpenter può inoltre applicare policy di separazione tramite taint, toleration o regole di affinity. Questo aiuta i team di piattaforma a gestire i costi mantenendo i confini tra i tenant.
Karpenter vs. Kubernetes Cluster Autoscaler su AWS
Karpenter e Kubernetes Cluster Autoscaler aggiungono entrambi capacità di compute quando i pod non possono essere schedulati, ma utilizzano modelli di scaling diversi.
Cluster Autoscaler lavora con gruppi di nodi esistenti, come i managed node group di Amazon EKS o gli Auto Scaling group. Aumenta o riduce le dimensioni di tali gruppi in base ai pod in pending e ai nodi inutilizzati. Funziona bene quando i workloads rientrano in un numero ridotto di tipi di nodo noti. È prevedibile e ampiamente utilizzato, ma spesso richiede un'attenta pianificazione: i team devono definire i gruppi di nodi, impostare dimensioni minime e massime e decidere quali tipi di istanza utilizzare per ciascun gruppo.
Karpenter non richiede gruppi di nodi predefiniti. Esegue invece il provisioning di istanze EC2 in base ai requisiti dei pod in pending. Questo gli consente di scegliere tra una gamma più ampia di tipi di istanza e opzioni di capacità al momento del provisioning. Karpenter è adatto agli ambienti in cui i requisiti dei workloads cambiano spesso. Può selezionare i nodi in base a CPU, memoria, architettura, availability zone e tipo di capacità.
Il compromesso principale è tra controllo e flessibilità:
- Cluster Autoscaler utilizza un modello basato su gruppi di nodi fissi.
- Karpenter offre un provisioning più dinamico ma richiede ai team di gestire risorse specifiche come NodePool ed EC2NodeClass.
Contenuti correlati: per un confronto più approfondito, consulti la nostra guida Karpenter vs. Cluster Autoscaler.
Tutorial: primi passi con Karpenter su AWS
Questo tutorial mostra come creare un cluster Amazon EKS, installare Karpenter, definire un NodePool predefinito e testare il provisioning automatico dei nodi. Il flusso utilizza eksctl, kubectl, helm e la AWS CLI.
Step 1: prima di iniziare, installare gli strumenti richiesti:
aws --versionkubectl version --clienteksctl versionhelm versionKarpenter ha bisogno di permessi AWS per poter avviare e terminare istanze EC2. In questa configurazione, tali permessi vengono associati al service account di Karpenter tramite pod identity.
Step 2: iniziare impostando le principali variabili d'ambiente:
export KARPENTER_NAMESPACE="kube-system"export KARPENTER_VERSION="1.14.0"export K8S_VERSION="1.36"export AWS_PARTITION="aws"export CLUSTER_NAME="${USER}-karpenter-demo"export AWS_DEFAULT_REGION="us-west-2"export AWS_ACCOUNT_ID="$(aws sts get-caller-identity --query Account --output text)"export TEMPOUT="$(mktemp)"Queste variabili vengono riutilizzate dai comandi successivi. CLUSTER_NAME identifica il cluster EKS, mentre AWS_ACCOUNT_ID viene utilizzato per la creazione di ruoli e policy IAM.
Step 3: recuperare quindi gli ID delle AMI Amazon Linux 2 consigliate per la versione di Kubernetes:
export ARM_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2-arm64/recommended/image_id \  --query Parameter.Value --output text)"
export AMD_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2/recommended/image_id \  --query Parameter.Value --output text)"
Karpenter utilizza queste AMI quando crea i nodi EC2. Salvarle in variabili rende più semplice riutilizzarle nella successiva definizione della EC2NodeClass.
Step 4: creare l'infrastruttura AWS di supporto e il cluster EKS:
curl -fsSL https://raw.githubusercontent.com/aws/karpenter-provider-aws/v"${KARPENTER_VERSION}"/website/content/en/preview/getting-started/getting-started-with-karpenter/cloudformation.yaml > "${TEMPOUT}"
aws cloudformation deploy \  --stack-name "Karpenter-${CLUSTER_NAME}" \  --template-file "${TEMPOUT}" \  --capabilities CAPABILITY_NAMED_IAM \  --parameter-overrides "ClusterName=${CLUSTER_NAME}"
Questo stack CloudFormation crea le risorse AWS necessarie a Karpenter, inclusi i permessi IAM per il provisioning dei nodi.
Step 5: creare ora il cluster EKS:
eksctl create cluster -f - <<EOFapiVersion: eksctl.io/v1alpha5kind: ClusterConfigmetadata:  name: ${CLUSTER_NAME}  region: ${AWS_DEFAULT_REGION}  version: "${K8S_VERSION}"  tags:    karpenter.sh/discovery: ${CLUSTER_NAME}
iam:  withOIDC: true  podIdentityAssociations:  - namespace: "${KARPENTER_NAMESPACE}"    serviceAccountName: karpenter    roleName: ${CLUSTER_NAME}-karpenter    permissionPolicyARNs:    - arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:policy/KarpenterControllerPolicy-${CLUSTER_NAME}
iamIdentityMappings:- arn: "arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:role/KarpenterNodeRole-${CLUSTER_NAME}"  username: system:node:{{EC2PrivateDNSName}}  groups:  - system:bootstrappers  - system:nodes
managedNodeGroups:- instanceType: m5.large  amiFamily: AmazonLinux2023  name: ${CLUSTER_NAME}-ng  desiredCapacity: 2  minSize: 1  maxSize: 10
addons:- name: eks-pod-identity-agentEOF
Questo crea un piccolo managed node group per eseguire i componenti di sistema e Karpenter stesso. Il cluster viene taggato con karpenter.sh/discovery, che Karpenter utilizzerà in seguito per individuare subnet e security group.
Step 6: installare Karpenter con Helm:
helm registry logout public.ecr.aws
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \  --version "${KARPENTER_VERSION}" \  --namespace "${KARPENTER_NAMESPACE}" \  --create-namespace \  --set "settings.clusterName=${CLUSTER_NAME}" \  --set "settings.interruptionQueue=${CLUSTER_NAME}" \  --set controller.resources.requests.cpu=1 \  --set controller.resources.requests.memory=1Gi \  --set controller.resources.limits.cpu=1 \  --set controller.resources.limits.memory=1Gi \  --wait
Questo comando distribuisce il controller Karpenter nel cluster. Il controller monitora i pod che Kubernetes non riesce a schedulare e chiama poi le API AWS per creare istanze EC2 adeguate.
Step 7: creare quindi un NodePool e una EC2NodeClass predefiniti:
cat <<EOF | envsubst | kubectl apply -f -apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: kubernetes.io/arch operator: In values: ["amd64"] - key: kubernetes.io/os operator: In values: ["linux"] - key: karpenter.sh/capacity-type operator: In values: ["on-demand"] - key: karpenter.k8s.aws/instance-category operator: In values: ["c", "m", "r"] nodeClassRef: group: karpenter.k8s.aws kind: EC2NodeClass name: default expireAfter: 720h limits: cpu: 1000 disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m---apiVersion: karpenter.k8s.aws/v1kind: EC2NodeClassmetadata: name: defaultspec: amiFamily: AL2023 role: "KarpenterNodeRole-${CLUSTER_NAME}" subnetSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" securityGroupSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" amiSelectorTerms: - id: "${AMD_AMI_ID}"EOFIl NodePool definisce quali nodi Karpenter è autorizzato a creare. In questo esempio, consente istanze Linux amd64 On-Demand delle famiglie compute, general-purpose e memory-optimized.
La EC2NodeClass contiene le impostazioni specifiche di AWS. Indica a Karpenter quali ruolo IAM, subnet, security group e AMI utilizzare per l'avvio dei nodi.
Step 8: per testare lo scaling, creare un deployment con zero repliche:
cat <<EOF | kubectl apply -f -apiVersion: apps/v1kind: Deploymentmetadata: name: inflatespec: replicas: 0 selector: matchLabels: app: inflate template: metadata: labels: app: inflate spec: terminationGracePeriodSeconds: 0 containers: - name: inflate image: public.ecr.aws/eks-distro/kubernetes/pause:3.7 resources: requests: cpu: 1EOFQuesto deployment utilizza l'immagine pause, molto leggera. Ogni replica richiede una CPU, il che lo rende utile per testare il provisioning dei nodi.
Step 9: scalare il deployment per generare pod non schedulabili:
kubectl scale deployment inflate --replicas 5Karpenter dovrebbe rilevare i pod in pending e creare nuovi nodi EC2. È possibile seguire i log del controller con:
kubectl logs -f -n "${KARPENTER_NAMESPACE}" \ -l app.kubernetes.io/name=karpenter \ -c controllerAl termine del test, eliminare il deployment:
kubectl delete deployment inflatePoiché il NodePool utilizza WhenEmptyOrUnderutilized, Karpenter può rimuovere i nodi vuoti o sottoutilizzati dopo la consolidation. Questo aiuta a ridurre i costi quando i workloads non hanno più bisogno della capacità aggiuntiva.
Step 10: per ripulire l'ambiente demo, rimuovere Karpenter ed eliminare il cluster:
helm uninstall karpenter --namespace "${KARPENTER_NAMESPACE}"
aws cloudformation delete-stack \  --stack-name "Karpenter-${CLUSTER_NAME}"
eksctl delete cluster --name "${CLUSTER_NAME}"
Questo rimuove le principali risorse create durante il tutorial e aiuta a evitare costi AWS aggiuntivi.
Best practice per Karpenter su AWS
Ecco alcune pratiche utili da considerare quando si utilizza Karpenter su AWS.
1. Fissare le AMI in produzione
Negli ambienti di produzione, evitare di affidarsi ad AMI selezionate automaticamente. Fissare invece ID di AMI specifici nelle definizioni delle EC2NodeClass. Questo dà ai team il controllo sull'immagine del sistema operativo utilizzata per i worker node e riduce il rischio di cambiamenti imprevisti causati dal rilascio di nuove AMI. Le AMI fissate migliorano inoltre la coerenza tra gli ambienti e semplificano il troubleshooting.
Azioni consigliate:
- I team possono convalidare patch di sicurezza, container runtime e compatibilità con Kubernetes prima di distribuire gli aggiornamenti.
- Testare le nuove AMI in ambienti non di produzione prima di aggiornare i NodePool di produzione.
- Mantenere un processo documentato di aggiornamento delle AMI che includa revisioni di sicurezza, procedure di rollback e tracciamento delle versioni.
2. Utilizzare i controlli di disruption
Karpenter include funzionalità di disruption e consolidation che aiutano a ridurre i costi sostituendo o rimuovendo i nodi sottoutilizzati. Sebbene queste capacità migliorino l'efficienza, una consolidation aggressiva può compromettere la disponibilità dei workloads se i nodi vengono terminati troppo rapidamente. I controlli di disruption consentono ai team di bilanciare ottimizzazione dei costi e stabilità delle applicazioni, regolando come e quando avvengono le sostituzioni dei nodi.
Azioni consigliate:
- Utilizzare le policy di consolidation insieme a pod disruption budget, topology spread constraint e priorità dei workloads.
- Per i servizi critici, valutare di aumentare i ritardi di consolidation o limitare le sostituzioni dei nodi durante l'orario lavorativo.
- Nei cluster di produzione, configurare con attenzione le impostazioni di disruption e consolidation per evitare interruzioni superflue dei workloads.
3. Separare i tipi di workload con i NodePool
Workloads diversi hanno spesso requisiti infrastrutturali diversi. Ad esempio, i workloads batch stateless possono girare su NodePool basati su Spot, mentre le applicazioni rivolte ai clienti possono utilizzare capacità On-Demand. Anche i workloads GPU, quelli basati su ARM e le applicazioni ad alta memoria possono utilizzare NodePool dedicati con vincoli di istanza specifici.
Azioni consigliate:
- Separare i workloads in NodePool dedicati in base a sensibilità ai costi, requisiti di prestazioni, architettura o tolleranza alle interruzioni.
- Utilizzare taint, toleration, node selector e regole di affinity per garantire che i workloads vengano schedulati sui NodePool appropriati.
- Applicare a ciascun NodePool policy di disruption, consolidation e tipo di capacità differenti, in base alle caratteristiche dei workloads.
4. Monitorare il comportamento di Karpenter
Monitorare Karpenter come qualsiasi altro componente del cluster. La visibilità sulle decisioni di provisioning, sugli eventi del ciclo di vita dei nodi e sugli esiti dello scheduling aiuta i team a individuare inefficienze, diagnosticare problemi e verificare che il comportamento di scaling sia in linea con i requisiti dei workloads. Un monitoraggio regolare aiuta inoltre a rilevare vincoli di capacità AWS, problemi di configurazione o un churn imprevisto dei nodi prima che impattino le applicazioni.
Azioni consigliate:
- Tracciare gli eventi di provisioning dei nodi, i tentativi di avvio falliti, l'attività di consolidation, i pod in pending e le interruzioni delle istanze EC2.
- Utilizzare Amazon CloudWatch, Prometheus e gli eventi Kubernetes per osservare il comportamento di Karpenter. Le metriche importanti includono latenza di provisioning, tempo di avvio dei nodi, ritardi di scheduling dei pod e churn dei nodi.
- Esaminare i log del controller per diagnosticare problemi relativi a permessi IAM, discovery delle subnet o tipi di istanza non disponibili.
5. Testare prima di abilitare policy aggressive
Funzionalità come consolidation aggressiva, scadenza rapida dei nodi o uso esteso di Spot possono ridurre i costi, ma rischiano di introdurre instabilità se non vengono testate. I workloads possono rispondere in modo diverso alle frequenti sostituzioni dei nodi, in particolare quelli con tempi di avvio lunghi, componenti stateful o requisiti stringenti di disponibilità. I test aiutano i team a comprendere l'impatto operativo prima di applicare queste impostazioni in produzione.
Azioni consigliate:
- Prima di abilitare queste impostazioni in produzione, convalidarle in ambienti non di produzione con workloads e pattern di scaling realistici.
- Prestare attenzione ai workloads con connessioni di lunga durata, tempi di avvio elevati o requisiti stringenti di disponibilità.
- Testare il comportamento delle applicazioni durante la sostituzione dei nodi, gli eventi di interruzione Spot e le operazioni di scale-down rapido.
Come PerfectScale massimizza l'autoscaling di Karpenter su AWS
Gli autoscaler di nodi come Karpenter e Cluster Autoscaler sono strumenti potenti per aumentare e ridurre il numero di nodi in base alla domanda, migliorando la disponibilità del cluster e riducendo i costi delle risorse inattive. Ma anche quando l'autoscaling è ben configurato, i team si scontrano spesso con tre problemi che ne compromettono l'efficacia: container sovradimensionati che sprecano capacità e costringono l'autoscaler ad avviare più nodi del necessario, container sottodimensionati che causano eviction dei pod e pressione sui nodi, e un bin-packing inefficiente che lascia risorse sottoutilizzate generando al contempo eventi di scaling superflui. PerfectScale risolve questi problemi applicando in autonomia il right-sizing dei workloads e offrendo una visibilità approfondita sull'efficienza a livello di nodo, così che Karpenter esegua il provisioning esattamente del compute di cui il cluster ha realmente bisogno.
Funzionalità chiave di PerfectScale:
- Correzione proattiva degli errori di configurazione: analizza continuamente i workloads per identificare e correggere errori di configurazione — come CPU Request Not Set, Memory Request Not Set e Memory Limit Not Set — prevenendo eviction imprevedibili, over-commitment dei nodi e autoscaling inefficiente.
- Right-sizing autonomo dei workloads: adegua istantaneamente le risorse dei workloads in base all'utilizzo effettivo e migliora il bin-packing dei pod per aumentare l'efficienza dell'autoscaling, il tutto senza interventi manuali.
- Massima efficienza dell'autoscaling: offre una visibilità eccezionale su costi e utilizzo dei gruppi di autoscaling e dei node pool, fa emergere le inefficienze e aiuta a selezionare i tipi di nodo ottimali per migliorare l'utilizzo, ottenere una distribuzione precisa delle risorse e massimizzare l'efficienza dei costi.
Vuole ottenere il massimo da Karpenter su AWS? Scopra come PerfectScale ottimizza in autonomia i workloads e l'autoscaling dei nodi nella pagina della soluzione di node autoscaling di PerfectScale.