


Was ist Karpenter?
Karpenter ist ein flexibler, leistungsstarker Open-Source-Cluster-Autoscaler für Kubernetes, entwickelt von AWS. Er verbessert die Verfügbarkeit von Anwendungen und die Effizienz des Clusters, indem er bei wechselnden Workload-Anforderungen schnell passgenau dimensionierte Compute-Ressourcen bereitstellt.
Im Gegensatz zu traditionellen Autoscalern, die auf vordefinierte Node Groups oder statische Kapazitätsplanung setzen, startet und beendet Karpenter Nodes dynamisch auf Basis der Echtzeit-Anforderungen Ihrer Workloads. So kann ein Cluster bei Lastspitzen schnell hochskalieren – und ebenso effizient wieder herunterskalieren, wenn Ressourcen nicht mehr benötigt werden.
Die wichtigsten Vorteile:
- Schnelles Scaling: Stellt Compute-Nodes in Sekunden statt Minuten bereit und reduziert so die Scheduling-Latenz von Pods drastisch.
- Kostenoptimierung: Analysiert automatisch die Preise verschiedener Instanzfamilien und wählt zwischen On-Demand- und Spot-Kapazität, um Compute-Kosten zu senken. Savings Plans und Reserved Instances greifen automatisch auf der AWS-Abrechnungsebene – unabhängig davon, welche Instanzen Karpenter bereitstellt.
- Keine Node Groups: Eliminiert den operativen Aufwand für starre, vordefinierte Auto Scaling Groups (ASGs) oder Managed Node Groups.
- Dynamische Instanzflexibilität: Berücksichtigt nahtlos Hunderte verschiedener AWS-Instanztypen, um den effizientesten Compute-Footprint für Ihren Cluster zu finden.
Warum Karpenter auf AWS einsetzen?
Schnelles Scaling
Mit Karpenter reagieren Kubernetes-Cluster schneller auf Nachfrageänderungen als mit traditionellen Autoscalern. Wenn neue Pods gescheduled werden und den bestehenden Nodes die nötigen Ressourcen fehlen, stellt Karpenter neue EC2-Instanzen bereit, die exakt auf die Anforderungen der Workloads zugeschnitten sind. Das verkürzt Wartezeiten für ausstehende Pods und senkt die Anwendungslatenz. Diese Geschwindigkeit ist besonders wertvoll für Workloads mit unvorhersehbaren oder schwankenden Traffic-Mustern, bei denen langsames Scaling zu Serviceeinbußen führen kann.
So wird das erreicht: Der Geschwindigkeitsvorteil entsteht durch die direkte Interaktion von Karpenter mit den AWS-APIs und dadurch, dass die Einschränkungen von Node Groups entfallen. Statt auf Skalierungsrichtlinien oder schrittweise Anpassungen zu warten, startet Karpenter genau das, was benötigt wird – genau dann, wenn es benötigt wird.
Kostenoptimierung
Karpenter verbessert die Kosteneffizienz durch gezielte Entscheidungen über die Instanztypen und -größen, die es bereitstellt. Statt auf eine begrenzte Auswahl vordefinierter Node-Typen zurückzugreifen, bewertet es die verfügbaren EC2-Instanzoptionen – einschließlich Spot- und On-Demand-Instanzen –, um eine kosteneffiziente Lösung für den jeweiligen Workload zu finden. Diese dynamische Auswahl reduziert Überprovisionierung und hilft Teams, nicht für ungenutzte Kapazität zu bezahlen.
So wird das erreicht: Karpenter kann die AWS-Preismodelle nutzen. Durch die Unterstützung von Spot-Instanzen profitieren Cluster überall dort von reduzierten Compute-Kosten, wo Workloads Unterbrechungen tolerieren.
Keine Node Groups
Karpenter macht die Verwaltung von Node Groups überflüssig, die traditionelle Kubernetes-Autoscaler voraussetzen. Node Groups erfordern manuelle Konfiguration und Pflege – inklusive Skalierungslimits, Instanztypen und Update-Strategien. Mit Karpenter definieren Sie Anforderungen auf hoher Ebene, und es startet und beendet Nodes je nach Workload-Bedarf. Das reduziert den operativen Aufwand, besonders in großen oder komplexen Umgebungen.
Warum das nützlich ist: Ohne die Einschränkungen von Node Groups ermöglicht Karpenter ein feingranulareres Scaling. Es kann Instanztypen und -größen nach Bedarf kombinieren, unterstützt damit ein breiteres Spektrum an Workloads und optimiert Performance und Kosten.
Dynamische Instanzflexibilität
Karpenter kann beim Start aus der gesamten Bandbreite der EC2-Instanztypen wählen, statt auf die in Node Groups definierten Typen beschränkt zu sein. Es passt sich an Veränderungen im AWS-Angebot, bei den Preisen und bei den Workload-Anforderungen an. Werden bestimmte Instanztypen nicht verfügbar oder weniger kosteneffizient, wählt Karpenter eine andere Option.
Warum das nützlich ist: Diese Flexibilität kommt Workloads mit vielfältigen oder wechselnden Ressourcenanforderungen zugute. Datenverarbeitungsjobs benötigen beispielsweise an einem Tag speicherintensive Nodes und am nächsten CPU-starke Nodes. Karpenter kann für jedes Szenario den passenden Instanztyp bereitstellen, reduziert so Verschwendung und verbessert die Cluster-Performance.
Wie Karpenter mit Amazon EKS zusammenarbeitet
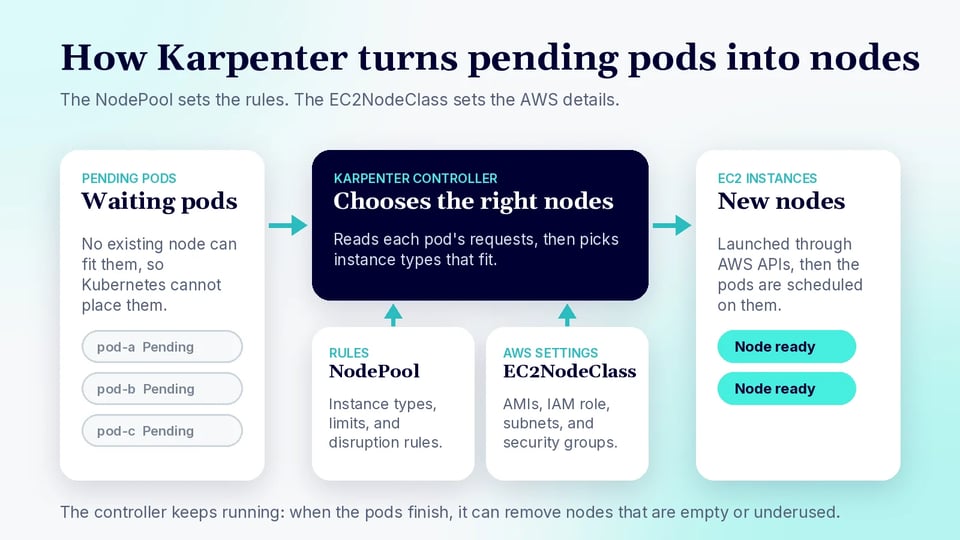
Karpenter integriert sich in Amazon Elastic Kubernetes Service (EKS) und übernimmt die Node-Bereitstellung für Kubernetes-Workloads auf AWS:
- Es läuft als Controller innerhalb des EKS-Clusters und beobachtet Pods, die nicht gescheduled werden können. Wenn Kubernetes einen Pod mangels Compute-Kapazität nicht platzieren kann, bewertet Karpenter die Ressourcenanforderungen des Pods und startet EC2-Instanzen, die diese Anforderungen erfüllen.
- Die Integration mit EKS arbeitet Hand in Hand mit dem Kubernetes-Scheduler. Kubernetes versucht zunächst, Pods auf bestehenden Nodes zu platzieren. Existiert keine passende Kapazität, erkennt Karpenter die wartenden Pods und stellt neue Worker-Nodes bereit.
- Sobald die neuen Instanzen bereit und im Cluster registriert sind, werden die Pods gescheduled und gestartet.
- Karpenter nutzt AWS-APIs, um EC2-Instanzen zu finden und zu starten. Statt sich auf feste Auto Scaling Groups zu verlassen, wählt es aus den verfügbaren Instanztypen auf Basis der von Administratoren definierten Vorgaben. Diese Vorgaben können CPU-Architektur, Instanzfamilie, Availability Zone, Kapazitätstyp oder Preispräferenzen umfassen.
In Amazon-EKS-Umgebungen arbeitet Karpenter mit zwei Custom Resources: NodePool und EC2NodeClass:
- Ein NodePool definiert Scheduling- und Skalierungsanforderungen wie Instanztypen, Taints, Limits und Disruption-Richtlinien.
- Eine EC2NodeClass definiert AWS-spezifische Infrastruktureinstellungen, darunter AMIs, IAM-Rollen, Subnetze und Security Groups.
Zusammen trennen diese Ressourcen das Kubernetes-Scheduling-Verhalten von der AWS-Infrastrukturkonfiguration.
Dank der AWS-Integration kann Karpenter Spot-Instanzen, mehrere Availability Zones und Graviton-basierte Instanztypen nutzen. So können EKS-Cluster auf einen breiteren und kosteneffizienteren Mix an Compute-Ressourcen zurückgreifen.
Typische Einsatzszenarien für Karpenter auf AWS
1. Autoscaling von Microservices auf EKS
Karpenter eignet sich hervorragend für das Autoscaling von Microservices auf Amazon EKS. Microservices unterliegen oft variablen Lastmustern und erfordern schnelles Scaling. Karpenter stellt bei steigender Nachfrage EC2-Instanzen für neue Pods bereit und beendet nicht mehr benötigte Nodes, wenn der Traffic sinkt. So erhalten Microservices die benötigten Ressourcen – ohne manuelle Eingriffe oder Überprovisionierung.
2. Batch- und Queue-basierte Workloads
Batch- und Queue-basierte Workloads benötigen oft kurzzeitig hohe Compute-Leistung, gefolgt von Leerlaufphasen. Das schnelle Scaling von Karpenter unterstützt genau diese Szenarien. Füllt sich eine Job-Queue oder wird ein Batch-Verarbeitungstask ausgelöst, stellt Karpenter Compute-Nodes für die Last bereit. Sind die Jobs abgeschlossen, skaliert es den Cluster herunter und gibt ungenutzte Ressourcen frei.
3. Datenverarbeitungs-Workloads
Datenverarbeitungs-Workloads wie Analytics, ETL oder Machine-Learning-Pipelines profitieren davon, dass Karpenter Compute-Ressourcen bedarfsgerecht bereitstellt. Diese Workloads haben oft spezifische CPU-, Speicher- oder GPU-Anforderungen, die je nach Job variieren. Karpenter bewertet diese Anforderungen und startet passende EC2-Instanztypen. Nach Abschluss der Jobs nimmt Karpenter ungenutzte Nodes außer Betrieb und verhindert so Ressourcenverschwendung.
4. Kostenoptimierung für Multi-Tenant-EKS-Cluster
Multi-Tenant-EKS-Cluster müssen oft Ressourceneffizienz und Mandantentrennung in Einklang bringen. Karpenter weist Compute-Ressourcen auf Basis der Nutzungsmuster zu. Benötigen Mandanten mehr Kapazität, stellt es zusätzliche Instanzen bereit; sinkt die Nachfrage, gibt es Ressourcen frei. Karpenter kann außerdem Trennungsrichtlinien über Taints, Tolerations oder Affinity-Regeln durchsetzen. Das hilft Plattform-Teams, Kosten zu steuern und gleichzeitig die Grenzen zwischen Mandanten zu wahren.
Karpenter vs. Kubernetes Cluster Autoscaler auf AWS
Karpenter und der Kubernetes Cluster Autoscaler fügen beide Compute-Kapazität hinzu, wenn Pods nicht gescheduled werden können – nutzen dafür aber unterschiedliche Skalierungsmodelle.
Der Cluster Autoscaler arbeitet mit bestehenden Node Groups, etwa Amazon EKS Managed Node Groups oder Auto Scaling Groups. Er vergrößert oder verkleinert diese Gruppen auf Basis wartender Pods und ungenutzter Nodes. Das funktioniert gut, wenn Workloads auf eine kleine Anzahl bekannter Node-Typen passen. Er ist vorhersehbar und weit verbreitet, erfordert aber oft sorgfältige Planung: Teams müssen Node Groups definieren, Minimal- und Maximalgrößen festlegen und entscheiden, welche Instanztypen jede Gruppe nutzen soll.
Karpenter benötigt keine vordefinierten Node Groups. Stattdessen stellt es EC2-Instanzen auf Basis der Anforderungen wartender Pods bereit. Dadurch kann es zum Zeitpunkt der Bereitstellung aus einer größeren Bandbreite an Instanztypen und Kapazitätsoptionen wählen. Karpenter eignet sich für Umgebungen, in denen sich die Workload-Anforderungen häufig ändern. Es kann Nodes nach CPU, Speicher, Architektur, Availability Zone und Kapazitätstyp auswählen.
Der zentrale Trade-off ist Kontrolle versus Flexibilität:
- Der Cluster Autoscaler nutzt ein Modell auf Basis fester Node Groups.
- Karpenter bietet eine dynamischere Bereitstellung, erfordert aber, dass Teams Karpenter-spezifische Ressourcen wie NodePool und EC2NodeClass verwalten.
Weiterführende Inhalte: Einen detaillierten Direktvergleich finden Sie in unserem Guide Karpenter vs. Cluster Autoscaler.
Tutorial: Erste Schritte mit Karpenter auf AWS
Dieses Tutorial zeigt, wie Sie einen Amazon-EKS-Cluster erstellen, Karpenter installieren, einen Standard-NodePool definieren und die automatische Node-Bereitstellung testen. Der Ablauf verwendet eksctl, kubectl, helm und die AWS CLI.
Schritt 1: Installieren Sie zunächst die benötigten Tools:
aws --versionkubectl version --clienteksctl versionhelm versionKarpenter benötigt AWS-Berechtigungen, um EC2-Instanzen starten und beenden zu können. In diesem Setup werden diese Berechtigungen über Pod Identity an den Karpenter-Service-Account gebunden.
Schritt 2: Setzen Sie als Erstes die wichtigsten Umgebungsvariablen:
export KARPENTER_NAMESPACE="kube-system"export KARPENTER_VERSION="1.14.0"export K8S_VERSION="1.36"export AWS_PARTITION="aws"export CLUSTER_NAME="${USER}-karpenter-demo"export AWS_DEFAULT_REGION="us-west-2"export AWS_ACCOUNT_ID="$(aws sts get-caller-identity --query Account --output text)"export TEMPOUT="$(mktemp)"Diese Variablen werden von späteren Befehlen wiederverwendet. CLUSTER_NAME identifiziert den EKS-Cluster, während AWS_ACCOUNT_ID beim Erstellen von IAM-Rollen und -Richtlinien verwendet wird.
Schritt 3: Rufen Sie als Nächstes die empfohlenen Amazon-Linux-2-AMI-IDs für die Kubernetes-Version ab:
export ARM_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2-arm64/recommended/image_id \  --query Parameter.Value --output text)"
export AMD_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2/recommended/image_id \  --query Parameter.Value --output text)"
Karpenter verwendet diese AMIs beim Erstellen von EC2-Nodes. Durch die Ablage in Variablen lässt sich die spätere EC2NodeClass-Definition leichter wiederverwenden.
Schritt 4: Erstellen Sie die unterstützende AWS-Infrastruktur und den EKS-Cluster:
curl -fsSL https://raw.githubusercontent.com/aws/karpenter-provider-aws/v"${KARPENTER_VERSION}"/website/content/en/preview/getting-started/getting-started-with-karpenter/cloudformation.yaml > "${TEMPOUT}"
aws cloudformation deploy \  --stack-name "Karpenter-${CLUSTER_NAME}" \  --template-file "${TEMPOUT}" \  --capabilities CAPABILITY_NAMED_IAM \  --parameter-overrides "ClusterName=${CLUSTER_NAME}"
Dieser CloudFormation-Stack erstellt die AWS-Ressourcen, die Karpenter benötigt – einschließlich der IAM-Berechtigungen für die Node-Bereitstellung.
Schritt 5: Erstellen Sie nun den EKS-Cluster:
eksctl create cluster -f - <<EOFapiVersion: eksctl.io/v1alpha5kind: ClusterConfigmetadata:  name: ${CLUSTER_NAME}  region: ${AWS_DEFAULT_REGION}  version: "${K8S_VERSION}"  tags:    karpenter.sh/discovery: ${CLUSTER_NAME}
iam:  withOIDC: true  podIdentityAssociations:  - namespace: "${KARPENTER_NAMESPACE}"    serviceAccountName: karpenter    roleName: ${CLUSTER_NAME}-karpenter    permissionPolicyARNs:    - arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:policy/KarpenterControllerPolicy-${CLUSTER_NAME}
iamIdentityMappings:- arn: "arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:role/KarpenterNodeRole-${CLUSTER_NAME}"  username: system:node:{{EC2PrivateDNSName}}  groups:  - system:bootstrappers  - system:nodes
managedNodeGroups:- instanceType: m5.large  amiFamily: AmazonLinux2023  name: ${CLUSTER_NAME}-ng  desiredCapacity: 2  minSize: 1  maxSize: 10
addons:- name: eks-pod-identity-agentEOF
Dies erstellt eine kleine Managed Node Group für die Systemkomponenten und Karpenter selbst. Der Cluster wird mit karpenter.sh/discovery getaggt, worüber Karpenter später Subnetze und Security Groups findet.
Schritt 6: Installieren Sie Karpenter mit Helm:
helm registry logout public.ecr.aws
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \  --version "${KARPENTER_VERSION}" \  --namespace "${KARPENTER_NAMESPACE}" \  --create-namespace \  --set "settings.clusterName=${CLUSTER_NAME}" \  --set "settings.interruptionQueue=${CLUSTER_NAME}" \  --set controller.resources.requests.cpu=1 \  --set controller.resources.requests.memory=1Gi \  --set controller.resources.limits.cpu=1 \  --set controller.resources.limits.memory=1Gi \  --wait
Damit wird der Karpenter-Controller im Cluster bereitgestellt. Der Controller beobachtet Pods, die Kubernetes nicht schedulen kann, und ruft dann AWS-APIs auf, um passende EC2-Instanzen zu erstellen.
Schritt 7: Erstellen Sie als Nächstes einen Standard-NodePool und eine EC2NodeClass:
cat <<EOF | envsubst | kubectl apply -f -apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: kubernetes.io/arch operator: In values: ["amd64"] - key: kubernetes.io/os operator: In values: ["linux"] - key: karpenter.sh/capacity-type operator: In values: ["on-demand"] - key: karpenter.k8s.aws/instance-category operator: In values: ["c", "m", "r"] nodeClassRef: group: karpenter.k8s.aws kind: EC2NodeClass name: default expireAfter: 720h limits: cpu: 1000 disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m---apiVersion: karpenter.k8s.aws/v1kind: EC2NodeClassmetadata: name: defaultspec: amiFamily: AL2023 role: "KarpenterNodeRole-${CLUSTER_NAME}" subnetSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" securityGroupSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" amiSelectorTerms: - id: "${AMD_AMI_ID}"EOFDer NodePool definiert, welche Nodes Karpenter erstellen darf. In diesem Beispiel sind Linux-amd64-On-Demand-Instanzen aus den Compute-, General-Purpose- und speicheroptimierten Familien erlaubt.
Die EC2NodeClass enthält AWS-spezifische Einstellungen. Sie teilt Karpenter mit, welche IAM-Rolle, Subnetze, Security Groups und AMIs beim Starten von Nodes zu verwenden sind.
Schritt 8: Erstellen Sie zum Testen des Scalings ein Deployment mit null Replicas:
cat <<EOF | kubectl apply -f -apiVersion: apps/v1kind: Deploymentmetadata: name: inflatespec: replicas: 0 selector: matchLabels: app: inflate template: metadata: labels: app: inflate spec: terminationGracePeriodSeconds: 0 containers: - name: inflate image: public.ecr.aws/eks-distro/kubernetes/pause:3.7 resources: requests: cpu: 1EOFDieses Deployment verwendet das leichtgewichtige Pause-Image. Jedes Replica fordert eine CPU an, was es für Tests der Node-Bereitstellung nützlich macht.
Schritt 9: Skalieren Sie das Deployment hoch, um Pods zu erzeugen, die nicht gescheduled werden können:
kubectl scale deployment inflate --replicas 5Karpenter sollte die wartenden Pods erkennen und neue EC2-Nodes erstellen. Die Controller-Logs verfolgen Sie mit:
kubectl logs -f -n "${KARPENTER_NAMESPACE}" \ -l app.kubernetes.io/name=karpenter \ -c controllerLöschen Sie das Deployment nach dem Test:
kubectl delete deployment inflateDa der NodePool WhenEmptyOrUnderutilized verwendet, kann Karpenter leere oder wenig ausgelastete Nodes nach der Konsolidierung entfernen. Das senkt die Kosten, wenn Workloads die zusätzliche Kapazität nicht mehr benötigen.
Schritt 10: Um die Demo-Umgebung aufzuräumen, entfernen Sie Karpenter und löschen den Cluster:
helm uninstall karpenter --namespace "${KARPENTER_NAMESPACE}"
aws cloudformation delete-stack \  --stack-name "Karpenter-${CLUSTER_NAME}"
eksctl delete cluster --name "${CLUSTER_NAME}"
Damit werden die wichtigsten im Tutorial erstellten Ressourcen entfernt und zusätzliche AWS-Kosten vermieden.
Best Practices für Karpenter auf AWS
Hier einige Best Practices für den Einsatz von Karpenter auf AWS.
1. AMIs in der Produktion fest pinnen
Verlassen Sie sich in Produktionsumgebungen nicht auf automatisch ausgewählte AMIs. Pinnen Sie stattdessen konkrete AMI-IDs in Ihren EC2NodeClass-Definitionen. Das gibt Teams die Kontrolle über das Betriebssystem-Image der Worker-Nodes und reduziert das Risiko unerwarteter Änderungen durch neue AMI-Releases. Gepinnte AMIs verbessern außerdem die Konsistenz über Umgebungen hinweg und vereinfachen das Troubleshooting.
To-dos:
- Teams können Sicherheitspatches, Container-Runtimes und Kubernetes-Kompatibilität validieren, bevor Updates ausgerollt werden.
- Testen Sie neue AMIs in Nicht-Produktionsumgebungen, bevor Sie Produktions-NodePools aktualisieren.
- Pflegen Sie einen dokumentierten AMI-Update-Prozess mit Sicherheitsreviews, Rollback-Verfahren und Versionsverfolgung.
2. Disruption-Kontrollen nutzen
Karpenter bietet Disruption- und Konsolidierungsfunktionen, die durch das Ersetzen oder Entfernen wenig ausgelasteter Nodes Kosten senken. Diese Funktionen steigern zwar die Effizienz, aber eine zu aggressive Konsolidierung kann die Workload-Verfügbarkeit beeinträchtigen, wenn Nodes zu schnell beendet werden. Mit Disruption-Kontrollen balancieren Teams Kostenoptimierung und Anwendungsstabilität, indem sie steuern, wie und wann Nodes ersetzt werden.
To-dos:
- Nutzen Sie Konsolidierungsrichtlinien zusammen mit Pod Disruption Budgets, Topology Spread Constraints und Workload-Prioritäten.
- Erwägen Sie für kritische Services längere Konsolidierungsverzögerungen oder begrenzen Sie Node-Ersetzungen während der Geschäftszeiten.
- Konfigurieren Sie in Produktionsclustern Disruption- und Konsolidierungseinstellungen mit Bedacht, um unnötige Workload-Unterbrechungen zu vermeiden.
3. Workload-Typen mit NodePools trennen
Unterschiedliche Workloads haben oft unterschiedliche Infrastrukturanforderungen. Stateless-Batch-Workloads können beispielsweise auf Spot-basierten NodePools laufen, während kundennahe Anwendungen On-Demand-Kapazität nutzen. Auch GPU-Workloads, ARM-basierte Workloads und speicherintensive Anwendungen können dedizierte NodePools mit spezifischen Instanz-Constraints verwenden.
To-dos:
- Trennen Sie Workloads anhand von Kostensensitivität, Performance-Anforderungen, Architektur oder Unterbrechungstoleranz in dedizierte NodePools.
- Nutzen Sie Taints, Tolerations, Node Selectors und Affinity-Regeln, damit Workloads auf die passenden NodePools gescheduled werden.
- Wenden Sie je nach Workload-Charakteristik unterschiedliche Disruption-, Konsolidierungs- und Kapazitätstyp-Richtlinien pro NodePool an.
4. Das Verhalten von Karpenter überwachen
Überwachen Sie Karpenter wie jede andere Cluster-Komponente. Einblick in Bereitstellungsentscheidungen, Node-Lifecycle-Events und Scheduling-Ergebnisse hilft Teams, Ineffizienzen zu identifizieren, Probleme zu diagnostizieren und zu überprüfen, ob das Skalierungsverhalten den Workload-Anforderungen entspricht. Regelmäßiges Monitoring deckt zudem AWS-Kapazitätsengpässe, Konfigurationsprobleme oder unerwartete Node-Fluktuation auf, bevor sie Anwendungen beeinträchtigen.
To-dos:
- Verfolgen Sie Node-Bereitstellungs-Events, fehlgeschlagene Starts, Konsolidierungsaktivitäten, wartende Pods und EC2-Instanzunterbrechungen.
- Nutzen Sie Amazon CloudWatch, Prometheus und Kubernetes-Events, um das Verhalten von Karpenter zu beobachten. Wichtige Metriken sind Bereitstellungslatenz, Node-Startzeit, Pod-Scheduling-Verzögerungen und Node-Fluktuation.
- Prüfen Sie die Controller-Logs, um Probleme mit IAM-Berechtigungen, Subnetz-Erkennung oder nicht verfügbaren Instanztypen zu diagnostizieren.
5. Vor dem Aktivieren aggressiver Richtlinien testen
Funktionen wie aggressive Konsolidierung, schnelles Node-Expiry oder breiter Spot-Einsatz können Kosten senken, aber ohne Tests Instabilität verursachen. Workloads reagieren unterschiedlich auf häufige Node-Ersetzungen – besonders solche mit langen Startzeiten, zustandsbehafteten Komponenten oder strikten Verfügbarkeitsanforderungen. Tests helfen Teams, die operativen Auswirkungen zu verstehen, bevor diese Einstellungen in der Produktion greifen.
To-dos:
- Validieren Sie diese Einstellungen vor dem Produktionseinsatz in vorgelagerten Umgebungen mit realistischen Workloads und Skalierungsmustern.
- Achten Sie besonders auf Workloads mit langlebigen Verbindungen, langen Startzeiten oder strikten Verfügbarkeitsanforderungen.
- Testen Sie, wie sich Anwendungen bei Node-Ersetzungen, Spot-Unterbrechungen und schnellen Scale-down-Operationen verhalten.
Wie PerfectScale Ihr Karpenter-Autoscaling auf AWS maximiert
Node-Autoscaler wie Karpenter und der Cluster Autoscaler sind leistungsstarke Tools, um Nodes bedarfsgerecht hoch- und herunterzuskalieren, die Cluster-Verfügbarkeit zu verbessern und Leerlaufkosten zu senken. Doch selbst bei gut konfiguriertem Autoscaling stoßen Teams häufig auf drei Probleme, die es untergraben: überprovisionierte Container, die Kapazität verschwenden und den Autoscaler zwingen, mehr Nodes als nötig zu starten; unterprovisionierte Container, die zu Pod-Evictions und erhöhtem Druck auf die Nodes führen; und ineffizientes Bin-Packing, das Ressourcen ungenutzt lässt und gleichzeitig unnötige Skalierungsereignisse auslöst. PerfectScale löst das durch autonomes Right-Sizing Ihrer Workloads und tiefe Einblicke in die Effizienz auf Node-Ebene – sodass Karpenter exakt die Compute-Kapazität bereitstellt, die Ihr Cluster tatsächlich benötigt.
Die wichtigsten Funktionen von PerfectScale:
- Proaktive Behebung von Konfigurationsfehlern: Analysiert Ihre Workloads kontinuierlich, um Konfigurationsfehler wie CPU Request Not Set, Memory Request Not Set und Memory Limit Not Set zu identifizieren und zu beheben – und verhindert so unvorhersehbare Evictions, Node-Überbuchung und ineffizientes Autoscaling.
- Autonomes Right-Sizing von Workloads: Passt Workload-Ressourcen sofort an die tatsächliche Auslastung an und verbessert das Pod-Bin-Packing, um die Autoscaling-Effizienz zu steigern – ganz ohne manuelle Eingriffe.
- Maximale Autoscaling-Effizienz: Liefert herausragende Transparenz über Kosten und Auslastung Ihrer Auto Scaling Groups und Node Pools, deckt Ineffizienzen auf und hilft Ihnen, optimale Node-Typen auszuwählen – für bessere Auslastung, präzise Ressourcenverteilung und maximale Kosteneffizienz.
Sie wollen das Maximum aus Karpenter auf AWS herausholen? Erfahren Sie auf der PerfectScale-Seite zur Node-Autoscaling-Lösung, wie PerfectScale Ihre Workloads und Ihr Node-Autoscaling autonom optimiert.