


Qu'est-ce que Karpenter ?
Karpenter est un autoscaler de cluster Kubernetes open source, flexible et performant, développé par AWS. Il améliore la disponibilité des applications et l'efficacité du cluster en lançant rapidement des ressources de calcul correctement dimensionnées en réponse à l'évolution de la demande des workloads.
Contrairement aux autoscalers traditionnels qui s'appuient sur des groupes de nœuds prédéfinis ou une planification de capacité statique, Karpenter lance et supprime dynamiquement des nœuds en fonction des besoins en temps réel de vos workloads. Cette approche permet aux clusters de monter rapidement en charge lors des pics de demande et de redescendre tout aussi efficacement lorsque les ressources ne sont plus nécessaires.
Principaux avantages :
- Scaling rapide : provisionne des nœuds de calcul en quelques secondes plutôt qu'en plusieurs minutes, réduisant considérablement la latence de scheduling des pods.
- Optimisation des coûts : analyse automatiquement les tarifs des différentes familles d'instances et arbitre entre capacités On-Demand et Spot pour réduire les coûts de calcul. Les Savings Plans et les instances réservées s'appliquent automatiquement au niveau de la facturation AWS, quelles que soient les instances provisionnées par Karpenter.
- Aucun groupe de nœuds : élimine la charge opérationnelle liée à la gestion d'Auto Scaling Groups (ASG) ou de groupes de nœuds managés rigides et prédéfinis.
- Flexibilité dynamique des instances : prend en compte des centaines de types d'instances AWS différents pour trouver l'empreinte de calcul la plus efficace pour votre cluster.
Pourquoi utiliser Karpenter sur AWS ?
Un scaling rapide
Karpenter permet aux clusters Kubernetes de réagir aux variations de la demande plus vite que les autoscalers traditionnels. Lorsque de nouveaux pods sont planifiés et que les nœuds existants manquent de ressources pour les héberger, Karpenter provisionne de nouvelles instances EC2 adaptées aux besoins du workload. Cela réduit le temps d'attente des pods en attente et la latence applicative. Cette rapidité de scaling est précieuse pour les workloads au trafic imprévisible ou variable, où un scaling trop lent peut dégrader le service.
Comment Karpenter y parvient : Cet avantage en vitesse vient de l'interaction directe de Karpenter avec les API AWS et de sa capacité à s'affranchir des limites des groupes de nœuds. Plutôt que d'attendre des politiques de scaling ou des ajustements incrémentaux, Karpenter lance ce qui est nécessaire au moment où c'est nécessaire.
Une optimisation des coûts
Karpenter améliore l'efficacité des coûts en choisissant lui-même les types et tailles d'instances qu'il provisionne. Au lieu d'utiliser un ensemble limité de types de nœuds prédéfinis, il évalue les options d'instances EC2 disponibles, y compris les instances Spot et On-Demand, pour trouver la correspondance la plus rentable pour le workload. Cette sélection dynamique réduit le surprovisionnement et aide les équipes à éviter de payer pour de la capacité inutilisée.
Comment Karpenter y parvient : Karpenter sait exploiter les modèles de tarification AWS. En prenant en charge les instances Spot, il permet aux clusters de bénéficier de coûts de calcul réduits lorsque les workloads tolèrent les interruptions.
Aucun groupe de nœuds
Karpenter supprime la nécessité de gérer des groupes de nœuds, indispensables aux autoscalers Kubernetes traditionnels. Les groupes de nœuds exigent une configuration et une maintenance manuelles : limites de scaling, types d'instances, stratégies de mise à jour. Avec Karpenter, vous définissez des exigences de haut niveau, et il lance et supprime les nœuds en fonction des besoins des workloads. Cela réduit la charge opérationnelle, en particulier dans les environnements vastes ou complexes.
Pourquoi c'est utile : Sans les contraintes des groupes de nœuds, Karpenter permet un scaling plus granulaire. Il peut combiner les types et tailles d'instances selon les besoins, couvrir un éventail plus large de workloads et optimiser à la fois performance et coûts.
Flexibilité dynamique des instances
Karpenter peut sélectionner, au moment du lancement, parmi l'ensemble des types d'instances EC2, au lieu d'être limité à ceux spécifiés dans des groupes de nœuds. Il s'adapte aux évolutions de l'inventaire AWS, des prix et des besoins des workloads. Si certains types d'instances deviennent indisponibles ou moins rentables, Karpenter choisit une autre option.
Pourquoi c'est utile : Cette flexibilité profite aux workloads dont les besoins en ressources sont variés ou changeants. Par exemple, des traitements de données peuvent nécessiter des nœuds à forte mémoire un jour, et des nœuds à fort CPU le lendemain. Karpenter peut provisionner le type d'instance approprié à chaque scénario, réduisant le gaspillage et améliorant les performances du cluster.
Comment Karpenter fonctionne avec Amazon EKS
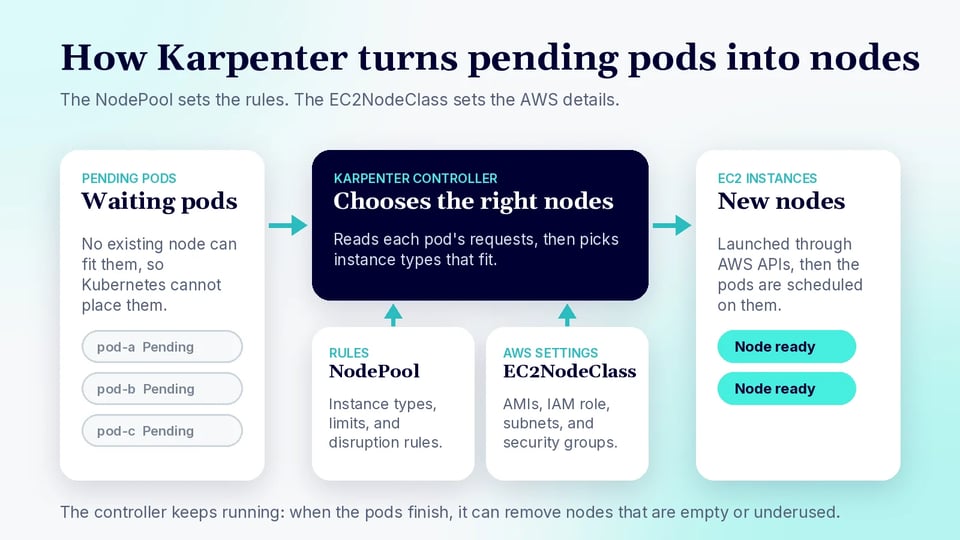
Karpenter s'intègre à Amazon Elastic Kubernetes Service (EKS) pour assurer le provisionnement de nœuds pour les workloads Kubernetes sur AWS :
- Il s'exécute en tant que contrôleur au sein du cluster EKS et surveille les pods non planifiables. Lorsque Kubernetes ne peut pas placer un pod faute de capacité de calcul suffisante, Karpenter évalue les requêtes de ressources du pod et lance des instances EC2 qui répondent à ces exigences.
- L'intégration avec EKS fonctionne de concert avec le scheduler Kubernetes. Kubernetes tente d'abord de planifier les pods sur les nœuds existants. Si aucune capacité adaptée n'existe, Karpenter détecte les pods en attente et provisionne de nouveaux nœuds workers.
- Une fois les nouvelles instances prêtes et enregistrées auprès du cluster, les pods sont planifiés et démarrés.
- Karpenter utilise les API AWS pour découvrir et lancer des instances EC2. Au lieu de s'appuyer sur des groupes d'autoscaling fixes, il sélectionne parmi les types d'instances disponibles en fonction des contraintes définies par les administrateurs. Ces contraintes peuvent inclure l'architecture CPU, la famille d'instances, la zone de disponibilité, le type de capacité ou des préférences tarifaires.
Dans les environnements Amazon EKS, Karpenter s'appuie sur deux ressources personnalisées : NodePool et EC2NodeClass :
- Un NodePool définit les exigences de scheduling et de scaling telles que les types d'instances, les taints, les limites et les politiques de disruption.
- Une EC2NodeClass définit les paramètres d'infrastructure propres à AWS, dont les AMI, les rôles IAM, les sous-réseaux et les groupes de sécurité.
Ensemble, ces ressources séparent le comportement de scheduling Kubernetes de la configuration d'infrastructure AWS.
Grâce à son intégration avec AWS, Karpenter peut exploiter les instances Spot, plusieurs zones de disponibilité et les types d'instances basés sur Graviton. Les clusters EKS peuvent ainsi utiliser un mix de ressources de calcul plus large et plus rentable.
Cas d'usage courants de Karpenter sur AWS
1. Autoscaling de microservices sur EKS
Karpenter est bien adapté à l'autoscaling de microservices déployés sur Amazon EKS. Les microservices connaissent souvent des profils de charge variables et exigent un scaling rapide. Karpenter provisionne des instances EC2 pour accueillir les nouveaux pods quand la demande augmente et supprime les nœuds superflus quand le trafic diminue. Les microservices disposent ainsi des ressources nécessaires, sans ajustements manuels ni surprovisionnement.
2. Workloads batch et basés sur des files d'attente
Les workloads batch et basés sur des files d'attente requièrent souvent des pics de calcul de courte durée, suivis de périodes d'inactivité. Le scaling rapide de Karpenter répond à ces scénarios. Lorsqu'une file de jobs se remplit ou qu'un traitement batch est déclenché, Karpenter provisionne des nœuds de calcul pour absorber la charge. Une fois les jobs terminés, il réduit la taille du cluster et libère les ressources inutilisées.
3. Workloads de traitement de données
Les workloads de traitement de données, comme l'analytics, l'ETL ou les pipelines de machine learning, bénéficient de la capacité de Karpenter à provisionner des ressources de calcul à la demande. Ces workloads ont souvent des besoins spécifiques en CPU, mémoire ou GPU qui varient selon les jobs. Karpenter évalue ces besoins et lance les types d'instances EC2 appropriés. À la fin des jobs, Karpenter met hors service les nœuds inutilisés, évitant le gaspillage de ressources.
4. Optimisation des coûts pour les clusters EKS multi-tenants
Les clusters EKS multi-tenants doivent souvent concilier efficacité des ressources et isolation des tenants. Karpenter alloue les ressources de calcul en fonction des usages. Quand les tenants ont besoin de plus de capacité, il provisionne des instances supplémentaires ; quand la demande baisse, il libère les ressources. Karpenter peut aussi faire respecter des politiques de séparation via des taints, des tolerations ou des règles d'affinité. Les équipes plateforme peuvent ainsi maîtriser les coûts tout en maintenant des frontières entre tenants.
Karpenter face à Kubernetes Cluster Autoscaler sur AWS
Karpenter et Cluster Autoscaler ajoutent tous deux de la capacité de calcul lorsque des pods ne peuvent pas être planifiés, mais ils reposent sur des modèles de scaling différents.
Cluster Autoscaler travaille avec des groupes de nœuds existants, comme les groupes de nœuds managés Amazon EKS ou les groupes Auto Scaling. Il augmente ou réduit la taille de ces groupes en fonction des pods en attente et des nœuds inutilisés. Il convient bien lorsque les workloads tiennent dans un petit nombre de types de nœuds connus. Il est prévisible et largement adopté, mais exige souvent une planification minutieuse. Les équipes doivent définir les groupes de nœuds, fixer les tailles minimale et maximale et décider quels types d'instances chaque groupe doit utiliser.
Karpenter ne requiert aucun groupe de nœuds prédéfini. Il provisionne des instances EC2 en fonction des exigences des pods en attente, ce qui lui permet de choisir parmi un éventail plus large de types d'instances et d'options de capacité au moment du provisionnement. Karpenter est adapté aux environnements où les besoins des workloads évoluent souvent. Il peut sélectionner les nœuds selon le CPU, la mémoire, l'architecture, la zone de disponibilité et le type de capacité.
Le principal compromis se joue entre contrôle et flexibilité :
- Cluster Autoscaler repose sur un modèle de groupes de nœuds fixes.
- Karpenter offre un provisionnement plus dynamique, mais demande de gérer des ressources propres à Karpenter comme NodePool et EC2NodeClass.
Contenu associé : pour une comparaison détaillée, consultez notre guide Karpenter vs. Cluster Autoscaler.
Tutoriel : premiers pas avec Karpenter sur AWS
Ce tutoriel montre comment créer un cluster Amazon EKS, installer Karpenter, définir un NodePool par défaut et tester le provisionnement automatique de nœuds. Le déroulé utilise eksctl, kubectl, helm et l'AWS CLI.
Étape 1 : avant de commencer, installez les outils requis :
aws --versionkubectl version --clienteksctl versionhelm versionKarpenter a besoin de permissions AWS pour pouvoir lancer et arrêter des instances EC2. Dans cette configuration, ces permissions sont attachées au service account Karpenter via Pod Identity.
Étape 2 : commencez par définir les principales variables d'environnement :
export KARPENTER_NAMESPACE="kube-system"export KARPENTER_VERSION="1.14.0"export K8S_VERSION="1.36"export AWS_PARTITION="aws"export CLUSTER_NAME="${USER}-karpenter-demo"export AWS_DEFAULT_REGION="us-west-2"export AWS_ACCOUNT_ID="$(aws sts get-caller-identity --query Account --output text)"export TEMPOUT="$(mktemp)"Ces variables sont réutilisées par les commandes suivantes. CLUSTER_NAME identifie le cluster EKS, tandis que AWS_ACCOUNT_ID sert à la création des rôles et politiques IAM.
Étape 3 : récupérez ensuite les ID d'AMI Amazon Linux 2 recommandés pour la version de Kubernetes :
export ARM_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2-arm64/recommended/image_id \  --query Parameter.Value --output text)"
export AMD_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2/recommended/image_id \  --query Parameter.Value --output text)"
Karpenter utilise ces AMI lorsqu'il crée des nœuds EC2. Les conserver dans des variables facilite la réutilisation de la définition EC2NodeClass plus loin.
Étape 4 : créez l'infrastructure AWS de support et le cluster EKS :
curl -fsSL https://raw.githubusercontent.com/aws/karpenter-provider-aws/v"${KARPENTER_VERSION}"/website/content/en/preview/getting-started/getting-started-with-karpenter/cloudformation.yaml > "${TEMPOUT}"
aws cloudformation deploy \  --stack-name "Karpenter-${CLUSTER_NAME}" \  --template-file "${TEMPOUT}" \  --capabilities CAPABILITY_NAMED_IAM \  --parameter-overrides "ClusterName=${CLUSTER_NAME}"
Cette stack CloudFormation crée les ressources AWS dont Karpenter a besoin, y compris les permissions IAM pour provisionner des nœuds.
Étape 5 : créez maintenant le cluster EKS :
eksctl create cluster -f - <<EOFapiVersion: eksctl.io/v1alpha5kind: ClusterConfigmetadata:  name: ${CLUSTER_NAME}  region: ${AWS_DEFAULT_REGION}  version: "${K8S_VERSION}"  tags:    karpenter.sh/discovery: ${CLUSTER_NAME}
iam:  withOIDC: true  podIdentityAssociations:  - namespace: "${KARPENTER_NAMESPACE}"    serviceAccountName: karpenter    roleName: ${CLUSTER_NAME}-karpenter    permissionPolicyARNs:    - arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:policy/KarpenterControllerPolicy-${CLUSTER_NAME}
iamIdentityMappings:- arn: "arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:role/KarpenterNodeRole-${CLUSTER_NAME}"  username: system:node:{{EC2PrivateDNSName}}  groups:  - system:bootstrappers  - system:nodes
managedNodeGroups:- instanceType: m5.large  amiFamily: AmazonLinux2023  name: ${CLUSTER_NAME}-ng  desiredCapacity: 2  minSize: 1  maxSize: 10
addons:- name: eks-pod-identity-agentEOF
Cette commande crée un petit groupe de nœuds managés pour exécuter les composants système et Karpenter lui-même. Le cluster est taggé avec karpenter.sh/discovery, que Karpenter utilise ensuite pour découvrir les sous-réseaux et groupes de sécurité.
Étape 6 : installez Karpenter avec Helm :
helm registry logout public.ecr.aws
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \  --version "${KARPENTER_VERSION}" \  --namespace "${KARPENTER_NAMESPACE}" \  --create-namespace \  --set "settings.clusterName=${CLUSTER_NAME}" \  --set "settings.interruptionQueue=${CLUSTER_NAME}" \  --set controller.resources.requests.cpu=1 \  --set controller.resources.requests.memory=1Gi \  --set controller.resources.limits.cpu=1 \  --set controller.resources.limits.memory=1Gi \  --wait
Cette commande déploie le contrôleur Karpenter dans le cluster. Le contrôleur surveille les pods que Kubernetes ne peut pas planifier, puis appelle les API AWS pour créer des instances EC2 adaptées.
Étape 7 : créez ensuite un NodePool et une EC2NodeClass par défaut :
cat <<EOF | envsubst | kubectl apply -f -apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: kubernetes.io/arch operator: In values: ["amd64"] - key: kubernetes.io/os operator: In values: ["linux"] - key: karpenter.sh/capacity-type operator: In values: ["on-demand"] - key: karpenter.k8s.aws/instance-category operator: In values: ["c", "m", "r"] nodeClassRef: group: karpenter.k8s.aws kind: EC2NodeClass name: default expireAfter: 720h limits: cpu: 1000 disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m---apiVersion: karpenter.k8s.aws/v1kind: EC2NodeClassmetadata: name: defaultspec: amiFamily: AL2023 role: "KarpenterNodeRole-${CLUSTER_NAME}" subnetSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" securityGroupSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" amiSelectorTerms: - id: "${AMD_AMI_ID}"EOFLe NodePool définit les nœuds que Karpenter est autorisé à créer. Dans cet exemple, il autorise des instances On-Demand Linux amd64 issues des familles de calcul, généralistes et optimisées mémoire.
L'EC2NodeClass contient les paramètres propres à AWS. Elle indique à Karpenter quels rôle IAM, sous-réseaux, groupes de sécurité et AMI utiliser lors du lancement des nœuds.
Étape 8 : pour tester le scaling, créez un déploiement avec zéro replica :
cat <<EOF | kubectl apply -f -apiVersion: apps/v1kind: Deploymentmetadata: name: inflatespec: replicas: 0 selector: matchLabels: app: inflate template: metadata: labels: app: inflate spec: terminationGracePeriodSeconds: 0 containers: - name: inflate image: public.ecr.aws/eks-distro/kubernetes/pause:3.7 resources: requests: cpu: 1EOFCe déploiement utilise l'image pause, très légère. Chaque replica demande un CPU, ce qui en fait un bon test de provisionnement de nœuds.
Étape 9 : augmentez le nombre de replicas pour créer des pods non planifiables :
kubectl scale deployment inflate --replicas 5Karpenter devrait détecter les pods en attente et créer de nouveaux nœuds EC2. Vous pouvez suivre les logs du contrôleur avec :
kubectl logs -f -n "${KARPENTER_NAMESPACE}" \ -l app.kubernetes.io/name=karpenter \ -c controllerAprès le test, supprimez le déploiement :
kubectl delete deployment inflateComme le NodePool utilise WhenEmptyOrUnderutilized, Karpenter peut supprimer les nœuds vides ou sous-utilisés après consolidation. Cela aide à réduire les coûts lorsque les workloads n'ont plus besoin de capacité supplémentaire.
Étape 10 : pour nettoyer l'environnement de démonstration, désinstallez Karpenter et supprimez le cluster :
helm uninstall karpenter --namespace "${KARPENTER_NAMESPACE}"
aws cloudformation delete-stack \  --stack-name "Karpenter-${CLUSTER_NAME}"
eksctl delete cluster --name "${CLUSTER_NAME}"
Cette étape supprime les principales ressources créées durant le tutoriel et évite des frais AWS supplémentaires.
Bonnes pratiques pour Karpenter sur AWS
Voici quelques pratiques utiles à considérer lorsque vous utilisez Karpenter sur AWS.
1. Figer les AMI en production
Dans les environnements de production, évitez de vous fier aux AMI sélectionnées automatiquement. Figez plutôt des ID d'AMI spécifiques dans vos définitions EC2NodeClass. Les équipes gardent ainsi le contrôle de l'image système utilisée pour les nœuds workers et réduisent le risque de changements inattendus liés aux nouvelles versions d'AMI. Les AMI figées renforcent aussi la cohérence entre environnements et simplifient le diagnostic.
Actions recommandées :
- Les équipes peuvent valider les correctifs de sécurité, les runtimes de conteneurs et la compatibilité Kubernetes avant de déployer les mises à jour.
- Testez les nouvelles AMI dans des environnements hors production avant de mettre à jour les NodePools de production.
- Maintenez un processus documenté de mise à jour des AMI incluant revues de sécurité, procédures de rollback et suivi des versions.
2. Utiliser les contrôles de disruption
Karpenter inclut des fonctionnalités de disruption et de consolidation qui aident à réduire les coûts en remplaçant ou supprimant les nœuds sous-utilisés. Si ces capacités améliorent l'efficacité, une consolidation agressive peut nuire à la disponibilité des workloads si les nœuds sont arrêtés trop vite. Les contrôles de disruption permettent de concilier optimisation des coûts et stabilité applicative en maîtrisant comment et quand les remplacements de nœuds ont lieu.
Actions recommandées :
- Combinez les politiques de consolidation avec des pod disruption budgets, des contraintes de répartition topologique et des priorités de workloads.
- Pour les services critiques, envisagez d'allonger les délais de consolidation ou de limiter les remplacements de nœuds pendant les heures ouvrées.
- Dans les clusters de production, configurez soigneusement les paramètres de disruption et de consolidation pour éviter des interruptions de workloads inutiles.
3. Séparer les types de workloads avec des NodePools
Des workloads différents ont souvent des exigences d'infrastructure différentes. Par exemple, les workloads batch stateless peuvent s'exécuter sur des NodePools basés sur Spot, tandis que les applications exposées aux clients peuvent utiliser de la capacité On-Demand. Les workloads GPU, les workloads sur ARM et les applications à forte mémoire peuvent aussi bénéficier de NodePools dédiés avec des contraintes d'instances spécifiques.
Actions recommandées :
- Répartissez les workloads dans des NodePools dédiés selon la sensibilité aux coûts, les exigences de performance, l'architecture ou la tolérance aux interruptions.
- Utilisez taints, tolerations, node selectors et règles d'affinité pour garantir que les workloads sont planifiés sur les NodePools appropriés.
- Appliquez à chaque NodePool des politiques de disruption, de consolidation et de type de capacité adaptées aux caractéristiques des workloads.
4. Surveiller le comportement de Karpenter
Surveillez Karpenter comme n'importe quel autre composant du cluster. La visibilité sur les décisions de provisionnement, les événements du cycle de vie des nœuds et les résultats de scheduling aide les équipes à repérer les inefficacités, diagnostiquer les problèmes et vérifier que le comportement de scaling répond aux besoins des workloads. Une surveillance régulière permet aussi de détecter les contraintes de capacité AWS, les problèmes de configuration ou un churn de nœuds inattendu avant qu'ils n'affectent les applications.
Actions recommandées :
- Suivez les événements de provisionnement de nœuds, les lancements en échec, l'activité de consolidation, les pods en attente et les interruptions d'instances EC2.
- Utilisez Amazon CloudWatch, Prometheus et les événements Kubernetes pour observer le comportement de Karpenter. Les métriques importantes incluent la latence de provisionnement, le temps de démarrage des nœuds, les délais de scheduling des pods et le churn de nœuds.
- Examinez les logs du contrôleur pour diagnostiquer les problèmes liés aux permissions IAM, à la découverte de sous-réseaux ou aux types d'instances indisponibles.
5. Tester avant d'activer des politiques agressives
Des fonctionnalités comme la consolidation agressive, l'expiration rapide des nœuds ou un usage étendu de Spot peuvent réduire les coûts, mais introduire de l'instabilité si elles ne sont pas testées. Les workloads peuvent réagir différemment aux remplacements fréquents de nœuds, en particulier ceux avec de longs temps de démarrage, des composants stateful ou des exigences strictes de disponibilité. Les tests aident les équipes à mesurer l'impact opérationnel avant d'appliquer ces réglages en production.
Actions recommandées :
- Avant d'activer ces réglages en production, validez-les dans des environnements intermédiaires avec des workloads et des profils de scaling réalistes.
- Portez une attention particulière aux workloads avec connexions longue durée, temps de démarrage importants ou exigences strictes de disponibilité.
- Testez le comportement des applications lors des remplacements de nœuds, des interruptions Spot et des opérations de scale-down rapide.
Comment PerfectScale maximise votre autoscaling Karpenter sur AWS
Les autoscalers de nœuds comme Karpenter et Cluster Autoscaler sont des outils puissants pour ajuster le nombre de nœuds à la demande, améliorer la disponibilité du cluster et réduire les coûts d'inactivité. Mais même avec un autoscaling bien configuré, les équipes se heurtent souvent à trois problèmes qui en sapent les bénéfices : des conteneurs surprovisionnés qui gaspillent de la capacité et forcent l'autoscaler à lancer plus de nœuds que nécessaire, des conteneurs sous-provisionnés qui entraînent des évictions de pods et une pression sur les nœuds, et un bin-packing inefficace qui laisse des ressources sous-utilisées tout en déclenchant des événements de scaling superflus. PerfectScale résout ce problème en appliquant de façon autonome le right-sizing de vos workloads et en vous offrant une visibilité fine sur l'efficacité au niveau des nœuds, afin que Karpenter provisionne exactement le compute dont votre cluster a réellement besoin.
Capacités clés de PerfectScale :
- Correction proactive des erreurs de configuration : analyse en continu vos workloads pour identifier et corriger les erreurs de configuration — telles que CPU Request Not Set, Memory Request Not Set et Memory Limit Not Set — afin d'éviter les évictions imprévisibles, le surengagement des nœuds et un autoscaling inefficace.
- Right-sizing autonome des workloads : ajuste instantanément les ressources des workloads selon l'utilisation réelle et améliore le bin-packing des pods pour renforcer l'efficacité de l'autoscaling, sans aucune intervention manuelle.
- Efficacité d'autoscaling maximisée : offre une visibilité exceptionnelle sur les coûts et l'utilisation de vos groupes d'autoscaling et node pools, met en évidence les inefficacités et vous aide à choisir les types de nœuds optimaux pour améliorer l'utilisation, répartir précisément les ressources et maximiser l'efficacité des coûts.
Prêt à tirer le meilleur parti de Karpenter sur AWS ? Découvrez comment PerfectScale optimise de façon autonome vos workloads et l'autoscaling de vos nœuds sur la page de la solution d'autoscaling de nœuds PerfectScale.