


Karpenterとは
Karpenterは、AWSが開発したオープンソースで柔軟かつ高性能なKubernetesクラスターオートスケーラーです。変化するワークロードの需要に応じて、適切なサイズのコンピュートリソースを迅速に起動することで、アプリケーションの可用性とクラスターの効率を向上させます。
事前定義されたノードグループや静的なキャパシティプランニングに依存する従来のオートスケーラーとは異なり、Karpenterはワークロードのリアルタイムな要件に基づいてノードを動的に起動・終了します。このアプローチにより、需要が急増すれば迅速にスケールアップし、リソースが不要になれば同様に効率よくスケールダウンできます。
主なメリット:
- 高速なスケーリング: 数分ではなく数秒でコンピュートノードをプロビジョニングし、Podのスケジューリング遅延を大幅に削減します。
- コスト最適化: インスタンスファミリー間の料金を自動的に分析し、オンデマンドとSpotのキャパシティから選択してコンピュートコストを削減します。Savings Plansとリザーブドインスタンスは、Karpenterがどのインスタンスをプロビジョニングしても、AWSの請求レイヤーで自動的に適用されます。
- ノードグループ不要: 柔軟性に欠ける事前定義のAuto Scalingグループ(ASG)やマネージドノードグループを管理する運用負荷を排除します。
- 動的なインスタンスの柔軟性: 数百種類にのぼるAWSのインスタンスタイプをシームレスに検討し、クラスターに最も効率的なコンピュート構成を見つけ出します。
AWSでKarpenterを使う理由
高速なスケーリング
Karpenterを使えば、Kubernetesクラスターは従来のオートスケーラーよりも速く需要の変化に対応できます。新しいPodがスケジュールされ、既存のノードにそれらをホストするリソースが不足している場合、Karpenterはワークロードの要件に合わせた新しいEC2インスタンスをプロビジョニングします。これにより、保留中のPodの待ち時間が短縮され、アプリケーションのレイテンシーが低下します。このスケーリングの速さは、スケーリングの遅れがサービス品質の低下につながりやすい、トラフィックパターンが予測不能または変動しやすいワークロードで特に価値を発揮します。
実現の仕組み: この速度面の優位性は、KarpenterがAWS APIと直接やり取りし、ノードグループの制約を回避できることに由来します。スケーリングポリシーや段階的な調整を待つのではなく、必要なものを必要なタイミングで起動します。
コスト最適化
Karpenterは、プロビジョニングするインスタンスタイプとサイズを自ら判断することで、コスト効率を高めます。限られた事前定義のノードタイプを使う代わりに、Spotインスタンスとオンデマンドインスタンスを含む利用可能なEC2インスタンスの選択肢を評価し、ワークロードに対してコスト効率の高い組み合わせを見つけます。この動的な選択により、過剰プロビジョニングが減り、未使用キャパシティへの支払いを回避できます。
実現の仕組み: KarpenterはAWSの料金モデルを活用できます。Spotインスタンスに対応しているため、中断を許容できるワークロードではコンピュートコストの削減というメリットをクラスターにもたらします。
ノードグループ不要
Karpenterを使えば、従来のKubernetesオートスケーラーで必須だったノードグループの管理が不要になります。ノードグループには、スケーリングの上限・下限、インスタンスタイプ、更新戦略など、手動での設定とメンテナンスが必要です。Karpenterでは高レベルの要件を定義するだけで、ワークロードのニーズに応じてノードが起動・終了されます。これにより、特に大規模または複雑な環境において運用負荷が軽減されます。
メリット: ノードグループの制約がないため、Karpenterはよりきめ細かなスケーリングを可能にします。必要に応じてインスタンスタイプとサイズを自在に組み合わせられるため、より幅広いワークロードに対応し、パフォーマンスとコストの両面で最適化できます。
動的なインスタンスの柔軟性
Karpenterはノードグループで指定されたインスタンスタイプに縛られず、起動時にEC2インスタンスタイプの全ラインナップから選択できます。AWSの在庫状況、料金、ワークロード要件の変化にも適応します。特定のインスタンスタイプが利用できなくなったり、コスト効率が下がった場合には、別の選択肢を選びます。
メリット: この柔軟性は、リソース要件が多様または変化しやすいワークロードに有効です。たとえば、データ処理ジョブはある日には大容量メモリのノードを、翌日には高CPUのノードを必要とするかもしれません。Karpenterはそれぞれのシナリオに適したインスタンスタイプをプロビジョニングできるため、無駄を減らしクラスターのパフォーマンスを向上させます。
KarpenterとAmazon EKSの連携の仕組み
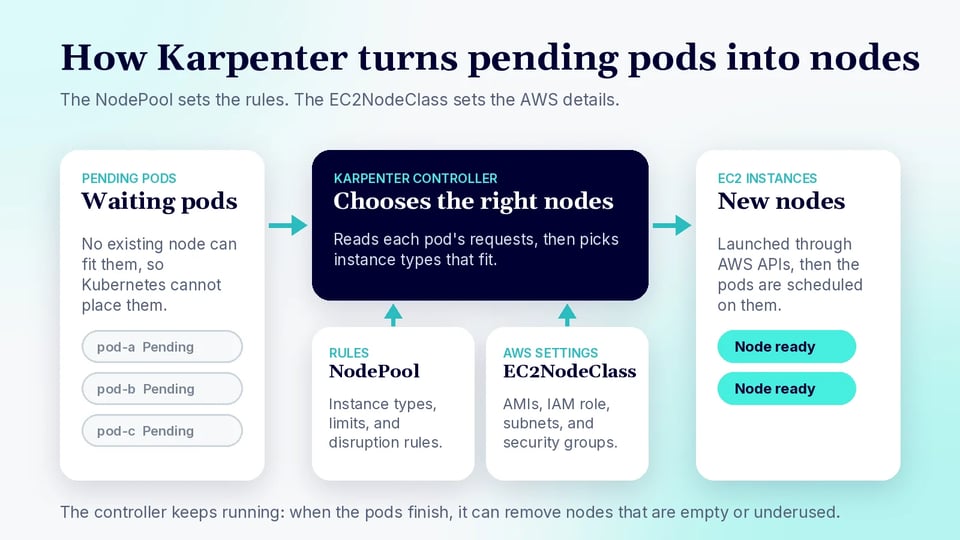
KarpenterはAmazon Elastic Kubernetes Service(EKS)と統合し、AWS上のKubernetesワークロードにノードプロビジョニングを提供します:
- EKSクラスター内でコントローラーとして動作し、スケジュール不能なPodを監視します。コンピュートキャパシティの不足によりKubernetesがPodを配置できない場合、KarpenterはPodのリソースリクエストを評価し、その要件を満たすEC2インスタンスを起動します。
- EKSとの統合はKubernetesスケジューラーと連携して機能します。Kubernetesはまず既存のノードへのPodのスケジュールを試みます。適切なキャパシティがない場合、Karpenterが保留中のPodを検知し、新しいワーカーノードをプロビジョニングします。
- 新しいインスタンスの準備が整い、クラスターに登録されると、Podがスケジュールされて起動します。
- KarpenterはAWS APIを使用してEC2インスタンスを検出・起動します。固定のオートスケーリンググループに依存するのではなく、管理者が定義した制約に基づいて利用可能なインスタンスタイプから選択します。制約には、CPUアーキテクチャ、インスタンスファミリー、アベイラビリティゾーン、キャパシティタイプ、料金の優先順位などを含めることができます。
Amazon EKS環境では、KarpenterはNodePoolとEC2NodeClassという2つのカスタムリソースを使用します:
- NodePoolは、インスタンスタイプ、taint、上限、中断(disruption)ポリシーなどのスケジューリングとスケーリングの要件を定義します。
- EC2NodeClassは、AMI、IAMロール、サブネット、セキュリティグループなど、AWS固有のインフラ設定を定義します。
この2つのリソースにより、Kubernetesのスケジューリング動作とAWSのインフラ設定を分離できます。
KarpenterはAWSと統合されているため、Spotインスタンス、複数のアベイラビリティゾーン、Gravitonベースのインスタンスタイプを活用できます。これにより、EKSクラスターはより幅広く、よりコスト効率の高いコンピュートリソースの組み合わせを利用できます。
AWSにおけるKarpenterの主なユースケース
1. EKS上のマイクロサービスのオートスケーリング
Karpenterは、Amazon EKSにデプロイされたマイクロサービスのオートスケーリングに適しています。マイクロサービスは負荷パターンが変動しやすく、迅速なスケーリングを必要とすることが少なくありません。Karpenterは需要が増加すると新しいPodを収容するためのEC2インスタンスをプロビジョニングし、トラフィックが減少すると不要なノードを終了します。これにより、手動調整や過剰プロビジョニングなしに、マイクロサービスが必要なリソースを確実に得られます。
2. バッチおよびキューベースのワークロード
バッチやキューベースのワークロードは、短時間のコンピュートのバーストとアイドル時間を繰り返すことがよくあります。Karpenterの高速スケーリングはこうしたシナリオに対応します。ジョブキューにタスクが溜まったり、バッチ処理がトリガーされると、Karpenterは負荷を処理するコンピュートノードをプロビジョニングします。ジョブが完了すると、クラスターをスケールダウンして未使用のリソースを解放します。
3. データ処理ワークロード
分析、ETL、機械学習パイプラインなどのデータ処理ワークロードでは、コンピュートリソースをオンデマンドでプロビジョニングできるKarpenterの特性が活きます。これらのワークロードは、ジョブごとに異なるCPU、メモリ、GPU要件を持つことがよくあります。Karpenterはこれらのニーズを評価し、適切なEC2インスタンスタイプを起動します。ジョブが完了すると未使用のノードを廃止し、リソースの無駄を防ぎます。
4. マルチテナントEKSクラスターのコスト最適化
マルチテナントのEKSクラスターでは、リソース効率とテナント分離のバランスを取る必要がしばしば生じます。Karpenterは使用パターンに基づいてコンピュートリソースを割り当てます。テナントがより多くのキャパシティを必要とすれば追加のインスタンスをプロビジョニングし、需要が減ればリソースを解放します。また、taint、toleration、アフィニティルールを使って分離ポリシーを適用することもできます。これにより、プラットフォームチームはテナント間の境界を維持しながらコストを管理できます。
AWSにおけるKarpenterとKubernetes Cluster Autoscalerの比較
KarpenterとKubernetes Cluster Autoscalerはどちらも、Podをスケジュールできない場合にコンピュートキャパシティを追加しますが、採用しているスケーリングモデルが異なります。
**Cluster Autoscaler**は、Amazon EKSマネージドノードグループやAuto Scalingグループなど、既存のノードグループを対象に動作します。保留中のPodや未使用のノードに基づいて、これらのグループのサイズを増減します。ワークロードが少数の既知のノードタイプに収まる場合にはうまく機能します。予測可能で広く使われている一方、多くの場合、綿密な計画が必要です。チームはノードグループを定義し、最小・最大サイズを設定し、各グループで使用するインスタンスタイプを決めなければなりません。
Karpenterは事前定義のノードグループを必要としません。代わりに、保留中のPodの要件に基づいてEC2インスタンスをプロビジョニングします。これにより、プロビジョニング時により幅広いインスタンスタイプとキャパシティオプションから選択できます。Karpenterは、ワークロード要件が頻繁に変化する環境に適しています。CPU、メモリ、アーキテクチャ、アベイラビリティゾーン、キャパシティタイプに基づいてノードを選択できます。
主なトレードオフは「制御」と「柔軟性」です:
- Cluster Autoscalerは、固定のノードグループに基づくモデルを採用しています。
- Karpenterはより動的なプロビジョニングを提供しますが、NodePoolやEC2NodeClassといったKarpenter固有のリソースの管理が必要になります。
関連コンテンツ:より詳細な比較については、Karpenter vs. Cluster Autoscalerのガイドをご覧ください。
チュートリアル:AWSでKarpenterを始める
このチュートリアルでは、Amazon EKSクラスターの作成、Karpenterのインストール、デフォルトのNodePoolの定義、ノードの自動プロビジョニングのテストを行います。手順ではeksctl、kubectl、helm、AWS CLIを使用します。
ステップ1:まず、必要なツールをインストールします:
aws --versionkubectl version --clienteksctl versionhelm versionKarpenterがEC2インスタンスを起動・終了できるように、AWSの権限が必要です。この構成では、Pod Identityを通じてKarpenterのサービスアカウントにこれらの権限が付与されます。
ステップ2:主要な環境変数を設定します:
export KARPENTER_NAMESPACE="kube-system"export KARPENTER_VERSION="1.14.0"export K8S_VERSION="1.36"export AWS_PARTITION="aws"export CLUSTER_NAME="${USER}-karpenter-demo"export AWS_DEFAULT_REGION="us-west-2"export AWS_ACCOUNT_ID="$(aws sts get-caller-identity --query Account --output text)"export TEMPOUT="$(mktemp)"これらの変数は後続のコマンドで再利用されます。CLUSTER_NAMEはEKSクラスターを識別し、AWS_ACCOUNT_IDはIAMロールとポリシーの作成時に使用されます。
ステップ3:次に、対象のKubernetesバージョンに推奨されるAmazon Linux 2のAMI IDを取得します:
export ARM_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2-arm64/recommended/image_id \  --query Parameter.Value --output text)"
export AMD_AMI_ID="$(aws ssm get-parameter \  --name /aws/service/eks/optimized-ami/${K8S_VERSION}/amazon-linux-2/recommended/image_id \  --query Parameter.Value --output text)"
Karpenterは、EC2ノードを作成する際にこれらのAMIを使用します。変数として保持しておくことで、後のEC2NodeClass定義を再利用しやすくなります。
ステップ4:サポート用のAWSインフラとEKSクラスターを作成します:
curl -fsSL https://raw.githubusercontent.com/aws/karpenter-provider-aws/v"${KARPENTER_VERSION}"/website/content/en/preview/getting-started/getting-started-with-karpenter/cloudformation.yaml > "${TEMPOUT}"
aws cloudformation deploy \  --stack-name "Karpenter-${CLUSTER_NAME}" \  --template-file "${TEMPOUT}" \  --capabilities CAPABILITY_NAMED_IAM \  --parameter-overrides "ClusterName=${CLUSTER_NAME}"
このCloudFormationスタックは、ノードのプロビジョニングに必要なIAM権限など、Karpenterが必要とするAWSリソースを作成します。
ステップ5:続いて、EKSクラスターを作成します:
eksctl create cluster -f - <<EOFapiVersion: eksctl.io/v1alpha5kind: ClusterConfigmetadata:  name: ${CLUSTER_NAME}  region: ${AWS_DEFAULT_REGION}  version: "${K8S_VERSION}"  tags:    karpenter.sh/discovery: ${CLUSTER_NAME}
iam:  withOIDC: true  podIdentityAssociations:  - namespace: "${KARPENTER_NAMESPACE}"    serviceAccountName: karpenter    roleName: ${CLUSTER_NAME}-karpenter    permissionPolicyARNs:    - arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:policy/KarpenterControllerPolicy-${CLUSTER_NAME}
iamIdentityMappings:- arn: "arn:${AWS_PARTITION}:iam::${AWS_ACCOUNT_ID}:role/KarpenterNodeRole-${CLUSTER_NAME}"  username: system:node:{{EC2PrivateDNSName}}  groups:  - system:bootstrappers  - system:nodes
managedNodeGroups:- instanceType: m5.large  amiFamily: AmazonLinux2023  name: ${CLUSTER_NAME}-ng  desiredCapacity: 2  minSize: 1  maxSize: 10
addons:- name: eks-pod-identity-agentEOFこれにより、システムコンポーネントとKarpenter自体を実行するための小規模なマネージドノードグループが作成されます。クラスターにはkarpenter.sh/discoveryタグが付与され、Karpenterが後でサブネットとセキュリティグループを検出する際に使用します。
ステップ6:HelmでKarpenterをインストールします:
helm registry logout public.ecr.aws
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \  --version "${KARPENTER_VERSION}" \  --namespace "${KARPENTER_NAMESPACE}" \  --create-namespace \  --set "settings.clusterName=${CLUSTER_NAME}" \  --set "settings.interruptionQueue=${CLUSTER_NAME}" \  --set controller.resources.requests.cpu=1 \  --set controller.resources.requests.memory=1Gi \  --set controller.resources.limits.cpu=1 \  --set controller.resources.limits.memory=1Gi \  --wait
これにより、Karpenterコントローラーがクラスターにデプロイされます。コントローラーはKubernetesがスケジュールできないPodを監視し、AWS APIを呼び出して適切なEC2インスタンスを作成します。
ステップ7:次に、デフォルトのNodePoolとEC2NodeClassを作成します:
cat <<EOF | envsubst | kubectl apply -f -apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: template: spec: requirements: - key: kubernetes.io/arch operator: In values: ["amd64"] - key: kubernetes.io/os operator: In values: ["linux"] - key: karpenter.sh/capacity-type operator: In values: ["on-demand"] - key: karpenter.k8s.aws/instance-category operator: In values: ["c", "m", "r"] nodeClassRef: group: karpenter.k8s.aws kind: EC2NodeClass name: default expireAfter: 720h limits: cpu: 1000 disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 1m---apiVersion: karpenter.k8s.aws/v1kind: EC2NodeClassmetadata: name: defaultspec: amiFamily: AL2023 role: "KarpenterNodeRole-${CLUSTER_NAME}" subnetSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" securityGroupSelectorTerms: - tags: karpenter.sh/discovery: "${CLUSTER_NAME}" amiSelectorTerms: - id: "${AMD_AMI_ID}"EOFNodePoolは、Karpenterが作成を許可されるノードを定義します。この例では、コンピュート最適化、汎用、メモリ最適化の各ファミリーからLinux amd64のオンデマンドインスタンスを許可しています。
EC2NodeClassにはAWS固有の設定が含まれます。ノード起動時に使用するIAMロール、サブネット、セキュリティグループ、AMIをKarpenterに指示します。
ステップ8:スケーリングをテストするため、レプリカ数ゼロのDeploymentを作成します:
cat <<EOF | kubectl apply -f -apiVersion: apps/v1kind: Deploymentmetadata: name: inflatespec: replicas: 0 selector: matchLabels: app: inflate template: metadata: labels: app: inflate spec: terminationGracePeriodSeconds: 0 containers: - name: inflate image: public.ecr.aws/eks-distro/kubernetes/pause:3.7 resources: requests: cpu: 1EOFこのDeploymentは軽量なpauseイメージを使用します。各レプリカが1 CPUをリクエストするため、ノードプロビジョニングのテストに便利です。
ステップ9:Deploymentをスケールして、スケジュール不能なPodを作成します:
kubectl scale deployment inflate --replicas 5Karpenterが保留中のPodを検知し、新しいEC2ノードを作成するはずです。コントローラーのログは次のコマンドで確認できます:
kubectl logs -f -n "${KARPENTER_NAMESPACE}" \ -l app.kubernetes.io/name=karpenter \ -c controllerテストが終わったら、Deploymentを削除します:
kubectl delete deployment inflateNodePoolはWhenEmptyOrUnderutilizedを使用しているため、Karpenterは統合(consolidation)の後に空または使用率の低いノードを削除できます。これにより、ワークロードが追加キャパシティを必要としなくなった際のコスト削減に役立ちます。
**ステップ10:**デモ環境をクリーンアップするには、Karpenterを削除してクラスターを破棄します:
helm uninstall karpenter --namespace "${KARPENTER_NAMESPACE}"
aws cloudformation delete-stack \  --stack-name "Karpenter-${CLUSTER_NAME}"
eksctl delete cluster --name "${CLUSTER_NAME}"
これにより、チュートリアルで作成した主要なリソースが削除され、余分なAWS料金の発生を防げます。
AWSにおけるKarpenterのベストプラクティス
ここでは、AWSでKarpenterを使う際に検討したい実践的なポイントを紹介します。
1. 本番環境ではAMIを固定する
本番環境では、自動的に選択されるAMIに依存しないようにしましょう。代わりに、EC2NodeClass定義で特定のAMI IDを固定します。これにより、ワーカーノードに使用されるOSイメージをチームが管理でき、新しいAMIリリースによる予期しない変更のリスクを減らせます。AMIを固定することで環境間の一貫性も向上し、トラブルシューティングも容易になります。
アクションアイテム:
- 更新を展開する前に、セキュリティパッチ、コンテナランタイム、Kubernetesの互換性をチームで検証できます。
- 本番のNodePoolを更新する前に、新しいAMIを非本番環境でテストしましょう。
- セキュリティレビュー、ロールバック手順、バージョン管理を含む、文書化されたAMI更新プロセスを維持しましょう。
2. 中断(Disruption)コントロールを活用する
Karpenterには、使用率の低いノードを置き換えたり削除したりしてコストを削減する、中断(disruption)および統合(consolidation)機能があります。これらの機能は効率を高めますが、ノードがあまりに早く終了されると、積極的な統合がワークロードの可用性に影響する可能性があります。中断コントロールを使えば、ノードの置き換えのタイミングと方法を制御し、コスト最適化とアプリケーションの安定性のバランスを取ることができます。
アクションアイテム:
- 統合ポリシーは、Pod Disruption Budget、トポロジー分散制約、ワークロードの優先度と組み合わせて使用しましょう。
- 重要なサービスについては、統合までの遅延時間を長くするか、業務時間中のノード置き換えを制限することを検討しましょう。
- 本番クラスターでは、不要なワークロードの中断を避けるため、中断と統合の設定を慎重に構成しましょう。
3. NodePoolでワークロードの種類を分離する
ワークロードごとにインフラ要件は異なることが多いものです。たとえば、ステートレスなバッチワークロードはSpotベースのNodePoolで実行し、顧客向けアプリケーションにはオンデマンドキャパシティを使用できます。GPUワークロード、ARMベースのワークロード、大容量メモリを必要とするアプリケーションにも、特定のインスタンス制約を持つ専用のNodePoolを割り当てられます。
アクションアイテム:
- コスト感度、パフォーマンス要件、アーキテクチャ、中断許容度に基づいて、ワークロードを専用のNodePoolに分離しましょう。
- taint、toleration、ノードセレクター、アフィニティルールを使って、ワークロードが適切なNodePoolにスケジュールされるようにしましょう。
- ワークロードの特性に応じて、NodePoolごとに異なる中断、統合、キャパシティタイプのポリシーを適用しましょう。
4. Karpenterの動作を監視する
Karpenterも他のクラスターコンポーネントと同様に監視しましょう。プロビジョニングの判断、ノードのライフサイクルイベント、スケジューリング結果を可視化することで、非効率の特定、問題の診断、スケーリング動作がワークロード要件に合致していることの検証が可能になります。定期的な監視は、AWSのキャパシティ制約、設定の問題、予期しないノードの入れ替わり(churn)を、アプリケーションに影響が出る前に検出するのにも役立ちます。
アクションアイテム:
- ノードのプロビジョニングイベント、起動の失敗、統合アクティビティ、保留中のPod、EC2インスタンスの中断を追跡しましょう。
- Amazon CloudWatch、Prometheus、Kubernetesイベントを使ってKarpenterの動作を観察しましょう。重要なメトリクスには、プロビジョニングのレイテンシー、ノードの起動時間、Podのスケジューリング遅延、ノードの入れ替わりが含まれます。
- IAM権限、サブネット検出、利用不可のインスタンスタイプに関する問題を診断するには、コントローラーのログを確認しましょう。
5. 積極的なポリシーは有効化前にテストする
積極的な統合、短いノード有効期限、広範なSpot利用といった機能はコストを削減できますが、テストせずに導入すると不安定さを招く可能性があります。特に起動に時間がかかるもの、ステートフルなコンポーネントを持つもの、厳格な可用性要件があるものなど、ワークロードによって頻繁なノード置き換えへの反応は異なります。テストを行うことで、本番環境に適用する前に運用への影響を把握できます。
アクションアイテム:
- 本番環境でこれらの設定を有効化する前に、現実的なワークロードとスケーリングパターンを使って下位環境で検証しましょう。
- 長時間維持される接続、起動時間の長さ、厳格な可用性要件を持つワークロードには特に注意を払いましょう。
- ノード置き換え、Spot中断イベント、急速なスケールダウンの際にアプリケーションがどう動作するかをテストしましょう。
PerfectScaleでAWSのKarpenterオートスケーリングを最大化する方法
KarpenterやCluster Autoscalerのようなノードオートスケーラーは、需要に応じてノードをスケールアップ・ダウンし、クラスターの可用性を高めてアイドルコストを削減する強力なツールです。しかし、オートスケーリングが適切に設定されていても、チームはその効果を損なう3つの問題に頻繁に直面します。キャパシティを浪費し、オートスケーラーに必要以上のノードを起動させる過剰プロビジョニングされたコンテナ。Podの退避(eviction)やノードへの負荷につながる過少プロビジョニングされたコンテナ。そして、リソースを十分に活用できないまま不要なスケーリングイベントを引き起こす非効率なビンパッキングです。PerfectScaleは、ワークロードを自律的にライトサイジングし、ノードレベルの効率を深く可視化することでこの問題を解決します。その結果、Karpenterはクラスターが実際に必要とするコンピュートだけを正確にプロビジョニングできるようになります。
PerfectScaleの主な機能:
- 設定エラーのプロアクティブな修正: ワークロードを継続的に分析し、CPU Request未設定、Memory Request未設定、Memory Limit未設定といった設定エラーを特定・修正することで、予測不能な退避、ノードのオーバーコミット、非効率なオートスケーリングを防ぎます。
- 自律的なワークロードのライトサイジング: 実際の使用状況に基づいてワークロードのリソースを即座に調整し、Podのビンパッキングを改善してオートスケーリングの効率を高めます。すべて手動操作なしで実行されます。
- オートスケーリング効率の最大化: オートスケーリンググループとノードプールのコストと使用状況を高い精度で可視化し、非効率な箇所を浮き彫りにします。最適なノードタイプの選択を支援することで、使用率の向上、正確なリソース配分、コスト効率の最大化を実現します。
AWSでKarpenterの効果を最大限に引き出したい方は、PerfectScaleがワークロードとノードオートスケーリングをどのように自律的に最適化するか、PerfectScaleのノードオートスケーリングソリューションページでご確認ください。