
PerfectScale
Les commitments sont une cible mouvante. Les moteurs natifs la ratent, alors nous avons construit le nôtre.
AWS et Google Cloud donnent le bon chiffre. Nous aussi. Et nous allons plus loin.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Mohammad Reza Saleh Sedghpour
Senior Software Engineer 2
Mohammad Reza Saleh Sedghpour is a Senior Software Engineer II at DoiT and a Cloud Engineer and Researcher with over a decade of experience in cloud computing and distributed systems. He holds a Ph.D. in Computer Science, specializing in resiliency patterns for microservices, and is an active open-source contributor who regularly publishes research and presents at international conferences. At DoiT, he works on the automation behind cloud cost-optimization tooling, including commitment management — helping businesses use cloud technologies for optimal performance, resilience, and cost.
My personal pageLes commitments comptent parmi les leviers les plus rapides pour réduire une facture cloud. Les maintenir à la bonne taille, semaine après semaine, est un travail à plein temps.
Alors, quand nous présentons PerfectScale for Commitments à un ingénieur FinOps, une question revient presque à chaque fois.
"AWS me dit déjà combien engager. Google Cloud aussi. Pourquoi aurais-je besoin du vôtre ?"
Question légitime. Honnêtement, c'est la bonne question à poser. Les deux clouds fournissent un moteur de recommandation. Les deux sont gratuits. Et les deux sont justes, pour la question à laquelle ils ont été conçus pour répondre.
Nous avons donc fait la chose évidente : exécuter le nôtre à côté des leurs. Pendant des mois. Mêmes comptes, mêmes plages de dates, mêmes types de commitments, sans sélectionner les résultats flatteurs. Cet article en présente les conclusions.
En résumé : posez la même question, obtenez le même chiffre. Tout l'intérêt réside dans ce qui entoure ce chiffre. La fréquence à laquelle vous avez le droit de poser la question. Ce que vous pouvez ajuster avant de la poser. Si quelqu'un peut vous dire pourquoi. Et si une machine peut agir sur la réponse à 3 h du matin, sans vous.
Comment notre moteur trouve le chiffre
Il y a en réalité deux moteurs. Un pour les Savings Plans AWS, un pour les remises sur engagement d'utilisation (CUD) de Google Cloud. Code séparé, parce que les deux clouds tarifient et appliquent les commitments de manière réellement différente, et prétendre le contraire nous aurait coûté en précision. L'idée sous-jacente, elle, est la même.
Tout commence par les données d'utilisation brutes. Nous prenons chaque heure de dépense qu'un commitment pourrait couvrir pendant la période d'analyse — pour une fenêtre de 60 jours, cela représente environ 1 440 heures individuelles et leurs montants exacts. Certaines de ces heures sont très chargées. D'autres sont complètement mortes, surtout au creux du week-end. Tout l'enjeu consiste à gérer cette courbe en dents de scie.
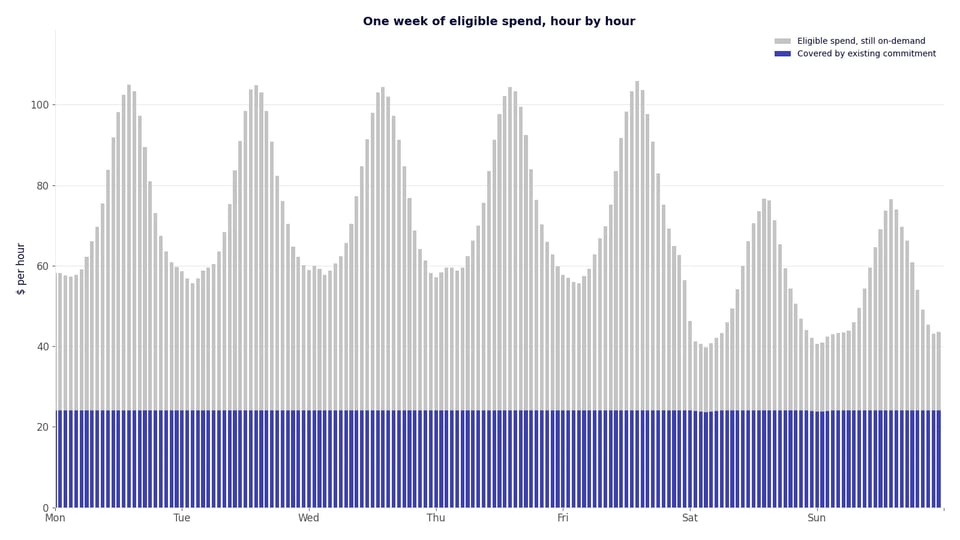
Ensuite, nous retirons ce que vous possédez déjà. Si vous avez des Savings Plans ou des CUD actifs, nous les appliquons à chaque heure exactement comme le ferait le fournisseur cloud, meilleure remise en premier. Ce que ces plans couvrent déjà n'entre plus en jeu. Ce qui reste, c'est la dépense sur laquelle un nouveau commitment peut encore vous faire économiser.
Nous tenons aussi compte de chaque remise dont vous bénéficiez déjà. Tarifs contractuels négociés. Remises d'utilisation soutenue sur Google Cloud. Couverture de Flexsave de DoiT, si vous l'utilisez. Un commitment n'a de sens que s'il bat le prix que vous payez réellement aujourd'hui ; c'est donc ce prix que nous prenons comme référence, pas le tarif catalogue.
Les deux moteurs sont séparés parce qu'AWS et Google Cloud exposent les données de facturation différemment et appliquent les commitments selon leurs propres règles. Le principe, lui, est commun : évaluer le commitment par rapport à ce que vous payez réellement, pas par rapport à un tarif catalogue que vous ne voyez jamais sur votre facture.
Vient maintenant le point essentiel.
Prenez n'importe quel commitment horaire que vous pourriez acheter. Sur la fenêtre, vous paieriez deux choses. Le commitment lui-même, chaque heure, utilisé ou non. Plus la dépense à la demande qui déborde encore pendant les heures chargées. Additionnez les deux et vous obtenez votre coût total à ce niveau de commitment.
Un exemple rapide. Une heure compte 100 $ de dépense éligible et vous avez engagé 30 $ de l'heure avec une remise de 40 %, pour simplifier. Ces 30 $ couvrent 50 $ d'utilisation à la demande. Vous payez donc 30 $ pour le commitment, 50 $ à la demande pour le reste, soit 80 $ au lieu de 100 $. Très bien. Prenez maintenant une heure creuse avec seulement 40 $ de dépense éligible. Vos 30 $ couvrent toujours 50 $, sauf qu'il n'y a que 40 $ à couvrir. Vous payez 30 $, vous économisez 10 $, et une partie du commitment reste inutilisée. Le moteur de recommandation effectue ce calcul pour chaque heure de la fenêtre et additionne le tout. Puis il recommence pour chaque niveau de commitment possible, afin de déterminer celui qui économise le plus.
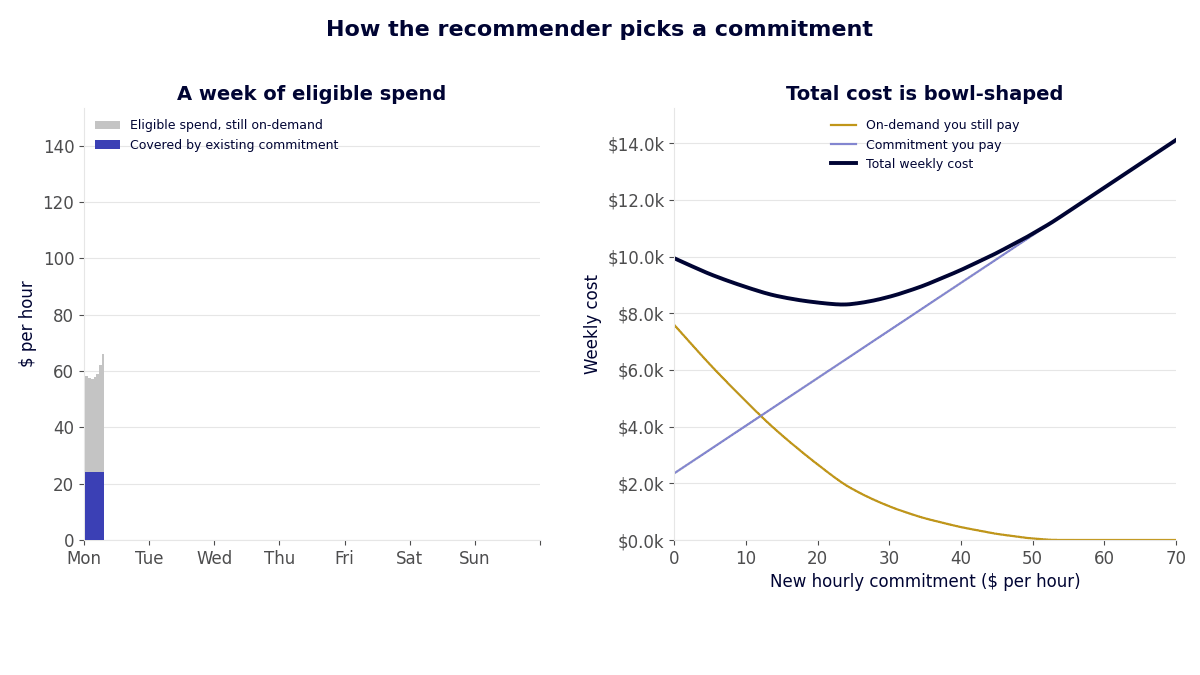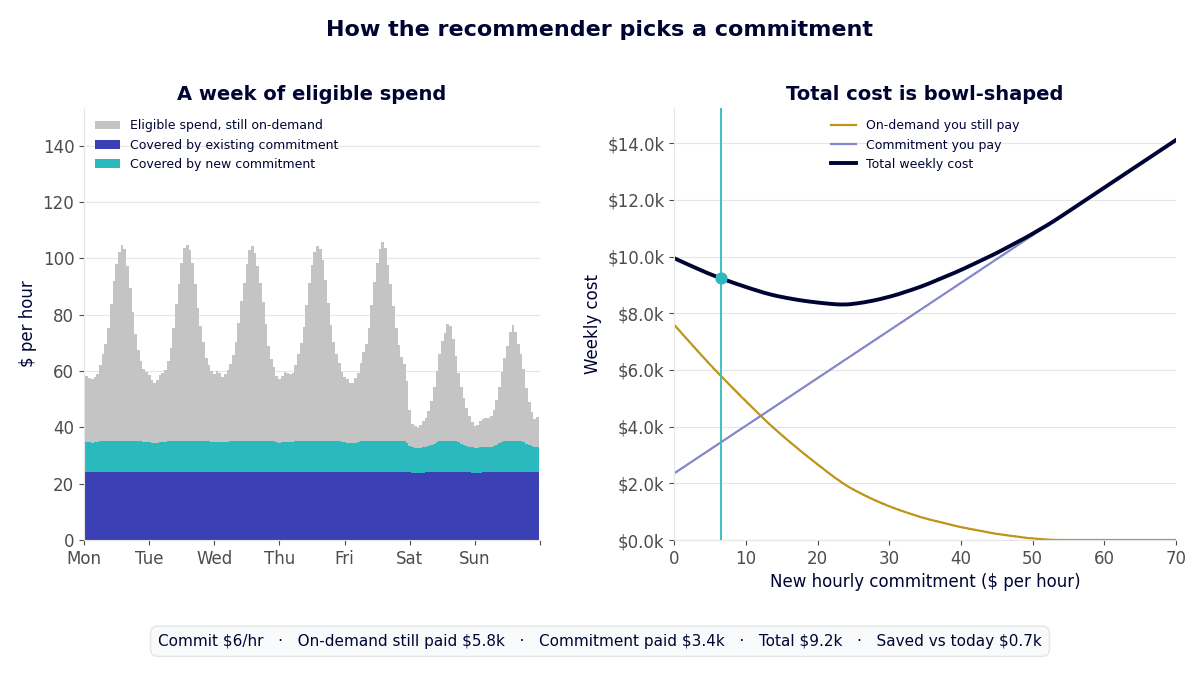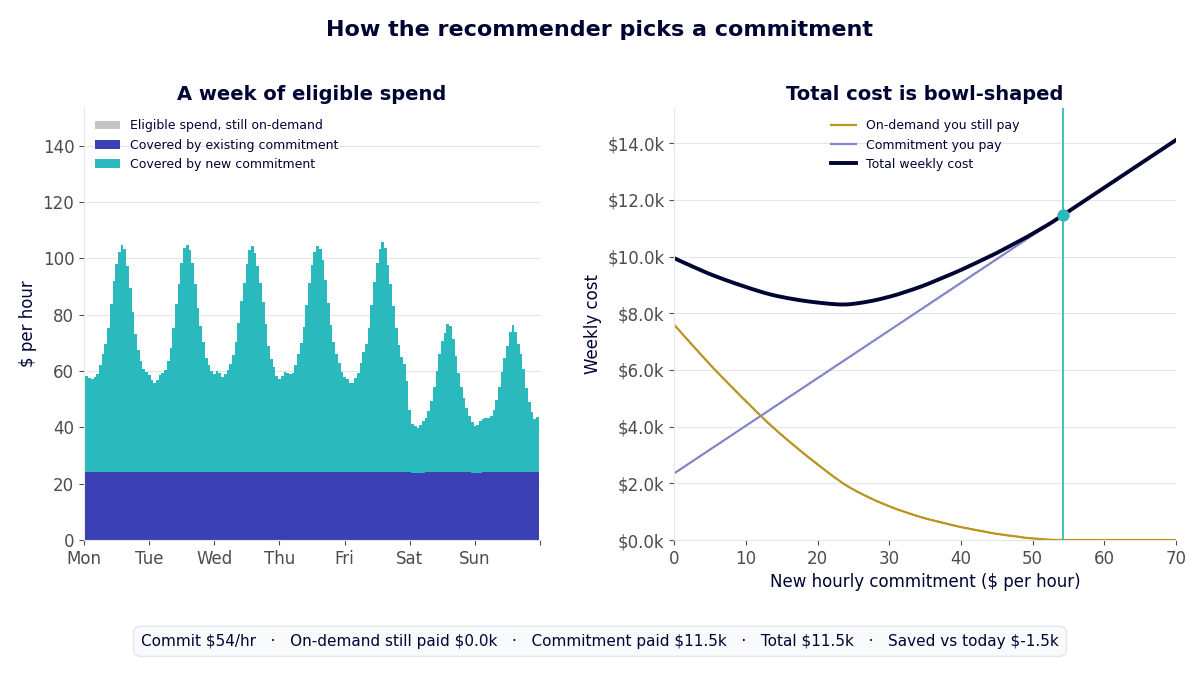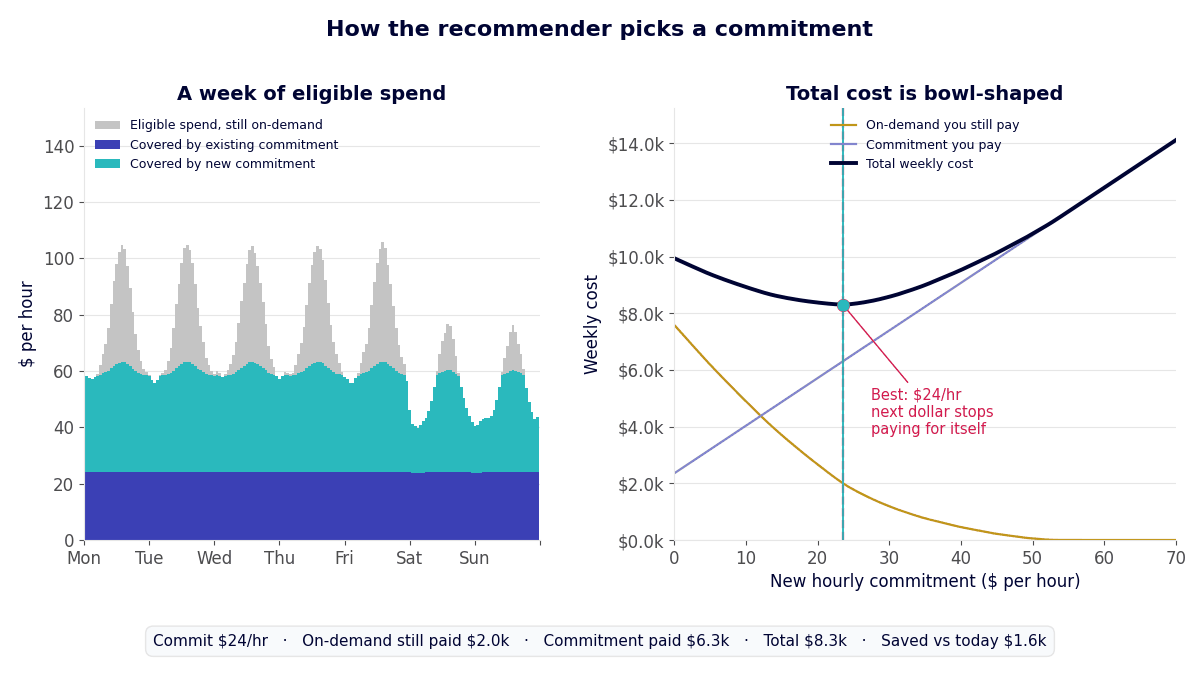
Tracez ce total en fonction de la taille du commitment et vous obtenez une courbe en cuvette. Le creux de la cuvette est le point idéal : le commitment où votre facture totale est la plus basse.
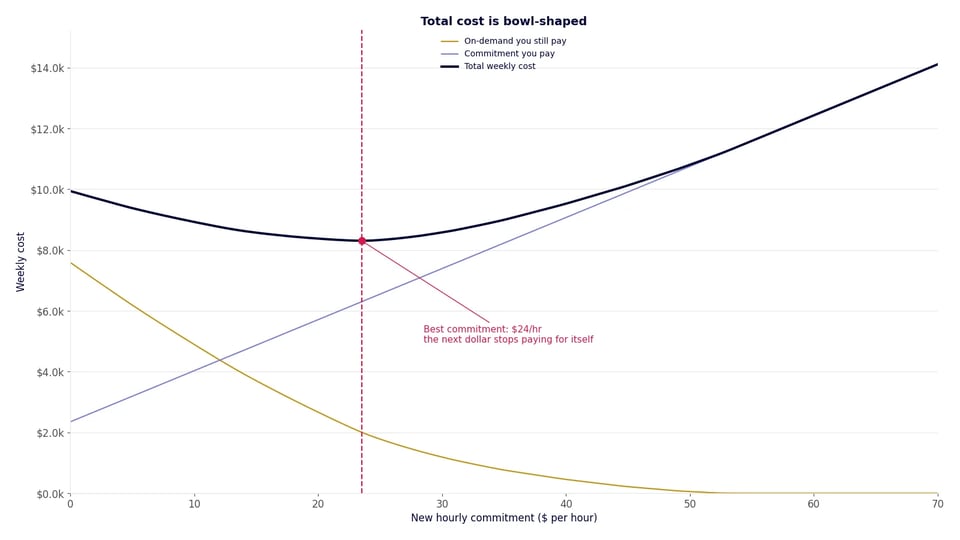
Sur la gauche, vous êtes sous-engagé. Chaque dollar de commitment supplémentaire remplace plus d'un dollar de dépense à la demande, donc le coût total baisse. Sur la droite, vous êtes sur-engagé. Le commitment excédentaire reste inutilisé pendant les heures creuses, donc le coût total remonte.
Le creux de la cuvette est le point où un dollar engagé de plus vous coûterait davantage qu'il ne vous rapporte. C'est le meilleur commitment. Nous ne le cherchons pas en testant chaque valeur centime par centime pour garder la moins chère. La forme de la courbe nous indique où elle s'inverse, alors nous allons droit à ce point.
Ensuite, vous choisissez une politique de risque. Conservative, Balanced, Max Savings, ou une politique définie par vos soins. Chacune retient une part de ce commitment optimal — 65 %, 80 % ou 90 % — pour laisser de la marge la semaine où votre utilisation baisse. Les politiques personnalisées vont plus loin : jusqu'à dix par client, chacune avec sa propre cible de couverture et ses propres paliers d'achat, de sorte que la recommandation suit vos règles plutôt que les trois préréglages imaginés par un fournisseur cloud. J'ai expliqué pourquoi cette marge compte, et pourquoi nous achetons par paliers plutôt qu'en une seule fois, dans un précédent article sur le problème du dimensionnement.
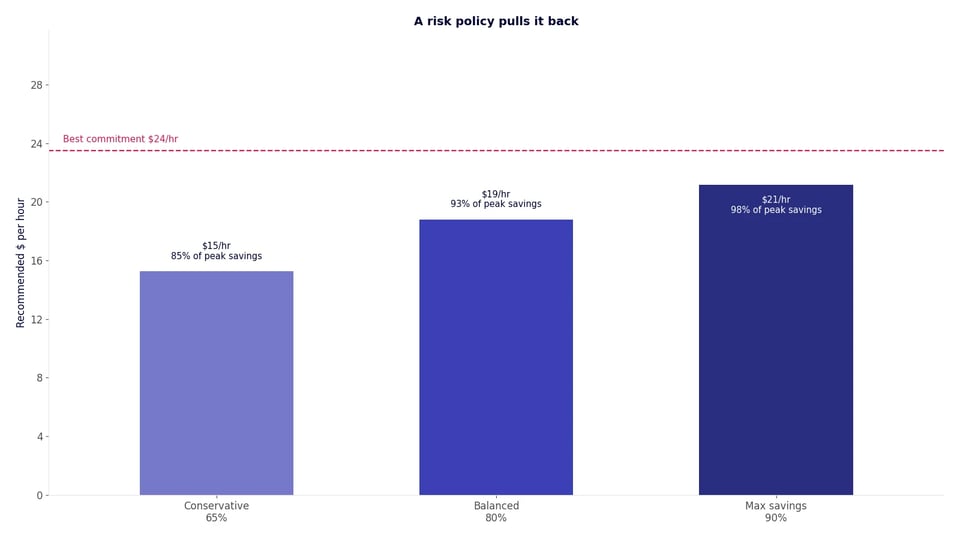
Au-dessus de tout cela, un petit ensemble de paramètres de réglage. Nous les ajustons à mesure que les achats réels nous apprennent des choses. Leur rôle : maintenir la recommandation du côté prudent de la valeur optimale du commitment.
Par exemple, le creux de la cuvette peut sembler plat dans certains cas. Une plage de commitments, et non un chiffre exact, économise à peu près le même montant. Le calcul brut pointerait volontiers vers le plus gros ; pas nous. Quand plusieurs tailles économisent à peu près autant, nous prenons la plus petite. Mêmes économies, moins d'argent immobilisé, plus de marge si un workload disparaît le mois prochain.
Ces paramètres nous permettent aussi de réagir à ce que nous observons en production. Si l'utilisation d'un compte tend à la baisse sur la fenêtre, la recommandation penche vers le bas. Si un achat se révèle moins utile que prévu par le modèle, nous en tirons les leçons et la recommandation suivante est plus prudente.
Et comme le moteur est le nôtre, quand un client demande quelque chose de précis — par exemple "ne jamais descendre sous 70 % d'utilisation" ou "laissez de la marge, nous consolidons des comptes au T3" — nous pouvons le respecter. Vous ne pouvez pas demander à AWS ou à Google d'exécuter leur moteur avec vos règles. Mais vous pouvez nous le demander, ou créer votre propre politique, et nous la suivrons.
Là où nous sommes d'accord avec les clouds
Avant de parler des différences, parlons de confiance. Si notre chiffre était loin de celui du cloud, vous seriez en droit de demander lequel est faux.
Alors nous avons vérifié.
Une chose doit d'abord être juste, sinon toute la comparaison n'est que du bruit : les deux moteurs doivent analyser les mêmes jours d'utilisation. Chaque moteur dimensionne sur une fenêtre d'analyse, une période fixe d'heures passées. AWS vous permet de choisir jusqu'aux 60 derniers jours. Le nôtre peut être réglé sur n'importe quelle période. Si les deux fenêtres ne coïncident pas, même de quelques jours, les chiffres divergeront, et cet écart n'aura rien à voir avec la méthode et tout à voir avec les dates. Pour chaque comparaison ci-dessous, nous avons donc réglé notre moteur sur exactement les mêmes dates de début et de fin qu'AWS ou Google. Mêmes jours en entrée, puis comparaison des résultats.
Sur AWS, nous avons confronté notre moteur au Purchase Analyzer d'AWS sur plusieurs comptes. Nous avons testé toutes les combinaisons : durées d'un an et de trois ans, sans acompte, acompte partiel et paiement intégral d'avance. Même fenêtre d'analyse des deux côtés. Notre commitment recommandé s'est situé à moins de 1 % du chiffre d'AWS dans chaque cas. Nous avons aussi exécuté le moteur sur notre plus gros client AWS pour vérifier qu'il tient à l'échelle. Il tient.
Sur Google Cloud, nous avons comparé avec les recommandations affichées dans la console GCP. Sur un compte de facturation aux tarifs standard, nous avons égalé Google au centime près, sur les huit périmètres de commitment testés. Cela inclut les CUD Compute Flexible, Memorystore et Cloud SQL dans chaque région. Sur un compte avec remises négociées, nous étions à moins de 1 %.
| Cloud | Type de compte | Périmètres testés | Notre chiffre face à celui du cloud |
|---|---|---|---|
| AWS | Payeur de taille moyenne, toutes combinaisons de durée et de paiement | 6 | À moins de 1 % |
| AWS | Notre plus gros client | 6 | Fonctionne sans problème, à moins de 1 % |
| Google Cloud | Tarification standard | 8 | Correspondance exacte, au centime près |
| Google Cloud | Remises négociées | 8 | À moins de 1 % |
Le constat est simple. Quand vous posez la même question, vous obtenez la même réponse. Personne n'invente un chiffre plus gros pour vous vendre davantage.
Alors pourquoi avoir construit le nôtre ?
Là où les clouds s'arrêtent et où nous continuons
Voici les questions que nos clients posent réellement. Dans chaque cas, le moteur du cloud ne peut pas répondre, ou vous fait attendre. La version courte, avant les détails :
| AWS | Google Cloud | DoiT | |
|---|---|---|---|
| Précision de la recommandation | Référence | Référence | À moins de 1 % des deux |
| Toutes les options de durée et de paiement, à la demande | 20 analyses par jour, une à la fois | Certains scénarios seulement | Toutes les combinaisons en moins de 20 secondes |
| API synchrone | Tâche asynchrone, interrogation pendant plusieurs minutes | Non disponible | Oui |
| Expliquer pourquoi le chiffre a bougé | Non | Non | Oui, jusqu'aux lignes de facturation |
| Périmètre par compte ou par SKU | Non | Non | Oui |
| Plage de dates personnalisée | Partiel | Partiel | Oui |
| Indépendant de l'API du cloud le jour de l'achat | Non | Non | Oui, lit directement les données de facturation |
| Achats automatisés par paliers | Non | Non | Oui |
| Commitments arrivant à expiration | Nouvelle recommandation après expiration | Nouvelle recommandation après expiration | Remplacement dimensionné et planifié avant l'expiration |
| Suivi humain de l'utilisation | Non | Non | Oui, équipe DoiT dédiée |
"Je veux comparer 1 an et 3 ans, sans acompte et paiement intégral, et trois niveaux de risque, avant de décider."
Sur AWS, chacune de ces options est une analyse distincte. Le Purchase Analyzer autorise 20 analyses par compte payeur et par jour. Chacune prend de quelques secondes à plusieurs minutes, et elles s'exécutent une à la fois. Pour voir le tableau complet d'un payeur, il faut plus d'analyses qu'AWS n'en autorise en une journée. Alors vous en choisissez quelques-unes, vous attendez, et vous espérez avoir bien choisi.
Google Cloud est plus flexible sur ce point. La console permet de construire des scénarios sur différentes périodes d'analyse, et vous pouvez exclure un ensemble de dates. Utile. Mais cela s'arrête là. Vous obtenez les options auxquelles Google a pensé, aux conditions de Google, et dès que vous voulez quelque chose en dehors de cette liste, vous êtes seul.
Notre moteur produit toutes les combinaisons pour un compte payeur en moins de 20 secondes. Vous pouvez l'exécuter autant de fois que vous le souhaitez.
"Je veux brancher les recommandations sur mes propres outils."
Le moteur de recommandation d'AWS est une tâche asynchrone. Vous la lancez, puis vous interrogez le service jusqu'à ce qu'elle se termine, quelques secondes ou minutes plus tard. Construire un pipeline fiable là-dessus demande du travail, et la limite quotidienne s'applique toujours.
La recommandation de la console Google Cloud est faite pour être lue, pas pour alimenter un workflow d'achat.
La nôtre est une API REST synchrone, intégrée à l'API DoiT Cloud Intelligence. Vous appelez l'endpoint avec votre clé API, vous recevez la recommandation dans la même réponse. Elle a la même structure sur AWS et sur Google Cloud : une seule intégration couvre les deux. Vous pouvez publier la recommandation quotidienne dans Slack, ouvrir un ticket quand elle varie au-delà d'un seuil, ou l'intégrer à votre propre dashboard FinOps à côté du reste de vos données de coûts.
Et comme c'est une simple API synchrone, elle se branche sur un assistant IA aussi facilement que sur un dashboard. Connectez-la à Claude, ou à l'outil de votre choix, et posez vos questions en langage naturel : "Quelle est la recommandation pour Cloud SQL dans us-east1 ?" "Quand expire mon prochain commitment ?" "Combien les commitments compute nous ont-ils fait économiser le mois dernier ?" Essayez de demander ça à une console.
Tout est également calculé à l'avance. Chaque option, chaque politique, chaque compte, une fois par jour. Quand vous ou votre assistant posez la question, rien n'est mis en file d'attente, rien n'est limité en débit, et il n'y a aucune attente par option. La réponse est déjà là.
"Pourquoi le chiffre a-t-il changé depuis la semaine dernière ?"
Nous avons vu la recommandation d'un payeur AWS osciller entre deux niveaux assez différents en une seule semaine. Rien dans l'utilisation ne l'expliquait. Notre meilleure hypothèse : la fenêtre glissante et le jour de la semaine où vous posez la question. Mais nous ne pouvons pas en être sûrs, car le Purchase Analyzer ne montre pas assez clairement son raisonnement pour le vérifier.
Chaque chiffre produit par notre moteur remonte aux lignes de facturation. Quand un client demande pourquoi la recommandation a bougé, nous pouvons lui montrer quelles heures ont changé et de combien. Souvent, la réponse est simple : un traitement batch a cessé de tourner la nuit, ou un nouvel environnement a été mis en ligne jeudi. Dans tous les cas, vous obtenez une réponse plutôt qu'un haussement d'épaules.
"Ce compte est en cours de décommissionnement. Ignorez-le."
Ou : "Excluez ces SKU, nous déplaçons ce workload." Ou : "Dimensionnez sur le trimestre dernier, pas sur la fenêtre par défaut."
Aucun des deux clouds ne vous permet de délimiter la recommandation par compte, par SKU ou par période explicite. Vous obtenez une seule réponse pour l'ensemble du payeur, sur la fenêtre de leur choix.
Le nôtre fait les trois. Excluez un compte. Retirez une part de certains SKU. Définissez vos propres dates de début et de fin. L'éligibilité est elle aussi granulaire : les comptes liés ou projets qui entrent dans le périmètre des commitments relèvent d'un simple paramètre, et le moteur ne dimensionne que sur ceux-là. Aujourd'hui, nous le configurons pour vous ; un réglage en libre-service arrive bientôt. Et il existe derrière cela bien plus de contrôles que n'en expose l'une ou l'autre console.
Une précision en toute transparence : aujourd'hui, ce ne sont pas des boutons en libre-service dans la console. Vous indiquez à votre équipe DoiT ce qu'il faut exclure ou quelles dates utiliser, et nous exécutons le moteur avec ces paramètres pour vous. L'essentiel, c'est que ce soit tout simplement possible, et que la réponse arrive le jour même. Et tout cela est sur notre feuille de route : nous comptons mettre ces réglages entre les mains des clients pour qu'ils en contrôlent chaque aspect eux-mêmes.
"Et si Cost Explorer est en panne le jour de l'achat ?"
Cela ressemble à un cas limite, jusqu'au jour où ça arrive. Dimensionner un commitment n'est pas une tâche ponctuelle. Comme je l'expliquais dans l'article sur le dimensionnement, c'est une cible mouvante qu'il faut continuer d'atteindre, semaine après semaine, à mesure que votre utilisation évolue. Et la cible se multiplie. Deux clouds, le compute plus les bases de données, plusieurs régions, chacun avec son propre commitment et sa propre date d'expiration. Ce n'est pas une décision hebdomadaire. C'en est une douzaine.
Un moteur qui dépend d'une tâche externe peut rater une étape. Si l'API est lente, limitée en débit ou en plein incident, l'achat de la semaine n'a pas lieu. Le nôtre lit directement vos données de facturation. Il n'y a rien d'externe à attendre.
"Je ne veux pas avoir à surveiller tout ça."
Et voilà le fond du sujet. C'est la vraie réponse à "pourquoi aurais-je besoin du vôtre".
Une recommandation n'est utile que si quelqu'un agit dessus. Notre moteur alimente un mécanisme d'achats automatisés par paliers. Les achats se font en coulisses, à un rythme contrôlé par le client, par paliers dimensionnés selon la politique choisie. Et une équipe DoiT dédiée surveille l'utilisation de chaque commitment. Si quelque chose commence à rester inutilisé, elle le détecte avant que cela ne devienne du gaspillage sur votre facture. Sur AWS, cela peut même aller jusqu'à restituer un Savings Plan tant que la fenêtre de retour est encore ouverte.
L'expiration est gérée de la même manière. Quand un plan touche à sa fin, la recommandation suivante part déjà du principe qu'il a disparu, et le mécanisme planifie le remplacement pour qu'il démarre à l'instant où l'ancien se termine. La couverture ne chute pas pendant une semaine en attendant que quelqu'un s'en aperçoive. Les moteurs des clouds, eux, ne voient le trou de couverture qu'une fois qu'il s'est formé.
Bientôt, les clients pourront définir eux-mêmes la politique de rythme d'achat, en plus de la politique de risque qu'ils choisissent déjà aujourd'hui.
Ce qui est disponible aujourd'hui
Sur AWS, le moteur couvre les Compute Savings Plans et les Database Savings Plans. Sur Google Cloud, il couvre les CUD Compute Flexible, qui s'appliquent à Compute Engine et à GKE, ainsi que les CUD Cloud SQL basées sur la dépense, achetées par région. Les autres types de commitments sont sur la feuille de route et seront disponibles prochainement.
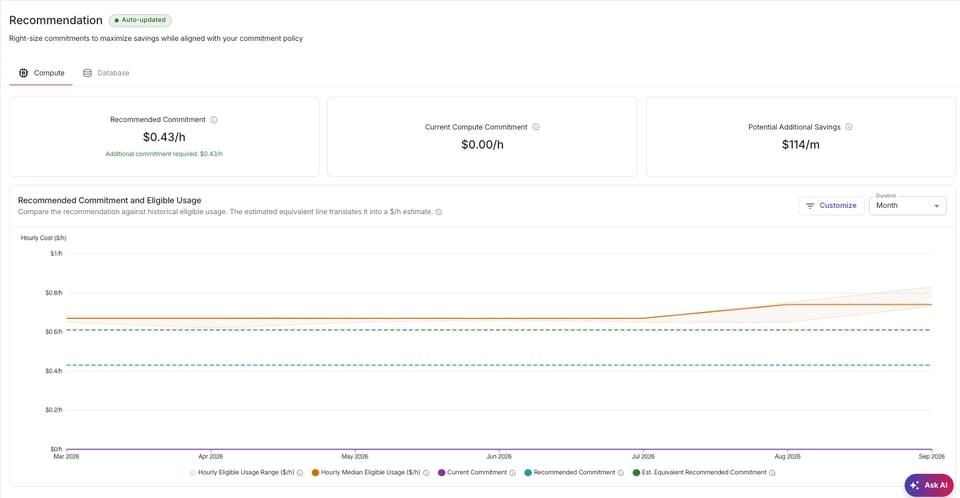
Les Reserved Instances existantes et les CUD basées sur les ressources ne font pas partie de ce que nous achetons pour vous. Mais le moteur les connaît. La dépense qu'elles couvrent déjà n'est pas éligible, donc nous ne recommandons pas de commitment par-dessus.
Les politiques ont la même signification sur les deux clouds. Balanced sur AWS correspond aux mêmes 80 % du commitment optimal que Balanced sur Google Cloud. Si vous utilisez les deux clouds, votre stratégie de commitments se lit de la même façon des deux côtés.
Le moteur s'exécute une fois par jour, pour chaque politique et chaque combinaison de durée et de paiement, pour chaque compte payeur et chaque compte de facturation que nous gérons. Quand vous ouvrez la console, les chiffres sont déjà là.
La suite
Azure est le prochain sur la liste : le même moteur et les mêmes politiques couvriront ainsi les trois grands clouds. Le simulateur de scénarios que nous utilisons en interne — où vous retirez un workload ou un compte et observez la recommandation évoluer avant d'acheter — arrive bientôt chez les clients. Et côté FinOps au sens large, le showback par labels et par tags est en préparation, pour voir à quelle équipe ou à quel produit chaque commitment fait réellement économiser de l'argent.
Ce qu'il faut retenir
Les moteurs de recommandation intégrés d'AWS et de Google Cloud sont bons. Quand nous leur posons la même question, nous obtenons la même réponse. Si vous achetez des commitments une fois par an, ils vous suffisent probablement.
Cela tient tant que vous avez un seul cloud, un seul service de compute, une seule région. Ajoutez maintenant les bases de données. Ajoutez une deuxième région. Ajoutez Google Cloud à côté d'AWS. Soudain, ce sont des Savings Plans compute et database d'un côté, des CUD Compute Flexible et Cloud SQL par région de l'autre, chacun avec sa propre date d'expiration, sa propre courbe de remise, ses propres heures creuses. Les combinaisons se multiplient plus vite que n'importe quel agenda. Personne ne dimensionne cela à la main quelques fois par an. Pas correctement, en tout cas.
Mais les commitments ne sont pas un chantier annuel. L'utilisation croît, décroît et se déplace. Les anciens plans expirent. De nouveaux workloads apparaissent. Le bon commitment d'aujourd'hui n'est pas le bon commitment dans trois mois. C'est une cible mouvante qu'il faut continuer d'atteindre.
Pour cela, il vous faut un moteur de recommandation que vous pouvez exécuter à tout moment, adapter à votre situation, expliquer à votre équipe finance et confier à un processus d'achat automatisé. C'est pour cela que nous avons construit le nôtre. Il tourne chaque jour, sur les deux clouds, et il est disponible dès maintenant dans PerfectScale for Commitments.
Nous ne l'avons pas construit pour contredire AWS ou Google. Nous l'avons construit pour que le bon chiffre apparaisse chaque jour, selon notre calendrier, pour chaque option, avec une explication à l'appui. Puis nous laissons la machine agir.
Arrêtez de dimensionner vos commitments dans un tableur une fois par an. Contactez-nous et nous exécuterons le moteur sur votre facture réelle, pour que vous voyiez concrètement ce que des commitments automatisés et calibrés selon votre tolérance au risque peuvent vous apporter.